Язык программирования Rust
Авторы: Стив Клабник, Кэрол Николс и Крис Крычо при участии сообщества Rust
Этот текст рассчитан на Rust 1.98.0 (выпущен 20 августа 2026 года) или новее,
причём во всех проектах в файле Cargo.toml должно стоять edition = "2024",
чтобы использовались идиомы редакции Rust 2024. Как установить или обновить
Rust, рассказано в разделе «Установка» главы 1, а что
такое редакции — в приложении E.
Оригинал книги на английском доступен онлайн по адресу
https://doc.rust-lang.org/stable/book/,
а также оффлайн — он ставится вместе с Rust через rustup; откройте его
командой rustup doc --book.
Существуют и другие переводы, сделанные сообществом.
Бумажная и электронная версии оригинала выходят в издательстве No Starch Press.
🚨 Хотите учиться интерактивнее? Попробуйте другую версию Rust Book — с тестами, выделением текста, визуализациями и не только (на английском): https://rust-book.cs.brown.edu
О переводе. Это вольный перевод: мы старались передать смысл так, чтобы текст легко читался по-русски, а не следовать английскому оригиналу слово в слово. Термины при этом взяты те, что приняты в русскоязычном сообществе Rust; при первом появлении рядом дан английский оригинал. Текст распространяется на тех же условиях, что и оригинал, — под лицензиями MIT и Apache 2.0.
Предисловие
За несколько лет Rust проделал огромный путь. Начинался он как проект небольшого, только зарождавшегося сообщества энтузиастов, а сегодня это один из самых любимых и востребованных языков программирования в мире. Оглядываясь назад, можно сказать, что мощь и возможности Rust неизбежно должны были привлечь внимание и закрепить его в системном программировании. Но вот чего никто не мог предсказать — так это того, что интерес к языку и новые идеи вокруг него разойдутся по всему миру через open source-сообщества и что Rust начнут массово применять в самых разных отраслях.
Сегодня этот взрыв интереса легко объяснить прекрасными возможностями языка. Кто откажется от безопасной работы с памятью, и высокой скорости, и дружелюбного компилятора, и отличных инструментов — и это далеко не полный список? Rust, каким вы видите его сейчас, — это годы исследований в области системного программирования плюс практический опыт живого и увлечённого сообщества. Язык проектировали осмысленно и делали тщательно, чтобы дать разработчикам инструмент, с которым проще писать безопасный, быстрый и надёжный код.
Но по-настоящему особенным Rust делает то, что он изначально создавался, чтобы помочь вам, пользователю, добиться своих целей. Этот язык хочет, чтобы у вас всё получилось, и этот принцип лежит в основе сообщества, которое разрабатывает, поддерживает и продвигает Rust. Со времени предыдущего издания этой книги Rust стал по-настоящему глобальным языком, которому доверяют. Теперь у проекта Rust есть надёжная опора — фонд Rust Foundation, который к тому же вкладывается в ключевые инициативы, чтобы Rust оставался безопасным, стабильным и жизнеспособным.
Это издание «Языка программирования Rust» полностью обновлено: оно отражает то, как язык менялся за эти годы, и содержит много нового и полезного. Но это не просто справочник по синтаксису и библиотекам — это приглашение в сообщество, которое ценит качество, производительность и продуманный дизайн. Пробуете ли вы Rust впервые, имея за плечами большой опыт разработки, или уже давно пишете на Rust и хотите отточить навыки — каждый найдёт здесь что-то для себя.
Путь Rust — это совместная работа, обучение и постоянное улучшение. Рост языка и его экосистемы прямо отражает то, насколько живое и разнообразное сообщество за ним стоит. Именно вклад тысяч разработчиков — от тех, кто проектирует ядро языка, до тех, кто изредка присылает исправления, — делает Rust таким уникальным и мощным инструментом. Открыв эту книгу, вы не просто изучаете новый язык программирования: вы присоединяетесь к движению за то, чтобы программы становились лучше, безопаснее, а работать с ними было приятнее.
Добро пожаловать в сообщество Rust!
- Бек Рамбул, исполнительный директор Rust Foundation
Введение
Примечание: это издание книги совпадает с книгой The Rust Programming Language, которая выходит в бумажном и электронном виде в издательстве No Starch Press.
Добро пожаловать в «Язык программирования Rust» — вводную книгу о Rust. Rust помогает писать более быстрые и надёжные программы. Обычно при проектировании языка приходится выбирать: либо удобство высокого уровня, либо контроль над низкоуровневыми деталями. Rust с этим выбором не согласен. Он сочетает серьёзные технические возможности с удобством для разработчика и позволяет управлять низкоуровневыми вещами (например, использованием памяти) без той головной боли, которая обычно с этим связана.
Для кого Rust
Rust подходит очень многим, и по разным причинам. Рассмотрим несколько самых важных групп.
Команды разработчиков
Rust хорошо показывает себя в больших командах, где у людей разный опыт в системном программировании. В низкоуровневом коде легко допустить коварные ошибки, и в большинстве языков их ловят только обширным тестированием и внимательным ревью кода опытными разработчиками. В Rust роль такого привратника берёт на себя компилятор: код с подобными трудноуловимыми ошибками, включая ошибки многопоточности, он просто не скомпилирует. Работая в паре с компилятором, команда может заниматься логикой программы, а не охотой за багами.
Кроме того, Rust приносит в системное программирование современные инструменты разработки:
- Cargo — встроенный менеджер зависимостей и система сборки. С ним добавлять, собирать и обновлять зависимости просто, и делается это одинаково во всей экосистеме Rust.
- Утилита форматирования
rustfmtследит за тем, чтобы код у всех разработчиков был оформлен в едином стиле. - Rust Language Server обеспечивает поддержку в среде разработки (IDE): автодополнение и сообщения об ошибках прямо в коде.
С этими и другими инструментами экосистемы Rust разработчики могут продуктивно работать даже над системным кодом.
Студенты
Rust подойдёт студентам и всем, кто хочет разобраться в системных концепциях. Многие с помощью Rust изучили, например, разработку операционных систем. Сообщество очень доброжелательное и охотно отвечает на вопросы студентов. Такими проектами, как эта книга, команды Rust стремятся сделать системные концепции понятнее для как можно большего числа людей — особенно для тех, кто только начинает программировать.
Компании
Сотни компаний, больших и маленьких, используют Rust в продакшене для самых разных задач: утилиты командной строки, веб-сервисы, инструменты DevOps, встраиваемые устройства, анализ и перекодирование аудио и видео, криптовалюты, биоинформатика, поисковые системы, интернет вещей, машинное обучение и даже значительные части браузера Firefox.
Разработчики open source
Rust — для тех, кто хочет развивать сам язык Rust, его сообщество, инструменты разработки и библиотеки. Мы будем рады вашему вкладу в язык.
Те, кому важны скорость и стабильность
Rust — для тех, кому нужен быстрый и стабильный язык. Под скоростью мы понимаем и то, насколько быстро работает код на Rust, и то, насколько быстро Rust позволяет писать программы. Компилятор проверяет код при каждой сборке, поэтому новые возможности и рефакторинг не ломают незаметно то, что уже работало. Сравните это с хрупким legacy-кодом на языках без таких проверок: его часто просто боятся трогать. Rust стремится к абстракциям с нулевой стоимостью (zero-cost abstractions): высокоуровневые конструкции компилируются в такой же быстрый низкоуровневый код, какой вы написали бы вручную. Цель — чтобы безопасный код был ещё и быстрым.
Rust надеется помочь и многим другим — здесь перечислены лишь самые крупные группы заинтересованных. В целом главная амбиция Rust — избавить программистов от компромиссов, с которыми они мирились десятилетиями: дать безопасность и продуктивность, скорость и удобство. Попробуйте Rust и посмотрите, подходит ли вам его подход.
Для кого эта книга
Мы предполагаем, что вы уже писали код на каком-то другом языке программирования, но на каком именно — не важно. Мы старались подать материал так, чтобы он был понятен людям с самым разным опытом. Мы не будем долго рассуждать о том, что такое программирование и как о нём думать. Если вы совсем новичок в программировании, лучше начните с книги, которая специально учит программированию с нуля.
Как читать эту книгу
В целом книга рассчитана на чтение по порядку, от начала до конца. Поздние главы опираются на понятия из ранних, а ранние главы порой не углубляются в детали, потому что к теме мы вернёмся позже.
В книге есть главы двух видов: теоретические и практические. В теоретических главах вы знакомитесь с какой-то частью Rust. В практических мы вместе пишем небольшие программы и применяем то, что уже изучили. Практические главы — это главы 2, 12 и 21, остальные — теоретические.
Глава 1 рассказывает, как установить Rust, написать программу «Hello, world!» и пользоваться Cargo — менеджером пакетов и системой сборки Rust. Глава 2 — практическое знакомство с Rust: вы напишете игру «Угадай число». Здесь мы проходимся по понятиям поверхностно, а подробности будут в следующих главах. Если хочется сразу взяться за дело, глава 2 — как раз для этого. Если же вы из тех, кто любит сперва разобраться во всех деталях, можете пропустить главу 2 и сразу перейти к главе 3. Она рассказывает о возможностях Rust, похожих на то, что есть в других языках. А к главе 2 можно вернуться потом, когда захочется применить изученное на практике.
В главе 4 вы познакомитесь с системой владения (ownership) в Rust.
Глава 5 посвящена структурам и методам. Глава 6 рассказывает о
перечислениях, выражениях match и конструкциях управления потоком if let
и let...else. Структуры и перечисления нужны, чтобы создавать собственные
типы.
В главе 7 вы узнаете о системе модулей Rust и о правилах приватности, с помощью которых организуют код и его публичный интерфейс (API). Глава 8 рассказывает о распространённых коллекциях из стандартной библиотеки: векторах, строках и хеш-таблицах. Глава 9 объясняет, как Rust подходит к обработке ошибок и какие для этого есть приёмы.
Глава 10 подробно разбирает обобщения (generics), трейты и времена жизни
— всё это позволяет писать код, который работает с разными типами. Глава 11
целиком посвящена тестированию: даже с гарантиями безопасности Rust тесты нужны,
чтобы убедиться, что логика программы верна. В главе 12 мы сами напишем
упрощённую версию утилиты командной строки grep, которая ищет текст в файлах.
Для этого пригодятся многие понятия из предыдущих глав.
Глава 13 рассказывает о замыканиях и итераторах — возможностях Rust, пришедших из функциональных языков. В главе 14 мы глубже разберём Cargo и поговорим о том, как лучше делиться своими библиотеками с другими. Глава 15 посвящена умным указателям из стандартной библиотеки и трейтам, на которых они построены.
В главе 16 мы рассмотрим разные модели конкурентного программирования и
поговорим о том, как Rust позволяет без страха писать многопоточный код. В
главе 17 мы продолжим эту тему: разберём синтаксис async и await, а
также задачи, футуры и стримы и ту лёгкую модель конкурентности, которую они
дают.
Глава 18 сравнивает идиомы Rust с принципами объектно-ориентированного программирования, которые вам, возможно, знакомы. Глава 19 — справочник по образцам и сопоставлению с образцом: это мощный способ выражать мысли в программах на Rust. Глава 20 — сборная солянка продвинутых тем: небезопасный Rust, макросы и ещё немного о временах жизни, трейтах, типах, функциях и замыканиях.
В главе 21 мы доведём до конца проект: напишем низкоуровневый многопоточный веб-сервер!
Наконец, в приложениях собраны полезные сведения о языке в формате справочника. Приложение A — ключевые слова Rust, приложение B — операторы и символы, приложение C — выводимые трейты из стандартной библиотеки, приложение D — полезные инструменты разработки, приложение E объясняет, что такое редакции Rust. В приложении F перечислены переводы книги, а в приложении G рассказано, как создаётся Rust и что такое nightly Rust.
Неправильного способа читать эту книгу нет: хотите забежать вперёд — пожалуйста! Если что-то окажется непонятным, возможно, придётся вернуться к предыдущим главам. Но делайте так, как удобно вам.
Важная часть изучения Rust — научиться читать сообщения об ошибках, которые выдаёт компилятор: они подскажут, как довести код до рабочего состояния. Поэтому мы будем приводить много примеров, которые не компилируются, вместе с сообщением об ошибке, которое в каждом случае покажет компилятор. Имейте в виду: если вы возьмёте случайный пример и запустите его, он может и не скомпилироваться! Обязательно читайте окружающий текст, чтобы понять, должен ли пример, который вы запускаете, завершиться ошибкой. Отличить код, который и не должен работать, поможет Феррис:
| Феррис | Что это значит |
|---|---|
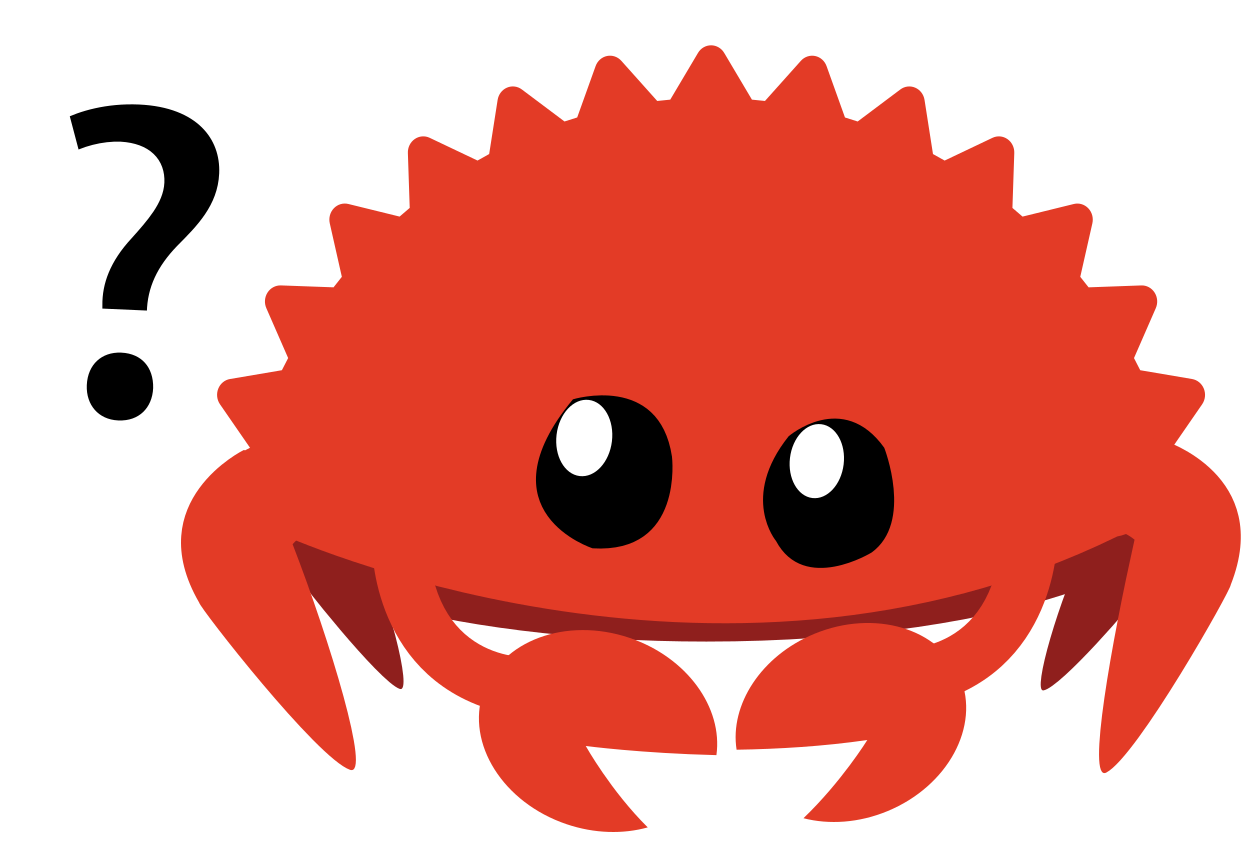 | Этот код не компилируется! |
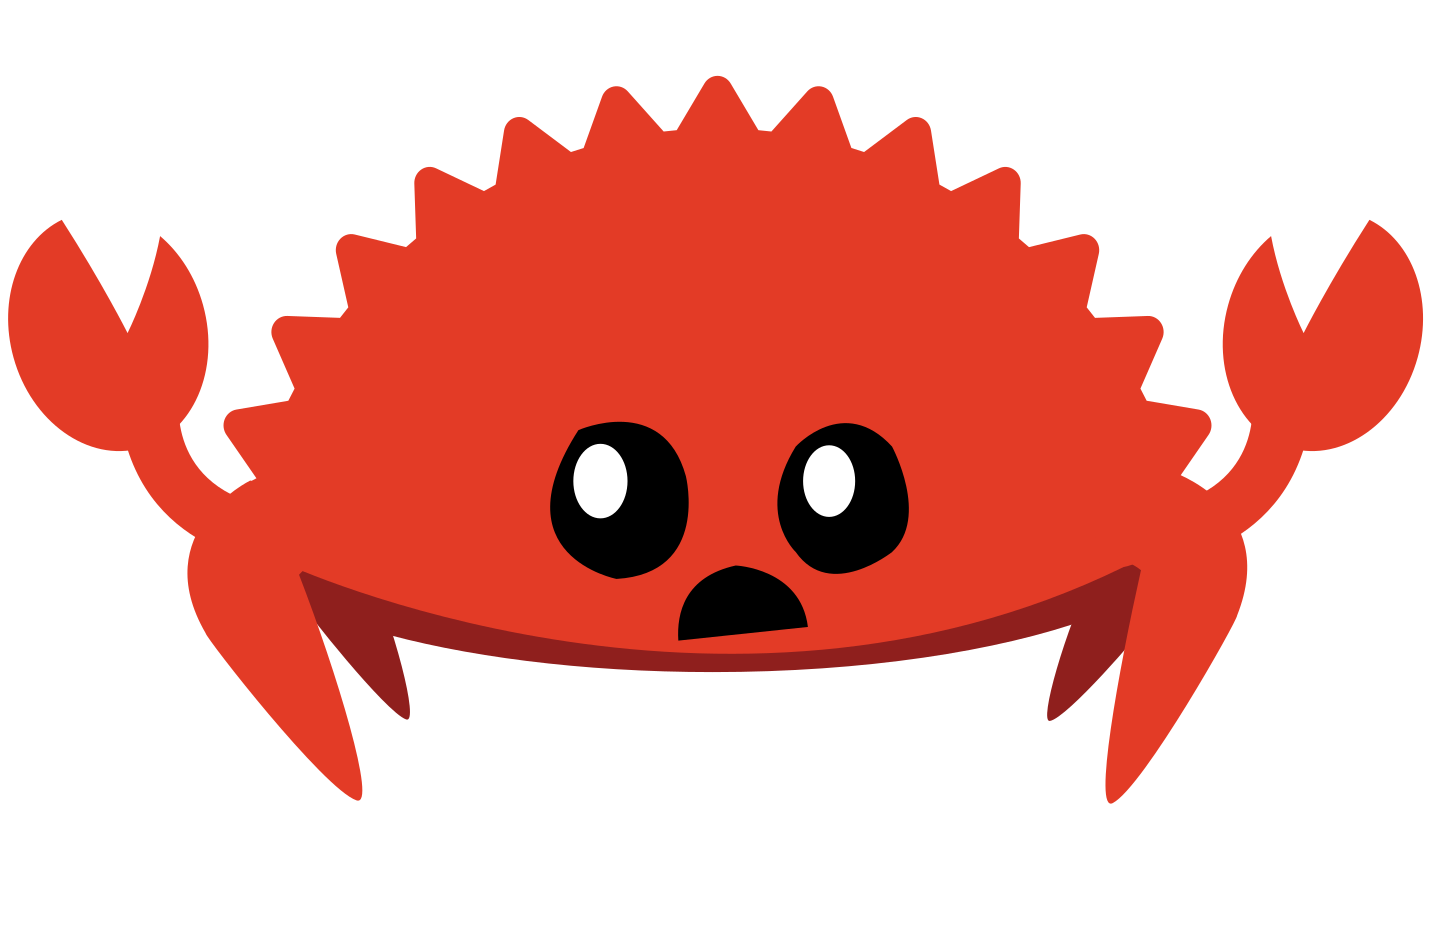 | Этот код паникует! |
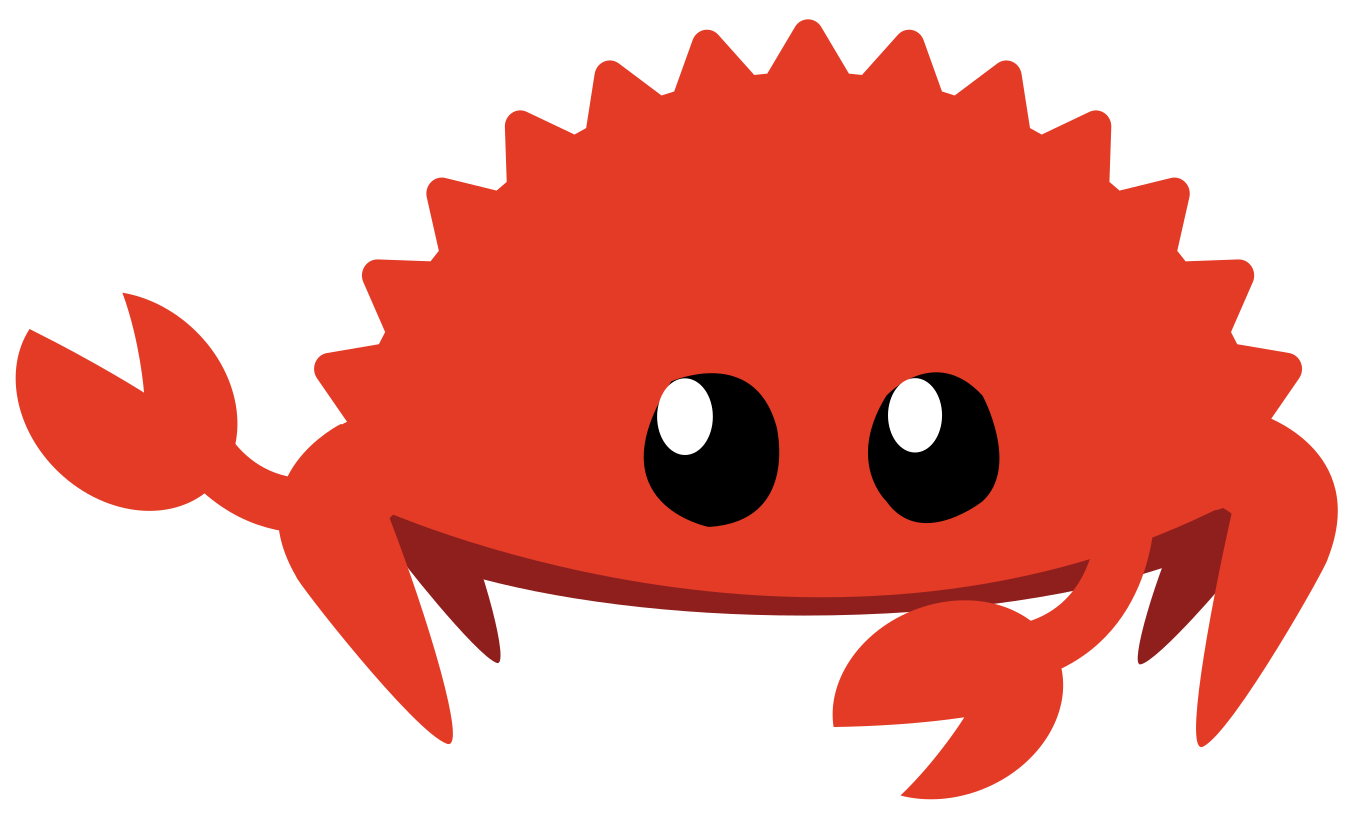 | Этот код работает не так, как задумано. |
Почти всегда мы потом покажем исправленную версию кода, который не компилируется.
Исходный код
Исходные файлы, из которых собирается оригинал этой книги, лежат на GitHub.
С чего начать
Начнём ваше путешествие в Rust! Изучить предстоит многое, но любой путь начинается с первого шага. В этой главе мы:
- установим Rust на Linux, macOS и Windows;
- напишем программу, которая выводит
Hello, world!; - познакомимся с
cargo— менеджером пакетов и системой сборки Rust.
Установка
Установка
Первым делом нужно установить Rust. Скачивать его мы будем через rustup —
утилиту командной строки, которая управляет версиями Rust и связанными с ним
инструментами. Для загрузки понадобится интернет.
Примечание: если по какой-то причине вы не хотите использовать rustup,
загляните на страницу других способов установки Rust.
Следующие шаги устанавливают последнюю стабильную версию компилятора Rust. Rust гарантирует стабильность: все примеры из книги, которые компилируются сейчас, будут компилироваться и в более новых версиях. Вывод может немного отличаться от версии к версии, потому что в Rust постоянно улучшают сообщения об ошибках и предупреждения. Иными словами, любая более новая стабильная версия Rust, установленная по этой инструкции, будет работать с материалом книги так, как ожидается.
Как записаны команды
В этой главе и дальше в книге мы будем показывать команды, которые вводятся
в терминале. Все строки, которые нужно ввести, начинаются с $. Сам символ
$ набирать не нужно: это приглашение командной строки, оно лишь отмечает
начало команды. Строки без $ обычно показывают вывод предыдущей команды.
А в примерах специально для PowerShell вместо $ будет >.
Установка rustup в Linux и macOS
Если у вас Linux или macOS, откройте терминал и выполните команду:
$ curl --proto '=https' --tlsv1.2 https://sh.rustup.rs -sSf | sh
Она скачает скрипт и запустит установку утилиты rustup, а та, в свою
очередь, установит последнюю стабильную версию Rust. Возможно, у вас спросят
пароль. Если всё прошло успешно, появится строка:
Rust is installed now. Great!
Вам также понадобится компоновщик (linker) — программа, которой Rust собирает результаты компиляции в один файл. Скорее всего, он у вас уже есть. Если же появляются ошибки компоновки, установите компилятор C — обычно компоновщик идёт вместе с ним. Компилятор C пригодится и по другой причине: некоторые популярные пакеты Rust зависят от кода на C, и для их сборки он нужен.
В macOS компилятор C можно получить так:
$ xcode-select --install
В Linux обычно ставят GCC или Clang — как именно, описано в документации
вашего дистрибутива. Например, в Ubuntu достаточно установить пакет
build-essential.
Установка rustup в Windows
В Windows откройте https://www.rust-lang.org/tools/install и следуйте инструкции по установке Rust. В какой-то момент установщик предложит поставить Visual Studio: она содержит компоновщик и системные библиотеки, без которых программы не скомпилировать. Если с этим шагом нужна помощь, загляните на https://rust-lang.github.io/rustup/installation/windows-msvc.html.
Дальше в книге используются команды, которые работают и в cmd.exe, и в PowerShell. Если где-то есть разница, мы скажем, что использовать.
Решение проблем
Чтобы проверить, правильно ли установлен Rust, откройте терминал и введите:
$ rustc --version
Вы должны увидеть номер последней вышедшей стабильной версии, хеш коммита и дату коммита в таком формате:
rustc x.y.z (abcabcabc yyyy-mm-dd)
Если видите эту строку — Rust успешно установлен! Если нет, проверьте, что
Rust есть в системной переменной %PATH%.
В Windows CMD:
> echo %PATH%
В PowerShell:
> echo $env:Path
В Linux и macOS:
$ echo $PATH
Если всё в порядке, а Rust всё равно не работает, помощь можно найти во многих местах. Как связаться с другими растацеанами (Rustaceans — так мы в шутку себя называем), смотрите на странице сообщества.
Обновление и удаление
Если Rust установлен через rustup, обновиться до свежей версии очень просто.
Выполните в терминале:
$ rustup update
Чтобы удалить Rust вместе с rustup, выполните:
$ rustup self uninstall
Локальная документация
Вместе с Rust устанавливается и локальная копия документации, так что читать
её можно без интернета. Команда rustup doc откроет её в браузере.
Если вам попался тип или функция из стандартной библиотеки и вы не уверены, что они делают или как ими пользоваться, — загляните в документацию по API (application programming interface, программный интерфейс приложения)!
Текстовые редакторы и IDE
Книга не навязывает вам никаких инструментов для написания кода на Rust — подойдёт практически любой текстовый редактор! Впрочем, во многих редакторах и интегрированных средах разработки (IDE) есть встроенная поддержка Rust. Довольно свежий список редакторов и IDE всегда можно найти на странице инструментов сайта Rust.
Работа с книгой без интернета
В некоторых примерах мы будем использовать пакеты Rust, которых нет в
стандартной библиотеке. Чтобы проработать эти примеры, нужен либо интернет,
либо заранее скачанные зависимости. Скачать их заранее можно такими командами
(что такое cargo и что делает каждая команда, мы подробно объясним позже):
$ cargo new get-dependencies
$ cd get-dependencies
$ cargo add rand@0.10.1 trpl@0.2.0
Скачанные пакеты сохранятся в кеше, и потом загружать их уже не придётся.
После этого папку get-dependencies можно удалить. Дальше в книге ко всем
командам cargo можно добавлять флаг --offline — тогда Cargo возьмёт
закешированные версии и не будет лезть в сеть.
Hello, World!
Hello, World!
Rust установлен — пора написать первую программу. По традиции, изучая новый
язык, первым делом пишут маленькую программу, которая выводит на экран текст
Hello, world!. Так поступим и мы!
Примечание: мы предполагаем, что вы хотя бы немного знакомы с командной
строкой. Rust не предъявляет особых требований к редактору, инструментам или
месту, где лежит код, так что если вам удобнее IDE, а не командная строка, —
пользуйтесь любимой IDE. Сейчас многие IDE в той или иной мере поддерживают
Rust; подробности ищите в документации вашей IDE. Команда Rust вкладывается в
хорошую поддержку IDE через rust-analyzer. Подробнее об этом — в
приложении D.
Папка для проекта
Начнём с папки, где будет лежать код на Rust. Самому Rust всё равно, где находится ваш код, но для упражнений и проектов из этой книги мы советуем создать в домашнем каталоге папку projects и держать все проекты в ней.
Откройте терминал и введите следующие команды: они создадут папку projects, а внутри неё — папку для проекта «Hello, world!».
В Linux, macOS и PowerShell в Windows:
$ mkdir ~/projects
$ cd ~/projects
$ mkdir hello_world
$ cd hello_world
В Windows CMD:
> mkdir "%USERPROFILE%\projects"
> cd /d "%USERPROFILE%\projects"
> mkdir hello_world
> cd hello_world
Основы программы на Rust
Теперь создайте файл с исходным кодом и назовите его main.rs. Файлы Rust всегда имеют расширение .rs. Если в имени файла несколько слов, их принято разделять подчёркиванием: например, hello_world.rs, а не helloworld.rs.
Откройте только что созданный файл main.rs и введите код из листинга 1-1.
fn main() {
    println!("Hello, world!");
}Hello, world!Сохраните файл и вернитесь в терминал, в папку ~/projects/hello_world. В Linux или macOS скомпилируйте и запустите программу так:
$ rustc main.rs
$ ./main
Hello, world!
В Windows вместо ./main введите .\main:
> rustc main.rs
> .\main
Hello, world!
В какой бы ОС вы ни работали, в терминале должна появиться строка
Hello, world!. Если её нет, загляните в часть «Решение
проблем» раздела об установке — там написано,
где искать помощь.
Если Hello, world! появилась — поздравляем! Вы официально написали программу
на Rust, а значит, стали программистом на Rust. Добро пожаловать!
Из чего состоит программа на Rust
Разберём программу «Hello, world!» по частям. Вот первый кусочек:
fn main() {

}
Эти строки определяют функцию с именем main. Функция main особенная: в
любой исполняемой программе на Rust она запускается первой. Здесь первая
строка объявляет функцию main, у которой нет параметров и которая ничего не
возвращает. Если бы параметры были, они бы стояли в круглых скобках (()).
Тело функции заключено в фигурные скобки {}. В Rust они обязательны вокруг
тела любой функции. Хорошим тоном считается ставить открывающую скобку на той
же строке, что и объявление функции, через один пробел.
Примечание: если хотите придерживаться единого стиля во всех проектах на
Rust, воспользуйтесь утилитой автоматического форматирования rustfmt —
она приведёт код к стандартному виду (подробнее о rustfmt — в
приложении D). Команда Rust включила её в
стандартную поставку Rust, как и rustc, так что она у вас, скорее всего,
уже установлена!
В теле функции main находится такой код:
#![allow(unused)]
fn main() {
println!("Hello, world!");
}
Эта строка и делает всю работу в нашей маленькой программе — выводит текст на экран. Здесь стоит обратить внимание на три важные детали.
Во-первых, println! — это вызов макроса Rust. Если бы вызывалась функция, мы
бы написали println (без !). Макросы в Rust — это способ писать код,
который генерирует другой код и тем самым расширяет синтаксис языка. Подробнее
мы поговорим о них в главе 20. А пока достаточно
знать: ! означает, что вызывается макрос, а не обычная функция, и что
макросы подчиняются не совсем тем же правилам, что функции.
Во-вторых, в коде есть строка "Hello, world!". Мы передаём её как аргумент в
println!, и макрос выводит её на экран.
В-третьих, строка кода заканчивается точкой с запятой (;). Она означает, что
это выражение закончилось и можно начинать следующее. Большинство строк кода
на Rust заканчиваются точкой с запятой.
Компиляция и запуск
Вы только что запустили новую программу — давайте разберём, что при этом происходило на каждом шаге.
Прежде чем запустить программу на Rust, её нужно скомпилировать компилятором
Rust: выполнить команду rustc и передать ей имя файла с исходным кодом:
$ rustc main.rs
Если вы писали на C или C++, то заметите, что это похоже на gcc или
clang. После успешной компиляции Rust создаёт исполняемый бинарный файл.
В Linux, macOS и PowerShell в Windows исполняемый файл можно увидеть командой
ls:
$ ls
main  main.rs
В Linux и macOS вы увидите два файла. В Windows файлов будет три — и в
PowerShell, и в CMD. В CMD вместо ls нужно ввести:
> dir /B %= ключ /B говорит выводить только имена файлов =%
main.exe
main.pdb
main.rs
Здесь мы видим файл с исходным кодом (расширение .rs), исполняемый файл (main.exe в Windows и просто main на остальных платформах), а в Windows ещё и файл с отладочной информацией с расширением .pdb. Теперь запустите main или main.exe:
$ ./main # или .\main в Windows
Если в main.rs лежит программа «Hello, world!», эта команда выведет в
терминал Hello, world!.
Если вы больше привыкли к динамическим языкам вроде Ruby, Python или JavaScript, вам может быть непривычно, что компиляция и запуск — это отдельные шаги. Rust — язык с предварительной компиляцией (ahead-of-time compiled): вы один раз компилируете программу и получаете исполняемый файл. Его можно отдать кому угодно, и он запустится даже там, где Rust не установлен. А вот если отдать кому-то файл .rb, .py или .js, у него должен быть установлен Ruby, Python или JavaScript соответственно. Зато в этих языках достаточно одной команды, чтобы и скомпилировать, и запустить программу. В дизайне языков всё — компромисс.
Для простых программ вполне хватит одного rustc. Но когда проект
разрастётся, вам понадобится управлять множеством настроек и удобно делиться
кодом с другими.
Дальше мы познакомимся с Cargo — инструментом, который поможет писать
настоящие, «боевые» программы на Rust.
Hello, Cargo!
Hello, Cargo!
Cargo — это система сборки и менеджер пакетов Rust. Большинство растацеанов управляют своими проектами именно через Cargo, потому что он берёт на себя массу рутины: собирает ваш код, а также скачивает и собирает библиотеки, которые нужны этому коду. (Библиотеки, которые нужны вашему коду, называют зависимостями.)
У простейших программ вроде той, что мы только что написали, зависимостей нет. Если бы мы собирали «Hello, world!» через Cargo, задействовалась бы только та его часть, что отвечает за сборку. Но когда программы станут сложнее, вы начнёте добавлять зависимости — и если проект с самого начала создан через Cargo, делать это будет гораздо проще.
Подавляющее большинство проектов на Rust используют Cargo, поэтому дальше в книге мы считаем, что и вы им пользуетесь. Если вы ставили Rust официальным установщиком, как описано в разделе «Установка», Cargo у вас уже есть. Если Rust установлен каким-то другим способом, проверьте, есть ли Cargo, такой командой:
$ cargo --version
Если появился номер версии — всё в порядке! Если же видите ошибку вроде
command not found, загляните в документацию к своему способу установки и
узнайте, как поставить Cargo отдельно.
Создание проекта с Cargo
Создадим новый проект с помощью Cargo и посмотрим, чем он отличается от нашего первого «Hello, world!». Вернитесь в папку projects (или туда, где вы решили хранить код) и в любой ОС выполните:
$ cargo new hello_cargo
$ cd hello_cargo
Первая команда создаёт новый проект с именем hello_cargo. Cargo создаёт его файлы в одноимённой папке.
Перейдите в папку hello_cargo и посмотрите, что в ней лежит. Cargo сгенерировал для нас два файла и одну папку: файл Cargo.toml и папку src с файлом main.rs внутри.
Кроме того, он инициализировал новый Git-репозиторий и создал файл
.gitignore. Если запустить cargo new внутри уже существующего
Git-репозитория, файлы Git создаваться не будут; это поведение можно
переопределить командой cargo new --vcs=git.
Примечание: Git — распространённая система контроля версий. С помощью флага
--vcs можно указать cargo new другую систему контроля версий или
отказаться от неё совсем. Все доступные варианты покажет
cargo new --help.
Откройте Cargo.toml в любимом редакторе. Он должен выглядеть примерно как в листинге 1-2.
[package]
name = "hello_cargo"
version = "0.1.0"
edition = "2024"

[dependencies]
cargo newФайл записан в формате TOML (Tom’s Obvious, Minimal Language — «очевидный минималистичный язык Тома»). В этом формате Cargo хранит настройки.
Первая строка, [package], — заголовок секции: следующие за ним строки
настраивают пакет. Когда мы будем добавлять в файл новую информацию, появятся
и другие секции.
Следующие три строки задают то, что нужно Cargo для компиляции программы: имя,
версию и редакцию Rust. О ключе edition мы поговорим в
приложении E.
Последняя строка, [dependencies], открывает секцию, где перечисляются
зависимости проекта. Пакеты кода в Rust называются крейтами (crates). Для
этого проекта другие крейты не нужны, а вот в первом проекте из главы 2 они
понадобятся — тогда мы этой секцией и воспользуемся.
Теперь откройте src/main.rs:
Файл: src/main.rs
fn main() {
    println!("Hello, world!");
}
Cargo сгенерировал для вас программу «Hello, world!» — точно такую же, как мы написали в листинге 1-1! От нашего первого проекта этот отличается только двумя вещами: код лежит в папке src, а в корне проекта есть файл настроек Cargo.toml.
Cargo ожидает, что исходный код находится в папке src. Корневая папка проекта — для README, информации о лицензии, файлов настроек и всего прочего, что не относится к коду. Cargo помогает держать проект в порядке: у каждой вещи своё место, и каждая вещь на своём месте.
Если вы начали проект без Cargo, как мы с «Hello, world!», его можно
перевести на Cargo: перенесите код в папку src и создайте подходящий
Cargo.toml. Проще всего получить этот Cargo.toml командой cargo init — она
создаст его автоматически.
Сборка и запуск проекта Cargo
Посмотрим, что меняется, когда программу «Hello, world!» собирает и запускает Cargo! Находясь в папке hello_cargo, соберите проект командой:
$ cargo build
   Compiling hello_cargo v0.1.0 (file:///projects/hello_cargo)
    Finished dev [unoptimized + debuginfo] target(s) in 2.85 secs
Эта команда создаёт исполняемый файл не в текущей папке, а в target/debug/hello_cargo (в Windows — target\debug\hello_cargo.exe). По умолчанию сборка отладочная, поэтому Cargo кладёт бинарник в папку debug. Запустить его можно так:
$ ./target/debug/hello_cargo # или .\target\debug\hello_cargo.exe в Windows
Hello, world!
Если всё прошло хорошо, в терминале появится Hello, world!. При первом
запуске cargo build Cargo также создаёт в корне проекта новый файл —
Cargo.lock. В нём записаны точные версии зависимостей проекта. У нашего
проекта зависимостей нет, поэтому файл почти пустой. Править его вручную
никогда не понадобится: его содержимым управляет Cargo.
Мы собрали проект через cargo build и запустили через
./target/debug/hello_cargo. Но можно сделать и то и другое одной командой —
cargo run скомпилирует код и сразу запустит получившийся файл:
$ cargo run
    Finished dev [unoptimized + debuginfo] target(s) in 0.0 secs
     Running `target/debug/hello_cargo`
Hello, world!
cargo run удобнее, чем помнить про cargo build и потом набирать полный путь
к бинарнику, поэтому большинство разработчиков пользуются именно ею.
Обратите внимание: на этот раз в выводе нет строки о том, что Cargo
компилирует hello_cargo. Cargo понял, что файлы не менялись, поэтому не стал
пересобирать проект, а просто запустил бинарник. Если бы вы изменили исходный
код, Cargo пересобрал бы проект перед запуском, и вывод был бы таким:
$ cargo run
   Compiling hello_cargo v0.1.0 (file:///projects/hello_cargo)
    Finished dev [unoptimized + debuginfo] target(s) in 0.33 secs
     Running `target/debug/hello_cargo`
Hello, world!
Есть у Cargo и команда cargo check. Она быстро проверяет, что код
компилируется, но исполняемый файл не создаёт:
$ cargo check
   Checking hello_cargo v0.1.0 (file:///projects/hello_cargo)
    Finished dev [unoptimized + debuginfo] target(s) in 0.32 secs
Зачем может понадобиться сборка без исполняемого файла? Дело в том, что
cargo check обычно работает намного быстрее cargo build — как раз потому,
что пропускает создание исполняемого файла. Если вы постоянно проверяете код,
пока его пишете, cargo check гораздо быстрее скажет, компилируется ли ещё ваш
проект! Поэтому многие растацеаны по ходу работы то и дело запускают
cargo check, а cargo build — только когда исполняемый файл действительно
нужен.
Подведём итог тому, что мы узнали о Cargo:
- Создать проект можно командой
cargo new. - Собрать проект — командой
cargo build. - Собрать и сразу запустить — командой
cargo run. - Проверить проект на ошибки, не создавая бинарник, — командой
cargo check. - Cargo складывает результат сборки не рядом с кодом, а в папку target/debug.
Ещё одно преимущество Cargo — его команды одинаковы в любой операционной системе. Поэтому дальше мы уже не будем давать отдельные инструкции для Linux и macOS и для Windows.
Сборка релиза
Когда проект наконец готов к выпуску, скомпилируйте его с оптимизациями
командой cargo build --release. Исполняемый файл окажется в target/release,
а не в target/debug. С оптимизациями программа работает быстрее, но
компилируется дольше. Поэтому профилей сборки два. Отладочный — для
разработки: код пересобирается часто, и сборка должна быть быстрой. Релизный —
для финальной версии, которую вы отдадите пользователям: её собирают редко, а
работать она должна как можно быстрее. Если вы замеряете время работы своего
кода, обязательно собирайте его через cargo build --release и измеряйте
исполняемый файл из target/release.
Опираемся на соглашения Cargo
В простых проектах Cargo не даёт заметного выигрыша по сравнению с голым
rustc, но чем сложнее программа, тем больше от него пользы. Как только в программе
становится несколько файлов или появляются зависимости, гораздо проще
доверить организацию сборки Cargo.
Хоть проект hello_cargo и простой, в нём уже задействована большая часть
настоящих инструментов, с которыми вы будете работать в Rust и дальше. По сути,
чтобы начать работу над любым существующим проектом, достаточно скачать код
через Git, перейти в папку проекта и собрать его:
$ git clone example.org/someproject
$ cd someproject
$ cargo build
Подробнее о Cargo читайте в его документации.
Итоги
Вы отлично начали путь в Rust! В этой главе вы научились:
- устанавливать последнюю стабильную версию Rust через
rustup; - обновлять Rust до новой версии;
- открывать локальную документацию;
- писать и запускать программу «Hello, world!» напрямую через
rustc; - создавать и запускать новый проект по соглашениям Cargo.
Самое время написать программу посерьёзнее, чтобы привыкнуть читать и писать код на Rust. Поэтому в главе 2 мы напишем игру «Угадай число». Если же вам хочется сначала разобраться, как в Rust устроены базовые понятия программирования, прочитайте главу 3, а потом вернитесь к главе 2.
Пишем игру «Угадай число»
Давайте сразу окунёмся в Rust и вместе напишем небольшой проект! В этой главе
вы на примере настоящей программы познакомитесь с несколькими базовыми
понятиями Rust: let, match, методами, ассоциированными функциями, внешними
крейтами и не только. В следующих главах мы разберём всё это подробнее, а
сейчас просто потренируемся на основах.
Мы напишем классическую задачку для начинающих — игру «Угадай число». Правила такие: программа загадывает случайное целое число от 1 до 100 и просит игрока его угадать. После каждой попытки программа сообщает, больше загаданное число или меньше. Если игрок угадал, программа поздравляет его и завершается.
Создаём новый проект
Перейдите в папку projects, которую вы создали в главе 1, и создайте новый проект через Cargo:
$ cargo new guessing_game
$ cd guessing_game
Первая команда, cargo new, принимает первым аргументом имя проекта
(guessing_game). Вторая переходит в папку нового проекта.
Посмотрите на сгенерированный файл Cargo.toml:
Файл: Cargo.toml
[package]
name = "guessing_game"
version = "0.1.0"
edition = "2024"

[dependencies]
Как вы уже видели в главе 1, cargo new генерирует программу «Hello, world!».
Загляните в файл src/main.rs:
Файл: src/main.rs
fn main() {
    println!("Hello, world!");
}
Теперь скомпилируем и сразу запустим эту программу командой cargo run:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.08s
     Running `target/debug/guessing_game`
Hello, world!
Команда run очень выручает, когда над проектом нужно работать короткими
итерациями, как мы будем делать с этой игрой: внесли изменение, быстро
проверили — и дальше.
Снова откройте файл src/main.rs. Весь код игры мы будем писать в нём.
Обрабатываем догадку игрока
Первая часть программы будет запрашивать у пользователя ввод, обрабатывать его и проверять, что он в ожидаемом формате. Для начала дадим игроку ввести свою догадку. Введите в src/main.rs код из листинга 2-1.
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}Здесь много всего, так что разберём код строка за строкой. Чтобы получить ввод
пользователя и вывести результат, нам понадобится библиотека ввода-вывода
io. Она входит в стандартную библиотеку, которая называется std, и её нужно
подключить в область видимости:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
Часть того, что определено в стандартной библиотеке, Rust автоматически подключает в область видимости любой программы. Этот набор называется прелюдией (prelude), и его полный состав можно посмотреть в документации стандартной библиотеки.
Если нужного типа в прелюдии нет, его придётся явно подключить инструкцией
use. Библиотека std::io даёт много полезного, в том числе возможность
читать ввод пользователя.
Как вы видели в главе 1, выполнение программы начинается с функции main:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
fn объявляет новую функцию, пустые круглые скобки () говорят, что
параметров у неё нет, а фигурная скобка { открывает тело функции.
Из главы 1 вы также знаете, что println! — это макрос, который выводит строку
на экран:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
Этот код выводит название игры и просит пользователя что-нибудь ввести.
Храним значения в переменных
Дальше создадим переменную, в которой будет храниться ввод пользователя:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
Вот теперь становится интересно! В этой коротенькой строке происходит
довольно много. Переменная создаётся инструкцией let. Вот ещё пример:
let apples = 5;Эта строка создаёт новую переменную apples и привязывает к ней значение 5.
В Rust переменные по умолчанию неизменяемые: раз присвоив переменной значение,
поменять его уже нельзя. Подробно мы поговорим об этом в разделе «Переменные
и изменяемость» главы 3. Чтобы
переменную можно было изменять, перед её именем пишут mut:
let apples = 5; // неизменяемая
let mut bananas = 5; // изменяемая
Примечание: // начинает комментарий, который продолжается до конца строки.
Всё, что в комментарии, Rust игнорирует. Подробнее о комментариях — в
главе 3.
Вернёмся к нашей игре. Теперь вы знаете, что let mut guess создаёт
изменяемую переменную с именем guess. Знак равенства (=) говорит Rust, что
мы сразу привязываем к переменной какое-то значение. Справа от знака равенства
— то самое значение: результат вызова String::new, функции, которая
возвращает новый экземпляр String. String — это
строковый тип из стандартной библиотеки: текст в кодировке UTF-8, который
может расти.
:: в ::new означает, что new — это ассоциированная функция типа String.
Ассоциированная функция — это функция, реализованная для типа, в данном
случае для String. Функция new создаёт новую пустую строку. Функцию new
вы встретите у многих типов: это общепринятое имя для функции, которая создаёт
новое значение того или иного рода.
Итак, строка let mut guess = String::new(); создаёт изменяемую переменную и
привязывает к ней новый пустой экземпляр String. Уф!
Получаем ввод пользователя
Напомним: в первой строке программы мы подключили средства ввода-вывода из
стандартной библиотеки — use std::io;. Теперь вызовем функцию stdin из
модуля io, чтобы обработать ввод пользователя:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
Если бы мы не подключили модуль io через use std::io; в начале программы,
функцию всё равно можно было бы вызвать, просто написав полный путь:
std::io::stdin. Функция stdin возвращает экземпляр
std::io::Stdin — это тип, представляющий
дескриптор (handle) стандартного ввода вашего терминала.
Следующая строка, .read_line(&mut guess), вызывает у этого дескриптора метод
read_line, чтобы получить ввод пользователя.
Аргументом мы передаём &mut guess — так read_line узнаёт, в какую строку
записать введённое. Работа read_line в том, чтобы взять всё, что пользователь
напечатал в стандартный ввод, и дописать это в конец строки (не затирая её
прежнее содержимое). Поэтому мы и передаём строку аргументом. Строка должна
быть изменяемой, иначе метод не сможет поменять её содержимое.
& означает, что аргумент — это ссылка (reference). Ссылки позволяют
разным частям кода обращаться к одним и тем же данным, не копируя их в памяти
много раз. Ссылки — сложная тема, и одно из главных преимуществ Rust как раз в
том, что пользоваться ими безопасно и просто. Чтобы дописать эту программу,
многие подробности знать не нужно. Пока достаточно того, что ссылки, как и
переменные, по умолчанию неизменяемые. Поэтому, чтобы ссылка была изменяемой,
нужно писать &mut guess, а не &guess. (Подробно ссылки разбираются в
главе 4.)
Обрабатываем возможный сбой с помощью Result
Мы всё ещё разбираем ту же строку кода. Сейчас речь пойдёт уже о третьей строке текста, но логически это по-прежнему одна строка кода. Её следующая часть — вот этот метод:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
Можно было записать весь этот код так:
io::stdin().read_line(&mut guess).expect("Failed to read line");Но одну длинную строку тяжело читать, поэтому лучше её разбить. Когда
вызываете методы через .имя_метода(), разумно переносить длинную цепочку
на новые строки и добавлять отступы. Теперь разберёмся, что же делает эта
строка.
Как мы уже говорили, read_line записывает введённое пользователем в
переданную строку, но кроме этого он ещё и возвращает значение типа Result.
Result — это перечисление
(enumeration, или коротко enum), то есть тип, значение которого может
находиться в одном из нескольких возможных состояний. Каждое такое состояние
называется вариантом.
Подробнее перечисления разбираются в главе 6. Типы
Result нужны для того, чтобы передавать информацию об ошибках.
У Result два варианта: Ok и Err. Ok означает, что операция прошла
успешно, и внутри него лежит полученное значение. Err означает, что операция
не удалась, и внутри него лежат сведения о том, как и почему это произошло.
У значений типа Result, как и у значений любого другого типа, есть методы.
Например, у Result есть метод expect. Если значение
Result — это Err, то expect аварийно завершит программу и выведет
сообщение, которое вы передали ему аргументом. (Если read_line вернул Err,
скорее всего, сбой произошёл в операционной системе.) Если же значение
Result — это Ok, то expect достанет из Ok лежащее там значение и вернёт
его, чтобы вы могли с ним работать. В нашем случае это количество байтов,
которые ввёл пользователь.
Если не вызвать expect, программа скомпилируется, но с предупреждением:
$ cargo build
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
warning: unused `Result` that must be used
  --> src/main.rs:10:5
   |
10 |     io::stdin().read_line(&mut guess);
   |     ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
   |
   = note: this `Result` may be an `Err` variant, which should be handled
   = note: `#[warn(unused_must_use)]` (part of `#[warn(unused)]`) on by default
help: use `let _ = ...` to ignore the resulting value
   |
10 |     let _ = io::stdin().read_line(&mut guess);
   |     +++++++

warning: `guessing_game` (bin "guessing_game") generated 1 warning
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.59s
Rust предупреждает, что вы никак не использовали значение Result, которое
вернул read_line, — а значит, программа не обрабатывает возможную ошибку.
Правильный способ избавиться от предупреждения — действительно написать
обработку ошибки. Но нам сейчас достаточно, чтобы программа просто падала при
любой проблеме, поэтому можно обойтись expect. Как восстанавливаться после
ошибок, вы узнаете в главе 9.
Выводим значения через заполнители println!
Кроме закрывающей фигурной скобки, в нашем коде осталась всего одна строка, которую мы ещё не разобрали:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
Она выводит строку, в которой теперь лежит ввод пользователя. Пара фигурных
скобок {} — это заполнитель (placeholder): представьте, что {} — это
маленькие крабьи клешни, которые держат значение на месте. Чтобы вывести
значение переменной, можно написать её имя прямо внутри фигурных скобок. А
чтобы вывести результат вычисления выражения, поставьте в строке формата
пустые фигурные скобки, а после строки через запятую перечислите выражения —
они по порядку подставятся в пустые заполнители. Вот как вывести переменную и
результат выражения одним вызовом println!:
#![allow(unused)]
fn main() {
let x = 5;
let y = 10;

println!("x = {x} and y + 2 = {}", y + 2);
}
Этот код выведет x = 5 and y + 2 = 12.
Проверяем первую часть
Проверим, как работает первая часть игры. Запустите её командой cargo run:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 6.44s
     Running `target/debug/guessing_game`
Guess the number!
Please input your guess.
6
You guessed: 6
Первая часть игры готова: мы получаем ввод с клавиатуры и выводим его.
Загадываем число
Теперь нужно загадать число, которое пользователь будет угадывать. Оно должно
каждый раз быть новым, иначе играть второй раз будет неинтересно. Возьмём
случайное число от 1 до 100, чтобы игра не была слишком сложной. В стандартной
библиотеке Rust пока нет генератора случайных чисел, но команда Rust выпускает
для этого крейт rand.
Расширяем возможности с помощью крейта
Напомним, что крейт — это набор файлов с исходным кодом на Rust. Проект,
который мы пишем, — это бинарный крейт, то есть исполняемая программа. А
rand — библиотечный крейт: его код предназначен для использования в других
программах, а сам по себе он не запускается.
Именно в работе с внешними крейтами Cargo по-настоящему блистает. Прежде чем
писать код с rand, нужно добавить этот крейт в зависимости в файле
Cargo.toml. Откройте файл и допишите в самый конец, под заголовком секции
[dependencies], который Cargo уже создал, следующую строку. Укажите rand
именно так, как у нас, с этим номером версии, — иначе примеры кода из этой
главы могут не заработать:
Файл: Cargo.toml
[dependencies]
rand = "0.10.1"
В Cargo.toml всё, что идёт после заголовка, относится к его секции — до тех
пор, пока не начнётся следующая. В [dependencies] вы перечисляете, от каких
внешних крейтов зависит проект и какие их версии нужны. Здесь мы указали крейт
rand со спецификатором семантической версии 0.10.1. Cargo понимает
семантическое версионирование (его ещё называют
SemVer) — стандарт записи номеров версий. Спецификатор 0.10.1 — это на
самом деле сокращение для ^0.10.1, то есть «любая версия не ниже 0.10.1, но
ниже 0.11.0».
Cargo считает, что у всех этих версий публичный API совместим с версией 0.10.1. Такая запись гарантирует, что вы получите самый свежий патч-релиз, который всё ещё будет компилироваться с кодом из этой главы. А вот у версий 0.11.0 и выше API может уже отличаться от того, что используется в примерах ниже.
Теперь, ничего не меняя в коде, соберём проект, как показано в листинге 2-2.
$ cargo build
    Updating crates.io index
     Locking 8 packages to latest Rust 1.96.0 compatible versions
  Downloaded rand_core v0.10.1
  Downloaded chacha20 v0.10.1
  Downloaded rand v0.10.1
  Downloaded 3 crates (162.9KiB) in 0.59s
   Compiling libc v0.2.186
   Compiling rand_core v0.10.1
   Compiling getrandom v0.4.3
   Compiling cfg-if v1.0.4
   Compiling chacha20 v0.10.1
   Compiling rand v0.10.1
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 2.03s
cargo build после добавления крейта rand в зависимостиУ вас могут быть другие номера версий (но все они будут совместимы с кодом — спасибо SemVer!) и другие строки (в зависимости от операционной системы), да и порядок строк может отличаться.
Когда мы добавляем внешнюю зависимость, Cargo скачивает последние версии всего, что ей нужно, из реестра (registry) — копии данных с Crates.io. Crates.io — это место, где участники экосистемы Rust публикуют свои открытые проекты, чтобы ими могли пользоваться другие.
Обновив реестр, Cargo проверяет секцию [dependencies] и скачивает
перечисленные там крейты, если их ещё нет. Обратите внимание: хотя в
зависимостях мы указали только rand, Cargo скачал и другие крейты — те, без
которых не работает сам rand. Скачав крейты, Rust компилирует их, а затем
компилирует наш проект, в котором эти зависимости уже доступны.
Если сразу же, ничего не меняя, снова запустить cargo build, в выводе будет
только строка Finished. Cargo знает, что зависимости уже скачаны и
скомпилированы, а в Cargo.toml вы их не меняли. Знает он и то, что ваш код
тоже не менялся, так что и его перекомпилировать не нужно. Делать нечего —
Cargo просто завершается.
Если открыть src/main.rs, внести какое-нибудь пустяковое изменение, сохранить и собрать снова, вывод будет из двух строк:
$ cargo build
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.13s
По этим строкам видно, что Cargo пересобрал только то, что затронуло ваше крошечное изменение в src/main.rs. Зависимости не менялись, поэтому Cargo повторно использует то, что уже скачал и скомпилировал.
Воспроизводимые сборки
В Cargo есть механизм, который гарантирует, что при каждой сборке кода — вами
или кем-то ещё — получится один и тот же результат: пока вы явно не укажете
иное, Cargo будет использовать только те версии зависимостей, что вы выбрали.
Допустим, на следующей неделе выйдет версия 0.10.2 крейта rand. В ней
исправлена важная ошибка, но заодно появилась регрессия, которая ломает ваш
код. На этот случай при первом запуске cargo build Rust создаёт файл
Cargo.lock — он уже лежит у нас в папке guessing_game.
При первой сборке проекта Cargo подбирает версии всех зависимостей,
подходящие под условия, и записывает их в Cargo.lock. При следующих сборках
Cargo видит, что Cargo.lock уже есть, и берёт версии оттуда, а не подбирает
их заново. Так сборка автоматически становится воспроизводимой. Иначе говоря,
благодаря Cargo.lock ваш проект будет использовать rand 0.10.1, пока вы
явно не обновите его. Поскольку Cargo.lock так важен для воспроизводимости,
его обычно хранят в системе контроля версий вместе с остальным кодом.
Обновляем крейт до новой версии
Когда вы всё-таки хотите обновить крейт, воспользуйтесь командой Cargo
update. Она проигнорирует Cargo.lock, подберёт самые свежие версии,
подходящие под условия из Cargo.toml, и запишет их в Cargo.lock. При этом
по умолчанию Cargo будет искать только версии выше 0.10.1 и ниже 0.11.0. Если
у крейта rand вышли две новые версии, 0.10.2 и 0.999.0, то cargo update
выведет следующее:
$ cargo update
    Updating crates.io index
     Locking 1 package to latest Rust 1.96.0 compatible version
    Updating rand v0.10.1 -> v0.10.2 (available: v0.999.0)
Версию 0.999.0 Cargo проигнорирует. Заодно вы заметите, что в Cargo.lock
теперь записано: используется rand версии 0.10.2. Чтобы перейти на rand
0.999.0 или любую версию из серии 0.999.x, нужно изменить Cargo.toml вот
так (но на самом деле не меняйте — примеры ниже рассчитаны на rand 0.10):
[dependencies]
rand = "0.999.0"
При следующем запуске cargo build Cargo обновит реестр доступных крейтов и
заново подберёт rand в соответствии с новой версией, которую вы указали.
О Cargo и его экосистеме можно рассказать ещё очень многое — мы займёмся этим в главе 14, а пока этого достаточно. Cargo очень упрощает повторное использование библиотек, поэтому растацеаны могут писать небольшие проекты, собирая их из множества готовых пакетов.
Генерируем случайное число
Начнём пользоваться rand, чтобы загадать число. Обновите src/main.rs, как
показано в листинге 2-3.
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    println!("The secret number is: {secret_number}");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}Сначала мы добавляем строку use rand::prelude::*;. В модуле prelude собраны
самые часто используемые части крейта rand, а use делает их доступными в
области видимости нашей программы.
Затем в середину программы добавляются две строки. В первой мы вызываем
функцию rand::rng и получаем генератор случайных чисел, которым будем
пользоваться. У каждого потока выполнения такой генератор свой, а начальное
значение (seed) он берёт у операционной системы. Затем у
генератора вызывается метод random_range. Этот метод определён в трейте
RngExt, который входит в модуль rand::prelude, — мы подключили его
инструкцией use rand::prelude::*;. Метод random_range принимает аргументом
выражение диапазона и генерирует случайное число из этого диапазона. Мы
используем диапазон вида начало..=конец, который включает обе границы,
поэтому, чтобы получить число от 1 до 100, пишем 1..=100.
Примечание: заранее знать, что подключать и какие методы и функции крейта
вызывать, невозможно, поэтому у каждого крейта есть документация с
инструкциями. Ещё одна приятная возможность Cargo: команда
cargo doc --open локально собирает документацию всех ваших зависимостей и
открывает её в браузере. Если вам, например, интересно, что ещё умеет крейт
rand, выполните cargo doc --open и нажмите на rand в боковой панели
слева.
Вторая новая строка выводит загаданное число. Пока мы разрабатываем программу, это удобно для проверки, но из финальной версии мы её уберём. Какая же это игра, если программа сразу выдаёт ответ!
Запустите программу несколько раз:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.02s
     Running `target/debug/guessing_game`
Guess the number!
The secret number is: 7
Please input your guess.
4
You guessed: 4

$ cargo run
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.02s
     Running `target/debug/guessing_game`
Guess the number!
The secret number is: 83
Please input your guess.
5
You guessed: 5
Числа каждый раз должны быть разными, но все — от 1 до 100. Если появляются
предупреждения, их можно смело игнорировать. Если же появляются ошибки,
проверьте, что в Cargo.toml указано rand = "0.10.1": у будущих версий
rand API может отличаться, а вот с любой версией из серии 0.10 код из этой
главы должен работать.
Сравниваем догадку с загаданным числом
Теперь, когда у нас есть ввод пользователя и случайное число, их можно сравнить. Этот шаг показан в листинге 2-4. Обратите внимание: пока этот код не скомпилируется — почему, мы сейчас объясним.
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    // --пропуск--
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    println!("The secret number is: {secret_number}");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");

    match guess.cmp(&secret_number) {
        Ordering::Less => println!("Too small!"),
        Ordering::Greater => println!("Too big!"),
        Ordering::Equal => println!("You win!"),
    }
}Сначала мы добавляем ещё одну инструкцию use, которая подключает из
стандартной библиотеки тип std::cmp::Ordering. Ordering — это ещё одно
перечисление, у него три варианта: Less (меньше), Greater (больше) и
Equal (равно). Это три возможных исхода сравнения двух значений.
Затем мы добавляем внизу пять новых строк, где используется тип Ordering.
Метод cmp сравнивает два значения; его можно вызвать у всего, что вообще
можно сравнивать. Он принимает ссылку на то, с чем сравнивать: здесь мы
сравниваем guess с secret_number. Результат — один из вариантов
перечисления Ordering, которое мы подключили через use. С помощью выражения
match мы решаем, что делать дальше, в зависимости от
того, какой вариант Ordering вернул вызов cmp для guess и
secret_number.
Выражение match состоит из веток (arms). Каждая ветка — это пара:
образец (pattern) и код. Если значение, переданное в match, подходит под
образец ветки, выполняется код этой ветки. Rust берёт
значение, переданное в match, и по очереди проверяет образцы всех веток.
Образцы и конструкция match — мощные возможности Rust: они позволяют описать
самые разные ситуации, в которые может попасть ваш код, и гарантируют, что вы
обработаете их все. Подробно эти возможности разбираются в главах 6 и 19.
Разберём на примере, как работает наше выражение match. Допустим,
пользователь ввёл 50, а загаданное на этот раз число — 38.
Код сравнивает 50 с 38, и метод cmp возвращает Ordering::Greater, потому
что 50 больше 38. Выражение match получает значение Ordering::Greater и
начинает проверять образцы веток. Образец первой ветки — Ordering::Less;
значение Ordering::Greater с ним не совпадает, поэтому код этой ветки
пропускается и проверяется следующая. Образец следующей ветки —
Ordering::Greater, и он совпадает с Ordering::Greater! Выполняется код
этой ветки, и на экран выводится Too big!. Выражение match завершается
после первого же совпадения, так что последнюю ветку в этом случае оно даже не
проверяет.
Однако код из листинга 2-4 пока не компилируется. Попробуем:
$ cargo build
   Compiling libc v0.2.186
   Compiling rand_core v0.10.1
   Compiling cfg-if v1.0.0
   Compiling getrandom v0.4.3
   Compiling chacha20 v0.10.1
   Compiling rand v0.10.1
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
error[E0308]: mismatched types
  --> src/main.rs:23:21
   |
23 |     match guess.cmp(&secret_number) {
   |                 --- ^^^^^^^^^^^^^^ expected `&String`, found `&{integer}`
   |                 |
   |                 arguments to this method are incorrect
   |
   = note: expected reference `&String`
              found reference `&{integer}`
note: method defined here
  --> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/cmp.rs:1000:7

For more information about this error, try `rustc --explain E0308`.
error: could not compile `guessing_game` (bin "guessing_game") due to 1 previous error
Суть ошибки — несовпадение типов (mismatched types). В Rust сильная
статическая система типов, но при этом в нём есть выведение типов. Когда мы
написали let mut guess = String::new(), Rust сам понял, что guess должна
быть типа String, и не заставил нас указывать тип. А вот secret_number —
числового типа. Значение от 1 до 100 могут хранить несколько числовых типов
Rust: i32 (32-битное число), u32 (32-битное беззнаковое), i64
(64-битное) и другие. Если не сказано иное, Rust по умолчанию выбирает i32 —
именно такой тип и будет у secret_number, если где-то ещё в коде не окажется
подсказки, из которой Rust выведет другой числовой тип. А ошибка возникает
потому, что Rust не умеет сравнивать строку с числом.
В итоге нам нужно превратить String, которую программа прочитала из ввода, в
число, чтобы сравнивать его с загаданным уже как число с числом. Для этого
добавим в тело функции main такую строку:
Файл: src/main.rs
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    println!("The secret number is: {secret_number}");

    println!("Please input your guess.");

    // --пропуск--

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    let guess: u32 = guess.trim().parse().expect("Please type a number!");

    println!("You guessed: {guess}");

    match guess.cmp(&secret_number) {
        Ordering::Less => println!("Too small!"),
        Ordering::Greater => println!("Too big!"),
        Ordering::Equal => println!("You win!"),
    }
}
Вот она:
let guess: u32 = guess.trim().parse().expect("Please type a number!");Мы создаём переменную с именем guess. Но постойте, разве в программе уже нет
переменной guess? Есть, но Rust любезно позволяет затенить (shadow)
прежнее значение guess новым. Затенение позволяет снова использовать имя
guess, а не заводить две разные переменные вроде guess_str и guess.
Подробнее мы поговорим об этом в главе 3, а пока
просто запомните: этим часто пользуются, когда нужно преобразовать значение из
одного типа в другой.
Новую переменную мы привязываем к выражению guess.trim().parse(). guess в
этом выражении — это исходная переменная, в которой лежит ввод в виде строки.
Метод trim у экземпляра String убирает пробельные символы в начале и в
конце строки. Это обязательно нужно сделать, прежде чем превращать строку в
u32: тип u32 может хранить только число. Чтобы read_line принял догадку,
пользователь должен нажать enter, а это добавляет в строку символ
перевода строки. Например, если пользователь ввёл 5 и нажал
enter, в guess окажется 5\n, где \n — это «перевод строки».
(В Windows enter добавляет возврат каретки и перевод строки: \r\n.)
Метод trim убирает \n или \r\n, и остаётся просто 5.
Метод parse у строк преобразует строку в другой тип.
Здесь с его помощью мы получаем из строки число. Rust нужно подсказать, какой
именно числовой тип нам нужен, — для этого мы пишем let guess: u32.
Двоеточие (:) после guess говорит Rust, что дальше идёт аннотация типа
переменной. В Rust есть несколько встроенных числовых типов; u32 — это
беззнаковое 32-битное целое. Для небольшого положительного числа это хороший
выбор по умолчанию. О других числовых типах вы узнаете в
главе 3.
Кроме того, раз мы указали u32 и сравниваем guess с secret_number, Rust
выведет, что secret_number тоже должна быть типа u32. Так что теперь
сравниваются два значения одного типа!
Метод parse работает только с символами, которые по смыслу можно превратить
в число, поэтому легко может закончиться ошибкой. Если, например, в строке
A👍%, превратить это в число никак не получится. Раз parse может не
сработать, он возвращает Result — точно так же, как метод read_line (мы
обсуждали это выше, в разделе «Обрабатываем возможный сбой с помощью
Result»). И
обработаем мы этот Result так же — снова методом expect. Если parse не
сможет получить из строки число и вернёт вариант Err, вызов expect уронит
игру и выведет наше сообщение. Если же parse успешно преобразует строку в
число, он вернёт вариант Ok, а expect достанет из него нужное нам число.
Запустим программу:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.26s
     Running `target/debug/guessing_game`
Guess the number!
The secret number is: 58
Please input your guess.
  76
You guessed: 76
Too big!
Отлично! Хотя перед числом стояли пробелы, программа всё равно поняла, что пользователь ввёл 76. Запустите программу несколько раз и проверьте, как она ведёт себя при разном вводе: угадайте число, введите слишком большое и слишком маленькое.
Почти вся игра уже работает, но пользователь может сделать только одну попытку. Исправим это, добавив цикл!
Даём несколько попыток с помощью цикла
Ключевое слово loop создаёт бесконечный цикл. Добавим его, чтобы у игрока
было больше попыток угадать число:
Файл: src/main.rs
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    // --пропуск--

    println!("The secret number is: {secret_number}");

    loop {
        println!("Please input your guess.");

        // --пропуск--


        let mut guess = String::new();

        io::stdin()
            .read_line(&mut guess)
            .expect("Failed to read line");

        let guess: u32 = guess.trim().parse().expect("Please type a number!");

        println!("You guessed: {guess}");

        match guess.cmp(&secret_number) {
            Ordering::Less => println!("Too small!"),
            Ordering::Greater => println!("Too big!"),
            Ordering::Equal => println!("You win!"),
        }
    }
}
Как видите, мы перенесли в цикл всё, начиная с приглашения ввести догадку. Не забудьте сдвинуть строки внутри цикла ещё на четыре пробела и запустите программу снова. Теперь она будет бесконечно просить новую догадку — и тут возникает новая проблема: пользователь, похоже, никак не может выйти!
Конечно, пользователь всегда может прервать программу сочетанием клавиш
ctrl-C. Но есть и другой способ вырваться из лап этого
ненасытного монстра. Мы уже упоминали его, когда обсуждали parse в разделе
«Сравниваем догадку с загаданным
числом»: если ввести
не число, программа упадёт. Этим можно воспользоваться, чтобы выйти из игры:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.23s
     Running `target/debug/guessing_game`
Guess the number!
The secret number is: 59
Please input your guess.
45
You guessed: 45
Too small!
Please input your guess.
60
You guessed: 60
Too big!
Please input your guess.
59
You guessed: 59
You win!
Please input your guess.
quit

thread 'main' (6694925) panicked at src/main.rs:28:47:
Please type a number!: ParseIntError { kind: InvalidDigit }
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
Если ввести quit, игра завершится — но, как вы заметили, она завершится и от
любого другого ввода, который не является числом. Мягко говоря, не лучшее
решение. К тому же игра должна заканчиваться, когда число угадано.
Выход после правильного ответа
Сделаем так, чтобы при победе игра завершалась, — добавим инструкцию break:
Файл: src/main.rs
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    println!("The secret number is: {secret_number}");

    loop {
        println!("Please input your guess.");

        let mut guess = String::new();

        io::stdin()
            .read_line(&mut guess)
            .expect("Failed to read line");

        let guess: u32 = guess.trim().parse().expect("Please type a number!");

        println!("You guessed: {guess}");

        // --пропуск--

        match guess.cmp(&secret_number) {
            Ordering::Less => println!("Too small!"),
            Ordering::Greater => println!("Too big!"),
            Ordering::Equal => {
                println!("You win!");
                break;
            }
        }
    }
}
Строка break после You win! выводит программу из цикла, когда пользователь
угадал число. А раз цикл — последнее, что есть в main, выход из цикла
означает и выход из программы.
Обработка некорректного ввода
Доведём поведение игры до ума: пусть при вводе не-числа программа не падает, а
просто игнорирует такой ввод, и пользователь угадывает дальше. Для этого
изменим строку, где guess преобразуется из String в u32, как показано в
листинге 2-5.
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    println!("The secret number is: {secret_number}");

    loop {
        println!("Please input your guess.");

        let mut guess = String::new();

        // --пропуск--

        io::stdin()
            .read_line(&mut guess)
            .expect("Failed to read line");

        let guess: u32 = match guess.trim().parse() {
            Ok(num) => num,
            Err(_) => continue,
        };

        println!("You guessed: {guess}");

        // --пропуск--

        match guess.cmp(&secret_number) {
            Ordering::Less => println!("Too small!"),
            Ordering::Greater => println!("Too big!"),
            Ordering::Equal => {
                println!("You win!");
                break;
            }
        }
    }
}Мы заменили вызов expect на выражение match: теперь программа не падает
при ошибке, а обрабатывает её. Напомним, что parse возвращает Result, а
Result — это перечисление с вариантами Ok и Err. Мы используем здесь
match так же, как раньше для результата Ordering, который возвращал метод
cmp.
Если parse удалось превратить строку в число, он вернёт значение Ok с этим
числом внутри. Ok совпадёт с образцом первой ветки, и выражение match
просто вернёт число num, которое parse положил внутрь Ok. Это число
окажется ровно там, где нам нужно, — в новой переменной guess, которую мы
создаём.
Если же parse не удалось превратить строку в число, он вернёт значение
Err с подробностями об ошибке. Err не совпадает с образцом Ok(num) из
первой ветки, зато совпадает с образцом Err(_) из второй. Подчёркивание _ —
это «подходит что угодно»: здесь мы говорим, что нас устраивает любое значение
Err, что бы у него ни было внутри. Поэтому программа выполнит код второй
ветки — continue, то есть перейдёт к следующей итерации цикла loop и
попросит новую догадку. В итоге программа просто игнорирует любые ошибки,
которые может вернуть parse!
Теперь всё в программе должно работать как задумано. Проверим:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.13s
     Running `target/debug/guessing_game`
Guess the number!
The secret number is: 61
Please input your guess.
10
You guessed: 10
Too small!
Please input your guess.
99
You guessed: 99
Too big!
Please input your guess.
foo
Please input your guess.
61
You guessed: 61
You win!
Потрясающе! Осталась последняя мелочь — и игра готова. Помните, что программа
всё ещё выводит загаданное число? Для проверки это было удобно, но игру
портит. Удалим println!, который выводит загаданное число. Финальный код —
в листинге 2-6.
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    loop {
        println!("Please input your guess.");

        let mut guess = String::new();

        io::stdin()
            .read_line(&mut guess)
            .expect("Failed to read line");

        let guess: u32 = match guess.trim().parse() {
            Ok(num) => num,
            Err(_) => continue,
        };

        println!("You guessed: {guess}");

        match guess.cmp(&secret_number) {
            Ordering::Less => println!("Too small!"),
            Ordering::Greater => println!("Too big!"),
            Ordering::Equal => {
                println!("You win!");
                break;
            }
        }
    }
}Вот и всё — вы написали игру «Угадай число». Поздравляем!
Итоги
Этот проект на практике познакомил вас со многими новыми понятиями Rust:
let, match, функциями, использованием внешних крейтов и другими. В
следующих нескольких главах мы разберём их подробнее. Глава 3 рассказывает о
том, что есть почти в любом языке программирования, — переменных, типах данных
и функциях — и о том, как с ними работать в Rust. Глава 4 посвящена владению —
тому, что отличает Rust от других языков. В главе 5 речь пойдёт о структурах и
синтаксисе методов, а в главе 6 — о том, как устроены перечисления.
Основные понятия программирования
В этой главе речь пойдёт о понятиях, которые есть почти в любом языке программирования, и о том, как они устроены в Rust. В основе своей многие языки очень похожи. Ничего из того, о чём рассказывается в этой главе, не уникально для Rust, но мы рассмотрим всё это именно в контексте Rust и объясним, какие соглашения здесь приняты.
А именно: вы узнаете о переменных, базовых типах, функциях, комментариях и управлении потоком выполнения. Всё это встречается в каждой программе на Rust, и если освоить эти основы пораньше, у вас будет прочный фундамент для дальнейшего изучения.
Ключевые слова
Как и в других языках, в Rust есть набор ключевых слов, которые зарезервированы для самого языка. Помните, что использовать их в качестве имён переменных или функций нельзя. У большинства ключевых слов есть особое значение, и вы будете применять их для самых разных задач в своих программах. У некоторых пока нет никакого назначения: они зарезервированы под возможности, которые, возможно, появятся в Rust в будущем. Список ключевых слов есть в приложении A.
Переменные и изменяемость
Переменные и изменяемость
Как мы уже говорили в разделе «Храним значения в переменных», по умолчанию переменные неизменяемые. Так Rust подталкивает вас к коду, который безопаснее и который проще сделать конкурентным. Тем не менее вы всё равно можете сделать переменную изменяемой. Давайте разберёмся, как и почему Rust советует предпочитать неизменяемость и когда от неё имеет смысл отказаться.
Если переменная неизменяемая, то после того, как значение привязано к имени,
изменить это значение уже нельзя. Чтобы это увидеть, создайте в папке
projects новый проект variables командой cargo new variables.
Затем в новой папке variables откройте src/main.rs и замените код в нём на следующий (пока он не скомпилируется):
Файл: src/main.rs
fn main() {
    let x = 5;
    println!("The value of x is: {x}");
    x = 6;
    println!("The value of x is: {x}");
}
Сохраните файл и запустите программу командой cargo run. Вы получите
сообщение об ошибке, связанной с неизменяемостью:
$ cargo run
   Compiling variables v0.1.0 (file:///projects/variables)
error[E0384]: cannot assign twice to immutable variable `x`
 --> src/main.rs:4:5
  |
2 |     let x = 5;
  |         - first assignment to `x`
3 |     println!("The value of x is: {x}");
4 |     x = 6;
  |     ^^^^^ cannot assign twice to immutable variable
  |
help: consider making this binding mutable
  |
2 |     let mut x = 5;
  |         +++

For more information about this error, try `rustc --explain E0384`.
error: could not compile `variables` (bin "variables") due to 1 previous error
Этот пример показывает, как компилятор помогает находить ошибки в программах. Ошибки компиляции бывают неприятны, но означают они лишь одно: программа пока не может безопасно сделать то, что вы задумали. Они вовсе не означают, что вы плохой программист! Даже опытные растацеаны постоянно получают ошибки компиляции.
Сообщение cannot assign twice to immutable variable `x` («нельзя дважды
присвоить значение неизменяемой переменной x») появилось потому, что вы
попытались присвоить второе значение неизменяемой переменной x.
Очень важно, что попытка изменить значение, объявленное неизменяемым, ловится ещё при компиляции: именно такие ситуации и приводят к багам. Представьте: одна часть кода исходит из того, что значение никогда не меняется, а другая часть его меняет. Тогда первая часть может перестать работать так, как задумано. Найти причину такого бага потом бывает непросто — особенно если вторая часть кода меняет значение лишь иногда. Компилятор Rust гарантирует: если вы сказали, что значение не изменится, оно действительно не изменится, и следить за этим самому не нужно. Поэтому о таком коде проще рассуждать.
Но и изменяемость бывает очень полезна: с ней некоторый код писать удобнее.
Хотя переменные по умолчанию неизменяемые, их можно сделать изменяемыми,
добавив mut перед именем, — как вы делали в главе
2. Кроме того, mut сообщает
будущим читателям кода о вашем намерении: другие части кода будут менять
значение этой переменной.
Например, изменим src/main.rs так:
Файл: src/main.rs
fn main() {
    let mut x = 5;
    println!("The value of x is: {x}");
    x = 6;
    println!("The value of x is: {x}");
}
Теперь программа выводит:
$ cargo run
   Compiling variables v0.1.0 (file:///projects/variables)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.30s
     Running `target/debug/variables`
The value of x is: 5
The value of x is: 6
Благодаря mut мы можем поменять значение, привязанное к x, с 5 на 6. В
конечном счёте решать, использовать изменяемость или нет, — вам: выбирайте то,
что в конкретной ситуации делает код понятнее.
Константы
Константы, как и неизменяемые переменные, — это значения, привязанные к имени, которые нельзя менять. Но между константами и переменными есть несколько различий.
Во-первых, с константами нельзя использовать mut. Константы не просто
неизменяемы по умолчанию — они неизменяемы всегда. Объявляются они ключевым
словом const, а не let, и тип значения обязательно нужно указать. О
типах и их аннотациях мы поговорим в следующем разделе, «Типы
данных», так что пока не беспокойтесь о
подробностях. Просто запомните: тип константы указывается всегда.
Во-вторых, константы можно объявлять в любой области видимости, в том числе в глобальной. Поэтому они удобны для значений, которые нужны многим частям кода.
И последнее отличие: значением константы может быть только константное выражение — то, что можно вычислить при компиляции, а не то, что становится известно лишь во время работы программы.
Вот пример объявления константы:
#![allow(unused)]
fn main() {
const THREE_HOURS_IN_SECONDS: u32 = 60 * 60 * 3;
}
Константа называется THREE_HOURS_IN_SECONDS (три часа в секундах), а её
значение — произведение 60 (секунд в минуте) на 60 (минут в часе) и на 3
(столько часов нам нужно посчитать в этой программе). По соглашению имена
констант в Rust пишут заглавными буквами, разделяя слова подчёркиваниями.
Компилятор умеет вычислять при компиляции ограниченный набор операций. Поэтому
мы можем записать значение в виде, который проще понять и проверить, а не
просто вписать 10 800. Какие операции допустимы при объявлении констант,
описано в разделе о вычислении констант в справочнике Rust.
Константа доступна всё время, пока работает программа, — в той области видимости, где она объявлена. Поэтому константы удобны для значений из предметной области приложения, которые нужны разным частям программы: скажем, максимальное число очков, которое может набрать игрок, или скорость света.
Если значение зашито в код и используется по всей программе, лучше объявить его константой с понятным именем: тем, кто будет читать код после вас, будет проще понять, что это за число. Кроме того, если когда-нибудь его понадобится поменять, это придётся сделать лишь в одном месте.
Затенение
Как вы видели в игре «Угадай число» в главе
2, можно объявить
новую переменную с тем же именем, что и у предыдущей. Растацеаны говорят, что
вторая переменная затеняет (shadows) первую. Это значит, что, когда вы
используете это имя, компилятор видит вторую переменную. По сути, вторая
переменная заслоняет первую и забирает все обращения к этому имени себе — пока
её саму не затенят или пока не закончится область видимости. Чтобы затенить
переменную, достаточно ещё раз написать let с тем же именем:
Файл: src/main.rs
fn main() {
    let x = 5;

    let x = x + 1;

    {
        let x = x * 2;
        println!("The value of x in the inner scope is: {x}");
    }

    println!("The value of x is: {x}");
}
Сначала программа привязывает x к значению 5. Затем повторное let x =
создаёт новую переменную x: берёт исходное значение и прибавляет 1, так что
теперь x равно 6. Дальше, во внутренней области видимости, созданной
фигурными скобками, третья инструкция let снова затеняет x и создаёт новую
переменную, умножая предыдущее значение на 2, — теперь x равно 12. Когда
внутренняя область видимости заканчивается, заканчивается и это затенение, и
x снова равно 6. Программа выведет:
$ cargo run
   Compiling variables v0.1.0 (file:///projects/variables)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.31s
     Running `target/debug/variables`
The value of x in the inner scope is: 12
The value of x is: 6
Затенение — не то же самое, что mut. Если мы случайно попробуем присвоить
этой переменной новое значение без let, то получим ошибку компиляции.
Используя let, мы можем выполнить над значением несколько преобразований, а
после них переменная останется неизменяемой.
Есть и второе отличие от mut: при повторном let мы фактически создаём новую
переменную, поэтому можем поменять тип значения, сохранив прежнее имя.
Допустим, программа просит пользователя ввести столько пробелов, сколько он
хочет видеть между фрагментами текста. Получив ввод, мы хотим хранить уже не
сами пробелы, а их количество:
fn main() {
    let spaces = "   ";
    let spaces = spaces.len();
}
Первая переменная spaces — строкового типа, а вторая — числового. Благодаря
затенению не нужно придумывать разные имена вроде spaces_str и spaces_num:
можно снова использовать простое spaces. А вот если попытаться сделать то же
самое с mut, получим ошибку компиляции:
fn main() {
    let mut spaces = "   ";
    spaces = spaces.len();
}
Ошибка говорит, что тип переменной менять нельзя:
$ cargo run
   Compiling variables v0.1.0 (file:///projects/variables)
error[E0308]: mismatched types
 --> src/main.rs:3:14
  |
2 |     let mut spaces = "   ";
  |                      ----- expected due to this value
3 |     spaces = spaces.len();
  |              ^^^^^^^^^^^^ expected `&str`, found `usize`

For more information about this error, try `rustc --explain E0308`.
error: could not compile `variables` (bin "variables") due to 1 previous error
Теперь, когда мы разобрались, как работают переменные, посмотрим, какие типы данных у них бывают.
Типы данных
Типы данных
Каждое значение в Rust имеет определённый тип данных. Тип говорит Rust, что это за данные, а значит, как с ними работать. Мы рассмотрим две группы типов: скалярные и составные.
Помните, что Rust — язык со статической типизацией: типы всех переменных
должны быть известны уже при компиляции. Обычно компилятор сам выводит нужный
тип по значению и по тому, как оно используется. Но если подходит сразу
несколько типов — как в разделе «Сравниваем догадку с загаданным
числом» главы 2,
когда мы превращали String в число методом parse, — нужно добавить
аннотацию типа:
#![allow(unused)]
fn main() {
let guess: u32 = "42".parse().expect("Not a number!");
}
Если убрать аннотацию : u32, Rust выдаст следующую ошибку. Она означает, что
компилятору не хватает информации, чтобы понять, какой тип мы имеем в виду:
$ cargo build
   Compiling no_type_annotations v0.1.0 (file:///projects/no_type_annotations)
error[E0284]: type annotations needed
 --> src/main.rs:2:9
  |
2 |     let guess = "42".parse().expect("Not a number!");
  |         ^^^^^        ----- type must be known at this point
  |
  = note: cannot satisfy `<_ as FromStr>::Err == _`
help: consider giving `guess` an explicit type
  |
2 |     let guess: /* Type */ = "42".parse().expect("Not a number!");
  |              ++++++++++++

For more information about this error, try `rustc --explain E0284`.
error: could not compile `no_type_annotations` (bin "no_type_annotations") due to 1 previous error
Для других типов данных аннотации выглядят по-разному — вы это ещё увидите.
Скалярные типы
Скалярный тип представляет одно значение. В Rust четыре основных скалярных типа: целые числа, числа с плавающей точкой, логические значения и символы. Скорее всего, вы встречали их и в других языках. Посмотрим, как они устроены в Rust.
Целочисленные типы
Целое число — это число без дробной части. В главе 2 мы уже пользовались
одним целочисленным типом — u32. Такое объявление типа говорит, что
значение — беззнаковое целое (у знаковых типов вместо u в начале стоит i) и
занимает 32 бита. В таблице 3-1 перечислены встроенные целочисленные типы
Rust. Любой из них можно указать как тип целого числа.
Таблица 3-1: Целочисленные типы в Rust
| Размер | Знаковый | Беззнаковый |
|---|---|---|
| 8 бит | i8 | u8 |
| 16 бит | i16 | u16 |
| 32 бита | i32 | u32 |
| 64 бита | i64 | u64 |
| 128 бит | i128 | u128 |
| Зависит от архитектуры | isize | usize |
Каждый вариант бывает знаковым или беззнаковым и имеет явно заданный размер. Знаковый и беззнаковый — это о том, может ли число быть отрицательным. Иными словами, нужен ли числу знак (знаковое) или оно всегда положительное, и знак можно не хранить (беззнаковое). Это как запись чисел на бумаге: когда знак важен, мы пишем перед числом плюс или минус, а когда и так понятно, что число положительное, знак не пишем. Знаковые числа хранятся в дополнительном коде (two’s complement).
Знаковый тип может хранить числа от −(2n − 1) до 2n − 1
− 1 включительно, где n — количество бит в типе. Так, i8 хранит числа от
−(27) до 27 − 1, то есть от −128 до 127. Беззнаковые
типы хранят числа от 0 до 2n − 1, так что u8 хранит числа от 0 до
28 − 1, то есть от 0 до 255.
Размер типов isize и usize зависит от архитектуры компьютера, на котором
работает программа: 64 бита на 64-битной архитектуре и 32 бита на 32-битной.
Целочисленные литералы можно записывать в любой из форм из таблицы 3-2. Если
литерал подходит под несколько числовых типов, к нему можно приписать суффикс
типа — например, 57u8. Кроме того, в числовых литералах можно ставить _ в
качестве визуального разделителя, чтобы число легче читалось: 1_000 — это то
же самое, что 1000.
Таблица 3-2: Целочисленные литералы в Rust
| Литерал | Пример |
|---|---|
| Десятичный | 98_222 |
| Шестнадцатеричный | 0xff |
| Восьмеричный | 0o77 |
| Двоичный | 0b1111_0000 |
Байт (только u8) | b'A' |
Как же понять, какой целочисленный тип выбрать? Если сомневаетесь, начните с
того, что Rust выбирает по умолчанию, — обычно это хороший вариант. По
умолчанию целые числа имеют тип i32. isize и usize в основном нужны для
индексации коллекций.
Переполнение целых чисел
Допустим, у вас есть переменная типа u8, которая хранит значения от 0 до
255. Если попытаться записать в неё значение вне этого диапазона, например
256, произойдёт переполнение (integer overflow). Дальше возможны два
варианта. При компиляции в отладочном режиме Rust добавляет проверки на
переполнение, и если оно случится, программа во время работы запаникует.
Словом «паника» (panic) в Rust называют аварийное завершение программы с
ошибкой; подробнее о панике мы поговорим в разделе «Неисправимые ошибки и
panic!» главы 9.
При компиляции в режиме релиза (с флагом --release) Rust не добавляет
проверок, вызывающих панику. Вместо этого при переполнении происходит
циклический перенос (two’s complement wrapping). Проще говоря, значения
больше максимума для типа «заворачиваются» и начинаются с минимума. Для u8
значение 256 превращается в 0, 257 — в 1 и так далее. Паники не будет, но в
переменной окажется не то значение, которого вы, скорее всего, ожидали.
Полагаться на такое «заворачивание» при переполнении считается ошибкой.
Чтобы явно обработать возможность переполнения, используйте семейства методов, которые стандартная библиотека даёт примитивным числовым типам:
wrapping_*(например,wrapping_add) — всегда заворачивают значение, в любом режиме компиляции;checked_*— при переполнении возвращаютNone;overflowing_*— возвращают значение и логический флаг, было ли переполнение;saturating_*— при переполнении «упираются» в минимальное или максимальное значение типа.
Числа с плавающей точкой
Ещё в Rust есть два примитивных типа для чисел с плавающей точкой, то есть
дробных чисел: f32 и f64 — 32 и 64 бита соответственно. По умолчанию
используется f64: на современных процессорах он работает примерно так же
быстро, как f32, но точнее. Все типы с плавающей точкой знаковые.
Вот пример работы с числами с плавающей точкой:
Файл: src/main.rs
fn main() {
    let x = 2.0; // f64

    let y: f32 = 3.0; // f32
}
Числа с плавающей точкой представлены по стандарту IEEE-754.
Арифметические операции
Для всех числовых типов Rust поддерживает привычные математические операции:
сложение, вычитание, умножение, деление и остаток от деления. Целочисленное
деление отбрасывает дробную часть (округляет к нулю). Вот как каждая операция
выглядит в инструкции let:
Файл: src/main.rs
fn main() {
    // сложение
    let sum = 5 + 10;

    // вычитание
    let difference = 95.5 - 4.3;

    // умножение
    let product = 4 * 30;

    // деление
    let quotient = 56.7 / 32.2;
    let truncated = -5 / 3; // Получится -1

    // остаток от деления
    let remainder = 43 % 5;
}
Каждое из этих выражений использует математический оператор и вычисляется в одно значение, которое затем привязывается к переменной. Полный список операторов Rust есть в приложении B.
Логический тип
Как и в большинстве других языков, у логического типа в Rust два возможных
значения: true и false. Занимает он один байт и обозначается bool.
Например:
Файл: src/main.rs
fn main() {
    let t = true;

    let f: bool = false; // с явной аннотацией типа
}
Чаще всего логические значения используются в условиях, например в выражении
if. Как работает if в Rust, мы разберём в разделе «Управление потоком
выполнения».
Символьный тип
Тип char — самый примитивный «буквенный» тип в Rust. Вот несколько примеров
объявления значений char:
Файл: src/main.rs
fn main() {
    let c = 'z';
    let z: char = 'ℤ'; // с явной аннотацией типа
    let heart_eyed_cat = '😻';
}
Обратите внимание: литералы char записываются в одинарных кавычках, а
строковые литералы — в двойных. Тип char в Rust занимает 4 байта и
представляет скалярное значение Юникода (Unicode scalar value), а значит,
умеет гораздо больше, чем просто ASCII. Буквы с диакритикой, китайские,
японские и корейские иероглифы, эмодзи, пробелы нулевой ширины — всё это
допустимые значения char. Скалярные значения Юникода лежат в диапазонах от
U+0000 до U+D7FF и от U+E000 до U+10FFFF включительно. Однако понятия
«символ» в Юникоде на самом деле нет, поэтому ваше интуитивное представление о
«символе» может не совпадать с тем, что такое char в Rust. Подробно мы
обсудим это в разделе «Строки: текст в UTF-8» главы 8.
Составные типы
Составные типы объединяют несколько значений в один тип. В Rust два примитивных составных типа: кортежи и массивы.
Кортежи
Кортеж (tuple) — универсальный способ собрать несколько значений разных типов в одно составное значение. Длина кортежа фиксирована: после объявления он не может ни вырасти, ни уменьшиться.
Кортеж создаётся так: в круглых скобках через запятую перечисляются значения. У каждой позиции в кортеже свой тип, и типы разных значений не обязаны совпадать. В этом примере мы добавили необязательные аннотации типов:
Файл: src/main.rs
fn main() {
    let tup: (i32, f64, u8) = (500, 6.4, 1);
}
Переменная tup привязана ко всему кортежу целиком: кортеж считается одним
составным элементом. Чтобы достать из кортежа отдельные значения, можно
разобрать его с помощью сопоставления с образцом:
Файл: src/main.rs
fn main() {
    let tup = (500, 6.4, 1);

    let (x, y, z) = tup;

    println!("The value of y is: {y}");
}
Сначала программа создаёт кортеж и привязывает его к переменной tup. Затем
let с образцом раскладывает tup на три отдельные переменные: x, y и
z. Это называется деструктуризацией (destructuring): один кортеж
разбивается на три части. В конце программа выводит значение y, то есть
6.4.
К элементу кортежа можно обратиться и напрямую: через точку (.) и индекс
нужного значения. Например:
Файл: src/main.rs
fn main() {
    let x: (i32, f64, u8) = (500, 6.4, 1);

    let five_hundred = x.0;

    let six_point_four = x.1;

    let one = x.2;
}
Программа создаёт кортеж x, а затем обращается к каждому его элементу по
индексу. Как и в большинстве языков программирования, индексы в кортеже
начинаются с 0.
У кортежа без единого значения есть особое название — unit («единичный
тип»). И само значение, и его тип записываются как (); они обозначают пустое
значение или отсутствие возвращаемого значения. Если выражение не возвращает
никакого другого значения, оно неявно возвращает ().
Массивы
Другой способ хранить несколько значений вместе — массив. В отличие от кортежа, все элементы массива должны быть одного типа. А в отличие от массивов в некоторых других языках, длина массива в Rust фиксирована.
Значения массива записываются через запятую в квадратных скобках:
Файл: src/main.rs
fn main() {
    let a = [1, 2, 3, 4, 5];
}
Массив пригодится, когда данные должны лежать на стеке, а не в куче (как и значения всех типов, что мы видели до сих пор; о стеке и куче подробно поговорим в главе 4). Или когда нужно гарантировать, что элементов всегда одно и то же количество. Но массив не так гибок, как вектор. Вектор — это похожая коллекция из стандартной библиотеки, которая может расти и уменьшаться, потому что её содержимое хранится в куче. Если не уверены, что выбрать — массив или вектор, — скорее всего, нужен вектор. Подробнее о векторах — в главе 8.
Зато массивы хороши, когда вы точно знаете, что количество элементов меняться не будет. Например, если программе нужны названия месяцев, лучше взять массив, а не вектор: месяцев всегда 12.
#![allow(unused)]
fn main() {
let months = ["January", "February", "March", "April", "May", "June", "July",
              "August", "September", "October", "November", "December"];
}
Тип массива записывается в квадратных скобках: тип элементов, точка с запятой и количество элементов:
#![allow(unused)]
fn main() {
let a: [i32; 5] = [1, 2, 3, 4, 5];
}
Здесь i32 — тип каждого элемента, а число 5 после точки с запятой говорит,
что в массиве пять элементов.
Можно также создать массив, все элементы которого одинаковы: в квадратных скобках укажите начальное значение, точку с запятой и длину массива:
#![allow(unused)]
fn main() {
let a = [3; 5];
}
Массив a будет содержать 5 элементов, и все они изначально равны 3. Это
то же самое, что let a = [3, 3, 3, 3, 3];, только короче.
Доступ к элементам массива
Массив — это один непрерывный кусок памяти известного фиксированного размера, который может располагаться на стеке. К элементам массива обращаются по индексу:
Файл: src/main.rs
fn main() {
    let a = [1, 2, 3, 4, 5];

    let first = a[0];
    let second = a[1];
}
Здесь переменная first получит значение 1 — оно лежит в массиве по индексу
[0]. А переменная second получит значение 2 по индексу [1].
Обращение за пределы массива
Посмотрим, что будет, если обратиться к элементу за концом массива. Допустим, вы запускаете вот такой код, похожий на игру из главы 2: он запрашивает у пользователя индекс элемента массива.
Файл: src/main.rs
use std::io;

fn main() {
    let a = [1, 2, 3, 4, 5];

    println!("Please enter an array index.");

    let mut index = String::new();

    io::stdin()
        .read_line(&mut index)
        .expect("Failed to read line");

    let index: usize = index
        .trim()
        .parse()
        .expect("Index entered was not a number");

    let element = a[index];

    println!("The value of the element at index {index} is: {element}");
}
Этот код успешно компилируется. Если запустить его через cargo run и ввести
0, 1, 2, 3 или 4, программа выведет элемент массива с этим индексом.
А если ввести число за пределами массива, например 10, вывод будет таким:
thread 'main' panicked at src/main.rs:19:19:
index out of bounds: the len is 5 but the index is 10
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
Программа упала с ошибкой времени выполнения ровно в тот момент, когда
попыталась обратиться к элементу по недопустимому индексу. Она завершилась с
сообщением об ошибке и так и не выполнила последний println!. Когда вы
обращаетесь к элементу по индексу, Rust проверяет, что индекс меньше длины
массива. Если индекс больше длины или равен ей, Rust паникует. Проверять это
приходится во время выполнения: компилятор никак не может заранее знать, какое
число введёт пользователь.
Это пример того, как на практике работают принципы безопасной работы с памятью в Rust. Во многих низкоуровневых языках такой проверки нет, и неправильный индекс приводит к обращению к чужой памяти. Rust защищает вас от такой ошибки: вместо того чтобы обратиться к памяти и продолжить работу, он немедленно завершает программу. В главе 9 мы подробнее поговорим об обработке ошибок в Rust и о том, как писать понятный и безопасный код, который и не паникует, и не допускает некорректного доступа к памяти.
Функции
Функции
Функции в коде на Rust встречаются повсюду. Одну из самых важных функций языка
вы уже видели — это main, точка входа во многие программы. Видели вы и
ключевое слово fn, которым объявляются новые функции.
Имена функций и переменных в Rust принято писать в стиле snake case: все буквы строчные, а слова разделяются подчёркиваниями. Вот программа с примером определения функции:
Файл: src/main.rs
fn main() {
    println!("Hello, world!");

    another_function();
}

fn another_function() {
    println!("Another function.");
}
Функция в Rust определяется так: fn, затем имя функции и круглые скобки.
Фигурные скобки показывают компилятору, где начинается и где заканчивается
тело функции.
Чтобы вызвать любую определённую нами функцию, достаточно написать её имя и
круглые скобки. Функция another_function определена в программе, поэтому её
можно вызвать из main. Обратите внимание: в исходном коде мы определили
another_function после main, но могли бы определить и до. Rust не важно,
в каком порядке идут функции, — важно лишь, чтобы вызывающий код их видел
(чтобы функция была в доступной ему области видимости).
Чтобы поэкспериментировать с функциями, создайте новый бинарный проект
functions. Поместите пример с another_function в src/main.rs и
запустите. Вывод должен быть таким:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.28s
     Running `target/debug/functions`
Hello, world!
Another function.
Строки выполняются в том порядке, в каком они записаны в main. Сначала
выводится «Hello, world!», затем вызывается another_function и выводит своё
сообщение.
Параметры
У функций могут быть параметры — особые переменные, которые являются частью сигнатуры функции. Если у функции есть параметры, при вызове в них можно передать конкретные значения. Строго говоря, сами конкретные значения называются аргументами, но в разговоре слова «параметр» и «аргумент» часто используют как синонимы — и для переменных в определении функции, и для значений, которые передаются при вызове.
В этой версии another_function мы добавили параметр:
Файл: src/main.rs
fn main() {
    another_function(5);
}

fn another_function(x: i32) {
    println!("The value of x is: {x}");
}
Запустите программу — вывод должен быть таким:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 1.21s
     Running `target/debug/functions`
The value of x is: 5
У another_function один параметр с именем x и типом i32. Когда мы
передаём в another_function значение 5, макрос println! подставляет 5
в строку формата на место фигурных скобок с x.
В сигнатуре функции тип каждого параметра указывать обязательно. Это сознательное решение в дизайне Rust: когда типы параметров записаны в определении функции, компилятор почти всегда может сам вывести остальные типы в коде, и вам не придётся расставлять аннотации где-то ещё. К тому же, зная, какие типы ожидает функция, компилятор может выдавать более полезные сообщения об ошибках.
Если параметров несколько, их объявления разделяются запятыми:
Файл: src/main.rs
fn main() {
    print_labeled_measurement(5, 'h');
}

fn print_labeled_measurement(value: i32, unit_label: char) {
    println!("The measurement is: {value}{unit_label}");
}
Здесь создаётся функция print_labeled_measurement с двумя параметрами.
Первый называется value и имеет тип i32. Второй — unit_label типа
char. Функция выводит текст, в котором есть и value, и unit_label.
Запустим этот код. Замените программу в src/main.rs проекта functions на
пример выше и запустите её через cargo run:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.31s
     Running `target/debug/functions`
The measurement is: 5h
Мы вызвали функцию со значением 5 для value и 'h' для unit_label, и
именно эти значения появились в выводе.
Инструкции и выражения
Тело функции состоит из последовательности инструкций, которая может заканчиваться выражением. У функций, которые мы видели до сих пор, такого завершающего выражения не было, но выражения внутри инструкций вам уже встречались. Rust — язык, основанный на выражениях (expression-based), поэтому разница между инструкциями и выражениями здесь важна. В других языках такого разделения нет, так что давайте разберёмся, что такое инструкции и выражения и как их различие сказывается на теле функций.
- Инструкции (statements) выполняют какое-то действие и не возвращают значения.
- Выражения (expressions) вычисляются в итоговое значение.
Посмотрим на примеры.
На самом деле мы уже пользовались и инструкциями, и выражениями. Создать
переменную и присвоить ей значение с помощью let — это инструкция. В
листинге 3-1 let y = 6; — инструкция.
fn main() {
    let y = 6;
}main, содержащей одну инструкциюОпределение функции — тоже инструкция: весь пример выше сам по себе является инструкцией. (А вот вызов функции, как мы скоро увидим, — уже не инструкция.)
Инструкции не возвращают значений. Поэтому инструкцию let нельзя присвоить
другой переменной, как пытается сделать следующий код, — получится ошибка:
Файл: src/main.rs
fn main() {
    let x = (let y = 6);
}
Если запустить эту программу, ошибка будет такой:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
error: expected expression, found `let` statement
 --> src/main.rs:2:14
  |
2 |     let x = (let y = 6);
  |              ^^^
  |
  = note: only supported directly in conditions of `if` and `while` expressions

warning: unnecessary parentheses around assigned value
 --> src/main.rs:2:13
  |
2 |     let x = (let y = 6);
  |             ^         ^
  |
  = note: `#[warn(unused_parens)]` (part of `#[warn(unused)]`) on by default
help: remove these parentheses
  |
2 -     let x = (let y = 6);
2 +     let x = let y = 6;
  |

warning: `functions` (bin "functions") generated 1 warning
error: could not compile `functions` (bin "functions") due to 1 previous error; 1 warning emitted
Инструкция let y = 6 не возвращает значения, так что привязывать к x
нечего. В этом Rust отличается от других языков, например C и Ruby, где
присваивание возвращает присвоенное значение. Там можно написать x = y = 6,
и обе переменные, x и y, получат значение 6. В Rust так не получится.
Выражения вычисляются в значение, и из них состоит большая часть остального
кода, который вы будете писать на Rust. Возьмём математическую операцию,
например 5 + 6: это выражение, которое вычисляется в 11. Выражения могут
входить в инструкции: в листинге 3-1 6 в инструкции let y = 6; — это
выражение, которое вычисляется в значение 6. Вызов функции — выражение.
Вызов макроса — выражение. Новый блок области видимости, созданный фигурными
скобками, — тоже выражение. Например:
Файл: src/main.rs
fn main() {
    let y = {
        let x = 3;
        x + 1
    };

    println!("The value of y is: {y}");
}
Вот это выражение:
{
    let x = 3;
    x + 1
}
— блок, который в данном случае вычисляется в 4. Это значение и
привязывается к y в инструкции let. Обратите внимание на строку x + 1:
в отличие от большинства строк, которые вы видели до сих пор, в конце у неё нет
точки с запятой. Выражения не заканчиваются точкой с запятой. Если поставить
точку с запятой в конце выражения, оно превратится в инструкцию и перестанет
возвращать значение. Помните об этом — дальше мы будем разбирать
возвращаемые значения функций и выражения.
Функции, возвращающие значения
Функции могут возвращать значения вызвавшему их коду. Возвращаемым значениям
мы не даём имён, но их тип нужно объявить после стрелки (->). В Rust
возвращаемое значение функции — это значение последнего выражения в её теле.
Из функции можно выйти и раньше, с помощью ключевого слова return и
значения, но большинство функций неявно возвращают последнее выражение. Вот
пример функции, которая возвращает значение:
Файл: src/main.rs
fn five() -> i32 {
    5
}

fn main() {
    let x = five();

    println!("The value of x is: {x}");
}
В функции five нет ни вызовов функций, ни макросов, ни даже инструкций
let — только число 5. И это совершенно нормальная функция на Rust.
Заметьте, что тип возвращаемого значения тоже указан: -> i32. Запустите этот
код — вывод должен быть таким:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.30s
     Running `target/debug/functions`
The value of x is: 5
5 в функции five — это её возвращаемое значение, поэтому тип возвращаемого
значения — i32. Разберём подробнее. Здесь важны два момента. Во-первых,
строка let x = five(); показывает, что мы инициализируем переменную
значением, которое вернула функция. Функция five возвращает 5, так что эта
строка равносильна такой:
#![allow(unused)]
fn main() {
let x = 5;
}
Во-вторых, у функции five нет параметров, зато указан тип возвращаемого
значения, а её тело — одинокое 5 без точки с запятой. Точки с запятой нет,
потому что это выражение, значение которого мы хотим вернуть.
Посмотрим на другой пример:
Файл: src/main.rs
fn main() {
    let x = plus_one(5);

    println!("The value of x is: {x}");
}

fn plus_one(x: i32) -> i32 {
    x + 1
}
Этот код выведет The value of x is: 6. А что будет, если поставить точку с
запятой в конце строки x + 1 и тем самым превратить выражение в инструкцию?
Файл: src/main.rs
fn main() {
    let x = plus_one(5);

    println!("The value of x is: {x}");
}

fn plus_one(x: i32) -> i32 {
    x + 1;
}
Компиляция завершится ошибкой:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
error[E0308]: mismatched types
 --> src/main.rs:7:24
  |
7 | fn plus_one(x: i32) -> i32 {
  |    --------            ^^^ expected `i32`, found `()`
  |    |
  |    implicitly returns `()` as its body has no tail or `return` expression
8 |     x + 1;
  |          - help: remove this semicolon to return this value

For more information about this error, try `rustc --explain E0308`.
error: could not compile `functions` (bin "functions") due to 1 previous error
Главное сообщение, mismatched types («несовпадение типов»), указывает на
суть проблемы. Функция plus_one по определению должна вернуть i32, но
инструкция ни во что не вычисляется — это обозначается (), единичным типом.
Получается, функция ничего не возвращает, а это противоречит её определению —
отсюда и ошибка. В выводе Rust даже подсказывает, как, скорее всего, это
исправить: убрать точку с запятой. И это действительно устранит ошибку.
Комментарии
Комментарии
Все программисты стараются писать понятный код, но иногда без дополнительных пояснений не обойтись. Для этого в исходном коде оставляют комментарии: компилятор их игнорирует, а людям, читающим код, они могут пригодиться.
Вот простой комментарий:
#![allow(unused)]
fn main() {
// hello, world
}
В Rust принято начинать комментарий с двух косых черт; комментарий
продолжается до конца строки. Если комментарий занимает несколько строк, //
нужно ставить в начале каждой:
#![allow(unused)]
fn main() {
// Здесь мы делаем что-то сложное — настолько, что для объяснения
// понадобилось несколько строк комментария! Уф! Надеюсь, этот комментарий
// объяснит, что тут происходит.
}
Комментарий можно поставить и в конце строки с кодом:
Файл: src/main.rs
fn main() {
    let lucky_number = 7; // Сегодня мне повезёт
}
Но чаще комментарий пишут на отдельной строке над тем кодом, к которому он относится:
Файл: src/main.rs
fn main() {
    // Сегодня мне повезёт
    let lucky_number = 7;
}
Есть в Rust и другой вид комментариев — документационные. О них мы поговорим в разделе «Публикация крейта на Crates.io» главы 14.
Управление потоком выполнения
Управление потоком выполнения
Выполнять код в зависимости от того, истинно ли условие, и повторять код,
пока условие истинно, — это базовые строительные блоки большинства языков
программирования. Чаще всего управлять потоком выполнения кода на Rust
приходится с помощью выражений if и циклов.
Выражения if
Выражение if позволяет разветвить код в зависимости от условий. Вы задаёте
условие и говорите: «Если условие выполняется, запусти этот блок кода. Если
нет — не запускай».
Чтобы поэкспериментировать с if, создайте в папке projects новый проект
branches. В файл src/main.rs введите следующее:
Файл: src/main.rs
fn main() {
    let number = 3;

    if number < 5 {
        println!("condition was true");
    } else {
        println!("condition was false");
    }
}
Любое выражение if начинается с ключевого слова if, за которым следует
условие. Здесь условие проверяет, меньше ли значение переменной number, чем
5. Блок кода, который должен выполниться, если условие истинно (true), мы
пишем сразу после условия в фигурных скобках. Блоки кода, связанные с
условиями в if, иногда называют ветками — так же, как ветки выражения
match, о которых мы говорили в разделе «Сравниваем догадку с загаданным
числом» главы 2.
При желании можно добавить и выражение else — что мы здесь и сделали. Оно
задаёт альтернативный блок кода, который выполнится, если условие окажется
ложным (false). Если else нет, а условие ложно, программа просто пропустит
блок if и перейдёт к следующему коду.
Запустите этот код — вывод должен быть таким:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.31s
     Running `target/debug/branches`
condition was true
Давайте поменяем значение number так, чтобы условие стало ложным, и
посмотрим, что получится:
fn main() {
    let number = 7;

    if number < 5 {
        println!("condition was true");
    } else {
        println!("condition was false");
    }
}
Снова запустите программу и посмотрите на вывод:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.31s
     Running `target/debug/branches`
condition was false
Стоит отметить, что условие в этом коде обязательно должно иметь тип bool.
Если это не bool, будет ошибка. Попробуйте, например, запустить такой код:
Файл: src/main.rs
fn main() {
    let number = 3;

    if number {
        println!("number was three");
    }
}
На этот раз условие if вычисляется в 3, и Rust выдаёт ошибку:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
error[E0308]: mismatched types
 --> src/main.rs:4:8
  |
4 |     if number {
  |        ^^^^^^ expected `bool`, found integer

For more information about this error, try `rustc --explain E0308`.
error: could not compile `branches` (bin "branches") due to 1 previous error
Ошибка говорит, что Rust ожидал bool, а получил целое число. В отличие от
Ruby или JavaScript, Rust не пытается автоматически превратить не-логическое
значение в логическое. Нужно писать явно и всегда передавать if в качестве
условия логическое значение. Если, например, мы хотим, чтобы блок if
выполнялся, только когда число не равно 0, выражение нужно переписать так:
Файл: src/main.rs
fn main() {
    let number = 3;

    if number != 0 {
        println!("number was something other than zero");
    }
}
Этот код выведет number was something other than zero.
Несколько условий: else if
Несколько условий можно проверить, соединив if и else в выражение
else if. Например:
Файл: src/main.rs
fn main() {
    let number = 6;

    if number % 4 == 0 {
        println!("number is divisible by 4");
    } else if number % 3 == 0 {
        println!("number is divisible by 3");
    } else if number % 2 == 0 {
        println!("number is divisible by 2");
    } else {
        println!("number is not divisible by 4, 3, or 2");
    }
}
У этой программы четыре возможных пути выполнения. Запустив её, вы увидите:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.31s
     Running `target/debug/branches`
number is divisible by 3
Программа по очереди проверяет каждое условие if и выполняет тело первого,
которое окажется истинным. Обратите внимание: хотя 6 делится на 2, мы не видим
ни number is divisible by 2, ни текста number is not divisible by 4, 3, or 2
из блока else. Дело в том, что Rust выполняет блок только для первого
истинного условия, а найдя его, остальные даже не проверяет.
Если else if слишком много, код становится запутанным. Так что если их
больше одного, возможно, стоит переписать код. Для таких случаев в главе 6
описана мощная конструкция ветвления Rust — match.
if в инструкции let
Раз if — это выражение, его можно поставить справа в инструкции let и
присвоить результат переменной, как в листинге 3-2.
fn main() {
    let condition = true;
    let number = if condition { 5 } else { 6 };

    println!("The value of number is: {number}");
}ifПеременная number получит значение в зависимости от результата выражения
if. Запустите код и посмотрите, что получится:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.30s
     Running `target/debug/branches`
The value of number is: 5
Напомним, что блок кода вычисляется в своё последнее выражение, а число само
по себе — тоже выражение. В нашем случае значение всего выражения if
зависит от того, какой блок выполнится. Значит, все значения, которые может
вернуть каждая ветка if, должны быть одного типа. В листинге 3-2 и ветка
if, и ветка else давали целые числа типа i32. Если типы не совпадают,
как в следующем примере, будет ошибка:
Файл: src/main.rs
fn main() {
    let condition = true;

    let number = if condition { 5 } else { "six" };

    println!("The value of number is: {number}");
}
При компиляции этого кода мы получим ошибку. Ветки if и else возвращают
значения несовместимых типов, и Rust точно указывает, где в программе
проблема:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
error[E0308]: `if` and `else` have incompatible types
 --> src/main.rs:4:44
  |
4 |     let number = if condition { 5 } else { "six" };
  |                                 -          ^^^^^ expected integer, found `&str`
  |                                 |
  |                                 expected because of this

For more information about this error, try `rustc --explain E0308`.
error: could not compile `branches` (bin "branches") due to 1 previous error
Выражение в блоке if вычисляется в целое число, а выражение в блоке else
— в строку. Так нельзя: у переменной может быть только один тип, и Rust
должен ещё при компиляции точно знать, какого типа переменная number. Зная
её тип, компилятор может проверить, что везде, где используется number, тип
подходит. Если бы тип number становился известен только во время
выполнения, такой проверки бы не было. Компилятору пришлось бы держать в уме
сразу несколько возможных типов для каждой переменной — он стал бы сложнее, а
гарантий о коде давал бы меньше.
Повторение: циклы
Часто бывает нужно выполнить блок кода несколько раз. Для этого в Rust есть несколько видов циклов: цикл выполняет код в своём теле до конца и сразу же начинает сначала. Чтобы поэкспериментировать с циклами, создадим новый проект loops.
В Rust три вида циклов: loop, while и for. Попробуем каждый.
Повторение кода с loop
Ключевое слово loop говорит Rust выполнять блок кода снова и снова —
бесконечно или пока вы явно не скажете остановиться.
Для примера замените содержимое src/main.rs в папке loops на такое:
Файл: src/main.rs
fn main() {
    loop {
        println!("again!");
    }
}
Если запустить эту программу, again! будет выводиться снова и снова, пока мы
не остановим её вручную. Большинство терминалов поддерживают сочетание
ctrl-C, которое прерывает зациклившуюся программу.
Попробуйте:
$ cargo run
   Compiling loops v0.1.0 (file:///projects/loops)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.08s
     Running `target/debug/loops`
again!
again!
again!
again!
^Cagain!
^C отмечает момент, когда вы нажали ctrl-C.
После ^C слово again! может появиться, а может и нет — это зависит от того,
в каком месте цикла был код, когда пришёл сигнал прерывания.
К счастью, выйти из цикла можно и из кода. Для этого внутри цикла ставят
ключевое слово break — оно говорит программе, когда прекратить выполнение
цикла. Вспомните: мы уже делали так в игре «Угадай число», в разделе «Выход
после правильного ответа»
главы 2, — чтобы программа завершалась, когда пользователь угадал число.
В той же игре мы использовали и continue. В цикле оно говорит программе
пропустить весь оставшийся код текущей итерации и перейти к следующей.
Возврат значений из цикла
Одно из применений loop — повторять операцию, которая может не удаться,
например проверять, закончил ли поток свою работу. При этом результат операции
может понадобиться вынести из цикла в остальной код. Для этого добавьте нужное
значение после выражения break, которым вы останавливаете цикл: это значение
вернётся из цикла, и его можно будет использовать. Вот так:
fn main() {
    let mut counter = 0;

    let result = loop {
        counter += 1;

        if counter == 10 {
            break counter * 2;
        }
    };

    println!("The result is {result}");
}
Перед циклом мы объявляем переменную counter и инициализируем её значением
0. Затем объявляем переменную result, в которую попадёт значение,
возвращённое циклом. На каждой итерации мы прибавляем к counter единицу и
проверяем, не равен ли counter десяти. Когда равен, вызываем break со
значением counter * 2. После цикла стоит точка с запятой — она завершает
инструкцию, которая присваивает значение result. В конце мы выводим значение
result — в данном случае 20.
Из цикла можно выйти и через return. Разница в том, что break выходит
только из текущего цикла, а return — всегда из текущей функции.
Метки циклов
Если циклы вложены друг в друга, break и continue относятся к самому
внутреннему циклу в этом месте. Но циклу можно дать метку (loop label) и
затем указать её в break или continue — тогда они будут относиться к
помеченному циклу, а не к самому внутреннему. Метка цикла должна начинаться с
одинарной кавычки. Вот пример с двумя вложенными циклами:
fn main() {
    let mut count = 0;
    'counting_up: loop {
        println!("count = {count}");
        let mut remaining = 10;

        loop {
            println!("remaining = {remaining}");
            if remaining == 9 {
                break;
            }
            if count == 2 {
                break 'counting_up;
            }
            remaining -= 1;
        }

        count += 1;
    }
    println!("End count = {count}");
}
У внешнего цикла метка 'counting_up, он считает от 0 до 2. Внутренний цикл
без метки считает от 10 до 9. Первый break без метки выходит только из
внутреннего цикла, а инструкция break 'counting_up; выходит из внешнего.
Этот код выведет:
$ cargo run
   Compiling loops v0.1.0 (file:///projects/loops)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.58s
     Running `target/debug/loops`
count = 0
remaining = 10
remaining = 9
count = 1
remaining = 10
remaining = 9
count = 2
remaining = 10
End count = 2
Циклы с условием: while
Программе часто нужно проверять условие внутри цикла: пока оно истинно, цикл
работает, а как только перестаёт быть истинным, программа вызывает break и
цикл останавливается. Такое поведение можно собрать из loop, if, else и
break — если хотите, попробуйте прямо сейчас. Но этот шаблон встречается
настолько часто, что в Rust для него есть встроенная конструкция — цикл
while. В листинге 3-3 с помощью while программа трижды проходит цикл,
каждый раз уменьшая счётчик, а после цикла выводит сообщение и завершается.
fn main() {
    let mut number = 3;

    while number != 0 {
        println!("{number}!");

        number -= 1;
    }

    println!("LIFTOFF!!!");
}while: код выполняется, пока условие истинноЭта конструкция избавляет от лишней вложенности, которая понадобилась бы с
loop, if, else и break, и читается понятнее. Пока условие истинно, код
выполняется; как только станет ложным — цикл завершается.
Обход коллекции с for
Перебрать элементы коллекции, например массива, можно и с помощью while.
Скажем, цикл в листинге 3-4 выводит каждый элемент массива a.
fn main() {
    let a = [10, 20, 30, 40, 50];
    let mut index = 0;

    while index < 5 {
        println!("the value is: {}", a[index]);

        index += 1;
    }
}whileЗдесь код перебирает элементы массива по индексу: начинает с 0 и крутится,
пока не дойдёт до последнего индекса (то есть пока index < 5 не перестанет
быть истинным). Код выведет все элементы массива:
$ cargo run
   Compiling loops v0.1.0 (file:///projects/loops)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.32s
     Running `target/debug/loops`
the value is: 10
the value is: 20
the value is: 30
the value is: 40
the value is: 50
Как и ожидалось, в терминале появились все пять значений. Хотя index в
какой-то момент становится равным 5, цикл останавливается раньше, чем
программа попытается достать из массива шестое значение.
Но такой подход чреват ошибками: если индекс или условие окажутся неверными,
программа может запаниковать. Например, если сократить массив a до четырёх
элементов и забыть поменять условие на while index < 4, код запаникует. К
тому же он медленный: компилятор добавляет код, который на каждой итерации во
время выполнения проверяет, не вышел ли индекс за границы массива.
Более лаконичная альтернатива — цикл for, который выполняет код для каждого
элемента коллекции. Он выглядит как в листинге 3-5.
fn main() {
    let a = [10, 20, 30, 40, 50];

    for element in a {
        println!("the value is: {element}");
    }
}forВывод будет таким же, как в листинге 3-4. Но, что важнее, код стал
безопаснее: исчезла возможность ошибиться — выйти за конец массива или,
наоборот, не дойти до конца и пропустить элементы. Машинный код для циклов
for к тому же может быть эффективнее, ведь индекс не нужно сравнивать с
длиной массива на каждой итерации.
С циклом for вам не придётся помнить, что нужно поменять ещё какой-то код,
если в массиве изменится количество элементов, — а со способом из листинга 3-4
пришлось бы.
Благодаря безопасности и лаконичности for — самый популярный вид цикла в
Rust. Даже когда нужно выполнить код определённое число раз, как в примере с
обратным отсчётом через while из листинга 3-3, большинство растацеанов
возьмут for. Для этого используют Range (диапазон) из стандартной
библиотеки: он по порядку выдаёт числа от начального значения до конечного,
не включая само конечное.
Вот как выглядит обратный отсчёт с циклом for и ещё одним методом, о
котором мы пока не говорили, — rev, который разворачивает диапазон:
Файл: src/main.rs
fn main() {
    for number in (1..4).rev() {
        println!("{number}!");
    }
    println!("LIFTOFF!!!");
}
Так ведь приятнее, правда?
Итоги
Вы справились! Глава была немаленькая: вы узнали о переменных, скалярных и
составных типах данных, функциях, комментариях, выражениях if и циклах.
Чтобы потренироваться, попробуйте написать программы, которые:
- переводят температуру из градусов Фаренгейта в градусы Цельсия и обратно;
- вычисляют n-е число Фибоначчи;
- выводят текст рождественской песни «The Twelve Days of Christmas» («Двенадцать дней Рождества»), используя то, что куплеты в ней повторяются.
Когда будете готовы двигаться дальше, мы поговорим о понятии, которого в других языках программирования обычно нет, — о владении.
Что такое владение
Владение (ownership) — самая необычная особенность Rust, и она глубоко влияет на весь остальной язык. Именно владение позволяет Rust гарантировать безопасную работу с памятью без сборщика мусора, поэтому так важно понять, как оно устроено. В этой главе мы поговорим о владении и нескольких связанных с ним вещах: заимствовании, срезах и о том, как Rust располагает данные в памяти.
Владение
Владение
Владение — это набор правил, по которым программа на Rust управляет памятью. Любой программе во время работы приходится как-то распоряжаться памятью компьютера. В некоторых языках есть сборщик мусора: пока программа работает, он регулярно ищет память, которая больше не используется. В других языках программист должен сам явно выделять и освобождать память. Rust идёт третьим путём: памятью управляет система владения — набор правил, которые проверяет компилятор. Если хоть одно правило нарушено, программа не скомпилируется. При этом никакая часть механизма владения не замедляет программу во время работы.
Для многих программистов владение — новое понятие, и к нему нужно привыкнуть. Хорошая новость: чем больше у вас опыта с Rust и правилами владения, тем естественнее у вас будет получаться безопасный и эффективный код. Не сдавайтесь!
Когда вы разберётесь во владении, у вас будет прочная основа, чтобы понять возможности, которые делают Rust уникальным. В этой главе мы изучим владение на примерах, связанных с очень распространённой структурой данных — строками.
Стек и куча
Во многих языках программирования о стеке и куче почти не приходится думать. Но в языке системного программирования, таком как Rust, то, где лежит значение — на стеке или в куче, — влияет и на поведение языка, и на то, какие решения вам приходится принимать. Дальше в главе некоторые аспекты владения будут объясняться через стек и кучу, поэтому для начала — короткое введение.
И стек, и куча — это области памяти, которые доступны вашему коду во время работы, но устроены они по-разному. Стек хранит значения в том порядке, в котором их получает, а убирает — в обратном. Это называется «последним пришёл — первым ушёл» (last in, first out, LIFO). Представьте стопку тарелок: новые тарелки кладут сверху, и снимают тоже сверху. Добавлять или вытаскивать тарелки из середины или снизу было бы куда менее удобно! Добавление данных называется помещением на стек (pushing), а удаление — снятием со стека (popping). Все данные на стеке должны иметь известный фиксированный размер. Данные, размер которых неизвестен при компиляции или может меняться, хранятся в куче.
Куча организована менее строго. Когда вы кладёте данные в кучу, вы запрашиваете место определённого размера. Распределитель памяти (allocator) находит в куче достаточно большой свободный участок, помечает его как занятый и возвращает указатель — адрес этого участка. Этот процесс называется выделением памяти в куче (allocating on the heap), или просто выделением памяти (помещение значений на стек выделением не считается). Указатель на кучу имеет известный фиксированный размер, поэтому сам указатель можно хранить на стеке, но чтобы добраться до данных, нужно пройти по указателю. Это как в ресторане: вы входите и называете, сколько вас человек, администратор находит свободный стол на всех и провожает вас к нему. Если кто-то из компании опоздает, он спросит, где вы сидите, и найдёт вас.
Положить данные на стек быстрее, чем выделить память в куче: распределителю не нужно искать место для новых данных — оно всегда на вершине стека. Выделение памяти в куче требует больше работы: распределитель должен сначала найти достаточно большой участок, а потом сделать служебные пометки, чтобы подготовиться к следующему выделению.
Обращение к данным в куче тоже обычно медленнее, чем к данным на стеке, — ведь сначала нужно пройти по указателю. Современные процессоры работают быстрее, когда им реже приходится прыгать по памяти. Продолжим аналогию: официант принимает заказы со многих столов. Эффективнее всего принять все заказы за одним столом и только потом переходить к следующему. Если брать заказ за столом A, потом за столом B, потом снова за A и снова за B, дело пойдёт куда медленнее. Так и процессор обычно лучше справляется с работой, если данные лежат рядом друг с другом (как на стеке), а не разбросаны далеко (как может быть в куче).
Когда код вызывает функцию, переданные в неё значения (в том числе, возможно, указатели на данные в куче) и её локальные переменные помещаются на стек. Когда функция завершается, эти значения снимаются со стека.
Следить за тем, какие части кода используют какие данные в куче, сводить к минимуму дублирование данных в куче и вовремя убирать неиспользуемые данные, чтобы не закончилась память, — вот те задачи, которые решает владение. Разобравшись во владении, вы будете нечасто думать о стеке и куче. Но если помнить, что главная задача владения — управлять данными в куче, легче понять, почему оно устроено именно так.
Правила владения
Для начала взглянем на сами правила владения. Держите их в голове, пока мы будем разбирать примеры:
- У каждого значения в Rust есть владелец (owner).
- В каждый момент времени владелец может быть только один.
- Когда владелец выходит из области видимости, значение уничтожается (dropped).
Область видимости переменной
С базовым синтаксисом Rust мы разобрались, поэтому дальше в примерах не будем
писать fn main() {. Если вы повторяете примеры, не забывайте сами помещать
их внутрь функции main. Так примеры получатся короче, и мы сможем
сосредоточиться на сути, а не на шаблонном коде.
Первым примером владения будет область видимости переменных. Область видимости (scope) — это участок программы, в пределах которого элемент действителен. Возьмём такую переменную:
#![allow(unused)]
fn main() {
let s = "hello";
}
Переменная s ссылается на строковый литерал — строку, значение которой
вписано прямо в текст программы. Переменная действительна с момента
объявления и до конца текущей области видимости. В листинге 4-1 комментарии
показывают, где переменная s действительна.
fn main() {
    {                      // здесь s ещё нет: она пока не объявлена
        let s = "hello";   // с этого места s можно использовать

        // что-то делаем с s
    }                      // область видимости закончилась, s больше нельзя использовать
}Иными словами, здесь есть два важных момента:
- Когда
sвходит в область видимости, она становится действительной. - Она остаётся действительной, пока не выйдет из области видимости.
Пока что связь между областью видимости и временем, когда переменная
действительна, такая же, как в других языках программирования. Теперь
двинемся дальше и познакомимся с типом String.
Тип String
Чтобы показать правила владения в действии, нам нужен тип посложнее тех, что
мы рассматривали в разделе «Типы данных» главы 3.
Размер тех типов известен заранее. Поэтому их значения можно хранить на стеке
и снимать со стека, когда заканчивается область видимости. А если такое же
значение понадобится другой части кода, его легко и быстро скопировать в новый
независимый экземпляр. Нам же интересны данные в куче: как Rust понимает, что
их пора освобождать? Тип String — отличный пример.
Мы сосредоточимся на тех свойствах String, которые связаны с владением. Они
относятся и к другим сложным типам данных — как из стандартной библиотеки,
так и созданным вами. Об остальных свойствах String мы поговорим в
главе 8.
Строковые литералы, у которых значение вписано прямо в программу, мы уже
видели. Они удобны, но годятся не для всех задач, связанных с текстом.
Во-первых, они неизменяемые. Во-вторых, не любое строковое значение известно
заранее, когда мы пишем код: например, что если нужно получить ввод
пользователя и сохранить его? Для таких случаев в Rust есть тип String. Он
управляет данными, выделенными в куче, и поэтому может хранить текст, объём
которого неизвестен при компиляции. String можно создать из строкового
литерала функцией from:
#![allow(unused)]
fn main() {
let s = String::from("hello");
}
Оператор :: позволяет поместить функцию from в пространство имён типа
String, а не придумывать ей имя вроде string_from. Подробнее об этом
синтаксисе мы поговорим в разделе «Методы» главы 5,
а также когда будем обсуждать пространства имён и модули в разделе «Пути к
элементам в дереве модулей» главы 7.
Такую строку можно изменять:
fn main() {
    let mut s = String::from("hello");

    s.push_str(", world!"); // push_str() дописывает литерал в конец String

    println!("{s}"); // выведет `hello, world!`
}
В чём же разница? Почему String можно менять, а литералы — нет? Всё дело в
том, как эти два типа работают с памятью.
Память и её выделение
Содержимое строкового литерала известно при компиляции, поэтому текст вписывается прямо в итоговый исполняемый файл. Отсюда скорость и эффективность строковых литералов. Но эти свойства — следствие их неизменяемости. К сожалению, невозможно заранее зашить в бинарник кусок памяти под каждый текст, размер которого неизвестен при компиляции и может меняться во время работы программы.
Чтобы String мог хранить изменяемый текст, способный расти, ему нужна
память в куче — заранее неизвестного размера. Это означает следующее:
- Память нужно запросить у распределителя во время выполнения программы.
- Нужен способ вернуть эту память распределителю, когда
Stringнам больше не нужна.
Первую часть делаем мы сами: когда мы вызываем String::from, его реализация
запрашивает нужную память. Так устроено практически во всех языках
программирования.
А вот со второй частью всё иначе. В языках со сборщиком мусора (garbage
collector, GC) сборщик сам отслеживает и освобождает память, которая больше не
используется, и думать об этом не нужно. В большинстве языков без сборщика
мусора мы сами должны определить, когда память больше не нужна, и явно
вызвать код, который её освободит, — так же, как явно её запрашивали. Делать
это правильно исторически было непростой задачей. Забудем освободить — память
утечёт. Освободим слишком рано — получим недействительную переменную.
Освободим дважды — тоже баг. Каждому выделению (allocate) должно
соответствовать ровно одно освобождение (free).
Rust идёт другим путём: память автоматически возвращается, как только
переменная, которая ею владеет, выходит из области видимости. Вот наш пример с
областью видимости из листинга 4-1, только с String вместо строкового
литерала:
fn main() {
    {
        let s = String::from("hello"); // с этого места s можно использовать

        // что-то делаем с s
    }                                  // область видимости закончилась, s больше
                                       // нельзя использовать
}
Есть естественный момент, когда память, нужную нашей String, можно вернуть
распределителю, — когда s выходит из области видимости. В этот момент Rust
вызывает для нас специальную функцию. Она называется drop, и именно в неё
автор типа String может поместить код, возвращающий память. Rust вызывает
drop автоматически на закрывающей фигурной скобке.
Примечание: в C++ такой подход — освобождать ресурсы в конце времени жизни
объекта — иногда называют «получение ресурса есть инициализация»
(Resource Acquisition Is Initialization, RAII). Если вы пользовались
RAII, функция drop в Rust покажется вам знакомой.
Этот подход очень сильно влияет на то, как пишется код на Rust. Сейчас всё выглядит просто, но в более сложных ситуациях, когда с данными, выделенными в куче, работают сразу несколько переменных, поведение кода может оказаться неожиданным. Давайте разберём некоторые из таких ситуаций.
Переменные и данные: перемещение
Что происходит, когда значение одной переменной присваивают другой? В Rust ответ зависит от типа данных. Начнём с целого числа — листинг 4-2.
fn main() {
    let x = 5;
    let y = x;
}x переменной yНетрудно догадаться, что здесь происходит: «привязать значение 5 к x;
затем скопировать значение из x и привязать копию к y». Теперь у нас две
переменные, x и y, и обе равны 5. Так и есть: целые числа — простые
значения известного фиксированного размера, и оба значения 5 кладутся на
стек.
Теперь посмотрим на версию со String:
fn main() {
    let s1 = String::from("hello");
    let s2 = s1;
}
Код очень похож, и можно подумать, что работает он так же: вторая строка
копирует значение из s1 и привязывает его к s2. Но на самом деле
происходит не совсем это.
Посмотрите на рисунок 4-1 — там показано, что творится со String «под
капотом». String состоит из трёх частей (они слева): указателя на память, в
которой лежит содержимое строки, длины и ёмкости. Эта группа данных хранится
на стеке. Справа — память в куче, где лежит само содержимое.
Рисунок 4-1: Представление в памяти String со
значением "hello", привязанной к s1
Длина — это сколько памяти (в байтах) сейчас занимает содержимое String.
Ёмкость — сколько всего памяти (в байтах) String получила от распределителя.
Разница между длиной и ёмкостью важна, но не здесь, так что пока про ёмкость
можно забыть.
Когда мы присваиваем s1 переменной s2, копируются данные String на
стеке — указатель, длина и ёмкость. Данные в куче, на которые указывает
указатель, не копируются. Иначе говоря, в памяти получается то, что
показано на рисунке 4-2.
Рисунок 4-2: Представление в памяти переменной s2,
у которой копия указателя, длины и ёмкости из s1
А вот так, как на рисунке 4-3, память не выглядит. Так было бы, если бы Rust
копировал ещё и данные в куче. Тогда при больших данных в куче операция
s2 = s1 могла бы обходиться очень дорого.
Рисунок 4-3: Другой возможный вариант s2 = s1 — если
бы Rust копировал и данные в куче
Выше мы говорили, что, когда переменная выходит из области видимости, Rust
автоматически вызывает drop и освобождает память в куче, принадлежащую этой
переменной. Но на рисунке 4-2 оба указателя ведут в одно и то же место. В этом
и проблема: когда s2 и s1 выйдут из области видимости, обе попытаются
освободить одну и ту же память. Это называется ошибкой двойного
освобождения (double free) — одна из тех ошибок безопасности памяти, о
которых мы говорили раньше. Двойное освобождение может повредить память, а
это, в свою очередь, может привести к уязвимостям.
Чтобы обеспечить безопасность памяти, после строки let s2 = s1; Rust считает
s1 недействительной. Поэтому, когда s1 выходит из области видимости,
освобождать ничего не нужно: память теперь принадлежит только s2. Посмотрите, что будет, если попытаться
использовать s1 после того, как создана s2, — ничего не выйдет:
fn main() {
    let s1 = String::from("hello");
    let s2 = s1;

    println!("{s1}, world!");
}
Вы получите примерно такую ошибку — Rust не даёт использовать недействительную ссылку:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0382]: borrow of moved value: `s1`
 --> src/main.rs:5:16
  |
2 |     let s1 = String::from("hello");
  |         -- move occurs because `s1` has type `String`, which does not implement the `Copy` trait
3 |     let s2 = s1;
  |              -- value moved here
4 |
5 |     println!("{s1}, world!");
  |                ^^ value borrowed here after move
  |
help: consider cloning the value if the performance cost is acceptable
  |
3 |     let s2 = s1.clone();
  |                ++++++++

For more information about this error, try `rustc --explain E0382`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
Если в других языках вам встречались понятия поверхностного копирования
(shallow copy) и глубокого копирования (deep copy), то копирование
указателя, длины и ёмкости без самих данных, скорее всего, напомнит вам
поверхностное копирование. Но поскольку Rust к тому же делает первую
переменную недействительной, это называют не поверхностным копированием, а
перемещением (move). В нашем примере говорят, что s1 переместилась в
s2. На самом деле происходит то, что показано на рисунке 4-4.
Рисунок 4-4: Представление в памяти после того, как
s1 стала недействительной
Проблема решена! Действительна только s2, поэтому, когда она выйдет из
области видимости, память освободит она одна — и всё.
Из этого вытекает ещё одно проектное решение: Rust никогда автоматически не создаёт «глубоких» копий ваших данных. Поэтому любое автоматическое копирование можно считать дешёвым с точки зрения производительности.
Область видимости и присваивание
Есть и обратная ситуация, где тоже видна связь между областью видимости,
владением и drop. Если присвоить уже существующей переменной новое значение,
Rust сразу вызовет drop для старого значения и освободит его память. Например:
fn main() {
    let mut s = String::from("hello");
    s = String::from("ahoy");

    println!("{s}, world!");
}
Сначала мы объявляем переменную s и привязываем к ней String со значением
"hello". Затем сразу создаём новую String со значением "ahoy" и
присваиваем её s. В этот момент на исходное значение в куче уже ничто не
ссылается. Рисунок 4-5 показывает, что теперь на стеке и в куче:
Рисунок 4-5: Представление в памяти после того, как исходное значение полностью заменено
Таким образом, исходная строка сразу выходит из области видимости. Rust
вызывает для неё drop, и её память тут же освобождается. Когда в конце мы
выводим значение, получаем "ahoy, world!".
Переменные и данные: клонирование
Если же мы действительно хотим глубоко скопировать данные String из кучи, а
не только данные на стеке, можно воспользоваться распространённым методом
clone. Синтаксис методов мы обсудим в главе 5, но методы есть во многих
языках, так что вы наверняка с ними уже встречались.
Вот как работает метод clone:
fn main() {
    let s1 = String::from("hello");
    let s2 = s1.clone();

    println!("s1 = {s1}, s2 = {s2}");
}
Этот код прекрасно работает и явно делает то, что показано на рисунке 4-3: данные в куче действительно копируются.
Увидев вызов clone, вы понимаете, что выполняется какой-то произвольный код и
он может быть дорогим. Это наглядный сигнал: здесь происходит что-то особенное.
Данные только на стеке: копирование
Есть ещё одна тонкость, о которой мы пока не говорили. Вот код с целыми числами (часть его была в листинге 4-2) — он работает и корректен:
fn main() {
    let x = 5;
    let y = x;

    println!("x = {x}, y = {y}");
}
Но он вроде бы противоречит тому, что мы только что узнали: clone не
вызывается, а x по-прежнему действительна и не переместилась в y.
Дело в том, что типы вроде целых чисел, размер которых известен при
компиляции, целиком хранятся на стеке, и скопировать само значение очень
быстро. Значит, нет никаких причин делать x недействительной после создания
y. Иными словами, здесь нет разницы между глубоким и поверхностным
копированием: clone сделал бы то же самое, что и обычное копирование, так
что его можно не писать.
В Rust есть специальная пометка — трейт Copy, который можно реализовать для
типов, хранящихся на стеке, как целые числа (подробнее о трейтах — в
главе 10). Если тип реализует трейт Copy, его
переменные не перемещаются, а просто копируются, и после присваивания другой
переменной остаются действительными.
Rust не позволит пометить тип как Copy, если сам тип или любая его часть
реализует трейт Drop. Если при выходе значения из области видимости для типа
должно происходить что-то особенное, а вы добавите ему пометку Copy, будет
ошибка компиляции. О том, как добавить пометку Copy к своему типу и тем
самым реализовать этот трейт, читайте в разделе «Выводимые
трейты» приложения C.
Так какие же типы реализуют Copy? Точно можно узнать в документации к
конкретному типу, но общее правило такое: Copy может реализовать любая
группа простых скалярных значений, и не может — ничто, что требует выделения
памяти или является каким-либо ресурсом. Вот некоторые типы, реализующие
Copy:
- Все целочисленные типы, например
u32. - Логический тип
boolсо значениямиtrueиfalse. - Все типы с плавающей точкой, например
f64. - Символьный тип
char. - Кортежи, если все их элементы тоже реализуют
Copy. Например,(i32, i32)реализуетCopy, а(i32, String)— нет.
Владение и функции
Передача значения в функцию устроена так же, как присваивание значения переменной: значение либо перемещается, либо копируется. В листинге 4-3 пример с комментариями о том, где переменные входят в область видимости и выходят из неё.
fn main() {
    let s = String::from("hello");  // s входит в область видимости

    takes_ownership(s);             // значение s перемещается в функцию...
                                    // ...поэтому дальше s использовать нельзя

    let x = 5;                      // x входит в область видимости

    makes_copy(x);                  // i32 реализует трейт Copy,
                                    // поэтому x НЕ перемещается в функцию,
                                    // и x можно использовать и дальше.

} // Здесь из области видимости выходит x, затем s. Но значение s уже
  // перемещено, поэтому ничего особенного не происходит.

fn takes_ownership(some_string: String) { // some_string входит в область видимости
    println!("{some_string}");
} // Здесь some_string выходит из области видимости, вызывается `drop`,
  // и память, где лежала строка, освобождается.

fn makes_copy(some_integer: i32) { // some_integer входит в область видимости
    println!("{some_integer}");
} // Здесь some_integer выходит из области видимости. Ничего особенного не происходит.Если бы мы попытались использовать s после вызова takes_ownership, Rust
выдал бы ошибку компиляции. Такие статические проверки уберегают нас от
ошибок. Попробуйте добавить в main код, который использует s и x, и
посмотрите, где их использовать можно, а где правила владения не позволяют.
Возвращаемые значения и область видимости
Возврат значения тоже может передавать владение. В листинге 4-4 пример функции, которая возвращает значение, — с такими же пометками, как в листинге 4-3.
fn main() {
    let s1 = gives_ownership();        // gives_ownership перемещает своё
                                       // возвращаемое значение в s1

    let s2 = String::from("hello");    // s2 входит в область видимости

    let s3 = takes_and_gives_back(s2); // s2 перемещается в
                                       // takes_and_gives_back, а та
                                       // перемещает своё возвращаемое значение в s3
} // Здесь s3 выходит из области видимости и уничтожается. s2 уже перемещена,
  // с ней ничего не происходит. s1 выходит из области видимости и уничтожается.

fn gives_ownership() -> String {       // gives_ownership переместит своё
                                       // возвращаемое значение в ту функцию,
                                       // которая её вызвала

    let some_string = String::from("yours"); // some_string входит в область видимости

    some_string                        // some_string возвращается и
                                       // перемещается в вызывающую
                                       // функцию
}

// Эта функция принимает String и возвращает String.
fn takes_and_gives_back(a_string: String) -> String {
    // a_string входит в
    // область видимости

    a_string  // a_string возвращается и перемещается в вызывающую функцию
}Владение всегда работает по одной схеме. Присваивание значения другой
переменной перемещает его. Когда переменная, владеющая данными в куче, выходит
из области видимости, Rust вызывает drop и освобождает эти данные — если
только владение ими к этому моменту не перешло к другой переменной.
Так работать можно, но забирать владение и возвращать его в каждой функции утомительно. А что, если мы хотим, чтобы функция воспользовалась значением, но не забирала его себе? Довольно неудобно, что всё переданное в функцию нужно ещё и возвращать обратно, если мы хотим пользоваться им дальше, — да ещё вместе с результатом работы самой функции, если он нам тоже нужен.
Вернуть несколько значений Rust позволяет с помощью кортежа, как показано в листинге 4-5.
fn main() {
    let s1 = String::from("hello");

    let (s2, len) = calculate_length(s1);

    println!("The length of '{s2}' is {len}.");
}

fn calculate_length(s: String) -> (String, usize) {
    let length = s.len(); // len() возвращает длину String

    (s, length)
}Но это слишком много церемоний и лишней работы ради того, что должно быть обычным делом. К счастью, в Rust есть способ использовать значение, не передавая владения, — ссылки.
Ссылки и заимствование
Ссылки и заимствование
Проблема с кортежем в листинге 4-5 в том, что String приходится возвращать
обратно вызывающей функции. Иначе после вызова calculate_length мы не смогли
бы пользоваться этой строкой — ведь она переместилась в calculate_length.
Вместо этого можно передать ссылку на значение String. Ссылка похожа на
указатель: это адрес, по которому можно добраться до данных, а владеет этими
данными какая-то другая переменная. Но, в отличие от указателя, ссылка
гарантированно указывает на действительное значение определённого типа всё
время, пока сама ссылка существует.
Вот как определить и использовать функцию calculate_length, которая
принимает параметром не само значение (и не забирает владение), а ссылку на
него:
fn main() {
    let s1 = String::from("hello");

    let len = calculate_length(&s1);

    println!("The length of '{s1}' is {len}.");
}

fn calculate_length(s: &String) -> usize {
    s.len()
}
Во-первых, заметьте: весь код с кортежами — и в объявлении переменной, и в
возвращаемом значении функции — исчез. Во-вторых, в calculate_length мы
передаём &s1, а в её определении принимаем &String, а не String. Эти
амперсанды и обозначают ссылки: они позволяют обратиться к значению, не
забирая владения им. Это показано на рисунке 4-6.
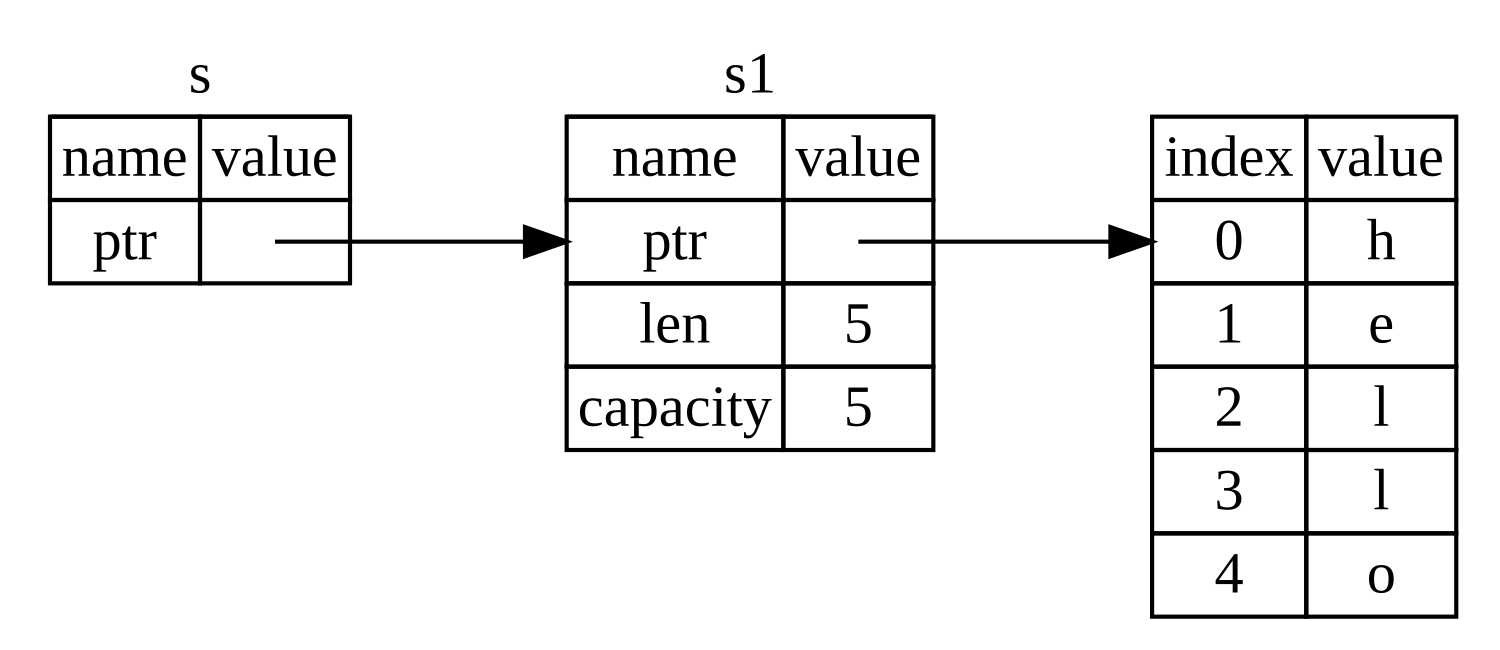
Рисунок 4-6: Схема: &String s указывает на
String s1
Примечание: противоположность взятию ссылки через & — разыменование
(dereferencing), для которого служит оператор разыменования *. Несколько
примеров его использования мы увидим в главе 8, а подробно разыменование
разберём в главе 15.
Посмотрим внимательнее на вызов функции:
fn main() {
    let s1 = String::from("hello");

    let len = calculate_length(&s1);

    println!("The length of '{s1}' is {len}.");
}

fn calculate_length(s: &String) -> usize {
    s.len()
}
Запись &s1 создаёт ссылку, которая указывает на значение s1, но не
владеет им. Раз ссылка не владеет значением, оно не будет уничтожено, когда
ссылка перестанет использоваться.
Сигнатура функции тоже использует &, показывая, что параметр s — ссылка.
Добавим поясняющие комментарии:
fn main() {
    let s1 = String::from("hello");

    let len = calculate_length(&s1);

    println!("The length of '{s1}' is {len}.");
}

fn calculate_length(s: &String) -> usize { // s — ссылка на String
    s.len()
} // Здесь s выходит из области видимости. Но s не владеет строкой, на которую
  // ссылается, поэтому строка не уничтожается.
Переменная s действительна в той же области видимости, что и любой параметр
функции. Но когда s перестаёт использоваться, значение, на которое она
ссылается, не уничтожается — потому что s им не владеет. Если функция
принимает параметрами ссылки, а не сами значения, ей не нужно возвращать
значения, чтобы вернуть владение: владения у неё никогда и не было.
Создание ссылки называется заимствованием (borrowing). Как и в жизни: если у кого-то есть вещь, вы можете взять её взаймы. Попользовались — нужно вернуть. Вещь не ваша.
А что будет, если попытаться изменить то, что мы позаимствовали? Попробуйте код из листинга 4-6. Спойлер: не сработает!
fn main() {
    let s = String::from("hello");

    change(&s);
}

fn change(some_string: &String) {
    some_string.push_str(", world");
}Вот ошибка:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0596]: cannot borrow `*some_string` as mutable, as it is behind a `&` reference
 --> src/main.rs:8:5
  |
8 |     some_string.push_str(", world");
  |     ^^^^^^^^^^^ `some_string` is a `&` reference, so it cannot be borrowed as mutable
  |
help: consider changing this to be a mutable reference
  |
7 | fn change(some_string: &mut String) {
  |                         +++

For more information about this error, try `rustc --explain E0596`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
Ссылки, как и переменные, по умолчанию неизменяемые. Изменить то, на что у нас есть (обычная) ссылка, нельзя.
Изменяемые ссылки
Код из листинга 4-6 можно исправить так, чтобы заимствованное значение можно было менять. Для этого достаточно пары небольших правок — и использовать изменяемую ссылку (mutable reference):
fn main() {
    let mut s = String::from("hello");

    change(&mut s);
}

fn change(some_string: &mut String) {
    some_string.push_str(", world");
}
Сначала мы делаем саму переменную s изменяемой (mut). Затем там, где
вызывается функция change, создаём изменяемую ссылку &mut s, а в
сигнатуре функции указываем, что она принимает изменяемую ссылку:
some_string: &mut String. Теперь сразу видно, что функция change будет
менять значение, которое заимствует.
У изменяемых ссылок есть одно серьёзное ограничение: если на значение есть
изменяемая ссылка, никаких других ссылок на это значение быть не может.
Поэтому код, который пытается создать две изменяемые ссылки на s, не
скомпилируется:
fn main() {
    let mut s = String::from("hello");

    let r1 = &mut s;
    let r2 = &mut s;

    println!("{r1}, {r2}");
}
Вот ошибка:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0499]: cannot borrow `s` as mutable more than once at a time
 --> src/main.rs:5:14
  |
4 |     let r1 = &mut s;
  |              ------ first mutable borrow occurs here
5 |     let r2 = &mut s;
  |              ^^^^^^ second mutable borrow occurs here
6 |
7 |     println!("{r1}, {r2}");
  |                -- first borrow later used here

For more information about this error, try `rustc --explain E0499`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
Ошибка говорит, что код некорректен: нельзя заимствовать s как изменяемую
больше одного раза одновременно. Первое изменяемое заимствование — r1. Оно
действует до строки с println!, где r1 используется. А мы как раз в этом
промежутке, между созданием r1 и её использованием, создаём вторую
изменяемую ссылку на те же данные — r2.
Запрет на несколько одновременных изменяемых ссылок на одни и те же данные позволяет изменять данные, но под строгим контролем. Новичкам в Rust это поначалу даётся тяжело: в большинстве языков менять данные можно когда угодно. Зато благодаря этому ограничению Rust предотвращает гонки данных (data races) ещё на этапе компиляции. Гонка данных похожа на состояние гонки и возникает, когда одновременно выполняются три условия:
- Два или больше указателя одновременно обращаются к одним и тем же данным.
- Хотя бы один из указателей используется для записи.
- Нет никакого механизма синхронизации доступа к данным.
Гонки данных приводят к неопределённому поведению, и их трудно отловить и исправить во время выполнения. Rust решает эту проблему радикально: код с гонками данных он просто не компилирует!
Как обычно, с помощью фигурных скобок можно создать новую область видимости. Так можно завести несколько изменяемых ссылок — главное, чтобы они не существовали одновременно:
fn main() {
    let mut s = String::from("hello");

    {
        let r1 = &mut s;
    } // здесь r1 выходит из области видимости, так что можно спокойно создать новую ссылку

    let r2 = &mut s;
}
Похожее правило действует и для сочетания изменяемых и неизменяемых ссылок. Этот код вызовет ошибку:
fn main() {
    let mut s = String::from("hello");

    let r1 = &s; // без проблем
    let r2 = &s; // без проблем
    let r3 = &mut s; // БОЛЬШАЯ ПРОБЛЕМА

    println!("{r1}, {r2}, and {r3}");
}
Вот ошибка:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0502]: cannot borrow `s` as mutable because it is also borrowed as immutable
 --> src/main.rs:6:14
  |
4 |     let r1 = &s; // без проблем
  |              -- immutable borrow occurs here
5 |     let r2 = &s; // без проблем
6 |     let r3 = &mut s; // БОЛЬШАЯ ПРОБЛЕМА
  |              ^^^^^^ mutable borrow occurs here
7 |
8 |     println!("{r1}, {r2}, and {r3}");
  |                -- immutable borrow later used here

For more information about this error, try `rustc --explain E0502`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
Ух! Получается, что изменяемую ссылку нельзя создать и тогда, когда на то же значение уже есть неизменяемая.
Те, кто пользуется неизменяемой ссылкой, вовсе не ждут, что значение вдруг поменяется у них под носом! А вот несколько неизменяемых ссылок одновременно — можно: кто просто читает данные, никак не мешает читать другим.
Учтите, что область действия ссылки начинается там, где ссылку создали, и
длится до места, где ссылка используется в последний раз. Например, следующий
код скомпилируется: неизменяемые ссылки последний раз используются в
println!, а изменяемая ссылка создаётся уже после этого:
fn main() {
    let mut s = String::from("hello");

    let r1 = &s; // без проблем
    let r2 = &s; // без проблем
    println!("{r1} and {r2}");
    // Дальше r1 и r2 больше не используются.

    let r3 = &mut s; // без проблем
    println!("{r3}");
}
Область действия неизменяемых ссылок r1 и r2 заканчивается после
println!, где они используются последний раз, — то есть ещё до того, как
создаётся изменяемая ссылка r3. Эти области не пересекаются, поэтому код
допустим: компилятор видит, что ссылка больше не используется, ещё до конца
области видимости.
Ошибки заимствования временами раздражают, но помните: это компилятор Rust заранее указывает на потенциальный баг (при компиляции, а не во время работы) и показывает, где именно проблема. И вам не придётся выяснять, почему данные оказались не такими, как вы думали.
Висячие ссылки
В языках с указателями легко по ошибке создать висячий указатель (dangling pointer) — указатель на участок памяти, который, возможно, уже отдан кому-то другому. Для этого достаточно освободить память, но сохранить указатель на неё. В Rust же компилятор гарантирует, что ссылки никогда не станут висячими: если у вас есть ссылка на какие-то данные, компилятор проследит, чтобы данные не вышли из области видимости раньше, чем ссылка на них.
Попробуем создать висячую ссылку и посмотрим, как Rust не даёт этого сделать, выдавая ошибку компиляции:
fn main() {
    let reference_to_nothing = dangle();
}

fn dangle() -> &String {
    let s = String::from("hello");

    &s
}
Вот ошибка:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0106]: missing lifetime specifier
 --> src/main.rs:5:16
  |
5 | fn dangle() -> &String {
  |                ^ expected named lifetime parameter
  |
  = help: this function's return type contains a borrowed value, but there is no value for it to be borrowed from
help: consider using the `'static` lifetime, but this is uncommon unless you're returning a borrowed value from a `const` or a `static`
  |
5 | fn dangle() -> &'static String {
  |                 +++++++
help: instead, you are more likely to want to return an owned value
  |
5 - fn dangle() -> &String {
5 + fn dangle() -> String {
  |

For more information about this error, try `rustc --explain E0106`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
Это сообщение упоминает возможность, которую мы ещё не разбирали, — времена жизни (lifetimes). Подробно о них мы поговорим в главе 10. Но если не обращать внимания на части про времена жизни, в сообщении есть ключ к тому, почему этот код проблемный:
this function's return type contains a borrowed value, but there is no value
for it to be borrowed from
(«возвращаемый тип этой функции содержит заимствованное значение, но заимствовать его не у чего».)
Разберём по шагам, что происходит в нашей функции dangle:
fn main() {
    let reference_to_nothing = dangle();
}

fn dangle() -> &String { // dangle возвращает ссылку на String

    let s = String::from("hello"); // s — новая String

    &s // возвращаем ссылку на String s
} // Здесь s выходит из области видимости и уничтожается, её память освобождается.
  // Опасно!
Строка s создаётся внутри dangle, поэтому, когда код dangle завершится,
память s будет освобождена. А мы пытаемся вернуть ссылку на неё. Значит, эта
ссылка указывала бы на уже недействительную String. Так не пойдёт! Rust
этого не допустит.
Решение — вернуть саму String:
fn main() {
    let string = no_dangle();
}

fn no_dangle() -> String {
    let s = String::from("hello");

    s
}
Так всё работает без проблем: владение перемещается наружу, и ничего не освобождается.
Правила ссылок
Подытожим, что мы узнали о ссылках:
- В каждый момент времени может быть либо одна изменяемая ссылка, либо сколько угодно неизменяемых.
- Ссылки всегда должны быть действительными.
Дальше мы рассмотрим другой вид ссылок — срезы.
Срезы
Срезы
Срезы (slices) позволяют сослаться на непрерывную последовательность элементов коллекции, а не на всю коллекцию целиком. Срез — это разновидность ссылки, поэтому владения у него нет.
Вот небольшая задачка: написать функцию, которая принимает строку из слов, разделённых пробелами, и возвращает первое слово. Если в строке нет пробела, значит, вся строка — одно слово, и вернуть нужно её целиком.
Примечание: чтобы проще было объяснить срезы, в этом разделе мы считаем, что строки состоят только из символов ASCII. Подробнее о работе с UTF-8 — в разделе «Строки: текст в UTF-8» главы 8.
Чтобы понять, какую проблему решают срезы, сначала попробуем написать сигнатуру такой функции без них:
fn first_word(s: &String) -> ?Параметр функции first_word имеет тип &String. Владение нам не нужно, так
что это нормально. (В идиоматичном Rust функции не забирают владение
аргументами без необходимости — почему, станет понятно дальше.) Но что
возвращать? У нас пока нет способа описать часть строки. Зато можно вернуть
индекс конца слова — то есть позицию пробела. Попробуем, как в листинге 4-7.
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}first_word возвращает индекс байта внутри строки-параметра StringНам нужно пройтись по String элемент за элементом и проверить, не пробел ли
это. Поэтому сначала превращаем String в массив байтов методом as_bytes:
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}
Затем методом iter создаём итератор по этому массиву байтов:
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}
Подробно итераторы разбираются в главе 13. Пока
достаточно знать, что iter — метод, который по очереди выдаёт каждый элемент
коллекции, а enumerate оборачивает результат iter и выдаёт каждый элемент
в составе кортежа. Первый элемент кортежа из enumerate — индекс, второй —
ссылка на сам элемент. Так удобнее, чем считать индекс вручную.
Раз enumerate возвращает кортеж, его можно разобрать с помощью образца.
Подробнее об образцах мы поговорим в главе 6. В цикле
for мы указываем образец, где i — индекс из кортежа, а &item — байт из
кортежа. Поскольку .iter().enumerate() даёт нам ссылку на элемент, в образце
стоит &.
Внутри цикла for мы ищем байт пробела, записав его как байтовый литерал.
Если пробел нашёлся, возвращаем его позицию. Если нет — возвращаем длину
строки, s.len().
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}
Теперь мы умеем находить индекс конца первого слова, но есть проблема. Мы
возвращаем отдельное число usize, а смысл у него есть только в связке с
конкретной строкой &String. Иначе говоря, это значение живёт отдельно от
String, и нет никакой гарантии, что оно останется верным в будущем.
Посмотрите на программу из листинга 4-8, которая использует first_word из
листинга 4-7.
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {
    let mut s = String::from("hello world");

    let word = first_word(&s); // word получит значение 5

    s.clear(); // очищаем String: теперь она равна ""

    // word по-прежнему равно 5, но в s больше нет текста, к которому это
    // число имело бы смысл, так что word теперь совершенно бесполезно!
}first_word, а затем меняем содержимое StringЭта программа компилируется без ошибок — и скомпилировалась бы, даже если бы
мы использовали word после вызова s.clear(). Переменная word никак не
связана с состоянием s, поэтому в ней по-прежнему лежит 5. Мы могли бы
попытаться вырезать из s первое слово с помощью этой пятёрки, но это был бы
баг: с тех пор как мы сохранили 5 в word, содержимое s изменилось.
Следить за тем, чтобы индекс в word не разошёлся с данными в s, —
утомительно, и легко ошибиться! А если написать ещё и функцию second_word,
всё станет ещё хрупче. Её сигнатура выглядела бы так:
fn second_word(s: &String) -> (usize, usize) {Теперь нужно отслеживать и начальный, и конечный индекс. Оба числа вычислены по строке в какой-то момент, но если строка потом изменится, сами числа об этом не узнают. Получается три независимые переменные — строка и два индекса, — и следить, чтобы они не разошлись, приходится вручную.
К счастью, у Rust есть решение — строковые срезы.
Строковые срезы
Строковый срез (string slice) — это ссылка на непрерывную часть String.
Выглядит он так:
fn main() {
    let s = String::from("hello world");

    let hello = &s[0..5];
    let world = &s[6..11];
}
Здесь hello ссылается не на всю String, а только на её часть, заданную
добавкой [0..5]. Срез создаётся указанием диапазона в квадратных скобках:
[начальный_индекс..конечный_индекс], где начальный_индекс — первая
позиция среза, а конечный_индекс — позиция, следующая за последней. Внутри
срез хранит начальную позицию и длину, равную конечный_индекс минус
начальный_индекс. Так, в let world = &s[6..11]; срез world содержит
указатель на байт с индексом 6 в s и длину 5.
На рисунке 4-7 это показано схематично.
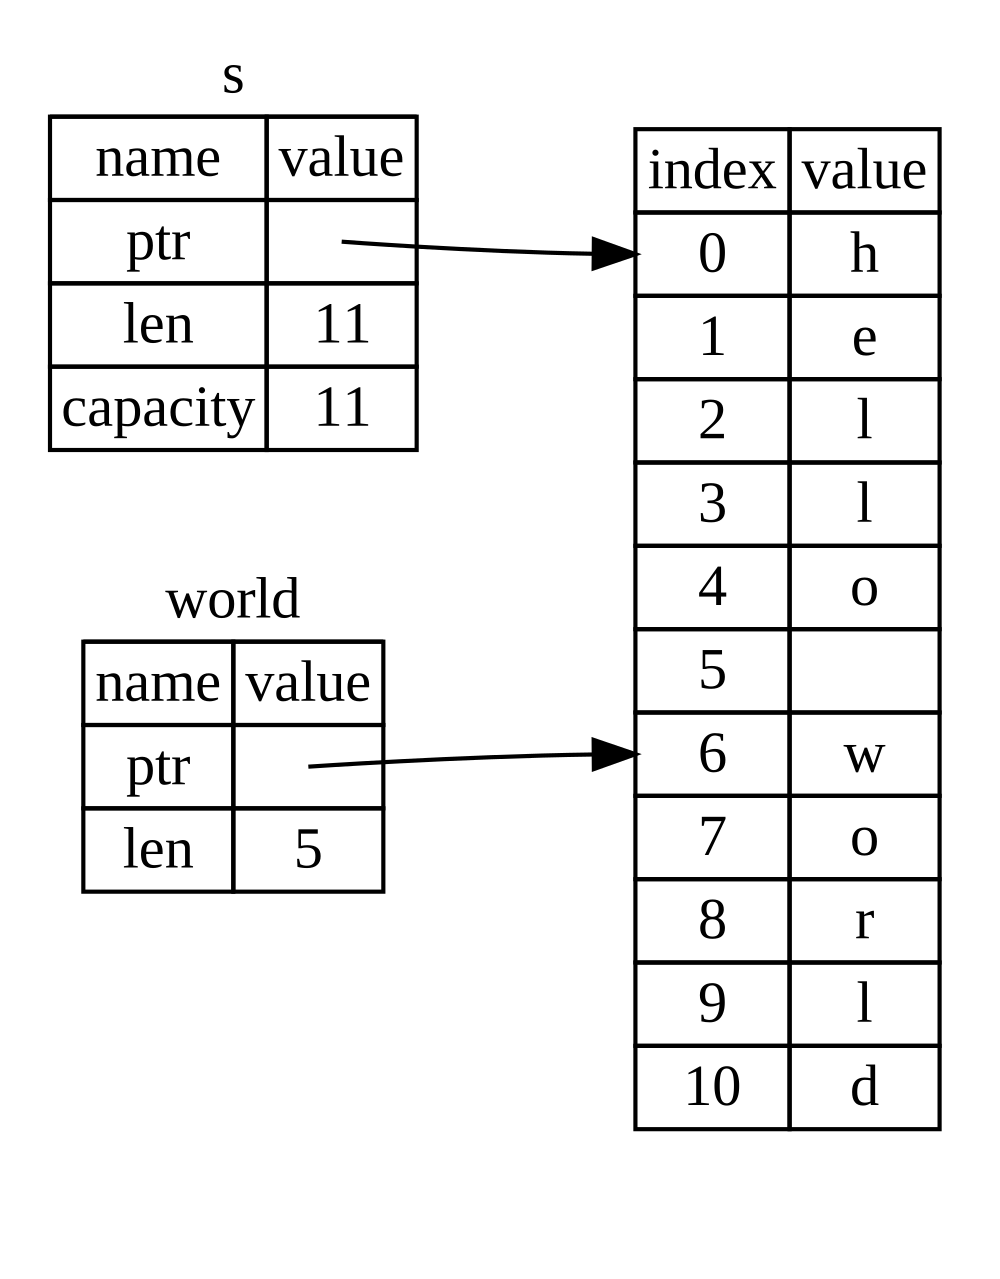
Рисунок 4-7: Строковый срез, ссылающийся на часть
String
Если диапазон .. начинается с индекса 0, число перед двумя точками можно не
писать. То есть эти две строки равнозначны:
#![allow(unused)]
fn main() {
let s = String::from("hello");

let slice = &s[0..2];
let slice = &s[..2];
}
Точно так же, если срез доходит до последнего байта String, можно не писать
число в конце. Эти строки тоже равнозначны:
#![allow(unused)]
fn main() {
let s = String::from("hello");

let len = s.len();

let slice = &s[3..len];
let slice = &s[3..];
}
А если опустить оба числа, получится срез всей строки. Эти строки равнозначны:
#![allow(unused)]
fn main() {
let s = String::from("hello");

let len = s.len();

let slice = &s[0..len];
let slice = &s[..];
}
Примечание: границы диапазона строкового среза должны приходиться на границы символов UTF-8. Если попытаться создать срез посередине многобайтового символа, программа завершится с ошибкой.
Теперь перепишем first_word так, чтобы она возвращала срез. Тип «строковый
срез» записывается как &str:
fn first_word(s: &String) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {}
Индекс конца слова мы находим так же, как в листинге 4-7, — ищем первый пробел. Найдя его, возвращаем строковый срез: от начала строки до индекса пробела.
Теперь first_word возвращает одно значение, которое привязано к исходным
данным. Оно состоит из ссылки на начало среза и количества элементов в нём.
Для функции second_word возврат среза тоже подойдёт:
fn second_word(s: &String) -> &str {Теперь у нас простой API, который гораздо сложнее использовать неправильно:
компилятор сам следит, чтобы ссылки внутрь String оставались
действительными. Помните баг из листинга 4-8? Мы получили индекс конца первого
слова, а потом очистили строку, и индекс стал бессмысленным. Код был логически
неверным, но никаких ошибок сразу не показывал. Проблемы всплыли бы позже —
если бы мы продолжили пользоваться индексом первого слова с уже пустой
строкой. Срезы делают такой баг невозможным и сообщают о проблеме гораздо
раньше. Версия first_word со срезом приведёт к ошибке компиляции:
fn first_word(s: &String) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {
    let mut s = String::from("hello world");

    let word = first_word(&s);

    s.clear(); // ошибка!

    println!("the first word is: {word}");
}
Вот ошибка компиляции:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0502]: cannot borrow `s` as mutable because it is also borrowed as immutable
  --> src/main.rs:18:5
   |
16 |     let word = first_word(&s);
   |                           -- immutable borrow occurs here
17 |
18 |     s.clear(); // ошибка!
   |     ^^^^^^^^^ mutable borrow occurs here
19 |
20 |     println!("the first word is: {word}");
   |                                   ---- immutable borrow later used here

For more information about this error, try `rustc --explain E0502`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
Почему так? Вспомните правило заимствования: пока на значение есть неизменяемая ссылка, изменяемую ссылку на него взять нельзя. Теперь посмотрим, что происходит в коде:
word— это срез строкиs, то есть неизменяемая ссылка наs.- Метод
clearочищает строкуs, а значит, меняет её. Для этого ему нужна изменяемая ссылка наs. - После
clearидётprintln!, который используетword. Значит, в момент вызоваclearнеизменяемая ссылкаwordвсё ещё нужна — она «жива».
Выходит, что в момент вызова clear на строку s должны одновременно
существовать и неизменяемая ссылка (word), и изменяемая (для clear). Rust
это запрещает, и компиляция завершается ошибкой. Так Rust не только сделал наш
API удобнее, но и избавил нас от целого класса ошибок — ещё до запуска
программы!
Строковые литералы — это срезы
Мы говорили, что строковые литералы хранятся прямо внутри бинарного файла. Теперь, зная о срезах, можно как следует понять, что такое строковый литерал:
#![allow(unused)]
fn main() {
let s = "Hello, world!";
}
Тип s здесь — &str: это срез, указывающий на определённое место в
бинарном файле. Поэтому строковые литералы и неизменяемы: &str —
неизменяемая ссылка.
Строковые срезы как параметры
Раз срезы можно брать и у литералов, и у значений String, сигнатуру
first_word можно улучшить ещё. Сейчас она такая:
fn first_word(s: &String) -> &str {Более опытный растацеан написал бы сигнатуру из листинга 4-9: с ней одна и та
же функция работает и со значениями &String, и со значениями &str.
fn first_word(s: &str) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {
    let my_string = String::from("hello world");

    // `first_word` принимает срезы `String` — как части, так и целой строки.
    let word = first_word(&my_string[0..6]);
    let word = first_word(&my_string[..]);
    // `first_word` принимает и ссылки на `String` — они равнозначны
    // срезам всей `String`.
    let word = first_word(&my_string);

    let my_string_literal = "hello world";

    // `first_word` принимает срезы строковых литералов — как части,
    // так и целого литерала.
    let word = first_word(&my_string_literal[0..6]);
    let word = first_word(&my_string_literal[..]);

    // Строковые литералы *уже* являются срезами строк,
    // поэтому сработает и так, без синтаксиса срезов!
    let word = first_word(my_string_literal);
}first_word: параметр s теперь имеет тип строкового срезаЕсли у нас есть строковый срез, его можно передать напрямую. Если есть
String, можно передать срез этой String или ссылку на неё. Такая гибкость
возможна благодаря неявному разыменованию (deref coercion) — мы разберём его
в разделе «Неявное разыменование в функциях и методах» главы 15.
Если функция принимает строковый срез, а не ссылку на String, её API
становится универсальнее и полезнее, а возможностей мы при этом не теряем:
fn first_word(s: &str) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {
    let my_string = String::from("hello world");

    // `first_word` принимает срезы `String` — как части, так и целой строки.
    let word = first_word(&my_string[0..6]);
    let word = first_word(&my_string[..]);
    // `first_word` принимает и ссылки на `String` — они равнозначны
    // срезам всей `String`.
    let word = first_word(&my_string);

    let my_string_literal = "hello world";

    // `first_word` принимает срезы строковых литералов — как части,
    // так и целого литерала.
    let word = first_word(&my_string_literal[0..6]);
    let word = first_word(&my_string_literal[..]);

    // Строковые литералы *уже* являются срезами строк,
    // поэтому сработает и так, без синтаксиса срезов!
    let word = first_word(my_string_literal);
}
Другие срезы
Строковые срезы, как нетрудно догадаться, бывают только у строк. Но есть и более общий вид среза. Возьмём массив:
#![allow(unused)]
fn main() {
let a = [1, 2, 3, 4, 5];
}
Точно так же, как может понадобиться сослаться на часть строки, может понадобиться сослаться на часть массива. Делается это так:
#![allow(unused)]
fn main() {
let a = [1, 2, 3, 4, 5];

let slice = &a[1..3];

assert_eq!(slice, &[2, 3]);
}
Тип этого среза — &[i32]. Работает он так же, как строковый срез: хранит
ссылку на первый элемент и длину. Такие срезы вы будете использовать с самыми
разными коллекциями. Подробно о коллекциях мы поговорим, когда дойдём до
векторов в главе 8.
Итоги
Владение, заимствование и срезы — это то, благодаря чему Rust гарантирует безопасную работу с памятью уже при компиляции. Памятью вы управляете так же точно, как в других языках системного программирования, но без лишней ручной работы. Освобождать память самому не нужно: как только переменная-владелец выходит из области видимости, Rust сам освобождает принадлежащие ей данные. Поэтому писать и отлаживать для этого отдельный код вам не придётся.
Владение влияет на то, как работают многие другие части Rust, поэтому мы ещё
не раз вернёмся к этим понятиям на протяжении книги. А теперь перейдём к
главе 5 и посмотрим, как объединять данные в структуры (struct).
Структуры для связанных данных
Структура (struct) — это пользовательский тип данных, который позволяет собрать вместе и назвать несколько связанных значений, образующих осмысленную группу. Если вы знакомы с объектно-ориентированными языками, структура похожа на набор полей (атрибутов данных) объекта. В этой главе мы сравним структуры с кортежами, чтобы опереться на то, что вы уже знаете, и показать, когда структуры лучше подходят для группировки данных.
Мы покажем, как определять структуры и создавать их экземпляры. Поговорим о том, как определять ассоциированные функции, и особенно об их разновидности — методах, которые задают поведение, связанное с типом структуры. Структуры и перечисления (о них — в главе 6) — это строительные блоки для создания новых типов из предметной области вашей программы. С ними вы сможете в полной мере пользоваться проверкой типов, которую Rust выполняет при компиляции.
Определение и создание структур
Определение и создание структур
Структуры похожи на кортежи, о которых шла речь в разделе «Кортежи»: и те и другие хранят несколько связанных значений. Как и в кортеже, части структуры могут быть разных типов. Но, в отличие от кортежа, в структуре у каждой части данных есть имя, поэтому сразу понятно, что означает каждое значение. Благодаря именам структуры гибче кортежей: чтобы задать или прочитать значение экземпляра, не нужно помнить порядок данных.
Чтобы определить структуру, пишем ключевое слово struct и даём имя всей
структуре. Имя должно отражать смысл данных, которые в ней сгруппированы. Затем
в фигурных скобках перечисляем имена и типы частей данных — они называются
полями (fields). Например, в листинге 5-1 показана структура, которая
хранит сведения об учётной записи пользователя.
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn main() {}UserЧтобы пользоваться определённой структурой, нужно создать её экземпляр
(instance), указав конкретные значения всех полей. Для этого пишем имя
структуры, а за ним — фигурные скобки с парами ключ: значение, где ключ —
имя поля, а значение — данные, которые мы хотим в нём хранить. Порядок полей
не обязан совпадать с порядком в объявлении структуры. Иначе говоря,
определение структуры — это общий шаблон типа, а экземпляры заполняют шаблон
конкретными данными и так создают значения этого типа. Например, конкретного
пользователя можно объявить так, как в листинге 5-2.
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn main() {
    let user1 = User {
        active: true,
        username: String::from("someusername123"),
        email: String::from("someone@example.com"),
        sign_in_count: 1,
    };
}UserЧтобы получить конкретное значение из структуры, используется точечная
нотация. Например, адрес электронной почты этого пользователя — это
user1.email. Если экземпляр изменяемый, значение можно поменять, обратившись
к полю через точку и присвоив ему новое значение. В листинге 5-3 показано, как
изменить поле email у изменяемого экземпляра User.
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn main() {
    let mut user1 = User {
        active: true,
        username: String::from("someusername123"),
        email: String::from("someone@example.com"),
        sign_in_count: 1,
    };

    user1.email = String::from("anotheremail@example.com");
}email у экземпляра UserОбратите внимание: изменяемым должен быть весь экземпляр целиком — пометить изменяемыми только отдельные поля Rust не позволяет. Как и любое другое выражение, новый экземпляр структуры можно создать последним выражением в теле функции — тогда функция неявно вернёт его.
В листинге 5-4 показана функция build_user, которая возвращает экземпляр
User с переданными адресом почты и именем пользователя. Поле active
получает значение true, а sign_in_count — 1.
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn build_user(email: String, username: String) -> User {
    User {
        active: true,
        username: username,
        email: email,
        sign_in_count: 1,
    }
}

fn main() {
    let user1 = build_user(
        String::from("someone@example.com"),
        String::from("someusername123"),
    );
}build_user принимает адрес почты и имя пользователя и возвращает экземпляр UserНазывать параметры функции так же, как поля структуры, вполне логично, но
повторять email и username дважды — и как имена полей, и как имена
переменных — немного утомительно. А будь у структуры больше полей, это
раздражало бы ещё сильнее. К счастью, есть удобное сокращение!
Сокращённая инициализация полей
В листинге 5-4 имена параметров и имена полей структуры полностью совпадают.
Поэтому build_user можно переписать с помощью сокращённой инициализации
полей (field init shorthand): функция будет вести себя точно так же, но без
повторения username и email, как в листинге 5-5.
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn build_user(email: String, username: String) -> User {
    User {
        active: true,
        username,
        email,
        sign_in_count: 1,
    }
}

fn main() {
    let user1 = build_user(
        String::from("someone@example.com"),
        String::from("someusername123"),
    );
}build_user использует сокращённую инициализацию, так как параметры username и email называются так же, как поля структурыЗдесь мы создаём новый экземпляр структуры User, у которой есть поле
email. В это поле мы хотим записать значение параметра email функции
build_user. Раз поле и параметр называются одинаково, достаточно написать
email вместо email: email.
Создание экземпляров с синтаксисом обновления
Часто бывает нужно создать новый экземпляр структуры, взяв большую часть значений из другого экземпляра того же типа и поменяв лишь некоторые. Для этого есть синтаксис обновления структуры (struct update syntax).
Сначала в листинге 5-6 покажем, как создать новый экземпляр User в user2
обычным способом, без синтаксиса обновления. Мы задаём новое значение email,
а остальные значения берём из user1, созданного в листинге 5-2.
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn main() {
    // --пропуск--

    let user1 = User {
        email: String::from("someone@example.com"),
        username: String::from("someusername123"),
        active: true,
        sign_in_count: 1,
    };

    let user2 = User {
        active: user1.active,
        username: user1.username,
        email: String::from("another@example.com"),
        sign_in_count: user1.sign_in_count,
    };
}User, взяв из user1 все значения, кроме одногоС синтаксисом обновления того же можно добиться меньшим количеством кода, как
в листинге 5-7. Запись .. означает, что все остальные поля, которые не заданы
явно, получат те же значения, что и в указанном экземпляре.
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn main() {
    // --пропуск--

    let user1 = User {
        email: String::from("someone@example.com"),
        username: String::from("someusername123"),
        active: true,
        sign_in_count: 1,
    };

    let user2 = User {
        email: String::from("another@example.com"),
        ..user1
    };
}User новый email, а остальные значения берём из user1Код в листинге 5-7 тоже создаёт экземпляр user2 с другим значением email,
но с теми же значениями полей username, active и sign_in_count, что и у
user1. ..user1 должно стоять последним: оно говорит, что все оставшиеся
поля берут значения из соответствующих полей user1. При этом явно задать
можно сколько угодно полей и в любом порядке, независимо от порядка полей в
определении структуры.
Обратите внимание: синтаксис обновления работает как присваивание через =,
то есть перемещает данные (см. раздел «Переменные и данные:
перемещение»). Что из этого следует в нашем примере:
- Поле
username— этоString, и её значение переместилось изuser1вuser2. Поэтомуuser1целиком использовать больше нельзя. - Поле
emailмы задали дляuser2заново, так чтоuser1.emailникуда не перемещалось — к нему по-прежнему можно обращаться. - Поля
activeиsign_in_countимеют типы, реализующие трейтCopy, поэтому они не перемещаются, а копируются (см. раздел «Данные только на стеке: копирование»).
Если бы мы задали для user2 новые String и в email, и в username, а из
user1 взяли бы только active и sign_in_count, то user1 осталась бы
полностью действительной и после создания user2.
Кортежные структуры: разные типы из похожих кортежей
Rust поддерживает и структуры, похожие на кортежи, — кортежные структуры (tuple structs). У кортежной структуры есть имя, которое придаёт ей смысл, но у её полей имён нет — только типы. Кортежные структуры удобны, когда нужно дать имя всему кортежу и сделать его отдельным типом, отличным от других кортежей, а давать имя каждому полю, как в обычной структуре, было бы многословно или излишне.
Чтобы определить кортежную структуру, напишите ключевое слово struct, имя
структуры, а за ним — типы в кортеже. Например, вот определение и
использование двух кортежных структур — Color и Point:
struct Color(i32, i32, i32);
struct Point(i32, i32, i32);

fn main() {
    let black = Color(0, 0, 0);
    let origin = Point(0, 0, 0);
}
Обратите внимание: значения black и origin — разных типов, потому что это
экземпляры разных кортежных структур. Каждая определённая вами структура — это
отдельный тип, даже если типы полей у структур совпадают. Например, функция,
принимающая параметр типа Color, не примет аргумент типа Point, хотя оба
типа состоят из трёх значений i32. В остальном экземпляры кортежных структур
ведут себя как кортежи: их можно разобрать на отдельные части и обращаться к
отдельному значению через . и индекс. Но, в отличие от кортежей, при
деструктуризации кортежной структуры нужно указывать её тип. Например, чтобы
разложить значения точки origin по переменным x, y и z, мы бы
написали let Point(x, y, z) = origin;.
Единичные структуры без полей
Можно определить и структуру вообще без полей! Такие структуры называют
единичными (unit-like structs), потому что они ведут себя похоже на () —
единичный тип, который мы упоминали в разделе «Кортежи». Единичные структуры пригодятся, когда нужно реализовать для какого-то
типа трейт, но хранить в самом типе никаких данных не требуется. Трейты мы
обсудим в главе 10. Вот пример объявления и создания экземпляра единичной
структуры AlwaysEqual:
struct AlwaysEqual;

fn main() {
    let subject = AlwaysEqual;
}
Чтобы определить AlwaysEqual, пишем ключевое слово struct, нужное имя и
точку с запятой. Ни фигурных, ни круглых скобок не нужно! Экземпляр
AlwaysEqual в переменной subject получаем так же просто — по имени, без
всяких скобок. Представьте, что позже мы реализуем для этого типа поведение, при
котором любой экземпляр AlwaysEqual всегда равен любому экземпляру любого
другого типа, — например, чтобы получать заранее известный результат в
тестах. Для такого поведения никакие данные не нужны! В главе 10 вы увидите,
как определять трейты и реализовывать их для любых типов, в том числе для
единичных структур.
Владение данными структуры
В определении структуры User из листинга 5-1 мы использовали тип String,
который владеет своими данными, а не строковый срез &str. Это сознательный
выбор: мы хотим, чтобы каждый экземпляр структуры владел всеми своими
данными и чтобы эти данные оставались действительными, пока действительна
вся структура.
Структуры могут хранить и ссылки на данные, которыми владеет кто-то другой, но для этого нужны времена жизни (lifetimes) — о них мы поговорим в главе 10. Времена жизни гарантируют, что данные, на которые ссылается структура, действительны, пока действительна сама структура. Допустим, вы пытаетесь сохранить в структуре ссылку, не указав времена жизни, — как в следующем коде в src/main.rs. Так не выйдет:
struct User {
    active: bool,
    username: &str,
    email: &str,
    sign_in_count: u64,
}

fn main() {
    let user1 = User {
        active: true,
        username: "someusername123",
        email: "someone@example.com",
        sign_in_count: 1,
    };
}
Компилятор пожалуется, что ему нужны спецификаторы времени жизни:
$ cargo run
   Compiling structs v0.1.0 (file:///projects/structs)
error[E0106]: missing lifetime specifier
 --> src/main.rs:3:15
  |
3 |     username: &str,
  |               ^ expected named lifetime parameter
  |
help: consider introducing a named lifetime parameter
  |
1 ~ struct User<'a> {
2 |     active: bool,
3 ~     username: &'a str,
  |

error[E0106]: missing lifetime specifier
 --> src/main.rs:4:12
  |
4 |     email: &str,
  |            ^ expected named lifetime parameter
  |
help: consider introducing a named lifetime parameter
  |
1 ~ struct User<'a> {
2 |     active: bool,
3 |     username: &str,
4 ~     email: &'a str,
  |

For more information about this error, try `rustc --explain E0106`.
error: could not compile `structs` (bin "structs") due to 2 previous errors
В главе 10 мы разберёмся, как исправить эти ошибки и хранить в структурах
ссылки, а пока будем избегать таких ошибок, используя типы-владельцы вроде
String вместо ссылок вроде &str.
Пример программы со структурами
Пример программы со структурами
Чтобы понять, когда пригодятся структуры, напишем программу, которая вычисляет площадь прямоугольника. Начнём с отдельных переменных, а потом будем переделывать программу, пока не придём к структурам.
Создадим через Cargo новый бинарный проект rectangles. Программа будет брать ширину и высоту прямоугольника в пикселях и вычислять его площадь. В листинге 5-8 короткая программа в src/main.rs, которая делает ровно это — одним из возможных способов.
fn main() {
    let width1 = 30;
    let height1 = 50;

    println!(
        "The area of the rectangle is {} square pixels.",
        area(width1, height1)
    );
}

fn area(width: u32, height: u32) -> u32 {
    width * height
}Запустим программу командой cargo run:
$ cargo run
   Compiling rectangles v0.1.0 (file:///projects/rectangles)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.42s
     Running `target/debug/rectangles`
The area of the rectangle is 1500 square pixels.
Код справляется с задачей: вызывает функцию area с обоими размерами и
получает площадь. Но его можно сделать понятнее и читабельнее.
Проблема хорошо видна по сигнатуре area:
fn main() {
    let width1 = 30;
    let height1 = 50;

    println!(
        "The area of the rectangle is {} square pixels.",
        area(width1, height1)
    );
}

fn area(width: u32, height: u32) -> u32 {
    width * height
}
Функция area должна вычислять площадь одного прямоугольника, но параметров у
неё два, и нигде в программе не сказано, что эти параметры связаны между
собой. Было бы понятнее и удобнее держать ширину и высоту вместе. Один способ
сделать это мы уже обсуждали в разделе «Кортежи» главы 3 — использовать кортеж.
Рефакторинг с кортежами
В листинге 5-9 — версия программы с кортежем.
fn main() {
    let rect1 = (30, 50);

    println!(
        "The area of the rectangle is {} square pixels.",
        area(rect1)
    );
}

fn area(dimensions: (u32, u32)) -> u32 {
    dimensions.0 * dimensions.1
}С одной стороны, программа стала лучше. Кортеж добавляет немного структуры, и теперь мы передаём всего один аргумент. Но с другой стороны, эта версия менее понятна: у элементов кортежа нет имён, приходится обращаться к ним по индексам, и вычисление становится не таким очевидным.
Для площади неважно, где ширина, а где высота, — но если мы захотим нарисовать
прямоугольник на экране, путаница станет ошибкой! Придётся держать
в голове, что width — это элемент кортежа с индексом 0, а height — с
индексом 1. Тому, кто будет пользоваться нашим кодом, разобраться в этом и
запомнить будет ещё сложнее. Мы не выразили в коде смысл наших данных, и
теперь в нём легче ошибиться.
Рефакторинг со структурами
Структуры позволяют придать данным смысл, снабдив их подписями. Кортеж можно превратить в структуру, у которой есть имя и у целого, и у частей, как в листинге 5-10.
struct Rectangle {
    width: u32,
    height: u32,
}

fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };

    println!(
        "The area of the rectangle is {} square pixels.",
        area(&rect1)
    );
}

fn area(rectangle: &Rectangle) -> u32 {
    rectangle.width * rectangle.height
}RectangleЗдесь мы определили структуру Rectangle (прямоугольник). В фигурных скобках
объявлены поля width и height, оба типа u32. Затем в main мы создали
конкретный экземпляр Rectangle шириной 30 и высотой 50.
Теперь у функции area один параметр, rectangle, и его тип —
неизменяемое заимствование экземпляра структуры Rectangle. Как мы говорили
в главе 4, лучше позаимствовать структуру, чем забирать владение ею. Тогда
main сохраняет владение и может дальше пользоваться rect1 — для этого мы и
пишем & и в сигнатуре функции, и в месте её вызова.
Функция area обращается к полям width и height экземпляра Rectangle.
(Заметьте: обращение к полям заимствованного экземпляра структуры не
перемещает значения полей — поэтому структуры так часто и передают по
ссылке.) Сигнатура area теперь говорит ровно то, что мы имеем в виду:
вычислить площадь Rectangle по его полям width и height. Видно, что
ширина и высота связаны друг с другом, а у значений понятные имена вместо
индексов кортежа 0 и 1. Ясность только выиграла.
Добавляем возможности с помощью выводимых трейтов
Во время отладки было бы удобно вывести экземпляр Rectangle и увидеть
значения всех его полей. В листинге 5-11 мы пробуем сделать это макросом
println!, как в предыдущих главах. Но так не
получится.
struct Rectangle {
    width: u32,
    height: u32,
}

fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };

    println!("rect1 is {rect1}");
}RectangleПри компиляции получаем ошибку, главное в которой — вот это сообщение:
error[E0277]: `Rectangle` doesn't implement `std::fmt::Display`
Макрос println! умеет форматировать вывод по-разному. По умолчанию фигурные
скобки говорят ему использовать форматирование Display — вывод для
конечного пользователя. Примитивные типы, которые мы видели до сих пор,
реализуют Display по умолчанию: показать пользователю 1 или любое другое
примитивное значение можно, по сути, только одним способом. А вот со
структурами неясно, как println! должен форматировать вывод: вариантов
слишком много. Нужны ли запятые? Выводить ли фигурные скобки? Показывать ли
все поля? Из-за этой неоднозначности Rust не пытается угадать, чего мы хотим,
и у структур нет готовой реализации Display для println! и заполнителя
{}.
Если читать ошибки дальше, найдётся полезная подсказка:
help: the trait `std::fmt::Display` is not implemented for `Rectangle`
  --> src/main.rs:1:1
Попробуем! Теперь вызов println! будет выглядеть так:
println!("rect1 is {rect1:?}");. Спецификатор :? внутри фигурных скобок
говорит println!, что нужен формат вывода Debug. Трейт Debug позволяет
выводить структуру в виде, удобном для разработчика, — чтобы видеть её
значение во время отладки.
Скомпилируйте код с этим изменением. Вот незадача! Ошибка всё равно есть:
error[E0277]: `Rectangle` doesn't implement `Debug`
Но компилятор снова даёт полезную подсказку:
   |                        required by this formatting parameter
   |
Возможность выводить отладочную информацию в Rust есть, но для своей
структуры её нужно явно включить. Для этого прямо перед определением
структуры добавляем внешний атрибут #[derive(Debug)], как в листинге 5-12.
#[derive(Debug)]
struct Rectangle {
    width: u32,
    height: u32,
}

fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };

    println!("rect1 is {rect1:?}");
}Debug, и печатаем экземпляр Rectangle в отладочном форматеТеперь программа запускается без ошибок, и мы видим:
$ cargo run
   Compiling rectangles v0.1.0 (file:///projects/rectangles)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.48s
     Running `target/debug/rectangles`
rect1 is Rectangle { width: 30, height: 50 }
Отлично! Не самый красивый вывод, но значения всех полей видны, а при
отладке это точно поможет. Для больших структур удобнее вывод, который легче
читать, — тогда в строке println! вместо {:?} можно написать {:#?}. В
нашем примере стиль {:#?} даст такой вывод:
$ cargo run
   Compiling rectangles v0.1.0 (file:///projects/rectangles)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.48s
     Running `target/debug/rectangles`
rect1 is Rectangle {
    width: 30,
    height: 50,
}
Другой способ вывести значение в формате Debug — макрос dbg!. В отличие от println!, который принимает ссылку, dbg! забирает
владение выражением. Он выводит имя файла и номер строки, где в коде стоит
вызов dbg!, вместе со значением выражения, а потом возвращает владение этим
значением обратно.
Примечание: макрос dbg! пишет в стандартный поток ошибок (stderr), а не
в стандартный поток вывода (stdout), как println!. Подробнее о stderr
и stdout — в разделе «Вывод ошибок в stderr» главы 12.
Вот пример, где нас интересует значение, которое присваивается полю width,
и значение всей структуры в rect1:
#[derive(Debug)]
struct Rectangle {
    width: u32,
    height: u32,
}

fn main() {
    let scale = 2;
    let rect1 = Rectangle {
        width: dbg!(30 * scale),
        height: 50,
    };

    dbg!(&rect1);
}
Мы оборачиваем в dbg! выражение 30 * scale. Поскольку dbg! возвращает
владение значением выражения, поле width получит то же значение, что и без
dbg!. А вот владение rect1 отдавать dbg! мы не хотим, поэтому в
следующем вызове передаём ссылку на rect1. Вывод примера выглядит так:
$ cargo run
   Compiling rectangles v0.1.0 (file:///projects/rectangles)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.61s
     Running `target/debug/rectangles`
[src/main.rs:10:16] 30 * scale = 60
[src/main.rs:14:5] &rect1 = Rectangle {
    width: 60,
    height: 50,
}
Первая часть вывода пришла из строки 10 файла src/main.rs, где мы
отлаживаем выражение 30 * scale; его значение — 60 (форматирование
Debug для целых чисел выводит просто их значение). Вызов dbg! в строке 14
файла src/main.rs выводит значение &rect1, то есть структуру Rectangle, —
в «красивом» формате Debug для типа Rectangle. Макрос dbg! очень
выручает, когда пытаешься понять, что на самом деле делает твой код!
Кроме Debug, Rust предоставляет ещё ряд трейтов, которые можно использовать
с атрибутом derive, чтобы добавить своим типам полезное поведение. Эти
трейты и их поведение перечислены в приложении C. Как
реализовывать такие трейты со своим поведением и как создавать собственные
трейты, мы разберём в главе 10. Есть и много других атрибутов, помимо
derive; подробнее — в разделе «Attributes» справочника Rust.
Наша функция area очень узкоспециализированная: она умеет считать только
площадь прямоугольника. Раз ни с каким другим типом она работать не будет,
было бы полезно теснее связать это поведение со структурой Rectangle.
Посмотрим, как продолжить рефакторинг и превратить функцию area в метод
area, определённый для типа Rectangle.
Методы
Методы
Методы похожи на функции: они объявляются ключевым словом fn и именем, у них
могут быть параметры и возвращаемое значение, и в них есть код, который
выполняется, когда метод вызывают. Но, в отличие от функций, методы
определяются в контексте структуры (или перечисления, или трейт-объекта — о
них мы поговорим в главе 6 и главе
18 соответственно), а их первый параметр —
всегда self: это экземпляр структуры, у которого вызван метод.
Синтаксис методов
Превратим функцию area, которая принимает экземпляр Rectangle параметром,
в метод area, определённый для структуры Rectangle, как в листинге 5-13.
#[derive(Debug)]
struct Rectangle {
    width: u32,
    height: u32,
}

impl Rectangle {
    fn area(&self) -> u32 {
        self.width * self.height
    }
}

fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };

    println!(
        "The area of the rectangle is {} square pixels.",
        rect1.area()
    );
}area для структуры RectangleЧтобы определить функцию в контексте Rectangle, открываем для Rectangle
блок impl (от implementation — реализация). Всё, что внутри этого блока,
будет связано с типом Rectangle. Затем переносим функцию area в фигурные
скобки impl и меняем первый (а здесь и единственный) параметр на self —
и в сигнатуре, и везде в теле. В main, где мы вызывали функцию area и
передавали ей rect1, теперь можно воспользоваться синтаксисом методов и
вызвать метод area у экземпляра Rectangle. Вызов метода пишется после
экземпляра: точка, имя метода, круглые скобки и аргументы, если они есть.
В сигнатуре area мы пишем &self вместо rectangle: &Rectangle. На самом
деле &self — это сокращение от self: &Self. Внутри блока impl тип Self
— это псевдоним того типа, для которого написан блок impl. Первым
параметром у метода обязательно должен быть параметр с именем self типа
Self, поэтому Rust разрешает на месте первого параметра писать просто
self. Обратите внимание: перед self всё равно нужен &, чтобы показать,
что метод заимствует экземпляр Self, — так же, как мы писали
rectangle: &Rectangle. С self, как и с любым другим параметром, метод
может поступить по-разному: забрать во владение, позаимствовать неизменяемо
(как здесь) или позаимствовать изменяемо.
&self мы выбрали по той же причине, по которой в версии с функцией писали
&Rectangle: владение нам не нужно, мы хотим только читать данные структуры,
а не менять их. Если бы метод должен был менять экземпляр, у которого его
вызвали, первым параметром был бы &mut self. Методы, которые забирают
владение экземпляром, принимая первым параметром просто self, встречаются
редко. Обычно так делают, когда метод превращает self во что-то другое и
нужно, чтобы после этого превращения вызывающий код больше не мог
пользоваться исходным экземпляром.
Помимо удобного синтаксиса вызова и того, что не нужно повторять тип self в
сигнатуре каждого метода, главная причина использовать методы вместо функций —
организация кода. Всё, что можно делать с экземпляром типа, собрано в одном
блоке impl. Будущим пользователям нашего кода не придётся искать
возможности Rectangle по разным местам библиотеки.
Методу можно дать то же имя, что и одному из полей структуры. Например,
определим для Rectangle метод, который тоже называется width:
#[derive(Debug)]
struct Rectangle {
    width: u32,
    height: u32,
}

impl Rectangle {
    fn width(&self) -> bool {
        self.width > 0
    }
}

fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };

    if rect1.width() {
        println!("The rectangle has a nonzero width; it is {}", rect1.width);
    }
}
Здесь метод width возвращает true, если значение в поле width экземпляра
больше 0, и false, если оно равно 0: внутри метода с тем же именем поле
можно использовать для чего угодно. Когда в main после rect1.width стоят
круглые скобки, Rust понимает, что имеется в виду метод width. Без скобок —
что поле width.
Часто (хотя и не всегда) метод с тем же именем, что и поле, просто возвращает значение этого поля и больше ничего не делает. Такие методы называются геттерами (getters), и Rust, в отличие от некоторых других языков, не создаёт их для полей структуры автоматически. Геттеры полезны тем, что поле можно сделать приватным, а метод — публичным и таким образом дать в публичном API типа доступ к полю только на чтение. Что такое публичность и приватность и как сделать поле или метод публичным или приватным, мы обсудим в главе 7.
А где же оператор ->?
В C и C++ для вызова методов есть два разных оператора: ., если метод
вызывается прямо у объекта, и ->, если вызов идёт через указатель на
объект и указатель сначала нужно разыменовать. Иначе говоря, если object —
указатель, то object->something() — это примерно (*object).something().
Аналога оператора -> в Rust нет. Вместо этого в Rust есть
автоматическое взятие ссылки и разыменование (automatic referencing and
dereferencing). Вызов методов — одно из немногих мест в Rust, где так
происходит.
Работает это так: когда вы вызываете метод через object.something(), Rust
сам добавляет &, &mut или *, чтобы object соответствовал сигнатуре
метода. Иными словами, эти строки равнозначны:
#![allow(unused)]
fn main() {
#[derive(Debug,Copy,Clone)]
struct Point {
    x: f64,
    y: f64,
}

impl Point {
   fn distance(&self, other: &Point) -> f64 {
       let x_squared = f64::powi(other.x - self.x, 2);
       let y_squared = f64::powi(other.y - self.y, 2);

       f64::sqrt(x_squared + y_squared)
   }
}
let p1 = Point { x: 0.0, y: 0.0 };
let p2 = Point { x: 5.0, y: 6.5 };
p1.distance(&p2);
(&p1).distance(&p2);
}
Первый вариант выглядит куда чище. Автоматическое взятие ссылки работает
потому, что у методов есть явный получатель (receiver) — тип self. Зная
получатель и имя метода, Rust может однозначно определить, читает ли метод
данные (&self), изменяет их (&mut self) или поглощает (self). То, что
Rust неявно заимствует получателя метода, во многом и делает владение
удобным на практике.
Методы с несколькими параметрами
Потренируемся и напишем для структуры Rectangle второй метод. Он будет
принимать другой экземпляр Rectangle и возвращать true, если этот второй
прямоугольник целиком помещается внутри self (первого прямоугольника), а
иначе — false. То есть, определив метод
can_hold («может вместить»), мы хотим иметь возможность написать программу из
листинга 5-14.
fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };
    let rect2 = Rectangle {
        width: 10,
        height: 40,
    };
    let rect3 = Rectangle {
        width: 60,
        height: 45,
    };

    println!("Can rect1 hold rect2? {}", rect1.can_hold(&rect2));
    println!("Can rect1 hold rect3? {}", rect1.can_hold(&rect3));
}can_holdОжидаемый вывод будет таким: оба размера rect2 меньше размеров rect1, а
вот rect3 шире, чем rect1:
Can rect1 hold rect2? true
Can rect1 hold rect3? false
Раз мы определяем метод, он будет в блоке impl Rectangle. Назовём его
can_hold; параметром он примет неизменяемое заимствование другого
Rectangle. Каким должен быть тип параметра, видно из вызывающего кода:
rect1.can_hold(&rect2) передаёт &rect2 — неизменяемое заимствование
экземпляра Rectangle. Это логично: rect2 нам нужно только читать
(а не менять — тогда понадобилось бы изменяемое заимствование), и мы хотим,
чтобы main сохранила владение rect2 и могла пользоваться им после вызова
can_hold. Метод can_hold возвращает логическое значение, а внутри
проверяет, больше ли ширина и высота self соответственно ширины и высоты
другого Rectangle. Добавим новый метод can_hold в блок impl из
листинга 5-13 — см. листинг 5-15.
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn area(&self) -> u32 {
self.width * self.height
}
fn can_hold(&self, other: &Rectangle) -> bool {
self.width > other.width && self.height > other.height
}
}
fn main() {
let rect1 = Rectangle {
width: 30,
height: 50,
};
let rect2 = Rectangle {
width: 10,
height: 40,
};
let rect3 = Rectangle {
width: 60,
height: 45,
};
println!("Can rect1 hold rect2? {}", rect1.can_hold(&rect2));
println!("Can rect1 hold rect3? {}", rect1.can_hold(&rect3));
}Rectangle метод can_hold, который принимает параметром другой экземпляр RectangleЕсли запустить этот код с функцией main из листинга 5-14, получим нужный
вывод. Методы могут принимать несколько параметров — они добавляются в
сигнатуру после self и работают точно так же, как параметры функций.
Ассоциированные функции
Все функции, определённые в блоке impl, называются ассоциированными
функциями (associated functions), потому что они связаны с типом, указанным
после impl. Можно определять ассоциированные функции, у которых первый
параметр — не self (а значит, это не методы): им для работы не нужен
экземпляр типа. Одной такой функцией мы уже пользовались — это String::from,
определённая для типа String.
Ассоциированные функции, которые не являются методами, часто служат
конструкторами — возвращают новый экземпляр структуры. Их часто называют
new, но new — не какое-то особое имя и не встроено в язык. Например, можно
сделать ассоциированную функцию square («квадрат») с одним параметром —
размером стороны, который будет и шириной, и высотой. Так проще создать
квадратный Rectangle, не указывая одно и то же значение дважды:
Файл: src/main.rs
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn square(size: u32) -> Self {
Self {
width: size,
height: size,
}
}
}
fn main() {
let sq = Rectangle::square(3);
}Ключевое слово Self в возвращаемом типе и в теле функции — псевдоним
типа, указанного после impl, то есть в данном случае Rectangle.
Чтобы вызвать такую ассоциированную функцию, пишем имя структуры и ::,
например: let sq = Rectangle::square(3);. Функция находится в пространстве
имён структуры: синтаксис :: используется и для ассоциированных функций, и
для пространств имён, которые создают модули. О модулях мы поговорим в
главе 7.
Несколько блоков impl
У одной структуры может быть несколько блоков impl. Например, листинг 5-15
равнозначен коду из листинга 5-16, где каждый метод находится в отдельном
блоке impl.
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn area(&self) -> u32 {
self.width * self.height
}
}
impl Rectangle {
fn can_hold(&self, other: &Rectangle) -> bool {
self.width > other.width && self.height > other.height
}
}
fn main() {
let rect1 = Rectangle {
width: 30,
height: 50,
};
let rect2 = Rectangle {
width: 10,
height: 40,
};
let rect3 = Rectangle {
width: 60,
height: 45,
};
println!("Can rect1 hold rect2? {}", rect1.can_hold(&rect2));
println!("Can rect1 hold rect3? {}", rect1.can_hold(&rect3));
}implЗдесь разносить методы по разным блокам impl незачем, но синтаксис это
допускает. Случай, когда несколько блоков impl действительно полезны, мы
увидим в главе 10, где пойдёт речь об обобщённых типах и трейтах.
Итоги
Структуры позволяют создавать собственные типы, которые имеют смысл в вашей
предметной области. Со структурами связанные между собой данные остаются
вместе, а у каждой части есть имя, и код становится понятнее. В блоках impl
можно определять функции, связанные с вашим типом, а методы — это
разновидность ассоциированных функций, которая задаёт поведение экземпляров
ваших структур.
Но структуры — не единственный способ создавать собственные типы. Перейдём к перечислениям Rust и добавим в ваш арсенал ещё один инструмент.
Перечисления и сопоставление с образцом
В этой главе мы рассмотрим перечисления (enumerations, или коротко
enums). Перечисление позволяет определить тип, перечислив все его возможные
варианты. Сначала мы определим и используем перечисление, чтобы показать, как
оно может хранить смысл вместе с данными. Затем разберём особенно полезное
перечисление — Option, которое выражает, что значение либо есть, либо его
нет. Потом посмотрим, как сопоставление с образцом в выражении match
позволяет легко выполнять разный код для разных вариантов перечисления. И
наконец, познакомимся с конструкцией if let — ещё одной удобной и
лаконичной идиомой для работы с перечислениями.
Определение перечисления
Определение перечисления
Структуры позволяют сгруппировать связанные поля и данные — как Rectangle
со своими width и height. А перечисления позволяют сказать, что значение —
одно из заранее известного набора. Например, мы можем захотеть сказать, что
Rectangle — одна из возможных фигур, наряду с Circle (кругом) и Triangle
(треугольником). Для этого Rust позволяет описать все варианты в виде
перечисления.
Рассмотрим ситуацию, которую нужно выразить в коде, и посмотрим, почему здесь перечисления полезнее и уместнее структур. Допустим, нам нужно работать с IP-адресами. Сейчас используются два основных стандарта IP-адресов: четвёртая и шестая версии. Других вариантов наша программа не встретит, поэтому все возможные варианты можно перечислить — отсюда и название «перечисление».
Любой IP-адрес — либо четвёртой версии, либо шестой, но не обоих сразу. Это свойство IP-адресов как раз и делает перечисление подходящей структурой данных: значение перечисления может быть только одним из его вариантов. При этом адреса и четвёртой, и шестой версии — по сути всё равно IP-адреса, поэтому в коде, который работает с любыми IP-адресами, их нужно считать одним типом.
Выразим это в коде: определим перечисление IpAddrKind и перечислим, какими
могут быть IP-адреса, — V4 и V6. Это и есть варианты перечисления:
enum IpAddrKind {
V4,
V6,
}
fn main() {
let four = IpAddrKind::V4;
let six = IpAddrKind::V6;
route(IpAddrKind::V4);
route(IpAddrKind::V6);
}
fn route(ip_kind: IpAddrKind) {}Теперь IpAddrKind — пользовательский тип данных, которым можно пользоваться
в других местах кода.
Значения перечисления
Экземпляры обоих вариантов IpAddrKind создаются так:
enum IpAddrKind {
V4,
V6,
}
fn main() {
let four = IpAddrKind::V4;
let six = IpAddrKind::V6;
route(IpAddrKind::V4);
route(IpAddrKind::V6);
}
fn route(ip_kind: IpAddrKind) {}Обратите внимание: варианты находятся в пространстве имён перечисления,
поэтому вариант записывается через двойное двоеточие после имени перечисления. Это удобно: теперь
оба значения, IpAddrKind::V4 и IpAddrKind::V6, имеют один и тот же тип —
IpAddrKind. Значит, можно, например, определить функцию, которая принимает
любой IpAddrKind:
enum IpAddrKind {
V4,
V6,
}
fn main() {
let four = IpAddrKind::V4;
let six = IpAddrKind::V6;
route(IpAddrKind::V4);
route(IpAddrKind::V6);
}
fn route(ip_kind: IpAddrKind) {}И вызывать её с любым из вариантов:
enum IpAddrKind {
V4,
V6,
}
fn main() {
let four = IpAddrKind::V4;
let six = IpAddrKind::V6;
route(IpAddrKind::V4);
route(IpAddrKind::V6);
}
fn route(ip_kind: IpAddrKind) {}Но у перечислений есть и другие преимущества. Подумаем ещё о нашем типе для IP-адресов: сейчас у нас нет способа хранить сами данные адреса — мы знаем только его вид. Вы только что изучили структуры в главе 5, и, возможно, вам захочется решить задачу с их помощью, как в листинге 6-1.
fn main() {
enum IpAddrKind {
V4,
V6,
}
struct IpAddr {
kind: IpAddrKind,
address: String,
}
let home = IpAddr {
kind: IpAddrKind::V4,
address: String::from("127.0.0.1"),
};
let loopback = IpAddr {
kind: IpAddrKind::V6,
address: String::from("::1"),
};
}IpAddrKind с помощью structЗдесь мы определили структуру IpAddr с двумя полями: kind типа
IpAddrKind (перечисление, определённое выше) и address типа String. У нас
два экземпляра этой структуры. Первый — home: у него kind равно
IpAddrKind::V4, а адрес — 127.0.0.1. Второй — loopback: у него kind —
другой вариант IpAddrKind, V6, а адрес — ::1. Мы использовали структуру,
чтобы связать kind и address вместе, так что теперь вариант привязан к
значению.
Однако то же самое можно выразить короче — одним только перечислением. Вместо
перечисления внутри структуры можно положить данные прямо в каждый вариант
перечисления. Новое определение перечисления IpAddr говорит, что у обоих
вариантов, V4 и V6, есть связанное значение String:
fn main() {
enum IpAddr {
V4(String),
V6(String),
}
let home = IpAddr::V4(String::from("127.0.0.1"));
let loopback = IpAddr::V6(String::from("::1"));
}Мы прикрепляем данные прямо к каждому варианту перечисления, так что
дополнительная структура не нужна. Здесь заодно легче увидеть ещё одну деталь
работы перечислений: имя каждого варианта, который мы определяем, становится
также функцией, создающей экземпляр перечисления. То есть IpAddr::V4() —
это вызов функции, которая принимает аргумент String и возвращает экземпляр
типа IpAddr. Эту функцию-конструктор мы получаем автоматически, просто
определив перечисление.
Есть у перечисления перед структурой и ещё одно преимущество: у каждого
варианта могут быть данные разных типов и в разном количестве. В адресе
четвёртой версии всегда четыре числа от 0 до 255. Если бы мы захотели хранить
адреса V4 как четыре значения u8, а адреса V6 — по-прежнему как одно
значение String, со структурой так бы не получилось. А перечисление
справляется с этим легко:
fn main() {
enum IpAddr {
V4(u8, u8, u8, u8),
V6(String),
}
let home = IpAddr::V4(127, 0, 0, 1);
let loopback = IpAddr::V6(String::from("::1"));
}Мы показали несколько разных способов описать структуры данных для хранения
IP-адресов четвёртой и шестой версий. Но, как оказалось, хранить IP-адреса
вместе с их видом нужно настолько часто, что в стандартной библиотеке уже
есть готовое определение! Посмотрим, как стандартная
библиотека определяет IpAddr. Там ровно такое же перечисление с такими же
вариантами, но данные адреса хранятся внутри вариантов в виде двух разных
структур, по-своему устроенных для каждого варианта:
#![allow(unused)]
fn main() {
struct Ipv4Addr {
// --snip--
}
struct Ipv6Addr {
// --snip--
}
enum IpAddr {
V4(Ipv4Addr),
V6(Ipv6Addr),
}
}Этот код показывает, что внутрь варианта перечисления можно положить данные любого вида: строки, числа, структуры. Можно даже положить другое перечисление! А ещё видно, что типы стандартной библиотеки зачастую ненамного сложнее того, что могли бы придумать вы сами.
Заметьте: хотя в стандартной библиотеке есть определение IpAddr, мы всё
равно можем создавать и использовать собственное, и конфликта не будет — ведь
определение из стандартной библиотеки мы не подключали в свою область
видимости. Подробнее о подключении типов в область видимости мы поговорим в
главе 7.
Рассмотрим ещё один пример перечисления — в листинге 6-2. В его вариантах хранятся самые разные типы.
enum Message {
Quit,
Move { x: i32, y: i32 },
Write(String),
ChangeColor(i32, i32, i32),
}
fn main() {}Message, варианты которого хранят значения разных типов и в разном количествеУ этого перечисления четыре варианта с разными типами:
Quit— никаких связанных данных нет вообще;Move— именованные поля, как у структуры;Write— однаString;ChangeColor— три значенияi32.
Определить перечисление с вариантами, как в листинге 6-2, — почти то же, что
определить несколько разных структур. Разница в том, что у перечисления нет
ключевого слова struct и все варианты собраны вместе под типом Message.
Те же данные, что хранят варианты перечисления, можно было бы хранить в таких
структурах:
struct QuitMessage; // единичная структура
struct MoveMessage {
x: i32,
y: i32,
}
struct WriteMessage(String); // кортежная структура
struct ChangeColorMessage(i32, i32, i32); // кортежная структура
fn main() {}Но у каждой из этих структур был бы свой тип, и написать функцию, которая
принимает любое такое сообщение, было бы не так просто, как с перечислением
Message из листинга 6-2 — ведь это один тип.
Есть у перечислений и структур ещё одно сходство: точно так же, как для
структур определяют методы через impl, их можно определять и для
перечислений. Вот метод call, который можно определить для нашего
перечисления Message:
fn main() {
enum Message {
Quit,
Move { x: i32, y: i32 },
Write(String),
ChangeColor(i32, i32, i32),
}
impl Message {
fn call(&self) {
// здесь было бы тело метода
}
}
let m = Message::Write(String::from("hello"));
m.call();
}В теле метода self даёт доступ к значению, у которого метод вызван. В этом
примере мы создали переменную m со значением
Message::Write(String::from("hello")) — именно оно и будет self в теле
метода call, когда выполнится m.call().
Теперь посмотрим на другое перечисление из стандартной библиотеки — очень
распространённое и полезное: Option.
Перечисление Option
В этом разделе мы подробно разберём Option — ещё одно перечисление из
стандартной библиотеки. Тип Option описывает очень частую ситуацию: значение
может быть, а может и не быть.
Например, если попросить первый элемент непустого списка, вы получите значение. А если попросить первый элемент пустого списка — ничего не получите. Если выразить это через систему типов, компилятор сможет проверить, что вы обработали все нужные случаи. Это предотвращает ошибки, которые крайне часто встречаются в других языках программирования.
О дизайне языка программирования обычно судят по тому, какие возможности в нём есть, но не менее важно, каких в нём нет. В Rust нет значения null, которое есть во многих других языках. Null — это значение, которое означает, что значения нет. В языках с null переменная всегда находится в одном из двух состояний: null или не null.
В своём выступлении 2009 года «Null References: The Billion Dollar Mistake» («Нулевые ссылки: ошибка на миллиард долларов») изобретатель null Тони Хоар сказал:
Я называю это своей ошибкой на миллиард долларов. Тогда я проектировал первую полноценную систему типов для ссылок в объектно-ориентированном языке. Моей целью было сделать любое использование ссылок абсолютно безопасным, чтобы проверки автоматически выполнял компилятор. Но я не смог устоять перед соблазном добавить нулевую ссылку — просто потому, что её было так легко реализовать. Это привело к бесчисленным ошибкам, уязвимостям и сбоям систем, которые за последние сорок лет, вероятно, принесли боли и ущерба на миллиард долларов.
Проблема с null в том, что если попытаться использовать null как обычное значение, получится какая-нибудь ошибка. А поскольку любое значение может оказаться null или не null, ошибиться таким образом очень легко.
При этом сама идея, которую пытается выразить null, полезна: null — это значение, которое по какой-то причине сейчас недействительно или отсутствует.
Проблема не в самой идее, а в конкретной реализации. Поэтому в Rust нет null,
зато есть перечисление, которое выражает, что значение есть или его нет. Это
перечисление называется Option<T>, и в стандартной библиотеке оно
определено так:
#![allow(unused)]
fn main() {
enum Option<T> {
None,
Some(T),
}
}Перечисление Option<T> настолько полезно, что входит в прелюдию: подключать
его в область видимости явно не нужно. Его варианты тоже входят в прелюдию:
Some и None можно использовать напрямую, без префикса Option::. При этом
Option<T> — самое обычное перечисление, а Some(T) и None — его варианты
типа Option<T>.
Синтаксис <T> — это возможность Rust, о которой мы ещё не говорили.
Это обобщённый параметр типа, и подробно обобщения мы разберём в главе 10.
Пока достаточно знать, что <T> означает: вариант Some перечисления
Option может хранить одно значение любого типа, и каждый конкретный тип,
подставленный вместо T, делает Option<T> отдельным типом. Вот несколько
примеров значений Option, хранящих числа и символы:
fn main() {
let some_number = Some(5);
let some_char = Some('e');
let absent_number: Option<i32> = None;
}Тип some_number — Option<i32>. Тип some_char — Option<char>, и это
уже другой тип. Rust может вывести эти типы, потому что внутри варианта Some
мы указали значение. А вот для absent_number Rust требует указать тип
Option целиком: по одному лишь значению None компилятор не может понять,
что хранил бы соответствующий вариант Some. Здесь мы говорим Rust, что
absent_number должна иметь тип Option<i32>.
Если у нас значение Some, мы знаем, что значение есть и лежит внутри Some.
Если же у нас None, то в каком-то смысле это то же самое, что null:
действительного значения нет. Так чем же Option<T> лучше null?
Коротко: Option<T> и T (где T — любой тип) — это разные типы, поэтому
компилятор не даст использовать значение Option<T> так, будто в нём точно
есть действительное значение. Например, этот код не скомпилируется — он
пытается сложить i8 с Option<i8>:
fn main() {
let x: i8 = 5;
let y: Option<i8> = Some(5);
let sum = x + y;
}Если запустить этот код, получим примерно такое сообщение об ошибке:
$ cargo run
Compiling enums v0.1.0 (file:///projects/enums)
error[E0277]: cannot add `Option<i8>` to `i8`
--> src/main.rs:5:17
|
5 | let sum = x + y;
| ^ no implementation for `i8 + Option<i8>`
|
= help: the trait `Add<Option<i8>>` is not implemented for `i8`
help: the following other types implement trait `Add<Rhs>`
--> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/ops/arith.rs:98:8
|
= note: `i8` implements `Add`
::: /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/ops/arith.rs:113:0
|
= note: in this macro invocation
--> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/internal_macros.rs:22:8
|
= note: `&i8` implements `Add<i8>`
::: /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/internal_macros.rs:33:8
|
= note: `i8` implements `Add<&i8>`
::: /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/internal_macros.rs:44:8
|
= note: `&i8` implements `Add`
= note: this error originates in the macro `add_impl` (in Nightly builds, run with -Z macro-backtrace for more info)
For more information about this error, try `rustc --explain E0277`.
error: could not compile `enums` (bin "enums") due to 1 previous error
Сурово! По сути, сообщение говорит, что Rust не понимает, как сложить i8 и
Option<i8>, потому что это разные типы. Когда у нас значение типа вроде
i8, компилятор гарантирует, что значение всегда действительное. Можно
спокойно им пользоваться, не проверяя перед этим на null. Беспокоиться о том,
что значения может не быть, приходится, только когда у нас Option<i8> (или
Option с другим нужным типом), — и компилятор проследит, чтобы мы обработали
этот случай, прежде чем пользоваться значением.
Иначе говоря, прежде чем выполнять с Option<T> операции типа T, его нужно
превратить в T. Как правило, это помогает поймать одну из самых частых
проблем с null: когда предполагаешь, что что-то не null, а оно на самом деле
null.
Когда исчезает риск ошибочно посчитать значение не-null, код становится
надёжнее. Чтобы значение могло отсутствовать, нужно явно на это согласиться и
сделать его тип Option<T>. А пользуясь таким значением, вы обязаны явно
обработать случай, когда его нет. Везде, где у значения тип не Option<T>,
можно смело считать, что оно не null. Это сознательное решение в дизайне Rust:
ограничить распространение null и повысить безопасность кода.
Как же достать значение T из варианта Some, если у вас значение типа
Option<T>? У перечисления Option<T> множество методов на все случаи жизни —
посмотрите их в документации. Знакомство с методами
Option<T> очень пригодится вам в работе с Rust.
В целом, чтобы использовать значение Option<T>, нужен код, который
обработает каждый вариант. Какой-то код должен выполняться, только когда
значение — Some(T), и этот код может пользоваться внутренним T. А другой
код должен выполняться, только когда значение — None, и значения T у него
нет. Выражение match — конструкция управления потоком, которая с
перечислениями делает ровно это: выполняет разный код в зависимости от
варианта перечисления, и этот код может пользоваться данными внутри
совпавшего значения.
Конструкция match
Конструкция match
В Rust есть чрезвычайно мощная конструкция управления потоком — match. Она
сравнивает значение с рядом образцов и выполняет код в зависимости от того,
какой образец совпал. Образцы могут состоять из литералов, имён переменных,
подстановочных знаков и многого другого; все виды образцов и то, что они
делают, описаны в главе 19. Сила match —
в выразительности образцов и в том, что компилятор проверяет: все возможные
случаи обработаны.
Выражение match можно представить как автомат для сортировки монет: монеты
катятся по жёлобу с отверстиями разного размера, и каждая проваливается в
первое же отверстие, в которое пролезает. Так же и значение в match по
очереди проходит мимо образцов. Как только оно подходит под какой-то образец,
выполняется код этой ветки.
Раз уж речь зашла о монетах, на них и разберём match! Напишем функцию,
которая принимает неизвестную американскую монету и, подобно счётному
автомату, определяет, что это за монета, и возвращает её достоинство в
центах, как в листинге 6-3.
enum Coin {
Penny,
Nickel,
Dime,
Quarter,
}
fn value_in_cents(coin: Coin) -> u8 {
match coin {
Coin::Penny => 1,
Coin::Nickel => 5,
Coin::Dime => 10,
Coin::Quarter => 25,
}
}
fn main() {}match, образцами в котором служат варианты перечисленияРазберём match в функции value_in_cents. Сначала идёт ключевое слово
match, а за ним — выражение, в нашем случае значение coin. Похоже на
условие в if, но есть большая разница: условие if должно давать
логическое значение, а здесь может быть значение любого типа. Тип coin в
этом примере — перечисление Coin, которое мы определили в первой строке.
Дальше идут ветки match. У ветки две части: образец и код. В первой ветке
образец — значение Coin::Penny, а за ним оператор =>, который отделяет
образец от кода. Код в данном случае — просто значение 1. Ветки отделяются
друг от друга запятыми.
Когда выполняется выражение match, оно по порядку сравнивает значение с
образцом каждой ветки. Если образец совпал, выполняется код этой ветки. Если
нет, проверяется следующая ветка — совсем как в автомате для сортировки
монет. Веток может быть сколько угодно: в листинге 6-3 их четыре.
Код каждой ветки — это выражение, и значение выражения в совпавшей ветке
становится значением всего выражения match.
Если код в ветке короткий, фигурные скобки обычно не пишут — как в листинге
6-3, где каждая ветка просто возвращает значение. Если же в ветке нужно
выполнить несколько строк кода, фигурные скобки обязательны, а запятая после
такой ветки становится необязательной. Например, следующий код выводит
«Lucky penny!» при каждом вызове с Coin::Penny, но всё равно возвращает
последнее значение блока — 1:
enum Coin {
Penny,
Nickel,
Dime,
Quarter,
}
fn value_in_cents(coin: Coin) -> u8 {
match coin {
Coin::Penny => {
println!("Lucky penny!");
1
}
Coin::Nickel => 5,
Coin::Dime => 10,
Coin::Quarter => 25,
}
}
fn main() {}Образцы, привязывающие значения
Ещё одна полезная возможность веток match — они могут привязывать к
переменным части значения, совпавшего с образцом. Так из вариантов
перечисления и достают значения.
Для примера изменим один из вариантов перечисления, чтобы он хранил данные.
С 1999 по 2008 год в США чеканили 25-центовые монеты (quarters), на одной
стороне которых было изображение, своё для каждого из 50 штатов. Другим
монетам такие изображения не достались, так что это дополнительное значение
есть только у четвертаков. Добавим эту информацию в наше enum: пусть вариант
Quarter хранит внутри значение UsState, как в листинге 6-4.
#[derive(Debug)] // чтобы чуть позже посмотреть на штат
enum UsState {
Alabama,
Alaska,
// --пропуск--
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn main() {}Coin, в котором вариант Quarter хранит ещё и значение UsStateПредставим, что друг собирает коллекцию четвертаков всех 50 штатов. Сортируя мелочь по типам монет, мы будем заодно называть штат на каждом четвертаке — и если такого у друга ещё нет, он сможет пополнить коллекцию.
В образец ветки для варианта Coin::Quarter мы добавляем переменную
state. Когда совпадает
Coin::Quarter, переменная state привязывается к штату этого четвертака.
Теперь state можно использовать в коде ветки:
#[derive(Debug)]
enum UsState {
Alabama,
Alaska,
// --пропуск--
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn value_in_cents(coin: Coin) -> u8 {
match coin {
Coin::Penny => 1,
Coin::Nickel => 5,
Coin::Dime => 10,
Coin::Quarter(state) => {
println!("State quarter from {state:?}!");
25
}
}
}
fn main() {
value_in_cents(Coin::Quarter(UsState::Alaska));
}Если вызвать value_in_cents(Coin::Quarter(UsState::Alaska)), то coin будет
равно Coin::Quarter(UsState::Alaska). Сравнивая это значение с ветками,
match не найдёт совпадений, пока не дойдёт до Coin::Quarter(state). Тут
state привяжется к значению UsState::Alaska. Эту привязку можно
использовать в println! — так мы и достаём штат из варианта Quarter
перечисления Coin.
Сопоставление с Option<T>
В предыдущем разделе мы хотели достать внутреннее значение T из варианта
Some у Option<T>. С Option<T> можно работать через match точно так же,
как с перечислением Coin! Только сравнивать мы будем не монеты, а варианты
Option<T>, — а работает выражение match всё так же.
Допустим, нужно написать функцию, которая принимает Option<i32> и, если
внутри есть значение, прибавляет к нему 1. Если значения внутри нет, функция
должна вернуть None и ничего не делать.
Благодаря match такую функцию написать очень просто — она будет выглядеть
как в листинге 6-5.
fn main() {
fn plus_one(x: Option<i32>) -> Option<i32> {
match x {
None => None,
Some(i) => Some(i + 1),
}
}
let five = Some(5);
let six = plus_one(five);
let none = plus_one(None);
}match к Option<i32>Разберём подробнее первый вызов plus_one. Когда мы вызываем
plus_one(five), переменная x в теле plus_one имеет значение Some(5).
Сравниваем его с каждой веткой:
fn main() {
fn plus_one(x: Option<i32>) -> Option<i32> {
match x {
None => None,
Some(i) => Some(i + 1),
}
}
let five = Some(5);
let six = plus_one(five);
let none = plus_one(None);
}Some(5) не совпадает с образцом None, так что переходим к следующей ветке:
fn main() {
fn plus_one(x: Option<i32>) -> Option<i32> {
match x {
None => None,
Some(i) => Some(i + 1),
}
}
let five = Some(5);
let six = plus_one(five);
let none = plus_one(None);
}Совпадает ли Some(5) с Some(i)? Да! Вариант тот же. i привязывается к
значению внутри Some, то есть получает значение 5. Затем выполняется код
ветки: прибавляем к i единицу и создаём новое значение Some, внутри
которого лежит результат — 6.
Теперь второй вызов plus_one в листинге 6-5, где x равно None. Входим в
match и сравниваем с первой веткой:
fn main() {
fn plus_one(x: Option<i32>) -> Option<i32> {
match x {
None => None,
Some(i) => Some(i + 1),
}
}
let five = Some(5);
let six = plus_one(five);
let none = plus_one(None);
}Совпало! Прибавлять не к чему, поэтому match сразу возвращает None,
стоящее справа от =>. Раз первая ветка совпала,
остальные уже не проверяются.
Сочетание match и перечислений полезно во многих ситуациях. Этот приём вы
будете часто встречать в коде на Rust: сопоставить перечисление через match,
привязать переменную к данным внутри и выполнить код в зависимости от них.
Поначалу это непривычно, но, освоившись, вы будете скучать по нему в других
языках. Это неизменно одна из самых любимых возможностей у пользователей
Rust.
match охватывает все варианты
Есть ещё один аспект match, который нужно обсудить: образцы веток должны
покрывать все возможные случаи. Посмотрите на эту версию функции plus_one —
в ней баг, и она не скомпилируется:
fn main() {
fn plus_one(x: Option<i32>) -> Option<i32> {
match x {
Some(i) => Some(i + 1),
}
}
let five = Some(5);
let six = plus_one(five);
let none = plus_one(None);
}Мы не обработали случай None, так что этот код привёл бы к ошибке. К
счастью, такие баги Rust ловить умеет. При компиляции получим ошибку:
$ cargo run
Compiling enums v0.1.0 (file:///projects/enums)
error[E0004]: non-exhaustive patterns: `None` not covered
--> src/main.rs:3:15
|
3 | match x {
| ^ pattern `None` not covered
|
note: `Option<i32>` defined here
--> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/option.rs:598:0
::: /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/option.rs:602:4
|
= note: not covered
= note: the matched value is of type `Option<i32>`
help: ensure that all possible cases are being handled by adding a match arm with a wildcard pattern or an explicit pattern as shown
|
4 ~ Some(i) => Some(i + 1),
5 ~ None => todo!(),
|
For more information about this error, try `rustc --explain E0004`.
error: could not compile `enums` (bin "enums") due to 1 previous error
Rust знает, что мы покрыли не все возможные случаи, и даже знает, какой
именно образец мы забыли! Выражения match в Rust исчерпывающие
(exhaustive): чтобы код был корректным, нужно перебрать все без исключения
варианты. Особенно это важно для Option<T>: не давая забыть про явную
обработку None, Rust защищает нас от предположения, что значение есть, когда
его может не быть. Так та самая ошибка на миллиард долларов становится
невозможной.
Образцы «для всего остального» и заполнитель _
С перечислениями можно делать что-то особенное для нескольких конкретных
значений, а для всех остальных — одно действие по умолчанию. Представьте, что
мы пишем игру: если на кубике выпало 3, игрок не ходит, а получает новую
модную шляпу. Если выпало 7 — игрок модную шляпу теряет. При любом другом
значении игрок перемещается по полю на столько клеток. Вот match, который
реализует эту логику. Результат броска здесь вписан в код, а не случайный, а
вся остальная логика представлена функциями без тела — их настоящая
реализация выходит за рамки примера:
fn main() {
let dice_roll = 9;
match dice_roll {
3 => add_fancy_hat(),
7 => remove_fancy_hat(),
other => move_player(other),
}
fn add_fancy_hat() {}
fn remove_fancy_hat() {}
fn move_player(num_spaces: u8) {}
}В первых двух ветках образцы — литералы 3 и 7. В последней ветке, которая
покрывает все остальные возможные значения, образец — переменная, которую мы
назвали other. Код этой ветки использует переменную, передавая её в функцию
move_player.
Этот код компилируется, хотя мы перечислили не все возможные значения u8:
последний образец совпадает со всеми значениями, не перечисленными явно.
Такой образец «для всего остального» (catch-all) удовлетворяет требованию
исчерпывающей проверки. Заметьте, что ветку «для всего остального» нужно
ставить последней: образцы проверяются по порядку. Если поставить её раньше,
остальные ветки никогда не выполнятся, поэтому Rust предупредит, если после
неё есть ещё ветки!
Есть в Rust и образец на случай, когда «всё остальное» нужно поймать, но
использовать само значение не нужно: _ — особый образец, который совпадает
с любым значением и не привязывает его к переменной. Так мы сообщаем Rust,
что значение использовать не будем, и Rust не станет предупреждать о
неиспользуемой переменной.
Изменим правила игры: теперь если выпало что-то кроме 3 или 7, нужно бросать
ещё раз. Значение «всего остального» нам больше не нужно, поэтому вместо
переменной other можно написать _:
fn main() {
let dice_roll = 9;
match dice_roll {
3 => add_fancy_hat(),
7 => remove_fancy_hat(),
_ => reroll(),
}
fn add_fancy_hat() {}
fn remove_fancy_hat() {}
fn reroll() {}
}Этот пример тоже удовлетворяет требованию исчерпывающей проверки: в последней ветке мы явно игнорируем все прочие значения — ничего не забыто.
И наконец, ещё раз поменяем правила: если выпало что-то кроме 3 или 7, в этот
ход вообще ничего не происходит. Выразить это можно, указав в качестве кода
ветки _ единичное значение (пустой кортеж, о котором мы говорили в разделе
«Кортежи»):
fn main() {
let dice_roll = 9;
match dice_roll {
3 => add_fancy_hat(),
7 => remove_fancy_hat(),
_ => (),
}
fn add_fancy_hat() {}
fn remove_fancy_hat() {}
}Здесь мы явно говорим Rust: любые значения, не совпавшие с образцами предыдущих веток, использовать не будем, и никакой код в этом случае выполнять не нужно.
Об образцах и сопоставлении можно рассказать ещё много — мы займёмся этим в
главе 19. А сейчас перейдём к синтаксису
if let, который выручает там, где выражение match получается многословным.
Краткое управление потоком: if let и let...else
Краткое управление потоком: if let и let...else
Синтаксис if let объединяет if и let и позволяет короче записать
обработку значений, которые совпадают с одним образцом, игнорируя все
остальные. Посмотрите на программу из листинга 6-6: она сопоставляет
значение Option<u8> из переменной config_max, но выполнять код хочет только
тогда, когда значение — вариант Some.
fn main() {
let config_max = Some(3u8);
match config_max {
Some(max) => println!("The maximum is configured to be {max}"),
_ => (),
}
}match, которому важно выполнить код только для значения SomeЕсли значение — Some, мы выводим лежащее в нём значение, привязав его в
образце к переменной max. Со значением None мы ничего делать не хотим. Но
чтобы удовлетворить match, после обработки единственного варианта
приходится дописывать _ => () — раздражающий шаблонный код.
Вместо этого можно написать то же короче, с помощью if let. Следующий код
ведёт себя точно так же, как match из листинга 6-6:
fn main() {
let config_max = Some(3u8);
if let Some(max) = config_max {
println!("The maximum is configured to be {max}");
}
}if let принимает образец и выражение, разделённые знаком равенства.
Работает это так же, как match, которому передали это выражение и у которого
этот образец — первая ветка. Здесь образец — Some(max), и max привязывается
к значению внутри Some. Дальше max можно использовать в теле блока
if let точно так же, как в соответствующей ветке match. Код в блоке
if let выполняется, только если значение совпало с образцом.
С if let меньше набирать, меньше отступов и шаблонного кода. Но вы теряете
исчерпывающую проверку, которую обеспечивает match и которая гарантирует,
что вы не забыли обработать какой-то случай. Что выбрать — match или
if let, — зависит от конкретной ситуации: стоит ли краткость потери
исчерпывающей проверки.
Иначе говоря, if let можно считать синтаксическим сахаром для match,
который выполняет код, когда значение совпадает с одним образцом, и
игнорирует все остальные значения.
К if let можно добавить else. Блок кода после else — то же самое, что
код ветки _ в равнозначном выражении match. Вспомните определение
перечисления Coin из листинга 6-4, где вариант Quarter хранил ещё и
значение UsState. Если бы мы хотели посчитать все монеты, кроме
четвертаков, и при этом называть штат на каждом четвертаке, это можно было бы
сделать выражением match:
#[derive(Debug)]
enum UsState {
Alabama,
Alaska,
// --пропуск--
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn main() {
let coin = Coin::Penny;
let mut count = 0;
match coin {
Coin::Quarter(state) => println!("State quarter from {state:?}!"),
_ => count += 1,
}
}А можно — выражением if let с else:
#[derive(Debug)]
enum UsState {
Alabama,
Alaska,
// --пропуск--
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn main() {
let coin = Coin::Penny;
let mut count = 0;
if let Coin::Quarter(state) = coin {
println!("State quarter from {state:?}!");
} else {
count += 1;
}
}Остаёмся на «счастливом пути» с let...else
Частая ситуация: если значение есть — выполнить с ним какие-то вычисления, а
если нет — вернуть значение по умолчанию. Продолжим пример с монетами и
UsState. Допустим, мы хотим сказать что-нибудь забавное в зависимости от
того, насколько старый штат изображён на четвертаке. Для этого можно добавить
к UsState метод, проверяющий возраст штата:
#[derive(Debug)] // чтобы чуть позже посмотреть на штат
enum UsState {
Alabama,
Alaska,
// --пропуск--
}
impl UsState {
fn existed_in(&self, year: u16) -> bool {
match self {
UsState::Alabama => year >= 1819,
UsState::Alaska => year >= 1959,
// -- пропуск --
}
}
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn describe_state_quarter(coin: Coin) -> Option<String> {
if let Coin::Quarter(state) = coin {
if state.existed_in(1900) {
Some(format!("{state:?} is pretty old, for America!"))
} else {
Some(format!("{state:?} is relatively new."))
}
} else {
None
}
}
fn main() {
if let Some(desc) = describe_state_quarter(Coin::Quarter(UsState::Alaska)) {
println!("{desc}");
}
}Затем с помощью if let можно сопоставить тип монеты и получить переменную
state в теле условия, как в листинге 6-7.
#[derive(Debug)] // чтобы чуть позже посмотреть на штат
enum UsState {
Alabama,
Alaska,
// --пропуск--
}
impl UsState {
fn existed_in(&self, year: u16) -> bool {
match self {
UsState::Alabama => year >= 1819,
UsState::Alaska => year >= 1959,
// -- пропуск --
}
}
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn describe_state_quarter(coin: Coin) -> Option<String> {
if let Coin::Quarter(state) = coin {
if state.existed_in(1900) {
Some(format!("{state:?} is pretty old, for America!"))
} else {
Some(format!("{state:?} is relatively new."))
}
} else {
None
}
}
fn main() {
if let Some(desc) = describe_state_quarter(Coin::Quarter(UsState::Alaska)) {
println!("{desc}");
}
}if letЗадачу это решает, но вся работа оказалась внутри тела if let. Если бы
работа была сложнее, было бы трудно уследить, как связаны между собой ветки
верхнего уровня. Можно воспользоваться тем, что выражения возвращают значение:
либо получить state из if let, либо досрочно выйти из функции, как в
листинге 6-8. (С match можно сделать нечто похожее.)
#[derive(Debug)] // чтобы чуть позже посмотреть на штат
enum UsState {
Alabama,
Alaska,
// --пропуск--
}
impl UsState {
fn existed_in(&self, year: u16) -> bool {
match self {
UsState::Alabama => year >= 1819,
UsState::Alaska => year >= 1959,
// -- пропуск --
}
}
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn describe_state_quarter(coin: Coin) -> Option<String> {
let state = if let Coin::Quarter(state) = coin {
state
} else {
return None;
};
if state.existed_in(1900) {
Some(format!("{state:?} is pretty old, for America!"))
} else {
Some(format!("{state:?} is relatively new."))
}
}
fn main() {
if let Some(desc) = describe_state_quarter(Coin::Quarter(UsState::Alaska)) {
println!("{desc}");
}
}if let либо выдаёт значение, либо досрочно выходит из функцииНо и за этим по-своему неудобно следить! Одна ветка if let выдаёт значение,
а другая вообще выходит из функции.
Чтобы такой частый случай записывался приятнее, в Rust есть let...else.
Синтаксис let...else очень похож на if let: слева образец, справа
выражение. Но ветки if у него нет — только ветка else. Если образец
совпал, значение из образца привязывается к переменной во внешней области
видимости. Если не совпал, выполнение переходит в ветку else, которая
обязана выйти из функции.
В листинге 6-9 показано, как выглядит листинг 6-8, если вместо if let
использовать let...else.
#[derive(Debug)] // чтобы чуть позже посмотреть на штат
enum UsState {
Alabama,
Alaska,
// --пропуск--
}
impl UsState {
fn existed_in(&self, year: u16) -> bool {
match self {
UsState::Alabama => year >= 1819,
UsState::Alaska => year >= 1959,
// -- пропуск --
}
}
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn describe_state_quarter(coin: Coin) -> Option<String> {
let Coin::Quarter(state) = coin else {
return None;
};
if state.existed_in(1900) {
Some(format!("{state:?} is pretty old, for America!"))
} else {
Some(format!("{state:?} is relatively new."))
}
}
fn main() {
if let Some(desc) = describe_state_quarter(Coin::Quarter(UsState::Alaska)) {
println!("{desc}");
}
}let...else делает ход выполнения функции нагляднееОбратите внимание: основной код функции остаётся на «счастливом пути»
(happy path). В нём больше нет развилки, где одна ветка выдаёт значение, а
другая выходит из функции, как было с if let.
Если логику программы слишком многословно выражать через match, помните,
что в вашем арсенале есть ещё if let и let...else.
Итоги
Мы разобрали, как с помощью перечислений создавать собственные типы, значение
которых — одно из заранее перечисленных. Мы показали, как тип Option<T> из
стандартной библиотеки помогает с помощью системы типов предотвращать ошибки.
Если внутри значений перечисления есть данные, достать и использовать их
можно через match или if let — в зависимости от того, сколько случаев
нужно обработать.
Теперь ваши программы на Rust могут выражать понятия предметной области с помощью структур и перечислений. Собственные типы в вашем API обеспечивают типобезопасность: компилятор проследит, чтобы каждая функция получала только значения того типа, который она ожидает.
Чтобы дать пользователям хорошо организованный API — простой в использовании и открывающий ровно то, что им нужно, — перейдём к модулям Rust.
Пакеты, крейты и модули
Чем больше программа, тем важнее становится организация кода. Если группировать связанную функциональность и разделять код с разными задачами, будет понятно, где искать код, реализующий нужную возможность, и куда идти, чтобы поменять её поведение.
Все программы, которые мы писали до сих пор, умещались в одном модуле в одном файле. Когда проект растёт, код стоит разбивать на несколько модулей, а затем и на несколько файлов. Пакет может содержать несколько бинарных крейтов и, при желании, один библиотечный крейт. По мере роста пакета его части можно выносить в отдельные крейты, которые становятся внешними зависимостями. Обо всех этих приёмах и пойдёт речь в этой главе. Для совсем больших проектов, состоящих из нескольких связанных пакетов, которые развиваются вместе, в Cargo есть рабочие пространства — о них мы поговорим в разделе «Рабочие пространства Cargo» главы 14.
Ещё мы обсудим инкапсуляцию деталей реализации, которая позволяет повторно использовать код на более высоком уровне: реализовав какую-то операцию, вы даёте другому коду вызывать её через публичный интерфейс, и этому коду не нужно знать, как она устроена внутри. То, как вы пишете код, определяет, какие его части публичны и доступны другому коду, а какие — приватные детали реализации, которые вы оставляете за собой право менять. Это ещё один способ уменьшить количество деталей, которые приходится держать в голове.
С этим связано понятие области видимости: у каждого вложенного контекста, в котором написан код, есть набор имён, которые в нём «видны». И программисту, и компилятору нужно понимать, на что указывает конкретное имя в конкретном месте кода — на переменную, функцию, структуру, перечисление, модуль, константу или что-то ещё — и что этот элемент означает. Области видимости можно создавать и решать, какие имена в них будут видны, а какие нет. Двух элементов с одинаковым именем в одной области видимости быть не может, но для разрешения конфликтов имён есть свои инструменты.
В Rust есть ряд возможностей для организации кода: что открыто наружу, что скрыто и какие имена видны в каждой области видимости программы. Вместе их иногда называют системой модулей (module system). В неё входят:
- Пакеты (packages) — возможность Cargo, которая позволяет собирать, тестировать и распространять крейты;
- Крейты (crates) — дерево модулей, из которого получается библиотека или исполняемый файл;
- Модули (modules) и
use— позволяют управлять организацией, областью видимости и приватностью путей; - Пути (paths) — способ назвать элемент, например структуру, функцию или модуль.
В этой главе мы разберём все эти возможности, обсудим, как они взаимодействуют, и объясним, как с их помощью управлять областью видимости. К концу главы у вас сложится твёрдое понимание системы модулей, и вы будете обращаться с областями видимости как профессионал!
Пакеты и крейты
Пакеты и крейты
Первыми из частей системы модулей мы разберём пакеты и крейты.
Крейт (crate) — это минимальный объём кода, который компилятор Rust
рассматривает за один раз. Даже если запустить не cargo, а rustc и передать
ему один файл с исходным кодом (как мы делали ещё в разделе «Основы программы
на Rust» главы 1), компилятор посчитает этот файл
крейтом. Крейт может содержать модули, а модули могут быть определены в
других файлах, которые компилируются вместе с крейтом, — это мы увидим в
следующих разделах.
Крейты бывают двух видов: бинарные и библиотечные. Бинарные крейты — это
программы, которые компилируются в исполняемый файл и запускаются: например,
утилита командной строки или сервер. В каждом из них должна быть функция
main, определяющая, что происходит при запуске. Все крейты, которые мы
создавали до сих пор, были бинарными.
У библиотечных крейтов нет функции main, и они не компилируются в
исполняемый файл. Вместо этого они содержат функциональность, которой можно
пользоваться из разных проектов. Например, крейт rand, который мы
использовали в главе 2, умеет генерировать случайные
числа. Говоря «крейт», растацеаны чаще всего имеют в виду именно
библиотечный крейт и используют слово «крейт» как синоним общепрограммистского
понятия «библиотека».
Корень крейта (crate root) — это исходный файл, с которого компилятор Rust начинает работу и который образует корневой модуль крейта (подробно модули разберём в разделе «Модули: область видимости и приватность»).
Пакет (package) — это набор из одного или нескольких крейтов, реализующий некоторую функциональность. В пакете есть файл Cargo.toml, который описывает, как собирать эти крейты. Сам Cargo — тоже пакет: в нём есть бинарный крейт, то есть та утилита командной строки, которой вы собираете свой код. А ещё в пакете Cargo есть библиотечный крейт, от которого зависит бинарный. Другие проекты могут подключить библиотечный крейт Cargo и пользоваться той же логикой, что и утилита командной строки Cargo.
Бинарных крейтов в пакете может быть сколько угодно, а библиотечный — не больше одного. И хотя бы один крейт — библиотечный или бинарный — в пакете быть должен.
Посмотрим, что происходит при создании пакета. Введём команду
cargo new my-project:
$ cargo new my-project
Created binary (application) `my-project` package
$ ls my-project
Cargo.toml
src
$ ls my-project/src
main.rs
После cargo new my-project мы смотрим через ls, что создал Cargo. В папке
my-project есть файл Cargo.toml — значит, у нас есть пакет. Есть и папка
src с файлом main.rs. Откройте Cargo.toml в редакторе: про
src/main.rs там ничего не сказано. Дело в том, что Cargo следует
соглашению: src/main.rs — корень бинарного крейта с тем же именем, что и у
пакета. Точно так же Cargo знает: если в папке пакета есть src/lib.rs, то в
пакете есть библиотечный крейт с тем же именем, что и у пакета, а
src/lib.rs — его корень. Файлы корней крейтов Cargo передаёт rustc, чтобы
собрать библиотеку или бинарник.
У нас пакет, в котором есть только src/main.rs, — значит, в нём только один
бинарный крейт с именем my-project. Если в пакете есть и src/main.rs, и
src/lib.rs, то в нём два крейта — бинарный и библиотечный, оба с именем
пакета. Чтобы в пакете было несколько бинарных крейтов, положите файлы в папку
src/bin: каждый файл станет отдельным бинарным крейтом.
Модули: область видимости и приватность
Модули: область видимости и приватность
В этом разделе мы поговорим о модулях и других частях системы модулей: о
путях, которые позволяют называть элементы; о ключевом слове use, которое
подключает путь в область видимости; и о ключевом слове pub, которое делает
элементы публичными. Ещё мы обсудим ключевое слово as, внешние пакеты и
оператор * (glob).
Шпаргалка по модулям
Прежде чем углубляться в модули и пути, приведём краткую справку: как
компилятор обрабатывает модули, пути и ключевые слова use и pub и как
большинство разработчиков организуют код. На протяжении главы мы разберём
каждое из этих правил на примерах, а сюда удобно возвращаться, чтобы
освежить в памяти, как работают модули.
- Начало — корень крейта. Компилируя крейт, компилятор сначала ищет код в файле корня крейта (обычно это src/lib.rs для библиотечного крейта и src/main.rs для бинарного).
- Объявление модулей. В файле корня крейта можно объявлять новые модули.
Допустим, вы объявили модуль «garden» (сад) строкой
mod garden;. Компилятор будет искать код модуля в следующих местах:- прямо в этом файле, в фигурных скобках, которые стоят вместо точки с
запятой после
mod garden; - в файле src/garden.rs;
- в файле src/garden/mod.rs.
- прямо в этом файле, в фигурных скобках, которые стоят вместо точки с
запятой после
- Объявление подмодулей. В любом файле, кроме корня крейта, можно
объявлять подмодули. Например, в src/garden.rs можно объявить
mod vegetables;(овощи). Компилятор будет искать код подмодуля в папке с именем родительского модуля, в следующих местах:- прямо в этом файле, сразу после
mod vegetables, в фигурных скобках вместо точки с запятой; - в файле src/garden/vegetables.rs;
- в файле src/garden/vegetables/mod.rs.
- прямо в этом файле, сразу после
- Пути к коду в модулях. Когда модуль стал частью крейта, на его код
можно ссылаться из любого места этого крейта (если позволяют правила
приватности) — по пути к этому коду. Например, тип
Asparagus(спаржа) из модуля овощей в саду будет доступен по путиcrate::garden::vegetables::Asparagus. - Приватное и публичное. По умолчанию код модуля скрыт от родительских
модулей. Чтобы сделать модуль публичным, объявите его через
pub modвместоmod. Чтобы сделать публичными и элементы внутри публичного модуля, поставьтеpubперед их объявлениями. - Ключевое слово
use. Внутри области видимостиuseсоздаёт ярлыки для элементов, чтобы не повторять длинные пути. В любой области видимости, где можно сослаться наcrate::garden::vegetables::Asparagus, можно создать ярлыкuse crate::garden::vegetables::Asparagus;— и дальше в этой области видимости достаточно писать простоAsparagus.
Создадим бинарный крейт backyard (задний двор) и посмотрим на эти правила в
деле. В папке крейта, которая тоже называется backyard, такие файлы и
папки:
backyard
├── Cargo.lock
├── Cargo.toml
└── src
├── garden
│ └── vegetables.rs
├── garden.rs
└── main.rs
Корень крейта здесь — src/main.rs, и в нём вот что:
use crate::garden::vegetables::Asparagus;
pub mod garden;
fn main() {
let plant = Asparagus {};
println!("I'm growing {plant:?}!");
}Строка pub mod garden; говорит компилятору подключить код из src/garden.rs,
а там вот что:
pub mod vegetables;А pub mod vegetables; здесь означает, что подключается ещё и код из
src/garden/vegetables.rs:
#[derive(Debug)]
pub struct Asparagus {}А теперь разберём эти правила подробно и посмотрим на них в действии!
Группировка связанного кода в модули
Модули позволяют организовать код внутри крейта так, чтобы его было удобно читать и повторно использовать. Кроме того, модули управляют приватностью элементов: по умолчанию код внутри модуля приватный. Приватные элементы — это внутренние детали реализации, недоступные снаружи. Модули и элементы в них можно сделать публичными — тогда внешний код сможет ими пользоваться и зависеть от них.
Для примера напишем библиотечный крейт, моделирующий работу ресторана. Мы определим сигнатуры функций, но оставим их тела пустыми, чтобы сосредоточиться на организации кода, а не на реализации ресторана.
В ресторанном деле заведение делят на зал (front of house) и служебную часть (back of house). Зал — это место, где находятся посетители: администратор рассаживает гостей, официанты принимают заказы и оплату, бармены готовят напитки. Служебная часть — это кухня, где работают шеф-повар и повара, мойщики посуды наводят чистоту, а менеджеры занимаются административной работой.
Чтобы устроить крейт так же, разложим его функции по вложенным модулям.
Создайте новую библиотеку restaurant командой
cargo new restaurant --lib. Затем введите в src/lib.rs код из
листинга 7-1 — он определяет несколько модулей и сигнатур функций. Это
«зал».
mod front_of_house {
mod hosting {
fn add_to_waitlist() {}
fn seat_at_table() {}
}
mod serving {
fn take_order() {}
fn serve_order() {}
fn take_payment() {}
}
}front_of_house, содержащий другие модули, в которых находятся функцииМодуль определяется ключевым словом mod, за которым идёт имя модуля (здесь
— front_of_house). Тело модуля пишется в фигурных скобках. Внутри модуля
можно размещать другие модули — как здесь модули hosting (встреча гостей) и
serving (обслуживание). Ещё в модулях могут быть определения других
элементов: структур, перечислений, констант, трейтов и, как в листинге 7-1,
функций.
Модули позволяют собрать связанные определения вместе и назвать то, что их объединяет. Программистам, которые пользуются этим кодом, проще ориентироваться по группам, чем читать все определения подряд, — так легче найти то, что им нужно. А программисты, которые добавляют в код новую функциональность, будут знать, куда её поместить, чтобы программа оставалась упорядоченной.
Выше мы говорили, что src/main.rs и src/lib.rs называются корнями
крейта. Название объясняется так: содержимое любого из этих двух файлов
образует модуль с именем crate, который находится в корне структуры модулей
крейта — так называемого дерева модулей (module tree).
В листинге 7-2 показано дерево модулей для структуры из листинга 7-1.
crate
└── front_of_house
├── hosting
│ ├── add_to_waitlist
│ └── seat_at_table
└── serving
├── take_order
├── serve_order
└── take_payment
Дерево показывает, какие модули вложены в другие: например, hosting вложен в
front_of_house. Видно и то, что некоторые модули — соседи (siblings), то
есть определены в одном и том же модуле: hosting и serving — соседи внутри
front_of_house. Если модуль A находится внутри модуля B, говорят, что модуль
A — потомок (child) модуля B, а B — родитель (parent) модуля A.
Обратите внимание: корнем всего дерева модулей служит неявный модуль с именем
crate.
Дерево модулей может напомнить вам дерево папок в файловой системе — и это очень удачное сравнение! Как папки в файловой системе, модули служат для организации кода. И точно так же, как файлы в папках, модули нужно уметь находить.
Пути к элементам в дереве модулей
Пути к элементам в дереве модулей
Чтобы показать Rust, где в дереве модулей искать элемент, мы указываем путь — так же, как путь в файловой системе. Чтобы вызвать функцию, нужно знать путь к ней.
Путь бывает двух видов:
- Абсолютный путь — полный путь от корня крейта. Для кода из внешнего крейта
абсолютный путь начинается с имени этого крейта, а для кода из текущего
крейта — со слова
crate. - Относительный путь начинается от текущего модуля и использует
self,superили имя элемента из текущего модуля.
И в абсолютном, и в относительном пути за началом следуют один или несколько
идентификаторов, разделённых двойным двоеточием (::).
Вернёмся к листингу 7-1. Допустим, мы хотим вызвать функцию add_to_waitlist
(добавить в список ожидания). Это то же самое, что спросить: какой путь у
функции add_to_waitlist? В листинге 7-3 — листинг 7-1, из которого убраны
некоторые модули и функции.
Мы покажем два способа вызвать add_to_waitlist из новой функции
eat_at_restaurant («поесть в ресторане»), определённой в корне крейта. Оба
пути правильные, но остаётся ещё одна проблема, из-за которой этот пример в
таком виде не скомпилируется. Почему — объясним чуть позже.
Функция eat_at_restaurant — часть публичного API нашего библиотечного
крейта, поэтому мы помечаем её ключевым словом pub. Подробнее о pub — в
разделе «Открываем пути ключевым словом pub».
mod front_of_house {
mod hosting {
fn add_to_waitlist() {}
}
}
pub fn eat_at_restaurant() {
// Абсолютный путь
crate::front_of_house::hosting::add_to_waitlist();
// Относительный путь
front_of_house::hosting::add_to_waitlist();
}add_to_waitlist по абсолютному и относительному путиВ первый раз add_to_waitlist вызывается из eat_at_restaurant по
абсолютному пути. Функция add_to_waitlist определена в том же крейте, что и
eat_at_restaurant, поэтому абсолютный путь можно начать с ключевого слова
crate. Дальше по очереди перечисляем все модули, пока не дойдём до
add_to_waitlist. Представьте файловую систему с такой же структурой: чтобы
запустить программу add_to_waitlist, мы бы указали путь
/front_of_house/hosting/add_to_waitlist. Начать путь с crate, то есть от
корня крейта, — всё равно что начать путь в терминале с /, то есть от корня
файловой системы.
Во второй раз add_to_waitlist вызывается по относительному пути. Он
начинается с front_of_house — имени модуля, определённого на том же уровне
дерева модулей, что и eat_at_restaurant. В файловой системе это был бы путь
front_of_house/hosting/add_to_waitlist. Если путь начинается с имени модуля,
он относительный.
Какой путь выбрать — относительный или абсолютный, — зависит от проекта, а
точнее от того, как вы скорее будете переносить код: определение элемента
отдельно от кода, который этот элемент использует, или вместе с ним. Например, если
перенести модуль front_of_house и функцию eat_at_restaurant в модуль
customer_experience, придётся обновить абсолютный путь к add_to_waitlist,
а относительный останется верным. А если перенести в модуль dining одну
лишь функцию eat_at_restaurant, то абсолютный путь в вызове
add_to_waitlist не изменится, а относительный придётся поправить. Мы обычно
предпочитаем абсолютные пути: чаще всего определения и вызовы элементов
переносят независимо друг от друга.
Попробуем скомпилировать листинг 7-3 и выясним, почему он пока не компилируется! Ошибки — в листинге 7-4.
$ cargo build
Compiling restaurant v0.1.0 (file:///projects/restaurant)
error[E0603]: module `hosting` is private
--> src/lib.rs:9:28
|
9 | crate::front_of_house::hosting::add_to_waitlist();
| ^^^^^^^ --------------- function `add_to_waitlist` is not publicly re-exported
| |
| private module
|
note: the module `hosting` is defined here
--> src/lib.rs:2:5
|
2 | mod hosting {
| ^^^^^^^^^^^
error[E0603]: module `hosting` is private
--> src/lib.rs:12:21
|
12 | front_of_house::hosting::add_to_waitlist();
| ^^^^^^^ --------------- function `add_to_waitlist` is not publicly re-exported
| |
| private module
|
note: the module `hosting` is defined here
--> src/lib.rs:2:5
|
2 | mod hosting {
| ^^^^^^^^^^^
For more information about this error, try `rustc --explain E0603`.
error: could not compile `restaurant` (lib) due to 2 previous errors
Сообщения говорят, что модуль hosting приватный. Иными словами, пути к
модулю hosting и к функции add_to_waitlist у нас правильные, но Rust не
даёт ими воспользоваться: у нас нет доступа к приватным частям. В Rust все
элементы (функции, методы, структуры, перечисления, модули и константы) по
умолчанию скрыты от родительских модулей. Чтобы сделать элемент вроде функции
или структуры приватным, достаточно поместить его в модуль.
Элементы родительского модуля не могут пользоваться приватными элементами дочерних модулей, а вот элементы дочерних модулей могут пользоваться элементами модулей-предков. Дело в том, что дочерние модули скрывают детали своей реализации, но сами видят контекст, в котором определены. Продолжим нашу метафору: правила приватности похожи на служебные помещения ресторана. Что там происходит, посетителям не видно, но управляющие видят всё в ресторане, которым руководят, и могут делать там что угодно.
Rust сделал систему модулей такой, чтобы детали внутренней реализации по
умолчанию были скрыты. Так вы знаете, какие части внутреннего кода можно
менять, не ломая внешний код. Но Rust позволяет и открыть внутренние части
дочерних модулей внешним модулям-предкам — для этого элемент делают публичным
ключевым словом pub.
Открываем пути ключевым словом pub
Вернёмся к ошибке из листинга 7-4, которая сообщала, что модуль hosting
приватный. Мы хотим, чтобы функция eat_at_restaurant в родительском модуле
имела доступ к функции add_to_waitlist в дочернем, поэтому помечаем модуль
hosting ключевым словом pub, как в листинге 7-5.
mod front_of_house {
pub mod hosting {
fn add_to_waitlist() {}
}
}
// -- пропуск --
pub fn eat_at_restaurant() {
// Абсолютный путь
crate::front_of_house::hosting::add_to_waitlist();
// Относительный путь
front_of_house::hosting::add_to_waitlist();
}hosting как pub, чтобы использовать его из eat_at_restaurantК сожалению, код из листинга 7-5 всё равно не компилируется — ошибки в листинге 7-6.
$ cargo build
Compiling restaurant v0.1.0 (file:///projects/restaurant)
error[E0603]: function `add_to_waitlist` is private
--> src/lib.rs:10:37
|
10 | crate::front_of_house::hosting::add_to_waitlist();
| ^^^^^^^^^^^^^^^ private function
|
note: the function `add_to_waitlist` is defined here
--> src/lib.rs:3:9
|
3 | fn add_to_waitlist() {}
| ^^^^^^^^^^^^^^^^^^^^
error[E0603]: function `add_to_waitlist` is private
--> src/lib.rs:13:30
|
13 | front_of_house::hosting::add_to_waitlist();
| ^^^^^^^^^^^^^^^ private function
|
note: the function `add_to_waitlist` is defined here
--> src/lib.rs:3:9
|
3 | fn add_to_waitlist() {}
| ^^^^^^^^^^^^^^^^^^^^
For more information about this error, try `rustc --explain E0603`.
error: could not compile `restaurant` (lib) due to 2 previous errors
Что произошло? pub перед mod hosting делает публичным сам модуль. Теперь,
если у нас есть доступ к front_of_house, есть доступ и к hosting. Но
содержимое hosting по-прежнему приватно: публичный модуль не делает
публичным своё содержимое. pub у модуля лишь позволяет коду в
модулях-предках ссылаться на сам модуль, но не обращаться к его внутреннему
коду. Модули — это контейнеры, и от одного лишь публичного модуля толку мало:
нужно пойти дальше и сделать публичными и какие-то элементы внутри него.
Ошибки в листинге 7-6 говорят, что приватна функция add_to_waitlist. Правила
приватности распространяются не только на модули, но и на структуры,
перечисления, функции и методы.
Сделаем публичной и функцию add_to_waitlist, добавив pub перед её
определением, как в листинге 7-7.
mod front_of_house {
pub mod hosting {
pub fn add_to_waitlist() {}
}
}
// -- пропуск --
pub fn eat_at_restaurant() {
// Абсолютный путь
crate::front_of_house::hosting::add_to_waitlist();
// Относительный путь
front_of_house::hosting::add_to_waitlist();
}pub у mod hosting и у fn add_to_waitlist позволяет вызвать функцию из eat_at_restaurantТеперь код компилируется! Чтобы понять, почему после добавления pub правила
приватности позволяют использовать эти пути в eat_at_restaurant, разберём
абсолютный и относительный пути.
Абсолютный путь начинается с crate — корня дерева модулей нашего крейта.
Модуль front_of_house определён в корне крейта. Он не публичный, но функция
eat_at_restaurant определена в том же модуле, что и front_of_house (то
есть они соседи), поэтому из eat_at_restaurant на front_of_house ссылаться
можно. Дальше идёт модуль hosting, помеченный pub. К родителю hosting
доступ у нас есть, значит, есть доступ и к hosting. Наконец, функция
add_to_waitlist помечена pub, а к её родительскому модулю доступ есть —
значит, вызов работает!
С относительным путём логика та же, кроме первого шага: путь начинается не от
корня крейта, а от front_of_house. Модуль front_of_house определён в том
же модуле, что и eat_at_restaurant, поэтому относительный путь от модуля, в
котором определена eat_at_restaurant, работает. А раз hosting и
add_to_waitlist помечены pub, остальная часть пути тоже работает — и вызов
корректен!
Если вы собираетесь поделиться своим библиотечным крейтом, чтобы другие проекты могли пользоваться вашим кодом, то публичный API — это ваш договор с пользователями крейта: он определяет, как они могут работать с вашим кодом. Вопросов о том, как менять публичный API так, чтобы людям было проще зависеть от вашего крейта, очень много, и они выходят за рамки этой книги. Если тема вам интересна, загляните в Rust API Guidelines (рекомендации по проектированию API на Rust).
Хорошие практики для пакетов с бинарником и библиотекой
Мы упоминали, что в пакете могут быть одновременно корень бинарного крейта src/main.rs и корень библиотечного src/lib.rs, и по умолчанию оба крейта называются так же, как пакет. Обычно в таких пакетах бинарный крейт совсем маленький: в нём ровно столько кода, сколько нужно, чтобы запустить программу, а вся основная работа сделана в библиотечном крейте. Так другие проекты получают от пакета максимум пользы: библиотечным крейтом можно пользоваться и в них.
Дерево модулей стоит определять в src/lib.rs. Тогда в бинарном крейте любыми публичными элементами можно пользоваться, начиная путь с имени пакета. Бинарный крейт становится пользователем библиотечного — точно так же, как совершенно посторонний крейт: ему доступен только публичный API. Это помогает спроектировать хороший API: вы не только его автор, но и клиент!
В главе 12 мы покажем такую организацию на примере программы командной строки, в которой будут и бинарный, и библиотечный крейт.
Относительные пути, начинающиеся с super
Относительный путь можно начать не от текущего модуля и не от корня крейта, а
от родительского модуля — для этого в начале пути пишут super. Это как
начать путь в файловой системе с .., что означает «перейти в родительскую
папку». super позволяет сослаться на элемент, который точно находится в
родительском модуле. Это упрощает перестройку дерева модулей, если модуль
тесно связан с родителем, но родителя когда-нибудь могут перенести в другое
место дерева.
Посмотрите на код в листинге 7-8. Он моделирует ситуацию, когда шеф-повар
исправляет ошибочный заказ и сам выносит его посетителю. Функция
fix_incorrect_order (исправить ошибочный заказ), определённая в модуле
back_of_house, вызывает функцию deliver_order (подать заказ) из
родительского модуля, указывая путь к deliver_order, который начинается с
super.
fn deliver_order() {}
mod back_of_house {
fn fix_incorrect_order() {
cook_order();
super::deliver_order();
}
fn cook_order() {}
}superФункция fix_incorrect_order находится в модуле back_of_house, поэтому с
помощью super можно перейти в родительский модуль back_of_house — в данном
случае это корень, crate. Там мы ищем deliver_order — и находим. Успех! Мы
считаем, что модуль back_of_house и функция deliver_order, скорее всего,
так и останутся в тех же отношениях друг с другом и при перестройке дерева
модулей крейта будут переноситься вместе. Поэтому мы и использовали super:
если этот код когда-нибудь переедет в другой модуль, править придётся меньше
мест.
Публичные структуры и перечисления
С помощью pub можно сделать публичными и структуры с перечислениями, но тут
есть несколько тонкостей. Если поставить pub перед определением структуры,
публичной станет сама структура, но её поля останутся приватными. Каждое поле
можно сделать публичным или нет по отдельности. В листинге 7-9 определена
публичная структура back_of_house::Breakfast (завтрак) с публичным полем
toast (тост) и приватным полем seasonal_fruit (сезонные фрукты). Это
моделирует ситуацию в ресторане, когда посетитель может выбрать хлеб к блюду,
а вот какие фрукты к нему подать, решает шеф-повар — в зависимости от сезона и
того, что есть на складе. Набор фруктов быстро меняется, поэтому посетители не
могут ни выбрать фрукты, ни даже увидеть, какие им достанутся.
mod back_of_house {
pub struct Breakfast {
pub toast: String,
seasonal_fruit: String,
}
impl Breakfast {
pub fn summer(toast: &str) -> Breakfast {
Breakfast {
toast: String::from(toast),
seasonal_fruit: String::from("peaches"),
}
}
}
}
pub fn eat_at_restaurant() {
// Заказываем летний завтрак с ржаным тостом.
let mut meal = back_of_house::Breakfast::summer("Rye");
// Передумали насчёт хлеба.
meal.toast = String::from("Wheat");
println!("I'd like {} toast please", meal.toast);
// Если раскомментировать следующую строку, код не скомпилируется: нам нельзя
// ни узнать, ни поменять сезонный фрукт, который подают к завтраку.
// meal.seasonal_fruit = String::from("blueberries");
}Поле toast в структуре back_of_house::Breakfast публичное, поэтому в
eat_at_restaurant его можно читать и записывать через точку. А вот поле
seasonal_fruit в eat_at_restaurant использовать нельзя — оно приватное.
Попробуйте раскомментировать строку, которая меняет значение
seasonal_fruit, и посмотрите, какая будет ошибка!
Заметьте также: раз у back_of_house::Breakfast есть приватное поле,
структуре нужна публичная ассоциированная функция, которая создаёт экземпляр
Breakfast (здесь она называется summer — «летний»). Без такой функции
создать экземпляр Breakfast в eat_at_restaurant было бы невозможно: мы не
смогли бы задать значение приватного поля seasonal_fruit.
С перечислениями всё наоборот: если сделать перечисление публичным, публичными
становятся все его варианты. Достаточно поставить pub перед ключевым словом
enum, как в листинге 7-10.
mod back_of_house {
pub enum Appetizer {
Soup,
Salad,
}
}
pub fn eat_at_restaurant() {
let order1 = back_of_house::Appetizer::Soup;
let order2 = back_of_house::Appetizer::Salad;
}Перечисление Appetizer (закуска) публичное, поэтому в eat_at_restaurant
можно использовать варианты Soup (суп) и Salad (салат).
От перечисления мало толку, если его варианты не публичны, и было бы
утомительно каждый раз помечать pub все варианты. Поэтому варианты
перечислений по умолчанию публичны. А вот структуры часто полезны и без
публичных полей, поэтому для полей структур действует общее правило: всё
приватно, если не помечено pub.
Остался ещё один случай с pub, который мы не разобрали, — он связан с
последней частью системы модулей, ключевым словом use. Сначала разберём
use само по себе, а потом покажем, как сочетать pub и use.
Подключение путей ключевым словом use
Подключение путей ключевым словом use
Выписывать полные пути при каждом вызове функции неудобно и однообразно. В
листинге 7-7, какой бы путь к add_to_waitlist мы ни выбрали — абсолютный
или относительный, — при каждом вызове приходилось указывать ещё и
front_of_house с hosting. К счастью, это можно упростить: один раз создать
ярлык для пути с помощью ключевого слова use, а дальше во всей области
видимости пользоваться коротким именем.
В листинге 7-11 мы подключаем модуль crate::front_of_house::hosting в
область видимости функции eat_at_restaurant, и теперь, чтобы вызвать
add_to_waitlist в eat_at_restaurant, достаточно написать
hosting::add_to_waitlist.
mod front_of_house {
pub mod hosting {
pub fn add_to_waitlist() {}
}
}
use crate::front_of_house::hosting;
pub fn eat_at_restaurant() {
hosting::add_to_waitlist();
}useДобавить в область видимости use с путём — примерно то же, что создать
символическую ссылку в файловой системе. После строки
use crate::front_of_house::hosting в корне крейта имя hosting становится в
этой области видимости допустимым — как будто модуль hosting определён прямо
в корне крейта. Пути, подключённые через use, проходят проверку
приватности, как и любые другие.
Учтите, что use создаёт ярлык только в той области видимости, где он
написан. В листинге 7-12 функция eat_at_restaurant перенесена в новый
дочерний модуль customer. Это уже другая область видимости, не та, где
стоит use, поэтому тело функции не скомпилируется.
mod front_of_house {
pub mod hosting {
pub fn add_to_waitlist() {}
}
}
use crate::front_of_house::hosting;
mod customer {
pub fn eat_at_restaurant() {
hosting::add_to_waitlist();
}
}use действует только в той области видимости, где она находитсяОшибка компиляции показывает, что внутри модуля customer ярлык уже не
действует:
$ cargo build
Compiling restaurant v0.1.0 (file:///projects/restaurant)
error[E0433]: cannot find module or crate `hosting` in this scope
--> src/lib.rs:11:9
|
11 | hosting::add_to_waitlist();
| ^^^^^^^ use of unresolved module or unlinked crate `hosting`
|
= help: if you wanted to use a crate named `hosting`, use `cargo add hosting` to add it to your `Cargo.toml`
help: consider importing this module through its public re-export
|
10 + use crate::hosting;
|
warning: unused import: `crate::front_of_house::hosting`
--> src/lib.rs:7:5
|
7 | use crate::front_of_house::hosting;
| ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
|
= note: `#[warn(unused_imports)]` (part of `#[warn(unused)]`) on by default
For more information about this error, try `rustc --explain E0433`.
warning: `restaurant` (lib) generated 1 warning
error: could not compile `restaurant` (lib) due to 1 previous error; 1 warning emitted
Заметьте, что есть ещё и предупреждение: use в своей области видимости
больше не используется! Чтобы исправить проблему, перенесите use тоже в
модуль customer или обращайтесь к ярлыку родительского модуля через
super::hosting внутри дочернего модуля customer.
Идиоматичные пути в use
Глядя на листинг 7-11, вы, возможно, задались вопросом: зачем мы написали
use crate::front_of_house::hosting и вызываем hosting::add_to_waitlist в
eat_at_restaurant, а не довели путь в use до самой функции
add_to_waitlist, как в листинге 7-13? Результат был бы тот же.
mod front_of_house {
pub mod hosting {
pub fn add_to_waitlist() {}
}
}
use crate::front_of_house::hosting::add_to_waitlist;
pub fn eat_at_restaurant() {
add_to_waitlist();
}add_to_waitlist через use — так делать неидиоматичноЛистинги 7-11 и 7-13 делают одно и то же, но идиоматичный способ подключить
функцию через use — как в листинге 7-11. Если подключить родительский модуль
функции, то при вызове придётся указывать этот модуль. А это сразу показывает,
что функция определена не здесь, и при этом полный путь повторять не нужно.
По коду из листинга 7-13 непонятно, где определена add_to_waitlist.
А вот структуры, перечисления и прочие элементы через use идиоматично
подключать по полному пути. В листинге 7-14 показан идиоматичный способ
подключить структуру HashMap из стандартной библиотеки в область видимости
бинарного крейта.
use std::collections::HashMap;
fn main() {
let mut map = HashMap::new();
map.insert(1, 2);
}HashMap в область видимости идиоматичным способомСерьёзной причины у этой идиомы нет: просто так сложилось, и люди привыкли читать и писать код на Rust именно так.
Исключение — когда нужно подключить через use два элемента с одинаковым
именем: Rust такого не допускает. В листинге 7-15 показано, как подключить в
область видимости два типа Result с одинаковым именем, но из разных
родительских модулей, и как к ним обращаться.
use std::fmt;
use std::io;
fn function1() -> fmt::Result {
// --пропуск--
Ok(())
}
fn function2() -> io::Result<()> {
// --пропуск--
Ok(())
}Как видите, родительские модули позволяют различить два типа Result. Если
бы мы написали use std::fmt::Result и use std::io::Result, в одной области
видимости оказались бы два типа Result, и Rust не понял бы, какой из них мы
имеем в виду, когда пишем Result.
Новые имена с помощью as
Есть и другое решение проблемы двух одноимённых типов в одной области
видимости: после пути можно написать as и новое локальное имя — псевдоним
(alias) — для типа. В листинге 7-16 показан другой вариант кода из листинга
7-15: один из двух типов Result переименован с помощью as.
use std::fmt::Result;
use std::io::Result as IoResult;
fn function1() -> Result {
// --пропуск--
Ok(())
}
fn function2() -> IoResult<()> {
// --пропуск--
Ok(())
}asВо второй инструкции use мы дали типу std::io::Result новое имя —
IoResult. Оно не конфликтует с Result из std::fmt, который мы тоже
подключили. И листинг 7-15, и листинг 7-16 считаются идиоматичными, так что
выбирайте сами!
Реэкспорт имён с помощью pub use
Когда мы подключаем имя через use, оно приватно для той области видимости,
куда мы его импортировали. Чтобы код за пределами этой области мог
обращаться к имени так, будто оно определено в ней, можно объединить pub и
use. Такой приём называется реэкспортом (re-exporting): мы подключаем
элемент в свою область видимости и одновременно делаем его доступным другим,
чтобы они могли подключить его в свою.
В листинге 7-17 — код из листинга 7-11, где use в корневом модуле заменено
на pub use.
mod front_of_house {
pub mod hosting {
pub fn add_to_waitlist() {}
}
}
pub use crate::front_of_house::hosting;
pub fn eat_at_restaurant() {
hosting::add_to_waitlist();
}pub use делаем имя доступным любому коду из новой области видимостиДо этого изменения внешнему коду пришлось бы вызывать функцию
add_to_waitlist по пути
restaurant::front_of_house::hosting::add_to_waitlist(), да ещё и модуль
front_of_house пришлось бы пометить pub. Теперь, когда pub use
реэкспортировал модуль hosting из корневого модуля, внешний код может
пользоваться путём restaurant::hosting::add_to_waitlist().
Реэкспорт полезен, когда внутренняя структура кода отличается от того, как
видят предметную область программисты, вызывающие ваш код. Например, в нашей
ресторанной метафоре те, кто управляет рестораном, думают категориями «зал» и
«служебная часть». А посетители, скорее всего, о ресторане так не думают. С
помощью pub use можно написать код с одной структурой, а наружу открыть
другую. Так библиотека получается хорошо организованной и для тех, кто над ней
работает, и для тех, кто её вызывает. Ещё один пример pub use и того, как он
влияет на документацию крейта, мы рассмотрим в разделе «Экспорт удобного
публичного API» главы 14.
Внешние пакеты
В главе 2 мы написали игру «Угадай число», в которой использовали внешний
пакет rand для получения случайных чисел. Чтобы подключить rand к проекту,
мы добавили в Cargo.toml строку:
rand = "0.10.1"
Добавив rand в зависимости в Cargo.toml, мы говорим Cargo скачать пакет
rand и все его зависимости с crates.io и сделать
rand доступным в нашем проекте.
Затем, чтобы подключить определения из rand в область видимости нашего
пакета, мы добавили строку use, которая начинается с имени крейта, rand,
и перечислили элементы, которые хотим подключить. Вспомните: в разделе
«Генерируем случайное число» главы 2 мы подключили
элементы из модуля rand::prelude и вызвали функцию rand::rng:
use std::io;
use rand::prelude::*;
fn main() {
println!("Guess the number!");
let secret_number = rand::rng().random_range(1..=100);
println!("The secret number is: {secret_number}");
println!("Please input your guess.");
let mut guess = String::new();
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
println!("You guessed: {guess}");
}Участники сообщества Rust опубликовали на crates.io
огромное количество пакетов, и подключить любой из них к своему пакету можно
теми же шагами: указать его в Cargo.toml своего пакета и подключить нужные
элементы из его крейтов через use.
Учтите, что стандартная библиотека std — тоже крейт, внешний по отношению к
нашему пакету. Стандартная библиотека поставляется вместе с Rust, поэтому
добавлять std в Cargo.toml не нужно. Но чтобы подключить из неё элементы
в область видимости нашего пакета, нужно сослаться на неё через use.
Например, для HashMap строка будет такой:
#![allow(unused)]
fn main() {
use std::collections::HashMap;
}Это абсолютный путь, который начинается с std — имени крейта стандартной
библиотеки.
Вложенные пути для аккуратных списков use
Если мы используем несколько элементов из одного крейта или модуля и пишем
каждый на отдельной строке, это занимает много места по вертикали. Например,
эти две инструкции use из игры в листинге 2-4 подключают элементы из std:
// --пропуск--
use std::cmp::Ordering;
use std::io;
// --пропуск--
use rand::prelude::*;
fn main() {
println!("Guess the number!");
let secret_number = rand::rng().random_range(1..=100);
println!("The secret number is: {secret_number}");
println!("Please input your guess.");
let mut guess = String::new();
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
println!("You guessed: {guess}");
match guess.cmp(&secret_number) {
Ordering::Less => println!("Too small!"),
Ordering::Greater => println!("Too big!"),
Ordering::Equal => println!("You win!"),
}
}Вместо этого можно подключить те же элементы одной строкой с помощью вложенных путей: пишем общую часть пути, два двоеточия, а затем в фигурных скобках — список различающихся частей, как в листинге 7-18.
use rand::prelude::*;
// --пропуск--
use std::{cmp::Ordering, io};
// --пропуск--
fn main() {
println!("Guess the number!");
let secret_number = rand::rng().random_range(1..=100);
println!("The secret number is: {secret_number}");
println!("Please input your guess.");
let mut guess = String::new();
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
let guess: u32 = guess.trim().parse().expect("Please type a number!");
println!("You guessed: {guess}");
match guess.cmp(&secret_number) {
Ordering::Less => println!("Too small!"),
Ordering::Greater => println!("Too big!"),
Ordering::Equal => println!("You win!"),
}
}В больших программах, где из одного крейта или модуля подключается много
элементов, вложенные пути могут заметно сократить количество отдельных
инструкций use!
Вложенный путь можно использовать на любом уровне пути. Это пригодится, когда
нужно объединить две инструкции use с общей частью. Например, в листинге
7-19 две инструкции use: одна подключает std::io, другая — std::io::Write.
use std::io;
use std::io::Write;use, где один путь — часть другогоОбщая часть этих двух путей — std::io, и это целиком первый путь. Чтобы
объединить их в одну инструкцию use, во вложенном пути можно использовать
self, как в листинге 7-20.
use std::io::{self, Write};useЭта строка подключает и std::io, и std::io::Write.
Импорт всего подряд оператором *
Если нужно подключить все публичные элементы, определённые по какому-то
пути, после пути ставят оператор * (glob):
#![allow(unused)]
fn main() {
use std::collections::*;
}Эта инструкция use подключает в текущую область видимости все публичные
элементы из std::collections. Будьте осторожны с этим оператором! С ним
труднее понять, какие имена видны в области видимости и где определено имя,
которое используется в программе. Кроме того, если в зависимости изменятся
определения, изменится и то, что вы импортировали. Например, при обновлении
зависимости могут появиться ошибки компиляции, если в ней добавится
определение с тем же именем, что и ваше в той же области видимости.
Оператор * часто используют в тестах, чтобы подключить всё тестируемое в
модуль tests, — об этом мы поговорим в разделе «Как писать
тесты» главы 11. Ещё его иногда используют в
шаблоне «прелюдии» — подробнее см. документацию стандартной
библиотеки.
Разделение модулей на файлы
Разделение модулей на файлы
До сих пор во всех примерах этой главы несколько модулей определялись в одном файле. Когда модули разрастаются, их определения удобно вынести в отдельные файлы, чтобы в коде было проще ориентироваться.
Возьмём для примера код из листинга 7-17 с несколькими модулями ресторана. Вынесем модули в отдельные файлы, чтобы не держать их все в файле корня крейта. Здесь корень крейта — src/lib.rs, но так же можно поступить и с бинарным крейтом, у которого корень — src/main.rs.
Сначала вынесем в отдельный файл модуль front_of_house. Удалите код внутри
фигурных скобок модуля front_of_house, оставив только объявление
mod front_of_house;, чтобы в src/lib.rs остался код из листинга 7-21.
Учтите: он не скомпилируется, пока мы не создадим файл src/front_of_house.rs
из листинга 7-22.
mod front_of_house;
pub use crate::front_of_house::hosting;
pub fn eat_at_restaurant() {
hosting::add_to_waitlist();
}front_of_house, тело которого будет в src/front_of_house.rsЗатем перенесите код, который был в фигурных скобках, в новый файл
src/front_of_house.rs, как в листинге 7-22. Компилятор знает, что искать
нужно в этом файле, потому что в корне крейта он встретил объявление модуля с
именем front_of_house.
pub mod hosting {
pub fn add_to_waitlist() {}
}front_of_house в файле src/front_of_house.rsОбратите внимание: загружать файл объявлением mod нужно лишь один раз во
всём дереве модулей. Как только компилятор знает, что файл — часть проекта (и
знает, где в дереве модулей находится его код, — по тому, где стоит
инструкция mod), остальные файлы проекта должны обращаться к коду
загруженного файла по пути к месту его объявления, как описано в разделе
«Пути к элементам в дереве модулей». Иными словами,
mod — это не операция «include», которая может быть вам знакома по другим
языкам программирования.
Теперь вынесем в отдельный файл модуль hosting. Тут всё немного иначе:
hosting — дочерний модуль front_of_house, а не корневого модуля. Файл для
hosting положим в новую папку, названную по его предкам в дереве модулей, —
в данном случае src/front_of_house.
Чтобы начать перенос hosting, оставим в src/front_of_house.rs только
объявление модуля hosting:
pub mod hosting;Затем создадим папку src/front_of_house и в ней файл hosting.rs с
определениями из модуля hosting:
pub fn add_to_waitlist() {}Если бы мы положили hosting.rs прямо в папку src, компилятор решил бы, что
код из hosting.rs относится к модулю hosting, объявленному в корне крейта,
а не к дочернему модулю front_of_house. Благодаря правилам, по которым
компилятор ищет код модулей в файлах, структура папок и файлов близко
повторяет дерево модулей.
Альтернативные пути к файлам
Мы рассмотрели самые идиоматичные пути к файлам, которые использует
компилятор Rust, но Rust поддерживает и более старый стиль. Для модуля
front_of_house, объявленного в корне крейта, компилятор ищет код в:
- src/front_of_house.rs (тот вариант, что мы разобрали);
- src/front_of_house/mod.rs (старый стиль, по-прежнему поддерживается).
Для модуля hosting, который является подмодулем front_of_house,
компилятор ищет код в:
- src/front_of_house/hosting.rs (тот вариант, что мы разобрали);
- src/front_of_house/hosting/mod.rs (старый стиль, по-прежнему поддерживается).
Если для одного и того же модуля использовать оба стиля сразу, будет ошибка компиляции. Смешивать стили для разных модулей одного проекта можно, но людям, которые будут разбираться в вашем проекте, это может мешать.
Главный недостаток стиля с файлами mod.rs в том, что в проекте накапливается много файлов с одинаковым именем mod.rs, и когда несколько из них одновременно открыты в редакторе, в них легко запутаться.
Мы перенесли код каждого модуля в отдельный файл, а дерево модулей осталось
прежним. Вызовы функций в eat_at_restaurant работают без всяких изменений,
хотя определения теперь лежат в разных файлах. Так модули можно выносить в
новые файлы по мере того, как они растут.
Заметьте, что инструкция pub use crate::front_of_house::hosting в
src/lib.rs тоже не изменилась, и use никак не влияет на то, какие файлы
компилируются в составе крейта. Модули объявляет ключевое слово mod, а код
модуля Rust ищет в файле с тем же именем, что и модуль.
Итоги
Rust позволяет разбить пакет на несколько крейтов, а крейт — на модули. Чтобы
обратиться из одного модуля к элементу, определённому в другом, указывают
абсолютный или относительный путь. Пути можно подключить в
область видимости инструкцией use, чтобы при многократном использовании
элемента в этой области писать путь покороче. Код модуля по умолчанию
приватный, но определения можно сделать публичными, добавив ключевое слово
pub.
В следующей главе мы рассмотрим структуры данных — коллекции из стандартной библиотеки, которыми можно пользоваться в вашем аккуратно организованном коде.
Основные коллекции
В стандартной библиотеке Rust есть несколько очень полезных структур данных, которые называются коллекциями. Большинство типов данных представляют одно конкретное значение, а коллекции могут хранить много значений. В отличие от встроенных массивов и кортежей, данные коллекций хранятся в куче. Это значит, что объём данных не обязательно знать при компиляции: во время работы программы он может расти и уменьшаться. У каждого вида коллекций свои возможности и своя цена, и умение выбрать подходящую под задачу придёт со временем. В этой главе мы рассмотрим три коллекции, которые очень часто встречаются в программах на Rust:
- Вектор (vector) хранит переменное количество значений подряд, одно за другим.
- Строка (string) — это коллекция символов. Тип
Stringмы уже упоминали, а в этой главе разберём его подробно. - Хеш-таблица (hash map) позволяет связать значение с определённым ключом. Это конкретная реализация более общей структуры данных, которая называется отображением (map).
О других коллекциях из стандартной библиотеки читайте в документации.
Мы разберём, как создавать и изменять векторы, строки и хеш-таблицы и чем каждая из этих коллекций особенна.
Векторы: списки значений
Векторы: списки значений
Первая коллекция, которую мы рассмотрим, — Vec<T>, или просто вектор.
Вектор позволяет хранить несколько значений в одной структуре данных, которая
располагает их в памяти подряд, одно за другим. Хранить вектор может только
значения одного типа. Векторы удобны, когда у вас список элементов: например,
строки текстового файла или цены товаров в корзине.
Создание вектора
Чтобы создать новый пустой вектор, вызывается функция Vec::new, как в
листинге 8-1.
fn main() {
let v: Vec<i32> = Vec::new();
}i32Заметьте, что здесь мы указали аннотацию типа. Раз мы ничего не кладём в этот
вектор, Rust не знает, элементы какого типа мы собираемся в нём хранить. Это
важный момент. Векторы реализованы с помощью обобщений; как использовать
обобщения со своими типами, мы разберём в главе 10. Пока достаточно знать, что
тип Vec<T> из стандартной библиотеки может хранить значения любого типа.
Если вектор создаётся для конкретного типа, этот тип указывают в угловых
скобках. В
листинге 8-1 мы сообщили Rust, что Vec<T> в v будет хранить элементы типа
i32.
Чаще вектор Vec<T> создают сразу с начальными значениями, и Rust сам
выводит тип хранимых значений, так что аннотация типа нужна редко. Для этого в
Rust есть удобный макрос vec!: он создаёт новый вектор с переданными
значениями. В листинге 8-2 создаётся новый Vec<i32> со значениями 1, 2 и
3. Целочисленный тип здесь i32, потому что это тип целых чисел по
умолчанию, как мы обсуждали в разделе «Типы данных» главы 3.
fn main() {
let v = vec![1, 2, 3];
}Мы задали начальные значения типа i32, поэтому Rust может вывести, что v
имеет тип Vec<i32>, и аннотация типа не нужна. Теперь посмотрим, как менять
вектор.
Изменение вектора
Чтобы создать вектор, а затем добавить в него элементы, можно воспользоваться
методом push, как в листинге 8-3.
fn main() {
let mut v = Vec::new();
v.push(5);
v.push(6);
v.push(7);
v.push(8);
}pushКак и с любой переменной, чтобы значение можно было менять, вектор нужно
сделать изменяемым с помощью mut, как говорилось в главе 3. Все числа,
которые мы кладём в вектор, имеют тип i32, и Rust выводит это из самих
данных, так что аннотация Vec<i32> не нужна.
Чтение элементов вектора
Сослаться на значение, хранящееся в векторе, можно двумя способами: по
индексу или методом get. В следующих примерах для наглядности указаны типы
значений, которые возвращают эти способы.
В листинге 8-4 показаны оба способа обратиться к значению в векторе — через
индексацию и через метод get.
fn main() {
let v = vec![1, 2, 3, 4, 5];
let third: &i32 = &v[2];
println!("The third element is {third}");
let third: Option<&i32> = v.get(2);
match third {
Some(third) => println!("The third element is {third}"),
None => println!("There is no third element."),
}
}getОбратите внимание на несколько деталей. Чтобы получить третий элемент, мы
используем индекс 2: элементы вектора нумеруются с нуля. & и [] дают
ссылку на элемент с этим индексом. А метод get, которому индекс передаётся
аргументом, возвращает Option<&T>, который можно обработать через match.
Rust даёт два способа сослаться на элемент, чтобы вы могли выбрать, как программа поведёт себя при попытке обратиться по индексу за пределами существующих элементов. Для примера посмотрим, что будет, если в векторе из пяти элементов обратиться каждым из способов к элементу с индексом 100, как в листинге 8-5.
fn main() {
let v = vec![1, 2, 3, 4, 5];
let does_not_exist = &v[100];
let does_not_exist = v.get(100);
}При запуске этого кода первый способ, [], вызовет панику: он ссылается на
несуществующий элемент. Этот способ лучше всего подходит, когда вы хотите,
чтобы программа упала при попытке обратиться за конец вектора.
Если передать методу get индекс за пределами вектора, он вернёт None и не
будет паниковать. Этим методом стоит пользоваться, если обращение за пределы
вектора иногда может случиться и в нормальной ситуации. Тогда в вашем коде
будет логика, обрабатывающая и Some(&element), и None, как мы обсуждали в
главе 6. Например, индекс может вводить человек. Если он случайно введёт
слишком большое число и программа получит None, можно сообщить
пользователю, сколько элементов в векторе, и дать ещё одну попытку ввести
правильное значение. Это куда дружелюбнее, чем ронять программу из-за
опечатки!
Когда у программы есть действительная ссылка, анализатор заимствований (borrow checker) следит за соблюдением правил владения и заимствования (о них — в главе 4), чтобы эта ссылка и все другие ссылки на содержимое вектора оставались действительными. Вспомните правило: в одной области видимости не может быть одновременно изменяемых и неизменяемых ссылок. Это правило срабатывает в листинге 8-6: мы держим неизменяемую ссылку на первый элемент вектора и пытаемся добавить элемент в конец. Программа не скомпилируется, если дальше в функции мы снова обратимся к этому первому элементу.
fn main() {
let mut v = vec![1, 2, 3, 4, 5];
let first = &v[0];
v.push(6);
println!("The first element is: {first}");
}При компиляции получим ошибку:
$ cargo run
Compiling collections v0.1.0 (file:///projects/collections)
error[E0502]: cannot borrow `v` as mutable because it is also borrowed as immutable
--> src/main.rs:6:5
|
4 | let first = &v[0];
| - immutable borrow occurs here
5 |
6 | v.push(6);
| ^^^^^^^^^ mutable borrow occurs here
7 |
8 | println!("The first element is: {first}");
| ----- immutable borrow later used here
For more information about this error, try `rustc --explain E0502`.
error: could not compile `collections` (bin "collections") due to 1 previous error
Может показаться, что код из листинга 8-6 должен работать: какое дело ссылке на первый элемент до изменений в конце вектора? Ошибка связана с тем, как устроены векторы. Вектор хранит значения в памяти подряд. Если в уже выделенном участке памяти не хватит места для нового элемента, вектор выделит новый, больший участок и скопирует туда все старые элементы. И тогда ссылка на первый элемент указывала бы на уже освобождённую память. Правила заимствования не дают программе попасть в такую ситуацию.
Примечание: подробнее о том, как устроен тип Vec<T>, читайте в
«The Rustonomicon».
Перебор значений вектора
Чтобы по очереди обратиться к каждому элементу вектора, удобнее перебрать все
элементы, чем обращаться к ним по одному по индексу. В листинге 8-7 показано,
как циклом for получить неизменяемые ссылки на каждый элемент вектора
значений i32 и вывести их.
fn main() {
let v = vec![100, 32, 57];
for i in &v {
println!("{i}");
}
}forМожно перебирать и изменяемые ссылки на элементы изменяемого вектора, чтобы
изменить все элементы. Цикл for в листинге 8-8 прибавит к каждому элементу
50.
fn main() {
let mut v = vec![100, 32, 57];
for i in &mut v {
*i += 50;
}
}Чтобы изменить значение, на которое указывает изменяемая ссылка, нужно
сначала добраться до значения в i оператором разыменования *, и только
потом применять +=. Подробнее об операторе разыменования — в разделе
«Переход по ссылке к значению» главы 15.
Перебирать вектор безопасно — и неизменяемо, и изменяемо — благодаря правилам
анализатора заимствований. Если бы в теле циклов for из листингов 8-7 и 8-8
мы попытались вставить или удалить элементы, получили бы ошибку компиляции,
похожую на ошибку из листинга 8-6. Ссылка на вектор, которую держит цикл
for, не даёт одновременно изменить вектор целиком.
Хранение разных типов с помощью перечисления
Вектор может хранить только значения одного типа. Это бывает неудобно: иногда действительно нужно хранить список элементов разных типов. К счастью, все варианты перечисления относятся к одному типу — типу перечисления. Так что если нужно одним типом представить элементы разных типов, можно определить перечисление!
Допустим, мы хотим получить значения из строки электронной таблицы, где в одних столбцах целые числа, в других — числа с плавающей точкой, а в третьих — строки. Определим перечисление, варианты которого хранят значения разных типов, — при этом все варианты считаются одним типом, типом перечисления. Затем создадим вектор, который хранит это перечисление, а значит, в конечном счёте хранит значения разных типов. Это показано в листинге 8-9.
fn main() {
enum SpreadsheetCell {
Int(i32),
Float(f64),
Text(String),
}
let row = vec![
SpreadsheetCell::Int(3),
SpreadsheetCell::Text(String::from("blue")),
SpreadsheetCell::Float(10.12),
];
}Rust должен знать при компиляции, какие типы будут в векторе, чтобы точно
знать, сколько памяти в куче понадобится для каждого элемента. Кроме того,
нужно явно указать, какие типы допустимы в векторе. Если бы Rust позволял
вектору хранить что угодно, какой-нибудь из типов мог бы вызвать ошибку при
операциях над элементами вектора. Перечисление вместе с выражением match
гарантирует, что Rust ещё при компиляции проверит обработку всех возможных
случаев, как говорилось в главе 6.
Если заранее неизвестен полный набор типов, которые программа получит во время работы и будет хранить в векторе, приём с перечислением не сработает. Тогда можно использовать трейт-объект — о них мы поговорим в главе 18.
Мы рассмотрели самые распространённые способы работы с векторами, но
обязательно загляните в документацию по API: в
стандартной библиотеке для Vec<T> определено множество полезных методов.
Например, кроме push есть метод pop, который удаляет и возвращает
последний элемент.
Вместе с вектором уничтожаются и его элементы
Как и любая другая структура (struct), вектор освобождается, когда выходит
из области видимости, — это показано в листинге 8-10.
fn main() {
{
let v = vec![1, 2, 3, 4];
// что-то делаем с v
} // <- здесь v выходит из области видимости, и память освобождается
}Когда вектор уничтожается, уничтожается и всё его содержимое — то есть хранящиеся в нём целые числа тоже освобождаются. Анализатор заимствований следит, чтобы ссылки на содержимое вектора использовались только пока сам вектор действителен.
Перейдём к следующей коллекции — String!
Строки: текст в UTF-8
Строки: текст в UTF-8
О строках мы уже говорили в главе 4, а теперь разберём их подробнее. Новички в Rust часто спотыкаются о строки по трём причинам сразу: Rust любит показывать возможные ошибки; строки — более сложная структура данных, чем считают многие программисты; и наконец, UTF-8. Вместе это может показаться трудным, если вы пришли из других языков.
Мы обсуждаем строки в контексте коллекций, потому что строка реализована как
коллекция байтов плюс набор методов, которые полезны, когда эти байты
интерпретируются как текст. В этом разделе мы поговорим об операциях над
String, которые есть у любой коллекции: создании, изменении и чтении. А ещё
обсудим, чем String отличается от других коллекций: почему к ней нельзя
просто обратиться по индексу. Всё дело в том, что люди и компьютеры
по-разному понимают, что лежит в строке.
Что такое строка
Сначала определимся, что мы называем строкой. В самом ядре языка Rust есть
только один строковый тип — строковый срез str, который обычно встречается
в заимствованной форме, &str. В главе 4 мы говорили о строковых срезах:
это ссылки на данные строки в кодировке UTF-8, хранящиеся где-то ещё.
Например, строковые литералы хранятся в бинарном файле программы и поэтому
являются строковыми срезами.
Тип String предоставляется стандартной библиотекой, а не встроен в ядро
языка. Это растущий, изменяемый строковый тип в кодировке UTF-8, который
владеет своими данными. Когда растацеаны говорят о «строках» в Rust, они могут
иметь в виду как String, так и строковый срез &str, а не какой-то один из
них. Хотя этот раздел в основном про String, оба типа активно используются в
стандартной библиотеке Rust, и оба — и String, и строковые срезы — хранят
текст в UTF-8.
Создание строки
Многие операции, доступные для Vec<T>, есть и у String: на самом деле
String реализован как обёртка над вектором байтов с дополнительными
гарантиями, ограничениями и возможностями. Пример функции, которая одинаково
работает и с Vec<T>, и со String, — функция new, создающая экземпляр,
как в листинге 8-11.
fn main() {
let mut s = String::new();
}StringЭта строка кода создаёт новую пустую строку s, в которую потом можно
загрузить данные. Часто строку хочется сразу создать с какими-то начальными
данными. Для этого есть метод to_string, доступный у любого типа, который
реализует трейт Display, — в том числе у строковых литералов. В листинге
8-12 два примера.
fn main() {
let data = "initial contents";
let s = data.to_string();
// Метод можно вызвать и прямо у литерала:
let s = "initial contents".to_string();
}String из строкового литерала методом to_stringЭтот код создаёт строку с содержимым initial contents.
Создать String из строкового литерала можно и функцией String::from. Код в
листинге 8-13 равнозначен коду из листинга 8-12 с to_string.
fn main() {
let s = String::from("initial contents");
}String из строкового литерала функцией String::fromСтроки используются для очень многих задач, поэтому для них есть множество
разных обобщённых API, и выбор вариантов большой. Некоторые из них могут
показаться избыточными, но у каждого своё место! В нашем случае String::from
и to_string делают одно и то же, так что выбор между ними — вопрос стиля и
читабельности.
Помните, что строки хранятся в UTF-8, поэтому в них можно положить любые корректно закодированные данные, как в листинге 8-14.
fn main() {
let hello = String::from("السلام عليكم");
let hello = String::from("Dobrý den");
let hello = String::from("Hello");
let hello = String::from("שלום");
let hello = String::from("नमस्ते");
let hello = String::from("こんにちは");
let hello = String::from("안녕하세요");
let hello = String::from("你好");
let hello = String::from("Olá");
let hello = String::from("Здравствуйте");
let hello = String::from("Hola");
}Всё это — допустимые значения String.
Изменение строки
String может расти, а её содержимое — меняться, как у Vec<T>, если
добавлять в неё данные. Кроме того, значения String удобно склеивать
оператором + или макросом format!.
Дописывание через push_str и push
Нарастить String можно методом push_str, который дописывает в конец
строковый срез, как в листинге 8-15.
fn main() {
let mut s = String::from("foo");
s.push_str("bar");
}String методом push_strПосле этих двух строк в s будет foobar. Метод push_str принимает
строковый срез, потому что забирать владение параметром нам вовсе не
обязательно. Например, в коде из листинга 8-16 мы хотим пользоваться s2 и
после того, как дописали её содержимое в s1.
fn main() {
let mut s1 = String::from("foo");
let s2 = "bar";
s1.push_str(s2);
println!("s2 is {s2}");
}StringЕсли бы метод push_str забирал владение s2, мы не смогли бы вывести её
значение в последней строке. Но этот код работает так, как мы и ожидаем!
Метод push принимает параметром один символ и добавляет его в String. В
листинге 8-17 мы добавляем в String букву l методом push.
fn main() {
let mut s = String::from("lo");
s.push('l');
}String методом pushВ результате в s будет lol.
Склеивание через + и format!
Часто нужно соединить две существующие строки. Один из способов — оператор
+, как в листинге 8-18.
fn main() {
let s1 = String::from("Hello, ");
let s2 = String::from("world!");
let s3 = s1 + &s2; // обратите внимание: s1 перемещена сюда, и использовать её больше нельзя
}String в новое значение String оператором +В строке s3 будет Hello, world!. Почему после сложения s1 перестаёт быть
действительной и почему мы взяли ссылку на s2 — объясняется сигнатурой
метода, который вызывается при использовании оператора +. Оператор +
вызывает метод add, сигнатура которого выглядит примерно так:
fn add(self, s: &str) -> String {В стандартной библиотеке add определён через обобщения и ассоциированные
типы. Здесь мы подставили конкретные типы — именно они получаются, когда этот
метод вызывается со значениями String. Обобщения мы обсудим в главе 10. А
эта сигнатура даёт нам подсказки, нужные, чтобы разобраться в хитростях
оператора +.
Во-первых, перед s2 стоит &, то есть к первой строке мы прибавляем ссылку
на вторую. Так получается из-за параметра s в функции add: к String можно
прибавить только строковый срез, сложить два значения String напрямую
нельзя. Но постойте: тип &s2 — это &String, а не &str, как указано во
втором параметре add. Почему же листинг 8-18 компилируется?
Использовать &s2 в вызове add можно потому, что компилятор умеет
привести аргумент &String к типу &str. При вызове add Rust применяет
неявное разыменование (deref coercion), которое здесь превращает &s2 в
&s2[..]. Подробнее о неявном разыменовании мы поговорим в главе 15. Метод
add не забирает владение параметром s, поэтому после этой операции s2
остаётся действительной String.
Во-вторых, из сигнатуры видно, что add забирает владение self: перед
self нет &. Значит, s1 из листинга 8-18 перемещается в вызов add и
после него становится недействительной. Так что хотя let s3 = s1 + &s2;
выглядит так, будто копирует обе строки и создаёт новую, на самом деле эта
инструкция забирает владение s1, дописывает в её конец копию содержимого
s2 и возвращает владение результатом. Иначе говоря, кажется, что тут много
копирования, а его нет: реализация эффективнее, чем копирование.
Если нужно склеить несколько строк, с оператором + становится неудобно:
fn main() {
let s1 = String::from("tic");
let s2 = String::from("tac");
let s3 = String::from("toe");
let s = s1 + "-" + &s2 + "-" + &s3;
}В итоге в s будет tic-tac-toe. Из-за всех этих + и " трудно понять,
что происходит. Для более сложного соединения строк лучше подходит макрос
format!:
fn main() {
let s1 = String::from("tic");
let s2 = String::from("tac");
let s3 = String::from("toe");
let s = format!("{s1}-{s2}-{s3}");
}Этот код тоже записывает в s значение tic-tac-toe. Макрос format!
работает как println!, только не выводит результат на экран, а возвращает
String с этим содержимым. Версию с format! читать гораздо проще, а код,
который генерирует макрос format!, использует ссылки, так что этот вызов не
забирает владение ни одним из своих параметров.
Обращение к строке по индексу
Во многих языках программирования обращение к отдельным символам строки по
индексу — нормальная и распространённая операция. Но если в Rust попытаться
обратиться к части String через индекс, получится ошибка. Посмотрите на
некорректный код из листинга 8-19.
fn main() {
let s1 = String::from("hi");
let h = s1[0];
}String по индексуЭтот код приведёт к ошибке:
$ cargo run
Compiling collections v0.1.0 (file:///projects/collections)
error[E0277]: the type `str` cannot be indexed by `{integer}`
--> src/main.rs:3:16
|
3 | let h = s1[0];
| ^ string indices are ranges of `usize`
|
= help: the trait `SliceIndex<str>` is not implemented for `{integer}`
= note: you can use `.chars().nth()` or `.bytes().nth()`
for more information, see chapter 8 in The Book: <https://doc.rust-lang.org/book/ch08-02-strings.html#indexing-into-strings>
help: `usize` implements trait `SliceIndex<T>`
--> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/slice/index.rs:179:0
|
= note: `SliceIndex<[T]>`
--> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/bstr/traits.rs:197:0
|
= note: `SliceIndex<ByteStr>`
= note: required for `String` to implement `Index<{integer}>`
For more information about this error, try `rustc --explain E0277`.
error: could not compile `collections` (bin "collections") due to 1 previous error
Ошибка говорит сама за себя: строки в Rust не поддерживают индексацию. Но почему? Чтобы ответить на этот вопрос, нужно разобраться, как Rust хранит строки в памяти.
Внутреннее представление
String — это обёртка над Vec<u8>. Посмотрим на несколько корректно
закодированных в UTF-8 строк из листинга 8-14. Сначала на эту:
fn main() {
let hello = String::from("السلام عليكم");
let hello = String::from("Dobrý den");
let hello = String::from("Hello");
let hello = String::from("שלום");
let hello = String::from("नमस्ते");
let hello = String::from("こんにちは");
let hello = String::from("안녕하세요");
let hello = String::from("你好");
let hello = String::from("Olá");
let hello = String::from("Здравствуйте");
let hello = String::from("Hola");
}Здесь len будет равно 4: вектор, хранящий строку "Hola", занимает 4
байта. Каждая из этих букв в UTF-8 занимает 1 байт. А вот следующая строка
может вас удивить:
fn main() {
let hello = String::from("السلام عليكم");
let hello = String::from("Dobrý den");
let hello = String::from("Hello");
let hello = String::from("שלום");
let hello = String::from("नमस्ते");
let hello = String::from("こんにちは");
let hello = String::from("안녕하세요");
let hello = String::from("你好");
let hello = String::from("Olá");
let hello = String::from("Здравствуйте");
let hello = String::from("Hola");
}На вопрос, какой длины эта строка, вы, скорее всего, ответите: 12. А Rust ответит: 24. Столько байтов нужно, чтобы закодировать «Здравствуйте» в UTF-8: каждое скалярное значение Юникода в этой строке занимает 2 байта. Поэтому индекс байта в строке не всегда соответствует целому скалярному значению Юникода. Чтобы это показать, рассмотрим такой некорректный код на Rust:
let hello = "Здравствуйте";
let answer = &hello[0];Вы уже знаете, что answer не будет равно З, первой букве. В UTF-8 первый
байт З — это 208, а второй — 151. Казалось бы, тогда answer должно
быть 208, но 208 сам по себе — не символ. Пользователь, который попросил
первую букву строки, вряд ли хотел получить 208, но других данных по
индексу 0 у Rust нет. Обычно пользователям не нужно значение байта, даже если
в строке только латиница: если бы &"hi"[0] был допустимым кодом,
возвращающим байт, он вернул бы 104, а не h.
Так что ответ такой: чтобы не возвращать неожиданное значение и не порождать баги, которые могут обнаружиться не сразу, Rust вообще не компилирует этот код и пресекает недоразумения ещё на ранних этапах разработки.
Байты, скалярные значения и графемные кластеры
Ещё одна особенность UTF-8: с точки зрения Rust на строку можно смотреть тремя способами — как на байты, как на скалярные значения и как на графемные кластеры (они ближе всего к тому, что мы называем буквами).
Возьмём слово на хинди «नमस्ते», записанное письмом деванагари. Оно хранится
как вектор значений u8, который выглядит так:
[224, 164, 168, 224, 164, 174, 224, 164, 184, 224, 165, 141, 224, 164, 164,
224, 165, 135]
Это 18 байт — именно так компьютер в конечном счёте хранит эти данные. Если
смотреть на них как на скалярные значения Юникода, то есть на значения типа
char в Rust, байты выглядят так:
['न', 'म', 'स', '्', 'त', 'े']
Здесь шесть значений char, но четвёртое и шестое — не буквы: это
диакритические знаки, которые сами по себе смысла не имеют. И наконец, если
смотреть на них как на графемные кластеры, получится то, что человек назвал бы
четырьмя буквами, из которых состоит это слово:
["न", "म", "स्", "ते"]
Rust даёт разные способы интерпретировать «сырые» данные строки, которые хранит компьютер, чтобы каждая программа могла выбрать нужную интерпретацию — на каком бы человеческом языке ни были данные.
И последняя причина, по которой Rust не позволяет получить символ из String
по индексу: от операции индексации ожидается, что она всегда выполняется за
константное время (O(1)). Но со String такую производительность
гарантировать невозможно: Rust пришлось бы пройти содержимое от начала до
индекса, чтобы определить, сколько там корректных символов.
Срезы строк
Обращаться к строке по индексу часто плохая идея, потому что непонятно, что должна возвращать такая операция: байт, символ, графемный кластер или строковый срез. Поэтому если вам действительно нужно создавать строковые срезы по индексам, Rust просит выражаться точнее.
Вместо [] с одним числом можно использовать [] с диапазоном — так
получится строковый срез, содержащий определённые байты:
#![allow(unused)]
fn main() {
let hello = "Здравствуйте";
let s = &hello[0..4];
}Здесь s будет &str с первыми 4 байтами строки. Мы уже говорили, что
каждый из этих символов занимает 2 байта, значит, s будет равно Зд.
Если попытаться вырезать только часть байтов символа, например
&hello[0..1], Rust запаникует во время выполнения — так же, как при
обращении к вектору по недопустимому индексу:
$ cargo run
Compiling collections v0.1.0 (file:///projects/collections)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.43s
Running `target/debug/collections`
thread 'main' (6017738) panicked at src/main.rs:4:19:
end byte index 1 is not a char boundary; it is inside 'З' (bytes 0..2 of string)
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
Создавая строковые срезы по диапазонам, будьте осторожны: это может уронить программу.
Перебор строк
Работать с частями строк лучше всего, явно указывая, что вам нужно — символы
или байты. Для отдельных скалярных значений Юникода есть метод chars.
Вызов chars у «Зд» разделяет строку и возвращает два значения типа char,
а результат можно перебрать и обратиться к каждому элементу:
#![allow(unused)]
fn main() {
for c in "Зд".chars() {
println!("{c}");
}
}Этот код выведет:
З
д
Можно воспользоваться и методом bytes, который возвращает каждый «сырой»
байт, — возможно, в вашей задаче нужно именно это:
#![allow(unused)]
fn main() {
for b in "Зд".bytes() {
println!("{b}");
}
}Этот код выведет 4 байта, из которых состоит строка:
208
151
208
180
Но обязательно помните, что корректное скалярное значение Юникода может состоять из нескольких байтов.
Получить из строки графемные кластеры, как в случае с деванагари, — сложная задача, поэтому стандартная библиотека этого не умеет. Если вам нужна такая функциональность, поищите подходящий крейт на crates.io.
Строки — это непросто
Подведём итог: строки — штука сложная. Разные языки программирования
по-разному решают, как показать эту сложность программисту. Rust выбрал путь,
при котором корректная обработка данных String — это поведение по умолчанию
во всех программах на Rust. Значит, программистам приходится заранее
продумывать работу с UTF-8. Из-за этого сложность строк в Rust заметнее, чем в
других языках, зато вам не придётся потом, на поздних этапах разработки,
разбираться с ошибками из-за не-ASCII-символов.
Хорошая новость: в стандартной библиотеке много функциональности на основе
типов String и &str, которая помогает правильно справляться с такими
сложными ситуациями. Обязательно загляните в документацию — там есть полезные
методы вроде contains для поиска в строке и replace для замены частей
строки другой строкой.
А теперь перейдём к чему-нибудь чуть попроще — к хеш-таблицам!
Хеш-таблицы: ключи и значения
Хеш-таблицы: ключи и значения
Последняя из наших основных коллекций — хеш-таблица. Тип HashMap<K, V>
хранит соответствие ключей типа K значениям типа V и использует для этого
хеш-функцию, которая определяет, как ключи и значения размещаются в памяти.
Такая структура данных есть во многих языках, но называется по-разному: hash,
map, object, hash table, dictionary (словарь) или associative array
(ассоциативный массив) — и это далеко не всё.
Хеш-таблицы удобны, когда данные нужно искать не по индексу, как в векторе, а по ключу, который может быть любого типа. Например, в игре можно хранить счёт каждой команды в хеш-таблице, где ключ — название команды, а значение — её счёт. Зная название команды, можно получить её счёт.
В этом разделе мы рассмотрим основной API хеш-таблиц, но в функциях, которые
стандартная библиотека определяет для HashMap<K, V>, спрятано ещё много
полезного. Как обычно, подробности ищите в документации стандартной
библиотеки.
Создание хеш-таблицы
Один из способов создать пустую хеш-таблицу — вызвать new, а элементы
добавлять методом insert. В листинге 8-20 мы отслеживаем счёт двух команд —
Blue (синих) и Yellow (жёлтых). У синих сначала 10 очков, у жёлтых — 50.
fn main() {
use std::collections::HashMap;
let mut scores = HashMap::new();
scores.insert(String::from("Blue"), 10);
scores.insert(String::from("Yellow"), 50);
}Обратите внимание: сначала нужно подключить HashMap через use из раздела
коллекций стандартной библиотеки. Из трёх наших основных коллекций эта
используется реже всего, поэтому её нет среди того, что прелюдия
автоматически подключает в область видимости. Да и поддержки в стандартной
библиотеке у хеш-таблиц меньше: например, нет встроенного макроса для их
создания.
Как и векторы, хеш-таблицы хранят данные в куче. У этой HashMap ключи типа
String и значения типа i32. И, как векторы, хеш-таблицы однородны: все
ключи должны быть одного типа, и все значения — тоже одного типа.
Доступ к значениям в хеш-таблице
Получить значение из хеш-таблицы можно, передав его ключ методу get, как в
листинге 8-21.
fn main() {
use std::collections::HashMap;
let mut scores = HashMap::new();
scores.insert(String::from("Blue"), 10);
scores.insert(String::from("Yellow"), 50);
let team_name = String::from("Blue");
let score = scores.get(&team_name).copied().unwrap_or(0);
}Здесь score получит значение, связанное с синей командой, — то есть 10.
Метод get возвращает Option<&V>: если в хеш-таблице нет значения для
этого ключа, get вернёт None. Программа обрабатывает Option так: сначала
вызывает copied, чтобы получить Option<i32> вместо Option<&i32>, а затем
unwrap_or, чтобы записать в score ноль, если в scores нет записи для
этого ключа.
Перебрать все пары «ключ — значение» в хеш-таблице можно так же, как
элементы вектора, — циклом for:
fn main() {
use std::collections::HashMap;
let mut scores = HashMap::new();
scores.insert(String::from("Blue"), 10);
scores.insert(String::from("Yellow"), 50);
for (key, value) in &scores {
println!("{key}: {value}");
}
}Этот код выведет все пары в произвольном порядке:
Yellow: 50
Blue: 10
Хеш-таблицы и владение
Значения типов, реализующих трейт Copy, вроде i32, копируются в
хеш-таблицу. А значения, которые владеют своими данными, вроде String,
перемещаются, и владельцем этих значений становится хеш-таблица, как показано
в листинге 8-22.
fn main() {
use std::collections::HashMap;
let field_name = String::from("Favorite color");
let field_value = String::from("Blue");
let mut map = HashMap::new();
map.insert(field_name, field_value);
// здесь field_name и field_value уже недействительны; попробуйте их
// использовать и посмотрите, какую ошибку выдаст компилятор!
}После того как вызов insert переместил переменные field_name и
field_value в хеш-таблицу, пользоваться ими уже нельзя.
Если вставлять в хеш-таблицу ссылки на значения, сами значения в неё перемещаться не будут. Но значения, на которые указывают ссылки, должны оставаться действительными как минимум столько же, сколько и хеш-таблица. Подробнее об этом мы поговорим в разделе «Проверка ссылок с помощью времён жизни» главы 10.
Изменение хеш-таблицы
Количество пар «ключ — значение» может расти, но с каждым уникальным ключом в
каждый момент связано только одно значение (обратное неверно: например, и у
синих, и у жёлтых в хеш-таблице scores может храниться значение 10).
Когда нужно поменять данные в хеш-таблице, приходится решить, что делать, если у ключа уже есть значение. Можно заменить старое значение новым, совсем не обращая внимания на старое. Можно оставить старое и проигнорировать новое, добавляя новое значение, только если у ключа значения ещё нет. А можно объединить старое значение с новым. Посмотрим, как сделать каждое из этого!
Перезапись значения
Если вставить в хеш-таблицу ключ со значением, а потом вставить тот же ключ с
другим значением, значение, связанное с ключом, будет заменено. Хотя код в
листинге 8-23 вызывает insert дважды, в хеш-таблице окажется только одна
пара «ключ — значение»: оба раза мы вставляем значение для ключа синей
команды.
fn main() {
use std::collections::HashMap;
let mut scores = HashMap::new();
scores.insert(String::from("Blue"), 10);
scores.insert(String::from("Blue"), 25);
println!("{scores:?}");
}Этот код выведет {"Blue": 25}. Исходное значение 10 перезаписано.
Добавление ключа, только если его ещё нет
Часто нужно проверить, есть ли уже в хеш-таблице такой ключ со значением, и дальше поступить так: если ключ есть — оставить существующее значение как есть; если нет — вставить ключ и значение для него.
Для этого у хеш-таблиц есть специальный API — метод entry, который
принимает параметром ключ, который нужно проверить. Метод entry возвращает
перечисление Entry, представляющее значение, которое может существовать, а
может и нет. Допустим, мы хотим проверить, есть ли значение у ключа жёлтой
команды. Если нет — вставить значение 50; то же самое для синей команды. С
API entry код выглядит как в листинге 8-24.
fn main() {
use std::collections::HashMap;
let mut scores = HashMap::new();
scores.insert(String::from("Blue"), 10);
scores.entry(String::from("Yellow")).or_insert(50);
scores.entry(String::from("Blue")).or_insert(50);
println!("{scores:?}");
}entry вставляет значение, только если у ключа его ещё нетМетод or_insert у Entry устроен так: если ключ существует, он возвращает
изменяемую ссылку на значение этого ключа; если нет — вставляет свой параметр
как новое значение для ключа и возвращает изменяемую ссылку на это новое
значение. Это куда чище, чем писать такую логику самим, да и с анализатором
заимствований так ладить проще.
Код из листинга 8-24 выведет {"Yellow": 50, "Blue": 10}. Первый вызов
entry вставит ключ жёлтой команды со значением 50, потому что значения у
жёлтых ещё нет. Второй вызов entry хеш-таблицу не изменит: у синих уже есть
значение 10.
Обновление значения на основе старого
Ещё один частый сценарий — найти значение по ключу и обновить его, опираясь
на старое значение. Например, в листинге 8-25 код подсчитывает, сколько раз
каждое слово встречается в тексте. Мы используем хеш-таблицу, где ключи —
слова, и увеличиваем значение, чтобы отслеживать, сколько раз нам встретилось
это слово. Если слово встретилось впервые, сначала вставляем значение 0.
fn main() {
use std::collections::HashMap;
let text = "hello world wonderful world";
let mut map = HashMap::new();
for word in text.split_whitespace() {
let count = map.entry(word).or_insert(0);
*count += 1;
}
println!("{map:?}");
}Этот код выведет {"world": 2, "hello": 1, "wonderful": 1}. У вас пары могут
появиться в другом порядке: как мы говорили в разделе «Доступ к значениям в
хеш-таблице», хеш-таблица перебирается в произвольном
порядке.
Метод split_whitespace возвращает итератор по фрагментам строки text,
разделённым пробельными символами. Метод or_insert возвращает изменяемую
ссылку (&mut V) на значение указанного ключа. Мы сохраняем эту ссылку в
переменной count, поэтому, чтобы присвоить значение, сначала нужно
разыменовать count звёздочкой (*). Изменяемая ссылка выходит из области
видимости в конце итерации цикла for, так что все эти изменения безопасны и
разрешены правилами заимствования.
Хеш-функции
По умолчанию HashMap использует хеш-функцию SipHash, которая устойчива к
атакам типа «отказ в обслуживании» (DoS), направленным на
хеш-таблицы1. Это не самый быстрый алгоритм
хеширования, но выигрыш в безопасности стоит потери в производительности. Если
вы профилируете код и обнаружите, что хеш-функция по умолчанию для ваших
задач слишком медленная, можно переключиться на другую, указав другой
хешер (hasher) — тип, реализующий трейт BuildHasher. О трейтах и о том,
как их реализовывать, мы поговорим в главе 10. Писать
свой хешер с нуля не обязательно: на crates.io есть библиотеки от других пользователей Rust с хешерами для многих
распространённых алгоритмов хеширования.
Итоги
Векторы, строки и хеш-таблицы покрывают большую часть того, что нужно программам, когда данные надо хранить, получать и изменять. Вот несколько упражнений, с которыми вы теперь справитесь:
- Дан список целых чисел. С помощью вектора найдите медиану (значение, которое окажется посередине после сортировки) и моду (значение, которое встречается чаще всего; здесь пригодится хеш-таблица).
- Переведите строки на «поросячью латынь» (Pig Latin). Первая согласная каждого слова переносится в конец слова, и к ней добавляется ay: first превращается в irst-fay. К словам, которые начинаются с гласной, в конец добавляется hay (apple превращается в apple-hay). Не забывайте про особенности кодировки UTF-8!
- С помощью хеш-таблицы и векторов сделайте текстовый интерфейс, через который пользователь может добавлять сотрудников в отделы компании: например, «Add Sally to Engineering» или «Add Amir to Sales». Затем дайте пользователю возможность получить список всех сотрудников отдела или всех сотрудников компании по отделам, отсортированный по алфавиту.
В документации по API стандартной библиотеки описаны методы векторов, строк и хеш-таблиц, которые пригодятся для этих упражнений!
Мы переходим к более сложным программам, в которых операции могут завершаться неудачей, — самое время поговорить об обработке ошибок. Этим мы и займёмся!
Обработка ошибок
Ошибки в программах неизбежны, поэтому в Rust есть ряд средств для ситуаций, когда что-то идёт не так. Во многих случаях Rust требует, чтобы вы признали возможность ошибки и как-то на неё отреагировали, — иначе код не скомпилируется. Это делает программу надёжнее: вы гарантированно обнаружите ошибки и правильно их обработаете ещё до того, как код попадёт в продакшен!
Rust делит ошибки на две большие категории: исправимые и неисправимые. При исправимой ошибке (recoverable error), например файл не найден, скорее всего, достаточно сообщить пользователю о проблеме и повторить операцию. Неисправимые ошибки (unrecoverable errors) — это всегда признак бага, например попытки обратиться за конец массива, и в таких случаях программу нужно немедленно остановить.
Большинство языков не различают эти два вида ошибок и обрабатывают их
одинаково — например, с помощью исключений. В Rust исключений нет. Вместо
них есть тип Result<T, E> для исправимых ошибок и макрос panic!, который
останавливает выполнение, когда программа сталкивается с неисправимой
ошибкой. В этой главе мы сначала разберём вызов panic!, а потом поговорим о
возврате значений Result<T, E>. А ещё обсудим, как решить, пытаться ли
восстановиться после ошибки или остановить выполнение.
Неисправимые ошибки и panic!
Неисправимые ошибки и panic!
Иногда в коде случается что-то плохое, и с этим ничего не поделать. На такие
случаи в Rust есть макрос panic!. На практике вызвать панику можно двумя
способами: сделать что-то, отчего код запаникует (например, обратиться за
конец массива), или явно вызвать макрос panic!. В обоих случаях в программе
возникает паника. По умолчанию при панике программа выводит сообщение об
ошибке, раскручивает и очищает стек и завершается. С помощью переменной
окружения можно также попросить Rust при панике показывать стек вызовов —
так проще найти её источник.
Раскрутка стека или аварийное завершение при панике
По умолчанию при панике программа начинает раскрутку стека (unwinding): Rust проходит по стеку в обратном направлении и очищает данные каждой функции, которая ему встречается. Но такой обход и очистка — большая работа. Поэтому Rust позволяет выбрать другой вариант — немедленное аварийное завершение (abort), при котором программа заканчивается без всякой очистки.
Память, которую занимала программа, тогда придётся освобождать
операционной системе. Если в вашем проекте нужно, чтобы бинарник был как
можно меньше, можно переключиться с раскрутки на аварийное завершение при
панике, добавив panic = 'abort' в соответствующие секции [profile] файла
Cargo.toml. Например, чтобы аварийно завершаться при панике в режиме
релиза, добавьте:
[profile.release]
panic = 'abort'
Попробуем вызвать panic! в простой программе:
fn main() {
panic!("crash and burn");
}Запустив программу, вы увидите примерно такое:
$ cargo run
Compiling panic v0.1.0 (file:///projects/panic)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.25s
Running `target/debug/panic`
thread 'main' (6018279) panicked at src/main.rs:2:5:
crash and burn
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
Вызов panic! порождает сообщение об ошибке в двух последних строках. Первая
строка показывает наше сообщение паники и место в исходном коде, где она
произошла: src/main.rs:2:5 означает вторую строку, пятый символ файла
src/main.rs.
В данном случае указанная строка — часть нашего кода, и, перейдя к ней, мы
увидим вызов макроса panic!. Но бывает, что panic! вызывается не в нашем
коде, а в коде, который вызывается из нашего, — например, в библиотеке. Тогда в
сообщении будет файл и строка из этого чужого кода, а не строка нашего кода,
которая в итоге привела к панике.
Чтобы найти часть нашего кода, которая вызывает проблему, можно
воспользоваться трассировкой (backtrace) функций, из которых пришёл вызов
panic!. Чтобы понять, как с ней работать, рассмотрим другой пример: на этот
раз panic! вызывается не нашим кодом напрямую, а библиотекой — из-за бага в
нашем коде. В листинге 9-1 код пытается обратиться к элементу вектора по
индексу за пределами допустимых.
fn main() {
let v = vec![1, 2, 3];
v[99];
}panic!Здесь мы пытаемся получить сотый элемент вектора (с индексом 99, ведь
нумерация начинается с нуля), а в векторе всего три элемента. В такой
ситуации Rust запаникует. [] должен вернуть элемент, но если индекс
недопустимый, никакого правильного элемента, который Rust мог бы вернуть,
просто нет.
В C попытка прочитать данные за концом структуры данных — это неопределённое поведение. Вы можете получить то, что лежит в памяти там, где был бы этот элемент, хотя эта память структуре не принадлежит. Это называется чтением за границей буфера (buffer overread) и может привести к уязвимостям: злоумышленник, сумев подобрать индекс, прочитает данные, лежащие после структуры, к которым у него не должно быть доступа.
Чтобы защитить программу от таких уязвимостей, при попытке прочитать элемент по несуществующему индексу Rust останавливает выполнение и отказывается продолжать. Попробуем:
$ cargo run
Compiling panic v0.1.0 (file:///projects/panic)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.27s
Running `target/debug/panic`
thread 'main' (6017887) panicked at src/main.rs:4:6:
index out of bounds: the len is 3 but the index is 99
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
Ошибка указывает на строку 4 файла main.rs, где мы пытаемся обратиться к
индексу 99 вектора v.
Строка note: подсказывает, что можно задать переменную окружения
RUST_BACKTRACE и получить трассировку того, что именно привело к ошибке.
Трассировка (backtrace) — это список всех функций, вызванных на пути к
этой точке. Трассировки в Rust работают так же, как в других языках: читайте
сверху вниз, пока не встретите файл, который написали вы. Именно там и
возникла проблема. Строки выше этого места — функции, которые были вызваны из вашего кода
(например, из стандартной библиотеки). Строки ниже — функции, из которых
был вызван ваш код. Среди этих строк
может быть код ядра Rust, стандартной библиотеки или крейтов, которыми вы
пользуетесь. Попробуем получить трассировку, задав переменной окружения
RUST_BACKTRACE любое значение, кроме 0. В листинге 9-2 — вывод, похожий
на тот, что увидите вы.
$ RUST_BACKTRACE=1 cargo run
thread 'main' panicked at src/main.rs:4:6:
index out of bounds: the len is 3 but the index is 99
stack backtrace:
0: rust_begin_unwind
at /rustc/4d91de4e48198da2e33413efdcd9cd2cc0c46688/library/std/src/panicking.rs:692:5
1: core::panicking::panic_fmt
at /rustc/4d91de4e48198da2e33413efdcd9cd2cc0c46688/library/core/src/panicking.rs:75:14
2: core::panicking::panic_bounds_check
at /rustc/4d91de4e48198da2e33413efdcd9cd2cc0c46688/library/core/src/panicking.rs:273:5
3: <usize as core::slice::index::SliceIndex<[T]>>::index
at file:///home/.rustup/toolchains/1.85/lib/rustlib/src/rust/library/core/src/slice/index.rs:274:10
4: core::slice::index::<impl core::ops::index::Index<I> for [T]>::index
at file:///home/.rustup/toolchains/1.85/lib/rustlib/src/rust/library/core/src/slice/index.rs:16:9
5: <alloc::vec::Vec<T,A> as core::ops::index::Index<I>>::index
at file:///home/.rustup/toolchains/1.85/lib/rustlib/src/rust/library/alloc/src/vec/mod.rs:3361:9
6: panic::main
at ./src/main.rs:4:6
7: core::ops::function::FnOnce::call_once
at file:///home/.rustup/toolchains/1.85/lib/rustlib/src/rust/library/core/src/ops/function.rs:250:5
note: Some details are omitted, run with `RUST_BACKTRACE=full` for a verbose backtrace.
panic!, если задана переменная окружения RUST_BACKTRACEВывода много! Точный вид зависит от операционной системы и версии Rust. Чтобы
трассировка содержала эту информацию, должны быть включены отладочные символы.
Они включены по умолчанию, если запускать cargo build или cargo run без
флага --release, как здесь.
В выводе из листинга 9-2 строка 6 трассировки указывает на строку нашего проекта, которая вызывает проблему: строку 4 файла src/main.rs. Если мы не хотим, чтобы программа паниковала, начинать расследование нужно с места, на которое указывает первая строка с упоминанием нашего файла. В листинге 9-1 мы нарочно написали код, который паникует, и исправить это можно, просто не запрашивая элемент за пределами индексов вектора. Когда ваш код запаникует в будущем, нужно будет разобраться, какое действие и с какими значениями приводит к панике и что код должен делать вместо этого.
Мы ещё вернёмся к panic! и обсудим, когда стоит, а когда не стоит
обрабатывать ошибки с его помощью, в разделе «Паниковать или не
паниковать» этой главы. А дальше
посмотрим, как восстанавливаться после ошибок с помощью Result.
Исправимые ошибки и Result
Исправимые ошибки и Result
Большинство ошибок не настолько серьёзны, чтобы останавливать программу целиком. Часто функция не срабатывает по причине, которую легко понять и на которую можно отреагировать. Например, если вы пытаетесь открыть файл, а его нет, возможно, разумнее создать файл, а не завершать процесс.
Вспомните раздел «Обрабатываем возможный сбой с помощью
Result» главы 2: перечисление Result
определено с двумя вариантами, Ok и Err:
#![allow(unused)]
fn main() {
enum Result<T, E> {
Ok(T),
Err(E),
}
}T и E — обобщённые параметры типа; подробно обобщения мы обсудим в
главе 10. Сейчас достаточно знать, что T — это тип значения, которое
вернётся в случае успеха внутри варианта Ok, а E — тип ошибки, которая
вернётся в случае неудачи внутри варианта Err. Благодаря этим обобщённым
параметрам тип Result и его функции можно использовать в самых разных
ситуациях, где значения успеха и ошибки бывают разными.
Вызовем функцию, которая возвращает Result, потому что может не сработать.
В листинге 9-3 мы пытаемся открыть файл.
use std::fs::File;
fn main() {
let greeting_file_result = File::open("hello.txt");
}File::open возвращает Result<T, E>. Вместо обобщённого параметра T
реализация File::open подставила тип значения успеха — std::fs::File, то
есть дескриптор файла. А тип ошибки E — std::io::Error. Такой
возвращаемый тип означает, что вызов File::open может пройти успешно и
вернуть дескриптор файла, из которого можно читать или в который можно
писать. Но может и не сработать: например, файла может не быть или у нас
может не хватать прав на доступ к нему. Функции File::open нужно как-то
сообщить, получилось у неё или нет, и заодно отдать либо дескриптор файла,
либо сведения об ошибке. Именно это и передаёт перечисление Result.
Если File::open сработает, в переменной greeting_file_result окажется
экземпляр Ok с дескриптором файла. Если нет — экземпляр Err с подробностями
о том, какая ошибка произошла.
Код из листинга 9-3 нужно дополнить, чтобы он вёл себя по-разному в
зависимости от того, что вернула File::open. В листинге 9-4 показан один из
способов обработать Result с помощью базового инструмента — выражения
match, которое мы обсуждали в главе 6.
use std::fs::File;
fn main() {
let greeting_file_result = File::open("hello.txt");
let greeting_file = match greeting_file_result {
Ok(file) => file,
Err(error) => panic!("Problem opening the file: {error:?}"),
};
}Result выражением matchЗаметьте, что перечисление Result и его варианты, как и Option, уже
подключены прелюдией, поэтому в ветках match не нужно писать Result::
перед Ok и Err.
Если результат — Ok, этот код достаёт из варианта Ok внутреннее значение
file, и мы присваиваем этот дескриптор переменной greeting_file. После
match дескриптором можно пользоваться для чтения или записи.
Вторая ветка match обрабатывает случай, когда File::open вернула Err. В
этом примере мы решили вызвать макрос panic!. Если в текущей папке нет
файла hello.txt, то при запуске кода макрос panic! выведет:
$ cargo run
Compiling error-handling v0.1.0 (file:///projects/error-handling)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.73s
Running `target/debug/error-handling`
thread 'main' (6018048) panicked at src/main.rs:8:23:
Problem opening the file: Os { code: 2, kind: NotFound, message: "No such file or directory" }
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
Как обычно, вывод точно говорит, что пошло не так.
Разная реакция на разные ошибки
Код из листинга 9-4 вызовет panic!, по какой бы причине File::open ни
вернула ошибку. Но мы хотим реагировать на разные причины по-разному.
Если файла нет, мы хотим создать его и вернуть дескриптор нового файла. Если
же File::open не сработала по любой другой причине — например, не хватает
прав на открытие файла, — код по-прежнему должен вызывать panic!, как в
листинге 9-4. Для этого добавим внутреннее выражение match, как в листинге
9-5.
use std::fs::File;
use std::io::ErrorKind;
fn main() {
let greeting_file_result = File::open("hello.txt");
let greeting_file = match greeting_file_result {
Ok(file) => file,
Err(error) => match error.kind() {
ErrorKind::NotFound => match File::create("hello.txt") {
Ok(fc) => fc,
Err(e) => panic!("Problem creating the file: {e:?}"),
},
_ => {
panic!("Problem opening the file: {error:?}");
}
},
};
}Внутри варианта Err, который возвращает File::open, лежит значение типа
io::Error — это структура из стандартной библиотеки. У неё есть метод
kind, который возвращает значение io::ErrorKind. Перечисление
io::ErrorKind тоже из стандартной библиотеки, его варианты описывают разные
виды ошибок, которые могут возникнуть при операциях ввода-вывода. Нам нужен
вариант ErrorKind::NotFound: он означает, что файла, который мы пытаемся
открыть, ещё нет. Так что мы сопоставляем greeting_file_result, а внутри —
ещё и error.kind().
Во внутреннем match мы проверяем, является ли значение, которое вернул
error.kind(), вариантом NotFound перечисления ErrorKind. Если да, пробуем
создать файл через File::create. Но File::create тоже может не сработать,
поэтому во внутреннем match нужна вторая ветка: если файл создать не
удалось, выводится другое сообщение об ошибке. Вторая ветка внешнего match
остаётся прежней, так что при любой ошибке, кроме отсутствия файла, программа
паникует.
Альтернативы match для Result<T, E>
Сколько же тут match! Выражение match очень полезно, но довольно
примитивно. В главе 13 вы познакомитесь с замыканиями, которые используются
во многих методах Result<T, E>. При обработке значений Result<T, E> эти
методы бывают лаконичнее, чем match.
Например, вот другой способ записать ту же логику, что и в листинге 9-5, —
на этот раз с замыканиями и методом unwrap_or_else:
use std::fs::File;
use std::io::ErrorKind;
fn main() {
let greeting_file = File::open("hello.txt").unwrap_or_else(|error| {
if error.kind() == ErrorKind::NotFound {
File::create("hello.txt").unwrap_or_else(|error| {
panic!("Problem creating the file: {error:?}");
})
} else {
panic!("Problem opening the file: {error:?}");
}
});
}Этот код ведёт себя так же, как листинг 9-5, но в нём нет ни одного
выражения match, и читать его проще. Вернитесь к этому примеру, когда
прочитаете главу 13, и найдите метод unwrap_or_else в документации
стандартной библиотеки. Множество подобных методов помогают навести порядок
в огромных вложенных match при работе с ошибками.
Краткие способы паниковать при ошибке
match работает неплохо, но многословно и не всегда хорошо передаёт
намерение. У типа Result<T, E> есть множество вспомогательных методов для
разных, более конкретных задач. Метод unwrap — сокращение, которое
реализовано ровно как выражение match из листинга 9-4. Если значение
Result — вариант Ok, unwrap вернёт значение внутри Ok. Если Err —
unwrap сам вызовет для нас макрос panic!. Вот unwrap в действии:
use std::fs::File;
fn main() {
let greeting_file = File::open("hello.txt").unwrap();
}Если запустить этот код без файла hello.txt, мы увидим сообщение от вызова
panic!, который делает метод unwrap:
thread 'main' panicked at src/main.rs:4:49:
called `Result::unwrap()` on an `Err` value: Os { code: 2, kind: NotFound, message: "No such file or directory" }
Похожий метод expect позволяет ещё и задать сообщение для panic!. Если
использовать expect вместо unwrap и писать хорошие сообщения об ошибках,
это передаст ваше намерение и упростит поиск источника паники. Синтаксис
expect выглядит так:
use std::fs::File;
fn main() {
let greeting_file = File::open("hello.txt")
.expect("hello.txt should be included in this project");
}expect используется так же, как unwrap: возвращает дескриптор файла или
вызывает макрос panic!. Только сообщением при вызове panic! будет не
стандартный текст, который использует unwrap, а параметр, переданный в
expect. Выглядит это так:
thread 'main' panicked at src/main.rs:5:10:
hello.txt should be included in this project: Os { code: 2, kind: NotFound, message: "No such file or directory" }
В коде продакшен-качества большинство растацеанов выбирают expect, а не
unwrap, и поясняют в сообщении, почему операция должна всегда проходить
успешно. Тогда, если ваши предположения однажды окажутся неверными, при
отладке у вас будет больше информации.
Проброс ошибок
Когда функция вызывает что-то, что может не сработать, ошибку не обязательно обрабатывать внутри самой функции: её можно вернуть вызывающему коду, и пусть он решает, что делать. Это называется пробросом ошибки (propagating). Так у вызывающего кода больше контроля: у него может быть больше информации или логики, определяющей, как обработать ошибку, чем есть в контексте вашего кода.
Например, в листинге 9-6 функция читает имя пользователя из файла. Если файла нет или его не удаётся прочитать, функция вернёт эти ошибки коду, который её вызвал.
#![allow(unused)]
fn main() {
use std::fs::File;
use std::io::{self, Read};
fn read_username_from_file() -> Result<String, io::Error> {
let username_file_result = File::open("hello.txt");
let mut username_file = match username_file_result {
Ok(file) => file,
Err(e) => return Err(e),
};
let mut username = String::new();
match username_file.read_to_string(&mut username) {
Ok(_) => Ok(username),
Err(e) => Err(e),
}
}
}matchЭту функцию можно записать гораздо короче, но сначала мы сделаем многое
вручную, чтобы разобраться в обработке ошибок, а короткий вариант покажем в
конце. Начнём с возвращаемого типа функции: Result<String, io::Error>. Это
значит, что функция возвращает значение типа Result<T, E>, где вместо
обобщённого параметра T подставлен конкретный тип String, а вместо E —
конкретный тип io::Error.
Если функция отработает без проблем, вызывающий код получит значение Ok со
String внутри — именем пользователя (username), которое функция прочитала
из файла. Если возникнут проблемы, вызывающий код получит значение Err с
экземпляром io::Error, в котором есть подробности о проблеме. Мы выбрали
io::Error типом ошибки потому, что именно такой тип ошибки возвращают обе
операции в теле функции, которые могут не сработать: функция File::open и
метод read_to_string.
Тело функции начинается с вызова File::open. Затем мы обрабатываем Result
выражением match, похожим на match из листинга 9-4. Если File::open
сработала, дескриптор файла из переменной образца file становится значением
изменяемой переменной username_file, и функция продолжает работу. В случае
Err вместо panic! мы с помощью return досрочно выходим из функции и
передаём значение ошибки из File::open (теперь оно в переменной образца e)
вызывающему коду как ошибку нашей функции.
Итак, если в username_file есть дескриптор файла, функция создаёт новую
String в переменной username и вызывает у дескриптора username_file метод
read_to_string, чтобы прочитать содержимое файла в username. Метод
read_to_string тоже возвращает Result: он может не сработать, даже если
File::open прошла успешно. Поэтому нужен ещё один match. Если
read_to_string сработал, то и вся функция сработала, и мы возвращаем имя
пользователя из файла, которое теперь лежит в username, обёрнутое в Ok.
Если read_to_string не сработал, возвращаем значение ошибки — так же, как в
match, обрабатывавшем результат File::open. Только писать return явно не
нужно: это последнее выражение в функции.
Код, который вызывает эту функцию, получит либо Ok с именем пользователя,
либо Err с io::Error и сам решит, что с ними делать. Получив Err, он
может, например, вызвать panic! и уронить программу, использовать имя
пользователя по умолчанию или поискать имя пользователя где-то, кроме файла.
Мы не знаем, что именно пытается сделать вызывающий код, поэтому передаём
наверх всю информацию — и об успехе, и об ошибке, — чтобы он обработал её
подходящим образом.
Такой проброс ошибок встречается в Rust настолько часто, что для него есть
специальный оператор — вопросительный знак ?.
Сокращение: оператор ?
В листинге 9-7 — реализация read_username_from_file, которая работает так
же, как в листинге 9-6, но использует оператор ?.
#![allow(unused)]
fn main() {
use std::fs::File;
use std::io::{self, Read};
fn read_username_from_file() -> Result<String, io::Error> {
let mut username_file = File::open("hello.txt")?;
let mut username = String::new();
username_file.read_to_string(&mut username)?;
Ok(username)
}
}?? после значения Result работает почти так же, как выражения match,
которыми мы обрабатывали значения Result в листинге 9-6. Если значение
Result — это Ok, выражение вернёт значение изнутри Ok, и программа
продолжит работу. Если это Err, то Err вернётся из всей функции, как
будто мы написали return, — и ошибка будет проброшена вызывающему коду.
Но между тем, что делает match из листинга 9-6, и тем, что делает оператор
?, есть разница. Значения ошибок, к которым применён ?, проходят через
функцию from из трейта From стандартной библиотеки — она служит для
преобразования значений из одного типа в другой. Когда оператор ? вызывает
from, полученный тип ошибки преобразуется в тип ошибки, указанный в
возвращаемом типе текущей функции. Это удобно, когда функция возвращает один
тип ошибки, описывающий все возможные неудачи, даже если отдельные её части
могут ломаться по самым разным причинам.
Например, функцию read_username_from_file из листинга 9-7 можно изменить так,
чтобы она возвращала наш собственный тип ошибки OurError. Если ещё и
определить impl From<io::Error> for OurError, чтобы создавать OurError из
io::Error, то вызовы оператора ? в теле read_username_from_file сами
вызовут from и преобразуют типы ошибок — без всякого дополнительного кода в
функции.
В листинге 9-7 ? в конце вызова File::open положит значение изнутри Ok в
переменную username_file. Если произойдёт ошибка, оператор ? досрочно
выйдет из всей функции и отдаст значение Err вызывающему коду. То же самое
относится к ? в конце вызова read_to_string.
Оператор ? избавляет от кучи шаблонного кода и упрощает реализацию функции.
Её можно сократить ещё сильнее, если сразу после ? продолжить цепочку
вызовов методов, как в листинге 9-8.
#![allow(unused)]
fn main() {
use std::fs::File;
use std::io::{self, Read};
fn read_username_from_file() -> Result<String, io::Error> {
let mut username = String::new();
File::open("hello.txt")?.read_to_string(&mut username)?;
Ok(username)
}
}?Создание новой String в username мы перенесли в начало функции; сам этот
код остался прежним. Вместо переменной username_file мы вызываем read_to_string
прямо у результата File::open("hello.txt")?. В конце вызова
read_to_string по-прежнему стоит ?, и мы по-прежнему возвращаем Ok с
username, если и File::open, и read_to_string сработали без ошибок.
Функциональность та же, что в листингах 9-6 и 9-7, — просто запись другая,
более удобная.
В листинге 9-9 показано, как сделать ещё короче с помощью
fs::read_to_string.
#![allow(unused)]
fn main() {
use std::fs;
use std::io;
fn read_username_from_file() -> Result<String, io::Error> {
fs::read_to_string("hello.txt")
}
}fs::read_to_string вместо открытия и последующего чтения файлаПрочитать файл в строку — довольно частая операция, поэтому в стандартной
библиотеке есть удобная функция fs::read_to_string: она открывает файл,
создаёт новую String, читает в неё содержимое файла и возвращает её.
Конечно, с fs::read_to_string не получилось бы объяснить всю обработку
ошибок, поэтому сначала мы пошли длинным путём.
Где можно использовать оператор ?
Оператор ? можно использовать только в функциях, возвращаемый тип которых
совместим со значением, к которому применяется ?. Ведь оператор ? досрочно
возвращает значение из функции — так же, как выражение match из листинга
9-6. Там match работал со значением Result, а ветка досрочного выхода
возвращала Err(e). Чтобы такой return был допустим, функция должна
возвращать Result.
В листинге 9-10 посмотрим, какая будет ошибка, если использовать ? в
функции main, возвращаемый тип которой несовместим с типом значения, к
которому применяется ?.
use std::fs::File;
fn main() {
let greeting_file = File::open("hello.txt")?;
}? в функции main, которая возвращает (), не скомпилируетсяЭтот код открывает файл, что может не сработать. Оператор ? стоит после
значения Result, которое вернула File::open, но функция main возвращает
(), а не Result. При компиляции получаем сообщение об ошибке:
$ cargo run
Compiling error-handling v0.1.0 (file:///projects/error-handling)
error[E0277]: the `?` operator can only be used in a function that returns `Result` or `Option` (or another type that implements `FromResidual`)
--> src/main.rs:4:48
|
3 | fn main() {
| --------- this function should return `Result` or `Option` to accept `?`
4 | let greeting_file = File::open("hello.txt")?;
| ^ cannot use the `?` operator in a function that returns `()`
|
help: consider adding return type
|
3 ~ fn main() -> Result<(), Box<dyn std::error::Error>> {
4 | let greeting_file = File::open("hello.txt")?;
5 + Ok(())
|
For more information about this error, try `rustc --explain E0277`.
error: could not compile `error-handling` (bin "error-handling") due to 1 previous error
Ошибка говорит, что оператор ? можно использовать только в функции, которая
возвращает Result, Option или другой тип, реализующий FromResidual.
Исправить это можно двумя способами. Первый — поменять возвращаемый тип
функции на совместимый со значением, к которому применяется ?, если ничто
этому не мешает. Второй — обработать Result<T, E> выражением match или
одним из методов Result<T, E> так, как подходит в вашей ситуации.
В сообщении об ошибке упоминалось, что ? можно применять и к значениям
Option<T>. Как и с Result, использовать ? с Option можно только в
функции, которая возвращает Option. Ведёт себя оператор ? с Option<T>
так же, как с Result<T, E>: если значение — None, в этом месте None
досрочно возвращается из функции. Если Some — значение внутри Some
становится результатом выражения, и функция продолжает работу. В листинге
9-11 пример функции, которая находит последний символ первой строки
переданного текста.
fn last_char_of_first_line(text: &str) -> Option<char> {
text.lines().next()?.chars().last()
}
fn main() {
assert_eq!(
last_char_of_first_line("Hello, world\nHow are you today?"),
Some('d')
);
assert_eq!(last_char_of_first_line(""), None);
assert_eq!(last_char_of_first_line("\nhi"), None);
}? со значением Option<T>Функция возвращает Option<char>, потому что символ там может быть, а может и
не быть. Код берёт аргумент — строковый срез text — и вызывает у него метод
lines, который возвращает итератор по строкам текста. Функции нужна первая
строка, поэтому она вызывает у итератора next и получает первое значение.
Если text — пустая строка, next вернёт None, и тогда ? сразу вернёт
None из last_char_of_first_line. Если text не пустая,
next вернёт значение Some со строковым срезом первой строки text.
? достаёт этот строковый срез, и у него можно вызвать chars, чтобы
получить итератор по символам. Нам нужен последний символ первой строки,
поэтому вызываем last — он возвращает последний элемент итератора. Это тоже
Option, ведь первая строка может оказаться пустой: например, если text
начинается с пустой строки, а символы есть на других строках, как в "\nhi".
Если же последний символ в первой строке есть, он вернётся в варианте Some.
Оператор ? посередине позволяет выразить эту логику кратко и уложить всю
функцию в одну строку. Если бы ? нельзя было применять к Option, пришлось
бы писать больше вызовов методов или выражение match.
Обратите внимание: ? можно применять к Result в функции, которая
возвращает Result, и к Option в функции, которая возвращает Option, но
смешивать их нельзя. Оператор ? не преобразует Result в Option и
наоборот автоматически. Для этого есть методы — например, ok у Result или
ok_or у Option, — с их помощью преобразование делают явно.
До сих пор все наши функции main возвращали (). Функция main особенная:
это точка входа в исполняемую программу и точка выхода из неё, поэтому на её
возвращаемый тип есть ограничения, чтобы программа вела себя как ожидается.
К счастью, main может возвращать и Result<(), E>. В листинге 9-12 — код
из листинга 9-10, но возвращаемый тип main изменён на
Result<(), Box<dyn Error>>, а в конце добавлено возвращаемое значение
Ok(()). Теперь код скомпилируется.
use std::error::Error;
use std::fs::File;
fn main() -> Result<(), Box<dyn Error>> {
let greeting_file = File::open("hello.txt")?;
Ok(())
}main возвращает Result<(), E>, к значениям Result можно применять оператор ?Тип Box<dyn Error> — это трейт-объект; о них мы поговорим в разделе
«Трейт-объекты: абстракция над общим поведением» главы 18. Пока можно читать Box<dyn Error> как «ошибка любого вида».
Применять ? к Result в такой main можно, потому что тип ошибки
Box<dyn Error> позволяет досрочно вернуть из функции любое значение Err. Хотя тело этой main возвращает только ошибки типа std::io::Error,
благодаря Box<dyn Error> сигнатура останется правильной, даже если в тело
main добавить код, возвращающий другие ошибки.
Когда main возвращает Result<(), E>, исполняемый файл завершается с кодом
0, если main вернула Ok(()), и с ненулевым кодом, если main вернула
Err. Исполняемые файлы на C при завершении возвращают целые числа: программы,
завершившиеся успешно, возвращают 0, а завершившиеся с ошибкой — какое-то
другое число. Rust тоже возвращает из исполняемых файлов целые числа, чтобы
соответствовать этому соглашению.
Функция main может возвращать любые типы, реализующие трейт
std::process::Termination. В нём есть функция
report, которая возвращает ExitCode. О том, как реализовать трейт
Termination для своих типов, читайте в документации стандартной библиотеки.
Теперь, когда мы разобрали подробности вызова panic! и возврата Result,
вернёмся к вопросу о том, как решить, что уместнее в том или ином случае.
Паниковать или не паниковать
Паниковать или не паниковать
Как же решить, когда вызывать panic!, а когда возвращать Result? Если код
паникует, восстановиться уже нельзя. Можно вызывать panic! при любой ошибке,
есть ли способ восстановиться или нет, — но тогда вы сами решаете за
вызывающий код, что ситуация неисправима. А возвращая Result, вы даёте
вызывающему коду выбор. Он может попробовать восстановиться так, как
подходит в его ситуации, а может решить, что эта ошибка неисправима, вызвать
panic! и тем самым превратить исправимую ошибку в неисправимую.
Поэтому, если функция может не сработать, возвращать Result — хороший выбор
по умолчанию.
В примерах, прототипах и тестах уместнее писать код, который паникует, а не
возвращает Result. Разберёмся, почему, а потом обсудим ситуации, когда
компилятор не может понять, что ошибка невозможна, а вы как человек — можете.
В конце главы — общие рекомендации о том, когда паниковать в коде
библиотеки.
Примеры, прототипы и тесты
Если вы пишете пример, иллюстрирующий какую-то идею, надёжная обработка
ошибок может сделать его менее понятным. В примерах подразумевается, что
вызов метода вроде unwrap, который может запаниковать, — это заглушка на
месте той обработки ошибок, которую вы захотите сделать в своём приложении. А
она может быть разной в зависимости от того, что делает остальной код.
Точно так же методы unwrap и expect очень удобны при прототипировании,
когда вы ещё не готовы решать, как обрабатывать ошибки. Они оставляют в коде
заметные пометки на тот момент, когда вы будете готовы сделать программу
надёжнее.
Если в тесте не сработал вызов какого-то метода, весь тест должен
провалиться, даже если этот метод — не то, что тестируется. Тест помечается
как проваленный именно через panic!, так что вызов unwrap или expect —
ровно то, что нужно.
Когда вы знаете больше компилятора
Вызывать expect уместно и тогда, когда какая-то логика гарантирует, что в
Result будет Ok, но компилятор этой логики не понимает. Значение Result
всё равно придётся обработать: вызываемая операция в общем случае может не
сработать, даже если в вашей конкретной ситуации это логически невозможно. Если,
проверив код вручную, вы уверены, что варианта Err никогда не будет, вполне
допустимо вызвать expect и объяснить в тексте аргумента, почему Err не
будет. Вот пример:
fn main() {
use std::net::IpAddr;
let home: IpAddr = "127.0.0.1"
.parse()
.expect("Hardcoded IP address should be valid");
}Мы создаём экземпляр IpAddr, разбирая строку, вписанную прямо в код. Мы
видим, что 127.0.0.1 — корректный IP-адрес, поэтому expect здесь допустим.
Но то, что строка задана в коде и корректна, не меняет возвращаемый тип метода
parse: мы всё равно получаем Result, и компилятор всё равно заставит нас
обработать Result так, будто Err возможен, — ему не хватает ума понять,
что эта строка всегда будет корректным IP-адресом. Если бы строка с адресом
приходила от пользователя, а не была вписана в программу, и ошибка была бы
возможна, мы бы, конечно, обработали Result надёжнее. А упоминание в
сообщении, что IP-адрес задан в коде, подскажет нам заменить expect на
нормальную обработку ошибок, если когда-нибудь адрес придётся брать из
другого источника.
Рекомендации по обработке ошибок
Пусть ваш код паникует, если он может оказаться в плохом состоянии. Здесь плохое состояние — это когда нарушено какое-то допущение, гарантия, договор или инвариант: например, в код переданы недопустимые, противоречивые или отсутствующие значения. И при этом выполняется хотя бы одно из условий:
- Плохое состояние неожиданно — в отличие от того, что время от времени наверняка будет случаться, вроде ввода пользователем данных в неправильном формате.
- Код после этой точки должен опираться на то, что плохого состояния нет, а не проверять проблему на каждом шагу.
- Нет хорошего способа выразить эту информацию в используемых типах. Что мы имеем в виду, разберём на примере в разделе «Состояния и поведение как типы» главы 18.
Если кто-то вызывает ваш код и передаёт бессмысленные значения, лучше по
возможности вернуть ошибку, чтобы пользователь библиотеки сам решил, что
делать. Но если продолжать работу небезопасно или вредно, лучше вызвать
panic! и сообщить тому, кто пользуется вашей библиотекой, о баге в его
коде, — чтобы он исправил его ещё на этапе разработки. Точно так же panic!
часто уместен, если вы вызываете внешний код, который вам неподконтролен, и он
возвращает некорректное состояние, исправить которое вы никак не можете.
А вот когда сбой ожидаем, лучше вернуть Result, чем вызывать panic!.
Например, парсер получил некорректные данные или HTTP-запрос вернул статус,
означающий, что вы превысили лимит запросов. В таких случаях Result
показывает, что неудача — ожидаемая возможность, и решать, как её
обработать, должен вызывающий код.
Если ваш код выполняет операцию, которая при недопустимых значениях может
подвергнуть пользователя риску, код должен сначала проверить значения и
запаниковать, если они недопустимы. В основном это нужно ради безопасности:
работа с некорректными данными может открыть уязвимости. Именно поэтому
стандартная библиотека вызывает panic! при попытке обратиться к памяти за
пределами границ: доступ к памяти, которая не принадлежит текущей структуре
данных, — распространённая проблема безопасности. У функций часто есть
договоры (contracts): их поведение гарантировано, только если входные
данные отвечают определённым требованиям. Паниковать при нарушении договора
разумно: нарушение договора всегда означает баг на стороне вызывающего, и это
не та ошибка, которую вызывающий код должен явно обрабатывать. Вызывающий код
всё равно не может разумно восстановиться: исправлять нужно сам код, и сделать
это должен программист, который его написал. Договор функции, особенно если его
нарушение приводит к панике, стоит описывать в документации к её API.
Впрочем, если в каждой функции будет куча проверок на ошибки, код станет
многословным и неприятным. К счастью, многие проверки за вас может сделать
система типов Rust (то есть проверка типов, которую выполняет компилятор).
Если параметр функции имеет определённый тип, можно спокойно писать логику,
зная, что компилятор уже гарантировал корректность значения. Например, если у
вас конкретный тип, а не Option, программа ожидает что-то, а не ничего.
Тогда коду не нужно обрабатывать два случая для вариантов Some и None —
только один, когда значение точно есть. Код, который попытается передать в
вашу функцию «ничего», просто не скомпилируется, так что проверять этот случай
во время выполнения не нужно. Другой пример — беззнаковый целочисленный тип
вроде u32, который гарантирует, что параметр никогда не будет
отрицательным.
Собственные типы для проверки значений
Разовьём идею о том, чтобы гарантировать корректность значения с помощью системы типов Rust, и посмотрим, как создать для проверки собственный тип. Вспомните игру из главы 2, где код просил пользователя угадать число от 1 до 100. Мы ни разу не проверили, что догадка пользователя лежит в этих пределах, прежде чем сравнивать её с загаданным числом, — проверили лишь, что она положительная. Последствия тут не страшные: вывод «Too high» или «Too low» всё равно будет верным. Но было бы полезно подсказывать пользователю, какие догадки допустимы, и по-разному реагировать на число вне диапазона и, скажем, на буквы вместо числа.
Можно, например, разбирать догадку не как u32, а как i32, чтобы допустить
отрицательные числа, а затем добавить проверку, что число в диапазоне:
use std::cmp::Ordering;
use std::io;
use rand::prelude::*;
fn main() {
println!("Guess the number!");
let secret_number = rand::rng().random_range(1..=100);
loop {
// --пропуск--
println!("Please input your guess.");
let mut guess = String::new();
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
let guess: i32 = match guess.trim().parse() {
Ok(num) => num,
Err(_) => continue,
};
if guess < 1 || guess > 100 {
println!("The secret number will be between 1 and 100.");
continue;
}
match guess.cmp(&secret_number) {
// --пропуск--
Ordering::Less => println!("Too small!"),
Ordering::Greater => println!("Too big!"),
Ordering::Equal => {
println!("You win!");
break;
}
}
}
}Выражение if проверяет, не вышло ли значение за пределы диапазона, сообщает
пользователю о проблеме и вызывает continue, чтобы начать следующую
итерацию цикла и попросить новую догадку. После if можно сравнивать guess
с загаданным числом, зная, что guess лежит между 1 и 100.
Но это не идеальное решение. Если программе абсолютно необходимо работать только со значениями от 1 до 100 и таких функций у неё много, повторять проверку в каждой функции утомительно (да и на производительности это может сказаться).
Вместо этого можно создать новый тип в отдельном модуле и поместить проверку
в функцию, создающую экземпляр этого типа, — а не повторять проверку везде.
Тогда функции смогут смело использовать новый тип в своих сигнатурах и
доверять получаемым значениям. В листинге 9-13 показан один из способов
определить тип Guess, экземпляр которого создаётся, только если функция
new получила значение от 1 до 100.
#![allow(unused)]
fn main() {
pub struct Guess {
value: i32,
}
impl Guess {
pub fn new(value: i32) -> Guess {
if value < 1 || value > 100 {
panic!("Guess value must be between 1 and 100, got {value}.");
}
Guess { value }
}
pub fn value(&self) -> i32 {
self.value
}
}
}Guess, который работает только со значениями от 1 до 100Обратите внимание: этот код в src/guessing_game.rs предполагает, что в
src/lib.rs добавлено объявление модуля mod guessing_game; — здесь мы его
не показываем. В файле нового модуля мы определяем структуру Guess с полем
value типа i32. В нём и будет храниться число.
Затем реализуем для Guess ассоциированную функцию new, которая создаёт
значения Guess. Функция new принимает один параметр value типа i32 и
возвращает Guess. Код в её теле проверяет, что value лежит между 1 и 100.
Если проверка не пройдена, мы вызываем panic! — это сообщит программисту,
пишущему вызывающий код, что у него баг, который нужно исправить: создание
Guess со значением value вне диапазона нарушило бы договор, на который
опирается Guess::new. Условия, при которых Guess::new может паниковать,
стоит описать в её публичной документации к API; о соглашениях, как отмечать
в документации возможность panic!, мы поговорим в главе 14. Если же
проверка пройдена, мы создаём новый Guess, записываем в поле value
параметр value и возвращаем Guess.
Дальше мы реализуем метод value, который заимствует self, не принимает
других параметров и возвращает i32. Такие методы иногда называют
геттерами: их задача — получить данные из полей и вернуть их. Этот
публичный метод нужен потому, что поле value структуры Guess приватное. И
важно, чтобы оно было приватным: тогда код, использующий структуру Guess, не
сможет задать value напрямую. Код за пределами модуля guessing_game
обязан создавать экземпляры Guess через функцию Guess::new, и значит, у
Guess никак не может оказаться значения value, не прошедшего проверку в
Guess::new.
Теперь функция, которая принимает или возвращает только числа от 1 до 100,
может объявить в сигнатуре, что принимает или возвращает Guess, а не i32,
и никаких дополнительных проверок в её теле не понадобится.
Итоги
Средства обработки ошибок в Rust помогают писать более надёжный код. Макрос
panic! сигнализирует, что программа оказалась в состоянии, с которым не
может справиться, и позволяет остановить процесс, а не продолжать работу с
некорректными значениями. Перечисление Result с помощью системы типов
показывает, что операции могут завершиться неудачей, от которой код может
восстановиться. Возвращая Result, вы сообщаете вызывающему коду, что ему
нужно обработать и успех, и возможную неудачу. Если
использовать panic! и Result там, где они уместны, код станет надёжнее
перед лицом неизбежных проблем.
Вы увидели, как стандартная библиотека с пользой применяет обобщения в
перечислениях Option и Result. Теперь поговорим о том, как устроены
обобщения и как пользоваться ими в своём коде.
Обобщённые типы, трейты и времена жизни
В любом языке программирования есть инструменты, которые помогают бороться с дублированием. В Rust один из таких инструментов — обобщения (generics): абстрактные заменители конкретных типов или других свойств. Мы можем описать поведение обобщений и их связь с другими обобщениями, не зная, что именно окажется на их месте при компиляции и запуске кода.
Функции могут принимать параметры не конкретного типа вроде i32 или
String, а какого-то обобщённого — точно так же, как они принимают параметры
с заранее неизвестными значениями, чтобы выполнять один и тот же код для
разных значений. На самом деле обобщениями мы уже пользовались: в главе 6 —
Option<T>, в главе 8 — Vec<T> и HashMap<K, V>, в главе 9 —
Result<T, E>. В этой главе вы научитесь определять с помощью обобщений
собственные типы, функции и методы!
Сначала мы вспомним, как вынести код в функцию, чтобы избавиться от дублирования. Затем тем же приёмом сделаем из двух функций, которые отличаются только типами параметров, одну обобщённую. Ещё мы объясним, как использовать обобщённые типы в определениях структур и перечислений.
Потом вы узнаете, как с помощью трейтов описывать поведение обобщённо. Трейты можно сочетать с обобщёнными типами, чтобы обобщённый тип принимал не какой угодно тип, а только такой, у которого есть определённое поведение.
И наконец, мы обсудим времена жизни (lifetimes) — разновидность обобщений, которая сообщает компилятору, как ссылки связаны друг с другом. Времена жизни позволяют дать компилятору достаточно сведений о заимствованных значениях, чтобы он мог убедиться в действительности ссылок в большем числе ситуаций, чем без нашей помощи.
Убираем дублирование, вынося код в функцию
Обобщения позволяют заменить конкретные типы заполнителем, который обозначает сразу много типов, и так избавиться от дублирования кода. Но прежде чем погружаться в синтаксис обобщений, посмотрим, как убрать дублирование без обобщённых типов: вынести код в функцию, заменив конкретные значения заполнителем, обозначающим много значений. А затем тем же приёмом выделим обобщённую функцию! Научившись замечать повторяющийся код, который можно вынести в функцию, вы начнёте замечать и повторяющийся код, где пригодятся обобщения.
Начнём с короткой программы из листинга 10-1, которая находит наибольшее число в списке.
fn main() {
let number_list = vec![34, 50, 25, 100, 65];
let mut largest = &number_list[0];
for number in &number_list {
if number > largest {
largest = number;
}
}
println!("The largest number is {largest}");
assert_eq!(*largest, 100);
}Мы храним список целых чисел в переменной number_list и кладём ссылку на
первое число списка в переменную largest. Затем перебираем все числа
списка, и если текущее число больше того, на которое указывает largest,
заменяем ссылку в этой переменной. Если же текущее число меньше или равно
наибольшему из встреченных, переменная не меняется, и код переходит к
следующему числу. Когда все числа перебраны, largest указывает на наибольшее
— в нашем случае на 100.
Теперь нам поручили найти наибольшее число в двух разных списках. Можно скопировать код из листинга 10-1 и использовать ту же логику в двух местах программы, как в листинге 10-2.
fn main() {
let number_list = vec![34, 50, 25, 100, 65];
let mut largest = &number_list[0];
for number in &number_list {
if number > largest {
largest = number;
}
}
println!("The largest number is {largest}");
let number_list = vec![102, 34, 6000, 89, 54, 2, 43, 8];
let mut largest = &number_list[0];
for number in &number_list {
if number > largest {
largest = number;
}
}
println!("The largest number is {largest}");
}Этот код работает, но копировать код утомительно, и легко ошибиться. К тому же при любом изменении придётся не забыть обновить код в нескольких местах.
Чтобы избавиться от дублирования, создадим абстракцию — функцию, которая работает с любым списком целых чисел, переданным ей параметром. Так код станет понятнее, а идея «найти наибольшее число в списке» будет выражена абстрактно.
В листинге 10-3 мы выносим код поиска наибольшего числа в функцию largest.
Затем вызываем её, чтобы найти наибольшее число в двух списках из листинга
10-2. Эту функцию можно будет применить и к любому другому списку значений
i32, который может появиться в будущем.
fn largest(list: &[i32]) -> &i32 {
let mut largest = &list[0];
for item in list {
if item > largest {
largest = item;
}
}
largest
}
fn main() {
let number_list = vec![34, 50, 25, 100, 65];
let result = largest(&number_list);
println!("The largest number is {result}");
assert_eq!(*result, 100);
let number_list = vec![102, 34, 6000, 89, 54, 2, 43, 8];
let result = largest(&number_list);
println!("The largest number is {result}");
assert_eq!(*result, 6000);
}У функции largest есть параметр list — любой конкретный срез значений
i32, который мы можем передать в функцию. Поэтому при вызове функции код
выполняется для тех конкретных значений, которые мы передали.
Подведём итог: чтобы превратить код из листинга 10-2 в код из листинга 10-3, мы сделали следующее:
- Нашли повторяющийся код.
- Перенесли повторяющийся код в тело функции, а в сигнатуре функции указали, что этот код принимает на вход и что возвращает.
- Заменили оба места с повторяющимся кодом вызовами функции.
Дальше мы проделаем те же шаги, но уже с обобщениями. Точно так же, как тело
функции может работать с абстрактным list вместо конкретных значений,
обобщения позволяют коду работать с абстрактными типами.
Допустим, у нас две функции: одна находит наибольший элемент в срезе значений
i32, а другая — в срезе значений char. Как избавиться от такого
дублирования? Давайте выясним!
Обобщённые типы данных
Обобщённые типы данных
С помощью обобщений мы создаём определения — например, сигнатуры функций или структуры, — которые потом можно использовать с множеством разных конкретных типов данных. Сначала посмотрим, как определять с обобщениями функции, структуры, перечисления и методы. А потом обсудим, как обобщения влияют на производительность кода.
В определениях функций
Определяя функцию с обобщениями, мы ставим их в сигнатуру — туда, где обычно указываются типы параметров и возвращаемого значения. Так код становится гибче и даёт вызывающему больше возможностей, а дублирования при этом нет.
Продолжим с функцией largest. В листинге 10-4 две функции, каждая из которых
находит наибольшее значение в срезе. Затем мы объединим их в одну обобщённую
функцию.
fn largest_i32(list: &[i32]) -> &i32 {
let mut largest = &list[0];
for item in list {
if item > largest {
largest = item;
}
}
largest
}
fn largest_char(list: &[char]) -> &char {
let mut largest = &list[0];
for item in list {
if item > largest {
largest = item;
}
}
largest
}
fn main() {
let number_list = vec![34, 50, 25, 100, 65];
let result = largest_i32(&number_list);
println!("The largest number is {result}");
assert_eq!(*result, 100);
let char_list = vec!['y', 'm', 'a', 'q'];
let result = largest_char(&char_list);
println!("The largest char is {result}");
assert_eq!(*result, 'y');
}Функция largest_i32 — та самая, что мы выделили в листинге 10-3: она
находит наибольшее i32 в срезе. Функция largest_char находит наибольший
char в срезе. Тела у функций одинаковые, так что избавимся от
дублирования, введя в единственную функцию обобщённый параметр типа.
Чтобы параметризовать типы в новой функции, нужно дать имя параметру типа —
так же, как мы даём имена параметрам-значениям. Именем параметра типа может
быть любой идентификатор. Но мы возьмём T: по соглашению имена параметров
типа в Rust короткие, часто из одной буквы, а типы в Rust называют в стиле
UpperCamelCase. T — сокращение от type (тип), и большинство программистов
на Rust выбирают именно его.
Когда мы используем параметр в теле функции, его имя нужно объявить в
сигнатуре, чтобы компилятор знал, что оно означает. Точно так же, прежде чем
использовать в сигнатуре имя параметра типа, его нужно объявить. Чтобы
определить обобщённую функцию largest, объявления имён типов ставят в
угловых скобках <> между именем функции и списком параметров:
fn largest<T>(list: &[T]) -> &T {Читается это так: «функция largest обобщена по некоторому типу T». У неё
один параметр list — срез значений типа T. Функция largest вернёт
ссылку на значение того же типа T.
В листинге 10-5 — объединённое определение функции largest с обобщённым
типом данных в сигнатуре. Там же показано, как вызывать функцию и со срезом
значений i32, и со срезом значений char. Учтите, что этот код пока не
компилируется.
fn largest<T>(list: &[T]) -> &T {
let mut largest = &list[0];
for item in list {
if item > largest {
largest = item;
}
}
largest
}
fn main() {
let number_list = vec![34, 50, 25, 100, 65];
let result = largest(&number_list);
println!("The largest number is {result}");
let char_list = vec!['y', 'm', 'a', 'q'];
let result = largest(&char_list);
println!("The largest char is {result}");
}largest с обобщёнными параметрами типа; пока не компилируетсяЕсли скомпилировать этот код сейчас, получим ошибку:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0369]: binary operation `>` cannot be applied to type `&T`
--> src/main.rs:5:17
|
5 | if item > largest {
| ---- ^ ------- &T
| |
| &T
|
help: consider restricting type parameter `T` with trait `PartialOrd`
|
1 | fn largest<T: std::cmp::PartialOrd>(list: &[T]) -> &T {
| ++++++++++++++++++++++
For more information about this error, try `rustc --explain E0369`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
В подсказке упоминается std::cmp::PartialOrd — это трейт, о трейтах мы
поговорим в следующем разделе. Пока достаточно понимать, что ошибка говорит:
тело largest будет работать не со всеми типами, которыми может оказаться
T. Мы хотим сравнивать в теле функции значения типа T, а значит, годятся
только типы, значения которых можно упорядочить. Для сравнения в стандартной
библиотеке есть трейт std::cmp::PartialOrd, который можно реализовать для
типов (подробнее о нём — в приложении C). Чтобы исправить листинг 10-5, можно
последовать подсказке и ограничить допустимые для T типы теми, что
реализуют PartialOrd. Тогда код скомпилируется: стандартная библиотека
реализует PartialOrd и для i32, и для char.
В определениях структур
Структуры тоже можно определять так, чтобы одно или несколько полей имели
обобщённый тип, — с помощью того же синтаксиса <>. В листинге 10-6
определена структура Point<T>, которая хранит координаты x и y любого
типа.
struct Point<T> {
x: T,
y: T,
}
fn main() {
let integer = Point { x: 5, y: 10 };
let float = Point { x: 1.0, y: 4.0 };
}Point<T> со значениями x и y типа TСинтаксис обобщений в определениях структур похож на синтаксис в определениях функций. Сначала объявляем имя параметра типа в угловых скобках сразу после имени структуры. Затем используем обобщённый тип в определении структуры там, где иначе указали бы конкретные типы данных.
Обратите внимание: раз в определении Point<T> только один обобщённый тип,
это определение говорит, что структура Point<T> обобщена по некоторому типу
T, и поля x и y — оба этого типа, каким бы он ни был. Если создать
экземпляр Point<T> со значениями разных типов, как в листинге 10-7, код не
скомпилируется.
struct Point<T> {
x: T,
y: T,
}
fn main() {
let wont_work = Point { x: 5, y: 4.0 };
}x и y должны быть одного типа, потому что у обоих один и тот же обобщённый тип TПрисваивая x целое число 5, мы сообщаем компилятору, что для этого
экземпляра Point<T> обобщённый тип T — целое число. А когда для y,
которое по определению того же типа, что и x, мы указываем 4.0, получаем
ошибку несовпадения типов:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0308]: mismatched types
--> src/main.rs:7:38
|
7 | let wont_work = Point { x: 5, y: 4.0 };
| ^^^ expected integer, found floating-point number
For more information about this error, try `rustc --explain E0308`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
Чтобы определить структуру Point, где и x, и y обобщённые, но могут быть
разных типов, можно использовать несколько обобщённых параметров типа.
Например, в листинге 10-8 мы делаем Point обобщённой по типам T и U:
x имеет тип T, а y — тип U.
struct Point<T, U> {
x: T,
y: U,
}
fn main() {
let both_integer = Point { x: 5, y: 10 };
let both_float = Point { x: 1.0, y: 4.0 };
let integer_and_float = Point { x: 5, y: 4.0 };
}Point<T, U> обобщена по двум типам, поэтому x и y могут быть значениями разных типовТеперь допустимы все показанные экземпляры Point! Обобщённых параметров
типа в определении может быть сколько угодно, но если их больше нескольких,
код становится трудно читать. Если вам нужно много обобщённых типов, возможно,
код стоит разбить на части поменьше.
В определениях перечислений
Как и структуры, перечисления можно определять так, чтобы их варианты хранили
обобщённые типы данных. Ещё раз взглянем на перечисление Option<T> из
стандартной библиотеки, которым мы пользовались в главе 6:
#![allow(unused)]
fn main() {
enum Option<T> {
Some(T),
None,
}
}Теперь это определение должно быть вам понятнее. Перечисление Option<T>
обобщено по типу T, и у него два варианта: Some, который хранит одно
значение типа T, и None, который не хранит ничего. С помощью Option<T>
можно выразить абстрактную идею необязательного значения, а раз Option<T>
обобщённое, этой абстракцией можно пользоваться, какого бы типа ни было
необязательное значение.
Перечисления тоже могут использовать несколько обобщённых типов. Пример —
определение перечисления Result, которым мы пользовались в главе 9:
#![allow(unused)]
fn main() {
enum Result<T, E> {
Ok(T),
Err(E),
}
}Перечисление Result обобщено по двум типам, T и E, и у него два
варианта: Ok, который хранит значение типа T, и Err, который хранит
значение типа E. Благодаря этому Result удобно использовать везде, где
операция может завершиться успехом (вернуть значение некоторого типа T) или
неудачей (вернуть ошибку некоторого типа E). Именно так мы открывали файл в
листинге 9-3: при успешном открытии вместо T был тип std::fs::File, а при
проблемах с открытием вместо E был тип std::io::Error.
Если вы замечаете в коде несколько определений структур или перечислений, которые отличаются только типами хранимых значений, дублирования можно избежать с помощью обобщённых типов.
В определениях методов
Для структур и перечислений можно реализовывать методы (как мы делали в главе
5) и использовать в их определениях обобщённые типы. В листинге 10-9 —
структура Point<T> из листинга 10-6, для которой реализован метод x.
struct Point<T> {
x: T,
y: T,
}
impl<T> Point<T> {
fn x(&self) -> &T {
&self.x
}
}
fn main() {
let p = Point { x: 5, y: 10 };
println!("p.x = {}", p.x());
}Point<T> метод x, который возвращает ссылку на поле x типа TЗдесь мы определили для Point<T> метод x, который возвращает ссылку на
данные в поле x.
Обратите внимание: T нужно объявить сразу после impl, чтобы с его помощью
указать, что мы реализуем методы для типа Point<T>. Объявив T обобщённым
типом после impl, мы даём Rust понять, что тип в угловых скобках у Point —
обобщённый, а не конкретный. Этому обобщённому параметру можно было дать и
другое имя, не такое, как в определении структуры, но по соглашению имя
используют то же. Метод, написанный внутри impl с объявленным обобщённым
типом, будет определён для любого экземпляра типа — какой бы конкретный тип
ни подставился вместо обобщённого.
Определяя методы для типа, можно также накладывать ограничения на
обобщённые типы. Например, можно реализовать методы только для экземпляров
Point<f32>, а не для Point<T> с любым обобщённым типом. В листинге 10-10
используется конкретный тип f32, поэтому после impl никаких типов мы не
объявляем.
struct Point<T> {
x: T,
y: T,
}
impl<T> Point<T> {
fn x(&self) -> &T {
&self.x
}
}
impl Point<f32> {
fn distance_from_origin(&self) -> f32 {
(self.x.powi(2) + self.y.powi(2)).sqrt()
}
}
fn main() {
let p = Point { x: 5, y: 10 };
println!("p.x = {}", p.x());
}impl, который применяется только к структуре с определённым конкретным типом вместо обобщённого параметра TЭтот код означает, что у типа Point<f32> будет метод
distance_from_origin, а у остальных экземпляров Point<T>, где T — не
f32, такого метода не будет. Метод вычисляет, насколько наша точка удалена
от точки с координатами (0.0, 0.0), и использует математические операции,
доступные только для типов с плавающей точкой.
Обобщённые параметры типа в определении структуры не всегда совпадают с теми,
что используются в сигнатурах её методов. В листинге 10-11 для структуры
Point используются обобщённые типы X1 и Y1, а для сигнатуры метода
mixup — X2 и Y2, чтобы пример был нагляднее. Метод создаёт новый
экземпляр Point, взяв значение x из Point в self (типа X1) и значение
y из переданного Point (типа Y2).
struct Point<X1, Y1> {
x: X1,
y: Y1,
}
impl<X1, Y1> Point<X1, Y1> {
fn mixup<X2, Y2>(self, other: Point<X2, Y2>) -> Point<X1, Y2> {
Point {
x: self.x,
y: other.y,
}
}
}
fn main() {
let p1 = Point { x: 5, y: 10.4 };
let p2 = Point { x: "Hello", y: 'c' };
let p3 = p1.mixup(p2);
println!("p3.x = {}, p3.y = {}", p3.x, p3.y);
}В main мы определили Point, у которой x — i32 (со значением 5), а y
— f64 (со значением 10.4). Переменная p2 — структура Point, у которой x
— строковый срез (со значением "Hello"), а y — char (со значением c).
Вызов mixup у p1 с аргументом p2 даёт p3, у которой x будет i32,
потому что x взят из p1, а y — char, потому что y взят из p2.
Макрос println! выведет p3.x = 5, p3.y = c.
Этот пример показывает ситуацию, когда часть обобщённых параметров
объявляется в impl, а часть — в определении метода. Здесь X1 и Y1
объявлены после impl, потому что относятся к определению структуры. А X2
и Y2 объявлены после fn mixup, потому что нужны только этому методу.
Производительность кода с обобщениями
Возможно, вас интересует, не стоят ли обобщённые параметры типа чего-то во время выполнения. Хорошая новость: с обобщёнными типами программа работает ничуть не медленнее, чем с конкретными.
Rust добивается этого с помощью мономорфизации кода с обобщениями при компиляции. Мономорфизация (monomorphization) — это превращение обобщённого кода в конкретный путём подстановки тех конкретных типов, которые используются при компиляции. При этом компилятор делает обратное тому, что мы делали, создавая обобщённую функцию в листинге 10-5: он смотрит на все места, где вызывается обобщённый код, и генерирует код для конкретных типов, с которыми его вызывают.
Посмотрим, как это работает, на примере обобщённого перечисления Option<T>
из стандартной библиотеки:
#![allow(unused)]
fn main() {
let integer = Some(5);
let float = Some(5.0);
}Компилируя этот код, Rust выполняет мономорфизацию. Компилятор читает
значения, использованные в экземплярах Option<T>, и находит два вида
Option<T>: с i32 и с f64. Поэтому он разворачивает обобщённое
определение Option<T> в два определения, специализированных для i32 и
f64, и заменяет ими обобщённое.
Мономорфизированная версия кода выглядит примерно так (компилятор использует другие имена — эти мы взяли для наглядности):
enum Option_i32 {
Some(i32),
None,
}
enum Option_f64 {
Some(f64),
None,
}
fn main() {
let integer = Option_i32::Some(5);
let float = Option_f64::Some(5.0);
}Обобщённый Option<T> заменяется конкретными определениями, которые создал
компилятор. Rust компилирует обобщённый код в код, где для каждого случая
указан конкретный тип, поэтому за обобщения мы ничего не платим во время
выполнения. Работающий код ведёт себя так же быстро, как если бы мы
продублировали каждое определение вручную. Благодаря мономорфизации обобщения
в Rust чрезвычайно эффективны во время выполнения.
Трейты: общее поведение
Трейты: общее поведение
Трейт (trait) описывает функциональность, которая может быть общей для нескольких типов. С помощью трейтов можно абстрактно описывать общее поведение. А с помощью ограничений трейтами (trait bounds) можно указать, что обобщённый тип — это любой тип с определённым поведением.
Примечание: трейты похожи на то, что в других языках часто называют интерфейсами, хотя есть и отличия.
Определение трейта
Поведение типа — это методы, которые можно у него вызвать. Разные типы ведут себя одинаково, если у всех этих типов можно вызвать одни и те же методы. Определение трейта — способ собрать вместе сигнатуры методов и описать набор поведения, необходимый для какой-то цели.
Допустим, у нас есть несколько структур, хранящих текст разного вида и объёма:
структура NewsArticle хранит новостную заметку из определённого места, а
SocialPost — пост длиной не больше 280 символов плюс метаданные: новый ли
это пост, репост или ответ на другой пост.
Мы хотим сделать библиотечный крейт aggregator — агрегатор медиа, который
умеет показывать краткое изложение (summary) данных из экземпляра
NewsArticle или SocialPost. Для этого от каждого типа нам нужно краткое
изложение, и получать его мы будем, вызывая у экземпляра метод summarize. В
листинге 10-12 определён публичный трейт Summary, который выражает это
поведение.
pub trait Summary {
fn summarize(&self) -> String;
}Summary, поведение которого задаёт метод summarizeТрейт объявляется ключевым словом trait и именем трейта — здесь Summary.
Ещё мы объявляем трейт как pub, чтобы им могли пользоваться и крейты,
которые зависят от нашего, — это мы увидим в паре примеров. В фигурных скобках
объявляются сигнатуры методов, описывающие поведение типов, которые реализуют
трейт, — в нашем случае fn summarize(&self) -> String.
После сигнатуры метода вместо реализации в фигурных скобках стоит точка с
запятой. Каждый тип, реализующий этот трейт, должен сам задать тело метода —
своё поведение. Компилятор проследит, чтобы у любого типа с трейтом Summary
был определён метод summarize ровно с такой сигнатурой.
Методов в трейте может быть несколько: их сигнатуры перечисляются по одной на строку, и каждая строка заканчивается точкой с запятой.
Реализация трейта для типа
Мы определили нужные сигнатуры методов трейта Summary и теперь можем
реализовать его для типов нашего агрегатора. В листинге 10-13 — реализация
трейта Summary для структуры NewsArticle: метод summarize собирает
возвращаемое значение из заголовка, автора и места. А для структуры
SocialPost метод summarize возвращает имя пользователя и весь текст поста
— считаем, что содержимое поста и так ограничено 280 символами.
pub trait Summary {
fn summarize(&self) -> String;
}
pub struct NewsArticle {
pub headline: String,
pub location: String,
pub author: String,
pub content: String,
}
impl Summary for NewsArticle {
fn summarize(&self) -> String {
format!("{}, by {} ({})", self.headline, self.author, self.location)
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize(&self) -> String {
format!("{}: {}", self.username, self.content)
}
}Summary для типов NewsArticle и SocialPostРеализация трейта для типа похожа на реализацию обычных методов. Разница в
том, что после impl пишется имя реализуемого трейта, затем ключевое слово
for, а затем имя типа, для которого реализуется трейт. Внутри блока impl
пишутся сигнатуры методов из определения трейта. Только вместо точки с
запятой после каждой сигнатуры ставятся фигурные скобки, а в них — тело
метода: то конкретное поведение, которое методы трейта должны иметь для
этого типа.
Теперь, когда библиотека реализовала трейт Summary для NewsArticle и
SocialPost, пользователи крейта могут вызывать методы трейта у экземпляров
NewsArticle и SocialPost так же, как обычные методы. Единственное отличие:
пользователю нужно подключить в область видимости не только типы, но и сам
трейт. Вот пример того, как бинарный крейт мог бы использовать наш
библиотечный крейт aggregator:
use aggregator::{SocialPost, Summary};
fn main() {
let post = SocialPost {
username: String::from("horse_ebooks"),
content: String::from(
"of course, as you probably already know, people",
),
reply: false,
repost: false,
};
println!("1 new post: {}", post.summarize());
}Этот код выведет 1 new post: horse_ebooks: of course, as you probably already know, people.
Другие крейты, зависящие от aggregator, тоже могут подключить трейт
Summary и реализовать его для своих типов. Есть одно ограничение: реализовать
трейт для типа можно, только если трейт, тип или оба они локальны для нашего
крейта. Например, мы можем реализовать трейты стандартной библиотеки, вроде
Display, для собственного типа вроде SocialPost в рамках крейта
aggregator, потому что тип SocialPost локален для нашего крейта. Можем мы
реализовать и Summary для Vec<T> в крейте aggregator, потому что
локален трейт Summary.
А вот реализовать внешний трейт для внешнего типа нельзя. Например, нельзя в
крейте aggregator реализовать трейт Display для Vec<T>: и Display, и
Vec<T> определены в стандартной библиотеке и не локальны для нашего крейта.
Это ограничение — часть свойства под названием согласованность
(coherence), а конкретнее — так называемое правило сироты (orphan rule):
реализация оказывается «сиротой», потому что ни трейт, ни тип не принадлежат
нашему крейту. Это правило гарантирует, что чужой
код не сломает ваш, и наоборот. Без него два крейта могли бы реализовать один
и тот же трейт для одного и того же типа, и Rust не знал бы, какую реализацию
использовать.
Реализации по умолчанию
Иногда удобно, чтобы у некоторых или у всех методов трейта было поведение по умолчанию, а не требовать реализации всех методов для каждого типа. Тогда, реализуя трейт для конкретного типа, можно оставить поведение каждого метода по умолчанию или переопределить его.
В листинге 10-14 мы задаём для метода summarize трейта Summary строку по
умолчанию, а не только сигнатуру, как в листинге 10-12.
pub trait Summary {
fn summarize(&self) -> String {
String::from("(Read more...)")
}
}
pub struct NewsArticle {
pub headline: String,
pub location: String,
pub author: String,
pub content: String,
}
impl Summary for NewsArticle {}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize(&self) -> String {
format!("{}: {}", self.username, self.content)
}
}Summary с реализацией метода summarize по умолчаниюЧтобы экземпляры NewsArticle использовали реализацию по умолчанию, пишем
пустой блок impl: impl Summary for NewsArticle {}.
Мы больше не определяем summarize для NewsArticle напрямую. Но у этого
метода есть реализация по умолчанию, а NewsArticle, как мы указали,
реализует трейт Summary. Поэтому метод summarize у экземпляра NewsArticle
по-прежнему можно вызвать:
use aggregator::{self, NewsArticle, Summary};
fn main() {
let article = NewsArticle {
headline: String::from("Penguins win the Stanley Cup Championship!"),
location: String::from("Pittsburgh, PA, USA"),
author: String::from("Iceburgh"),
content: String::from(
"The Pittsburgh Penguins once again are the best \
hockey team in the NHL.",
),
};
println!("New article available! {}", article.summarize());
}Этот код выведет New article available! (Read more...).
Появление реализации по умолчанию не требует ничего менять в реализации
Summary для SocialPost из листинга 10-13. Дело в том, что синтаксис
переопределения реализации по умолчанию такой же, как синтаксис реализации
метода трейта, у которого реализации по умолчанию нет.
Реализации по умолчанию могут вызывать другие методы того же трейта, даже
если у тех нет реализации по умолчанию. Так трейт может давать много полезной
функциональности, требуя от реализующих типов лишь малую её часть. Например,
можно определить в трейте Summary метод summarize_author, реализация
которого обязательна, и метод summarize с реализацией по умолчанию, которая
вызывает summarize_author:
pub trait Summary {
fn summarize_author(&self) -> String;
fn summarize(&self) -> String {
format!("(Read more from {}...)", self.summarize_author())
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize_author(&self) -> String {
format!("@{}", self.username)
}
}Чтобы пользоваться такой версией Summary, при реализации трейта для типа
достаточно определить summarize_author:
pub trait Summary {
fn summarize_author(&self) -> String;
fn summarize(&self) -> String {
format!("(Read more from {}...)", self.summarize_author())
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize_author(&self) -> String {
format!("@{}", self.username)
}
}Определив summarize_author, можно вызывать summarize у экземпляров
структуры SocialPost, и реализация summarize по умолчанию вызовет нашу
реализацию summarize_author. Мы реализовали summarize_author — и трейт
Summary дал нам поведение метода summarize без единой лишней строчки кода.
Вот как это выглядит:
use aggregator::{self, SocialPost, Summary};
fn main() {
let post = SocialPost {
username: String::from("horse_ebooks"),
content: String::from(
"of course, as you probably already know, people",
),
reply: false,
repost: false,
};
println!("1 new post: {}", post.summarize());
}Этот код выведет 1 new post: (Read more from @horse_ebooks...).
Учтите: вызвать реализацию по умолчанию из переопределяющей реализации того же метода нельзя.
Трейты как параметры
Теперь, когда вы умеете определять и реализовывать трейты, посмотрим, как с их
помощью определять функции, которые принимают значения множества разных
типов. Воспользуемся трейтом Summary, который мы реализовали для типов
NewsArticle и SocialPost в листинге 10-13, и определим функцию notify,
которая вызывает метод summarize у своего параметра item — значения
некоторого типа, реализующего трейт Summary. Для этого используется
синтаксис impl Trait:
pub trait Summary {
fn summarize(&self) -> String;
}
pub struct NewsArticle {
pub headline: String,
pub location: String,
pub author: String,
pub content: String,
}
impl Summary for NewsArticle {
fn summarize(&self) -> String {
format!("{}, by {} ({})", self.headline, self.author, self.location)
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize(&self) -> String {
format!("{}: {}", self.username, self.content)
}
}
pub fn notify(item: &impl Summary) {
println!("Breaking news! {}", item.summarize());
}Вместо конкретного типа параметра item мы пишем ключевое слово impl и имя
трейта. Такой параметр принимает любой тип, реализующий указанный трейт. В
теле notify у item можно вызывать любые методы трейта Summary, например
summarize. Вызвать notify можно с любым экземпляром NewsArticle или
SocialPost. А код, который вызовет функцию с любым другим типом, например
String или i32, не скомпилируется: эти типы не реализуют Summary.
Синтаксис ограничений трейтами
Синтаксис impl Trait хорош в простых случаях, но на самом деле это
синтаксический сахар для более длинной формы — ограничения трейтом (trait
bound). Выглядит она так:
pub fn notify<T: Summary>(item: &T) {
println!("Breaking news! {}", item.summarize());
}Эта длинная форма равнозначна примеру из предыдущего раздела, просто многословнее. Ограничения трейтами пишут вместе с объявлением обобщённого параметра типа — после двоеточия, внутри угловых скобок.
Синтаксис impl Trait удобен и в простых случаях даёт более лаконичный код, а
полный синтаксис ограничений трейтами позволяет выразить более сложные вещи.
Например, пусть у функции два параметра, реализующих Summary. С impl Trait
это выглядит так:
pub fn notify(item1: &impl Summary, item2: &impl Summary) {impl Trait подходит, если мы допускаем, что у item1 и item2 могут быть
разные типы (лишь бы оба реализовывали Summary). А если мы хотим, чтобы оба
параметра были одного типа, нужно ограничение трейтом:
pub fn notify<T: Summary>(item1: &T, item2: &T) {Обобщённый тип T, указанный типом обоих параметров item1 и item2,
требует, чтобы значения, переданные аргументами в item1 и item2, были
одного и того же конкретного типа.
Несколько ограничений через +
Ограничений трейтами можно указать несколько. Допустим, в notify мы хотим
использовать для item и форматирование для вывода, и summarize: тогда в
определении notify укажем, что item должен реализовывать и Display, и
Summary. Делается это через +:
pub fn notify(item: &(impl Summary + Display)) {+ работает и с ограничениями обобщённых типов:
pub fn notify<T: Summary + Display>(item: &T) {С двумя ограничениями тело notify может и вызывать summarize, и
форматировать item через {}.
Понятнее с where
У слишком большого числа ограничений трейтами есть недостатки. У каждого
обобщения свои ограничения, поэтому в функциях с несколькими обобщёнными
параметрами между именем функции и списком параметров может скопиться масса
информации об ограничениях, и сигнатуру станет трудно читать. Поэтому в Rust
есть альтернативный синтаксис: ограничения можно указать в конструкции where
после сигнатуры функции. Вместо такого:
fn some_function<T: Display + Clone, U: Clone + Debug>(t: &T, u: &U) -> i32 {можно написать так:
fn some_function<T, U>(t: &T, u: &U) -> i32
where
T: Display + Clone,
U: Clone + Debug,
{
unimplemented!()
}Сигнатура этой функции не так загромождена: имя функции, список параметров и возвращаемый тип стоят рядом, как у функции без кучи ограничений трейтами.
Возврат типов, реализующих трейты
Синтаксис impl Trait можно использовать и на месте возвращаемого типа, чтобы
вернуть значение некоторого типа, реализующего трейт:
pub trait Summary {
fn summarize(&self) -> String;
}
pub struct NewsArticle {
pub headline: String,
pub location: String,
pub author: String,
pub content: String,
}
impl Summary for NewsArticle {
fn summarize(&self) -> String {
format!("{}, by {} ({})", self.headline, self.author, self.location)
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize(&self) -> String {
format!("{}: {}", self.username, self.content)
}
}
fn returns_summarizable() -> impl Summary {
SocialPost {
username: String::from("horse_ebooks"),
content: String::from(
"of course, as you probably already know, people",
),
reply: false,
repost: false,
}
}Указав возвращаемым типом impl Summary, мы говорим, что функция
returns_summarizable возвращает некий тип, реализующий трейт Summary, не
называя конкретный тип. Здесь returns_summarizable возвращает SocialPost,
но вызывающему коду знать об этом не нужно.
Возможность указать возвращаемый тип только через трейт, который он
реализует, особенно полезна в контексте замыканий и итераторов — о них мы
поговорим в главе 13. Замыкания и итераторы создают типы, которые знает
только компилятор, или типы, которые очень долго выписывать. Синтаксис
impl Trait позволяет коротко сказать, что функция возвращает некий тип,
реализующий трейт Iterator, не выписывая очень длинный тип.
Но использовать impl Trait можно, только если возвращается один-единственный
тип. Например, этот код, который возвращает либо NewsArticle, либо
SocialPost, а возвращаемым типом указывает impl Summary, работать не будет:
pub trait Summary {
fn summarize(&self) -> String;
}
pub struct NewsArticle {
pub headline: String,
pub location: String,
pub author: String,
pub content: String,
}
impl Summary for NewsArticle {
fn summarize(&self) -> String {
format!("{}, by {} ({})", self.headline, self.author, self.location)
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize(&self) -> String {
format!("{}: {}", self.username, self.content)
}
}
fn returns_summarizable(switch: bool) -> impl Summary {
if switch {
NewsArticle {
headline: String::from(
"Penguins win the Stanley Cup Championship!",
),
location: String::from("Pittsburgh, PA, USA"),
author: String::from("Iceburgh"),
content: String::from(
"The Pittsburgh Penguins once again are the best \
hockey team in the NHL.",
),
}
} else {
SocialPost {
username: String::from("horse_ebooks"),
content: String::from(
"of course, as you probably already know, people",
),
reply: false,
repost: false,
}
}
}Возвращать то NewsArticle, то SocialPost нельзя из-за ограничений того, как
синтаксис impl Trait реализован в компиляторе. Как написать функцию с таким
поведением, мы разберём в разделе «Трейт-объекты: абстракция над общим
поведением» главы 18.
Условная реализация методов с ограничениями трейтами
Если в блоке impl с обобщёнными параметрами типа использовать ограничения
трейтами, можно реализовать методы условно — только для типов, реализующих
указанные трейты. Например, у типа Pair<T> из листинга 10-15 функция new,
возвращающая новый экземпляр Pair<T>, реализована всегда (напомним из
раздела «Синтаксис методов» главы 5, что Self —
псевдоним типа блока impl, в данном случае Pair<T>). А вот в следующем
блоке impl метод cmp_display реализован для Pair<T>, только если
внутренний тип T реализует трейт PartialOrd, позволяющий сравнивать, и
трейт Display, позволяющий выводить.
use std::fmt::Display;
struct Pair<T> {
x: T,
y: T,
}
impl<T> Pair<T> {
fn new(x: T, y: T) -> Self {
Self { x, y }
}
}
impl<T: Display + PartialOrd> Pair<T> {
fn cmp_display(&self) {
if self.x >= self.y {
println!("The largest member is x = {}", self.x);
} else {
println!("The largest member is y = {}", self.y);
}
}
}Условно можно реализовать и трейт — для любого типа, который реализует другой
трейт. Реализации трейта для любого типа, удовлетворяющего ограничениям,
называются обобщёнными реализациями (blanket implementations), и в
стандартной библиотеке Rust они используются повсеместно. Например,
стандартная библиотека реализует трейт ToString для любого типа, который
реализует трейт Display. Блок impl в стандартной библиотеке выглядит
примерно так:
impl<T: Display> ToString for T {
// --snip--
}Благодаря этой обобщённой реализации у любого типа, реализующего Display,
можно вызвать метод to_string из трейта ToString. Например, так можно
превратить целое число в соответствующее значение String — ведь целые числа
реализуют Display:
#![allow(unused)]
fn main() {
let s = 3.to_string();
}Обобщённые реализации перечислены в документации трейта в разделе «Implementors».
Трейты и ограничения трейтами позволяют писать код с обобщёнными параметрами типа, избавляясь от дублирования, и при этом сообщать компилятору, что у обобщённого типа должно быть определённое поведение. Компилятор по информации из ограничений проверяет, что все конкретные типы, с которыми используется наш код, ведут себя правильно. В динамически типизированных языках мы получили бы ошибку во время выполнения, вызвав у типа метод, которого у него нет. Rust переносит такие ошибки на этап компиляции, и исправить проблемы приходится ещё до того, как код вообще сможет запуститься. Кроме того, не нужно писать код, проверяющий поведение во время выполнения, — всё уже проверено при компиляции. Это повышает производительность и не лишает нас гибкости обобщений.
Проверка ссылок с помощью времён жизни
Проверка ссылок с помощью времён жизни
Времена жизни (lifetimes) — ещё одна разновидность обобщений, которой мы, сами того не зная, уже пользовались. Только они гарантируют не то, что у типа есть нужное нам поведение, а то, что ссылки остаются действительными столько, сколько они нам нужны.
В разделе «Ссылки и заимствование» главы 4 мы не упомянули одну деталь: у каждой ссылки в Rust есть время жизни — та область, в пределах которой ссылка действительна. Чаще всего времена жизни неявные и выводятся сами — так же, как чаще всего сами выводятся типы. Аннотировать типы приходится, только когда подходит сразу несколько. Точно так же и времена жизни приходится аннотировать, только когда времена жизни ссылок могут быть связаны между собой несколькими разными способами. В таких случаях Rust требует описать эту связь с помощью обобщённых параметров времени жизни — чтобы ссылки, которые реально используются во время работы программы, были гарантированно действительны.
В большинстве других языков программирования аннотаций времени жизни просто нет, так что поначалу это будет непривычно. Мы не охватим в этой главе тему времён жизни целиком, но разберём типичные ситуации, в которых вам встретится их синтаксис, чтобы вы освоились с самой идеей.
Висячие ссылки
Главная задача времён жизни — не допустить висячих ссылок, то есть ссылок, которые указывают уже не на те данные, на которые должны. Посмотрите на программу из листинга 10-16: в ней есть внешняя и внутренняя области видимости.
fn main() {
let r;
{
let x = 5;
r = &x;
}
println!("r: {r}");
}Примечание: в листингах 10-16, 10-17 и 10-23 переменные объявляются без начального значения — чтобы имя переменной существовало во внешней области видимости. На первый взгляд это противоречит тому, что в Rust нет null. Но если попытаться использовать переменную, прежде чем присвоить ей значение, будет ошибка компиляции — так что null в Rust действительно не допускается.
Во внешней области видимости объявлена переменная r без начального
значения, а во внутренней — переменная x с начальным значением 5. Внутри
внутренней области мы пытаемся сделать r ссылкой на x. Затем внутренняя
область заканчивается, а мы пытаемся вывести значение r. Этот код не
скомпилируется: значение, на которое ссылается r, вышло из области видимости
раньше, чем мы попытались им воспользоваться. Вот сообщение об ошибке:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0597]: `x` does not live long enough
--> src/main.rs:6:13
|
5 | let x = 5;
| - binding `x` declared here
6 | r = &x;
| ^^ borrowed value does not live long enough
7 | }
| - `x` dropped here while still borrowed
8 |
9 | println!("r: {r}");
| - borrow later used here
For more information about this error, try `rustc --explain E0597`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
В сообщении сказано, что переменная x «живёт недостаточно долго» (does not
live long enough). Дело в том, что x выйдет из области видимости, когда в
строке 7 закончится внутренняя область. А r действительна во всей внешней
области — её область больше, и говорят, что она «живёт дольше». Если бы Rust
пропустил этот код, r ссылалась бы на память, которая освободилась, когда
x вышла из области видимости, и всё, что мы попытались бы сделать с r,
работало бы неправильно. Как же Rust понимает, что код некорректен? С помощью
анализатора заимствований.
Анализатор заимствований
В компиляторе Rust есть анализатор заимствований (borrow checker), который сравнивает области видимости и определяет, все ли заимствования корректны. В листинге 10-17 — тот же код, что в листинге 10-16, но с пометками времён жизни переменных.
fn main() {
let r; // ---------+-- 'a
// |
{ // |
let x = 5; // -+-- 'b |
r = &x; // | |
} // -+ |
// |
println!("r: {r}"); // |
} // ---------+r и x — 'a и 'b соответственноЗдесь время жизни r помечено как 'a, а время жизни x — как 'b. Как
видите, внутренний блок 'b гораздо короче внешнего блока времени жизни 'a.
При компиляции Rust сравнивает эти два времени жизни и видит: у r время
жизни 'a, а ссылается она на память со временем жизни 'b. Программа
отвергается, потому что 'b короче 'a: то, на что указывает ссылка, живёт
меньше, чем сама ссылка.
В листинге 10-18 код исправлен: висячей ссылки больше нет, и он компилируется без ошибок.
fn main() {
let x = 5; // ----------+-- 'b
// |
let r = &x; // --+-- 'a |
// | |
println!("r: {r}"); // | |
// --+ |
} // ----------+Здесь у x время жизни 'b, и в этот раз оно больше 'a. Значит, r может
ссылаться на x: Rust знает, что ссылка в r будет действительна всё время,
пока действительна x.
Теперь вы знаете, где находятся времена жизни ссылок и как Rust анализирует их, чтобы ссылки всегда оставались действительными. Перейдём к обобщённым временам жизни в параметрах функций и возвращаемых значениях.
Обобщённые времена жизни в функциях
Напишем функцию, которая возвращает более длинный из двух строковых срезов.
Она принимает два строковых среза и возвращает один. Когда мы реализуем
функцию longest, код из листинга 10-19 должен вывести
The longest string is abcd.
fn main() {
let string1 = String::from("abcd");
let string2 = "xyz";
let result = longest(string1.as_str(), string2);
println!("The longest string is {result}");
}main вызывает longest, чтобы найти более длинный из двух строковых срезовОбратите внимание: мы хотим, чтобы функция принимала строковые срезы, то есть
ссылки, а не строки, — потому что не хотим, чтобы longest забирала владение
параметрами. Почему в листинге 10-19 параметры именно такие, подробнее
объясняется в разделе «Строковые срезы как
параметры» главы 4.
Если реализовать longest так, как в листинге 10-20, код не скомпилируется.
fn main() {
let string1 = String::from("abcd");
let string2 = "xyz";
let result = longest(string1.as_str(), string2);
println!("The longest string is {result}");
}
fn longest(x: &str, y: &str) -> &str {
if x.len() > y.len() { x } else { y }
}longest, которая возвращает более длинный из двух строковых срезов, но пока не компилируетсяВместо этого мы получим ошибку, в которой говорится о временах жизни:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0106]: missing lifetime specifier
--> src/main.rs:9:33
|
9 | fn longest(x: &str, y: &str) -> &str {
| ---- ---- ^ expected named lifetime parameter
|
= help: this function's return type contains a borrowed value, but the signature does not say whether it is borrowed from `x` or `y`
help: consider introducing a named lifetime parameter
|
9 | fn longest<'a>(x: &'a str, y: &'a str) -> &'a str {
| ++++ ++ ++ ++
For more information about this error, try `rustc --explain E0106`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
Из подсказки видно, что возвращаемому типу нужен обобщённый параметр времени
жизни: Rust не может понять, на что указывает возвращаемая ссылка — на x или
на y. Да мы и сами этого не знаем: блок if в теле функции возвращает
ссылку на x, а блок else — ссылку на y!
Определяя функцию, мы не знаем, какие конкретные значения в неё передадут, а
значит, не знаем, выполнится ветка if или ветка else. Не знаем мы и
конкретных времён жизни переданных ссылок, так что не можем, как в листингах
10-17 и 10-18, посмотреть на области видимости и понять, будет ли
возвращаемая ссылка всегда действительна. Анализатор заимствований тоже не
может этого определить: он не знает, как времена жизни x и y связаны со
временем жизни возвращаемого значения. Чтобы исправить ошибку, добавим
обобщённые параметры времени жизни, которые описывают связь между ссылками, —
тогда анализатор заимствований сможет выполнить свою проверку.
Синтаксис аннотаций времени жизни
Аннотации времени жизни не меняют того, сколько живёт та или иная ссылка. Они лишь описывают, как времена жизни нескольких ссылок соотносятся друг с другом, никак на эти времена жизни не влияя. Как функция с обобщённым параметром типа в сигнатуре может принимать значения любого типа, так и функция с обобщённым параметром времени жизни может принимать ссылки с любым временем жизни.
У аннотаций времени жизни немного необычный синтаксис: имена параметров
времени жизни начинаются с апострофа (') и обычно состоят из строчных букв
и очень коротки — как и обобщённые типы. Чаще всего первую аннотацию времени
жизни называют 'a. Аннотацию ставят после & ссылки и отделяют от типа
ссылки пробелом.
Вот несколько примеров — ссылка на i32 без параметра времени жизни, ссылка
на i32 с параметром времени жизни 'a и изменяемая ссылка на i32 с тем
же временем жизни 'a:
&i32 // ссылка
&'a i32 // ссылка с явным временем жизни
&'a mut i32 // изменяемая ссылка с явным временем жизниОдна аннотация времени жизни сама по себе особого смысла не имеет: аннотации
нужны, чтобы сказать Rust, как обобщённые параметры времени жизни нескольких
ссылок связаны между собой. Посмотрим, как это выглядит на примере функции
longest.
В сигнатурах функций
Чтобы использовать аннотации времени жизни в сигнатуре функции, обобщённые параметры времени жизни нужно объявить в угловых скобках между именем функции и списком параметров — так же, как обобщённые параметры типа.
Мы хотим, чтобы сигнатура выражала такое ограничение: возвращаемая ссылка
действительна, пока действительны оба параметра. Это и есть связь между
временами жизни параметров и возвращаемого значения. Назовём время жизни 'a
и добавим его к каждой ссылке, как в листинге 10-21.
fn main() {
let string1 = String::from("abcd");
let string2 = "xyz";
let result = longest(string1.as_str(), string2);
println!("The longest string is {result}");
}
fn longest<'a>(x: &'a str, y: &'a str) -> &'a str {
if x.len() > y.len() { x } else { y }
}longest, где у всех ссылок в сигнатуре одно и то же время жизни 'aЭтот код должен компилироваться и давать нужный результат с функцией main
из листинга 10-19.
Теперь сигнатура говорит Rust: для некоторого времени жизни 'a функция
принимает два параметра — строковые срезы, которые живут как минимум столько
же, сколько 'a. И возвращаемый строковый срез тоже будет жить как минимум
столько же, сколько 'a. На практике это значит, что время жизни ссылки,
которую возвращает longest, равно меньшему из времён жизни значений, на
которые ссылаются аргументы. Именно эти связи мы и хотим, чтобы Rust учитывал
при анализе кода.
Помните: указывая в сигнатуре параметры времени жизни, мы не меняем время
жизни ни одного переданного или возвращаемого значения. Мы лишь говорим
анализатору заимствований отвергать любые значения, которые не соблюдают эти
ограничения. Заметьте, что функции longest не нужно точно знать, сколько
проживут x и y, — достаточно, чтобы вместо 'a можно было подставить
какую-то область, удовлетворяющую сигнатуре.
Аннотации времени жизни в функциях пишутся в сигнатуре, а не в теле функции. Они становятся частью договора функции — так же, как типы в сигнатуре. Раз договор о временах жизни записан прямо в сигнатуре, анализ, который выполняет компилятор Rust, получается проще. Если что-то не так с аннотациями функции или с тем, как её вызывают, ошибка компиляции точнее укажет на нужное место кода и на нарушенные ограничения. А если бы компилятор сам угадывал, какие связи между временами жизни мы имели в виду, он мог бы указать лишь на место, где наш код используется, — а оно бывает очень далеко от настоящей причины ошибки.
Когда мы передаём в longest конкретные ссылки, вместо 'a подставляется
конкретное время жизни — та часть области видимости x, которая
пересекается с областью видимости y. Иначе говоря, обобщённое время жизни
'a получает конкретное время жизни, равное меньшему из времён жизни x и
y. А поскольку возвращаемую ссылку мы пометили тем же параметром 'a, она
тоже будет действительна в течение меньшего из времён жизни x и y.
Посмотрим, как аннотации времени жизни ограничивают функцию longest, если
передавать ей ссылки с разными конкретными временами жизни. Листинг 10-22 —
простой пример.
fn main() {
let string1 = String::from("long string is long");
{
let string2 = String::from("xyz");
let result = longest(string1.as_str(), string2.as_str());
println!("The longest string is {result}");
}
}
fn longest<'a>(x: &'a str, y: &'a str) -> &'a str {
if x.len() > y.len() { x } else { y }
}longest со ссылками на значения String с разными конкретными временами жизниЗдесь string1 действительна до конца внешней области, string2 — до конца
внутренней, а result ссылается на что-то, действительное до конца внутренней
области. Запустите этот код — анализатор заимствований его одобрит: код
скомпилируется и выведет The longest string is long string is long.
Теперь попробуем пример, который покажет, что время жизни ссылки в result
должно быть меньшим из времён жизни двух аргументов. Вынесем объявление
переменной result за пределы внутренней области, но присваивание ей значения
оставим внутри — рядом со string2. А println!, который использует result,
перенесём наружу, после конца внутренней области. Код в листинге 10-23 не
скомпилируется.
fn main() {
let string1 = String::from("long string is long");
let result;
{
let string2 = String::from("xyz");
result = longest(string1.as_str(), string2.as_str());
}
println!("The longest string is {result}");
}
fn longest<'a>(x: &'a str, y: &'a str) -> &'a str {
if x.len() > y.len() { x } else { y }
}result после того, как string2 вышла из области видимостиПри компиляции получаем ошибку:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0597]: `string2` does not live long enough
--> src/main.rs:6:44
|
5 | let string2 = String::from("xyz");
| ------- binding `string2` declared here
6 | result = longest(string1.as_str(), string2.as_str());
| ^^^^^^^ borrowed value does not live long enough
7 | }
| - `string2` dropped here while still borrowed
8 | println!("The longest string is {result}");
| ------ borrow later used here
For more information about this error, try `rustc --explain E0597`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
Ошибка говорит: чтобы result была действительна в println!, string2
должна оставаться действительной до конца внешней области. Rust знает это,
потому что мы пометили параметры функции и возвращаемое значение одним и тем
же параметром времени жизни 'a.
Мы, люди, смотрим на этот код и видим, что string1 длиннее string2, а
значит, в result окажется ссылка на string1. string1 ещё не вышла из
области видимости, так что ссылка на неё в println! по-прежнему
действительна. Но компилятор не может увидеть, что в этом случае ссылка
корректна. Мы сказали Rust, что время жизни ссылки, которую возвращает
longest, равно меньшему из времён жизни переданных ссылок. Поэтому
анализатор заимствований не пропускает код из листинга 10-23 — в нём может
оказаться недействительная ссылка.
Попробуйте придумать ещё эксперименты: меняйте значения и времена жизни
ссылок, которые передаются в longest, и то, как используется возвращаемая
ссылка. Перед компиляцией делайте предположение, пройдёт ли эксперимент
проверку анализатора заимствований, — а потом проверяйте, правы ли вы!
Связи между временами жизни
Как именно указывать параметры времени жизни, зависит от того, что делает
функция. Например, если бы longest всегда возвращала первый параметр, а не
более длинный срез, указывать время жизни для параметра y не понадобилось
бы. Следующий код скомпилируется:
fn main() {
let string1 = String::from("abcd");
let string2 = "efghijklmnopqrstuvwxyz";
let result = longest(string1.as_str(), string2);
println!("The longest string is {result}");
}
fn longest<'a>(x: &'a str, y: &str) -> &'a str {
x
}Мы указали параметр времени жизни 'a для параметра x и возвращаемого
типа, но не для y: время жизни y никак не связано ни с временем жизни x,
ни с возвращаемым значением.
Когда функция возвращает ссылку, параметр времени жизни возвращаемого типа
должен совпадать с параметром времени жизни одного из параметров. Если
возвращаемая ссылка не указывает ни на один из параметров, значит, она
указывает на значение, созданное внутри функции. Но тогда это будет висячая
ссылка: значение выйдет из области видимости в конце функции. Вот попытка
реализовать longest, которая не скомпилируется:
fn main() {
let string1 = String::from("abcd");
let string2 = "xyz";
let result = longest(string1.as_str(), string2);
println!("The longest string is {result}");
}
fn longest<'a>(x: &str, y: &str) -> &'a str {
let result = String::from("really long string");
result.as_str()
}Хотя мы указали для возвращаемого типа параметр времени жизни 'a, эта
реализация не скомпилируется: время жизни возвращаемого значения никак не
связано со временами жизни параметров. Вот сообщение об ошибке:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0515]: cannot return value referencing local variable `result`
--> src/main.rs:11:5
|
11 | result.as_str()
| ------^^^^^^^^^
| |
| returns a value referencing data owned by the current function
| `result` is borrowed here
For more information about this error, try `rustc --explain E0515`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
Проблема в том, что result выходит из области видимости и очищается в конце
функции longest, а мы пытаемся вернуть из функции ссылку на result.
Никакими параметрами времени жизни висячую ссылку не исправить, а создавать
висячие ссылки Rust не позволит. Лучшее решение здесь — возвращать не ссылку, а
тип-владелец, чтобы за очистку значения отвечала вызывающая функция.
В конечном счёте синтаксис времён жизни нужен, чтобы связать между собой времена жизни разных параметров и возвращаемых значений функций. Когда они связаны, у Rust достаточно информации, чтобы разрешать безопасные для памяти операции и запрещать те, что создали бы висячие указатели или как-то иначе нарушили безопасность памяти.
В определениях структур
До сих пор все наши структуры хранили типы-владельцы. Структура может хранить
и ссылки, но тогда к каждой ссылке в определении структуры нужно добавить
аннотацию времени жизни. В листинге 10-24 — структура ImportantExcerpt
(важный отрывок), которая хранит строковый срез.
struct ImportantExcerpt<'a> {
part: &'a str,
}
fn main() {
let novel = String::from("Call me Ishmael. Some years ago...");
let first_sentence = novel.split('.').next().unwrap();
let i = ImportantExcerpt {
part: first_sentence,
};
}У этой структуры одно поле — part, в котором хранится строковый срез, то
есть ссылка. Как и с обобщёнными типами данных, имя обобщённого параметра
времени жизни объявляется в угловых скобках после имени структуры, чтобы его
можно было использовать в теле определения. Эта аннотация означает, что
экземпляр ImportantExcerpt не может жить дольше ссылки, которая хранится в
его поле part.
Функция main создаёт экземпляр ImportantExcerpt, который хранит ссылку на
первое предложение String, принадлежащей переменной novel (роман).
Переменная novel появляется раньше, чем экземпляр ImportantExcerpt, а
выходит из области видимости позже него. Поэтому ссылка внутри
ImportantExcerpt всё время остаётся действительной.
Неявные времена жизни
Вы узнали, что у каждой ссылки есть время жизни и что для функций и структур, использующих ссылки, нужно указывать параметры времени жизни. Однако в листинге 4-9 у нас была функция (она снова показана в листинге 10-25), которая компилировалась без всяких аннотаций времени жизни.
fn first_word(s: &str) -> &str {
let bytes = s.as_bytes();
for (i, &item) in bytes.iter().enumerate() {
if item == b' ' {
return &s[0..i];
}
}
&s[..]
}
fn main() {
let my_string = String::from("hello world");
// first_word принимает срезы `String`
let word = first_word(&my_string[..]);
let my_string_literal = "hello world";
// first_word принимает срезы строковых литералов
let word = first_word(&my_string_literal[..]);
// Строковые литералы *уже* являются срезами строк,
// поэтому сработает и так, без синтаксиса срезов!
let word = first_word(my_string_literal);
}Причина, по которой эта функция компилируется без аннотаций, историческая. В ранних версиях Rust (до 1.0) этот код не скомпилировался бы: у каждой ссылки должно было быть явное время жизни. Тогда сигнатуру функции записали бы так:
fn first_word<'a>(s: &'a str) -> &'a str {Написав много кода на Rust, команда Rust заметила, что в определённых ситуациях программисты раз за разом пишут одни и те же аннотации времени жизни. Эти ситуации были предсказуемы и укладывались в несколько однозначных шаблонов. Разработчики встроили эти шаблоны в компилятор, чтобы анализатор заимствований сам выводил времена жизни в таких ситуациях и явные аннотации были не нужны.
Этот эпизод из истории Rust важен потому, что могут появиться и другие однозначные шаблоны, которые добавят в компилятор. Возможно, в будущем аннотаций времени жизни понадобится ещё меньше.
Шаблоны, встроенные в анализ ссылок Rust, называются правилами вывода времён жизни (lifetime elision rules, буквально «правила опускания»). Это не правила, которым должны следовать программисты, а набор частных случаев, которые рассматривает компилятор: если ваш код подходит под них, писать времена жизни явно не нужно.
Эти правила не дают полного вывода. Если после их применения остаётся неоднозначность в том, какие времена жизни у ссылок, компилятор не станет гадать, каким должно быть время жизни оставшихся ссылок. Вместо этого он выдаст ошибку, которую можно исправить, добавив аннотации времени жизни.
Времена жизни параметров функции или метода называются входными временами жизни (input lifetimes), а времена жизни возвращаемых значений — выходными (output lifetimes).
Когда явных аннотаций нет, компилятор определяет времена жизни ссылок по трём
правилам. Первое правило относится к входным временам жизни, второе и
третье — к выходным. Если, пройдя все три правила, компилятор так и не
определил времена жизни каких-то ссылок, он остановится с ошибкой. Эти правила
действуют и для определений fn, и для блоков impl.
Первое правило: компилятор назначает каждому параметру-ссылке свой параметр
времени жизни. То есть функция с одним параметром получает один параметр
времени жизни: fn foo<'a>(x: &'a i32); функция с двумя — два разных:
fn foo<'a, 'b>(x: &'a i32, y: &'b i32); и так далее.
Второе правило: если входной параметр времени жизни ровно один, это время
жизни назначается всем выходным параметрам времени жизни:
fn foo<'a>(x: &'a i32) -> &'a i32.
Третье правило: если входных параметров времени жизни несколько, но один из
них — &self или &mut self (то есть это метод), всем выходным параметрам
времени жизни назначается время жизни self. Благодаря третьему правилу
методы гораздо приятнее читать и писать: значков нужно меньше.
Представим, что мы компилятор, и применим эти правила, чтобы определить
времена жизни ссылок в сигнатуре функции first_word из листинга 10-25.
Сначала у ссылок в сигнатуре нет никаких времён жизни:
fn first_word(s: &str) -> &str {Компилятор применяет первое правило: у каждого параметра своё время жизни.
Как обычно, назовём его 'a, и сигнатура становится такой:
fn first_word<'a>(s: &'a str) -> &str {Входное время жизни ровно одно, поэтому применяется второе правило: время жизни единственного входного параметра назначается выходному, и сигнатура становится такой:
fn first_word<'a>(s: &'a str) -> &'a str {Теперь у всех ссылок в сигнатуре есть времена жизни, и компилятор может продолжать анализ, не требуя от программиста аннотаций в этой сигнатуре.
Рассмотрим другой пример — функцию longest, у которой не было параметров
времени жизни, когда мы начинали работать с ней в листинге 10-20:
fn longest(x: &str, y: &str) -> &str {Применим первое правило: у каждого параметра своё время жизни. На этот раз параметров два, значит, и времён жизни два:
fn longest<'a, 'b>(x: &'a str, y: &'b str) -> &str {Второе правило не применяется: входных времён жизни больше одного. Третье
тоже: longest — функция, а не метод, и ни один параметр не является self.
Пройдя все три правила, мы так и не выяснили, какое время жизни у
возвращаемого типа. Вот почему код из листинга 10-20 не компилировался:
компилятор прошёл по правилам вывода времён жизни, но так и не смог
определить времена жизни всех ссылок в сигнатуре.
Третье правило на самом деле применяется только к сигнатурам методов, поэтому дальше рассмотрим времена жизни именно в методах — и увидим, почему благодаря третьему правилу в сигнатурах методов аннотации времени жизни нужны нечасто.
В определениях методов
Когда мы реализуем методы для структуры с временами жизни, синтаксис тот же, что и для обобщённых параметров типа (см. листинг 10-11). Где объявлять и использовать параметры времени жизни, зависит от того, связаны ли они с полями структуры или с параметрами и возвращаемыми значениями метода.
Имена времён жизни для полей структуры всегда объявляются после ключевого
слова impl и используются после имени структуры: эти времена жизни — часть
типа структуры.
В сигнатурах методов внутри блока impl ссылки могут быть привязаны к времени
жизни ссылок в полях структуры, а могут быть и независимы. Кроме того,
благодаря правилам вывода времён жизни в сигнатурах методов аннотации часто
не нужны. Посмотрим на примеры со структурой ImportantExcerpt, которую мы
определили в листинге 10-24.
Начнём с метода level, единственный параметр которого — ссылка на self, а
возвращаемое значение — i32, то есть не ссылка ни на что:
struct ImportantExcerpt<'a> {
part: &'a str,
}
impl<'a> ImportantExcerpt<'a> {
fn level(&self) -> i32 {
3
}
}
impl<'a> ImportantExcerpt<'a> {
fn announce_and_return_part(&self, announcement: &str) -> &str {
println!("Attention please: {announcement}");
self.part
}
}
fn main() {
let novel = String::from("Call me Ishmael. Some years ago...");
let first_sentence = novel.split('.').next().unwrap();
let i = ImportantExcerpt {
part: first_sentence,
};
}Объявить параметр времени жизни после impl и использовать его после имени
типа обязательно, а вот аннотировать время жизни ссылки на self благодаря
первому правилу вывода не нужно.
А вот пример, где применяется третье правило:
struct ImportantExcerpt<'a> {
part: &'a str,
}
impl<'a> ImportantExcerpt<'a> {
fn level(&self) -> i32 {
3
}
}
impl<'a> ImportantExcerpt<'a> {
fn announce_and_return_part(&self, announcement: &str) -> &str {
println!("Attention please: {announcement}");
self.part
}
}
fn main() {
let novel = String::from("Call me Ishmael. Some years ago...");
let first_sentence = novel.split('.').next().unwrap();
let i = ImportantExcerpt {
part: first_sentence,
};
}Входных времён жизни два, поэтому Rust применяет первое правило и даёт и
&self, и announcement собственные времена жизни. Затем, поскольку один из
параметров — &self, возвращаемый тип получает время жизни &self, и все
времена жизни определены.
Статическое время жизни
Есть одно особое время жизни, о котором нужно сказать, — 'static. Оно
означает, что ссылка может жить всё время работы программы. У всех
строковых литералов время жизни 'static, и его можно указать так:
#![allow(unused)]
fn main() {
let s: &'static str = "I have a static lifetime.";
}Текст этой строки хранится прямо в бинарном файле программы, а он доступен
всегда. Поэтому время жизни всех строковых литералов — 'static.
В сообщениях об ошибках вам могут встретиться советы использовать время жизни
'static. Но прежде чем указывать для ссылки 'static, подумайте,
действительно ли ваша ссылка живёт всё время работы программы и нужно ли вам
это. Чаще всего сообщение с советом про 'static возникает из-за попытки
создать висячую ссылку или из-за несоответствия доступных времён жизни. В
таких случаях нужно устранять сами эти проблемы, а не указывать 'static.
Обобщённые параметры типа, ограничения трейтами и времена жизни вместе
Взглянем коротко на синтаксис, в котором в одной функции указаны и обобщённые параметры типа, и ограничения трейтами, и времена жизни!
fn main() {
let string1 = String::from("abcd");
let string2 = "xyz";
let result = longest_with_an_announcement(
string1.as_str(),
string2,
"Today is someone's birthday!",
);
println!("The longest string is {result}");
}
use std::fmt::Display;
fn longest_with_an_announcement<'a, T>(
x: &'a str,
y: &'a str,
ann: T,
) -> &'a str
where
T: Display,
{
println!("Announcement! {ann}");
if x.len() > y.len() { x } else { y }
}Это функция longest из листинга 10-21, которая возвращает более длинный из
двух строковых срезов. Но теперь у неё есть дополнительный параметр ann
обобщённого типа T, вместо которого можно подставить любой тип, реализующий
трейт Display, — так сказано в конструкции where. Этот параметр
выводится через {}, поэтому ограничение трейтом Display и нужно. Времена
жизни — разновидность обобщений, поэтому объявления параметра времени жизни
'a и обобщённого параметра типа T стоят в одном списке в угловых скобках
после имени функции.
Итоги
В этой главе мы разобрали очень многое! Теперь вы знаете об обобщённых параметрах типа, трейтах и ограничениях трейтами, а также об обобщённых параметрах времени жизни — и готовы писать код без повторений, который работает в самых разных ситуациях. Обобщённые параметры типа позволяют применять код к разным типам. Трейты и ограничения трейтами гарантируют, что, хотя типы и обобщённые, у них будет нужное коду поведение. Вы научились с помощью аннотаций времени жизни гарантировать, что в этом гибком коде не будет висячих ссылок. И весь этот анализ происходит при компиляции, никак не влияя на производительность во время выполнения!
Хотите верьте, хотите нет, но по темам этой главы можно узнать ещё очень многое. В главе 18 речь пойдёт о трейт-объектах — ещё одном способе использовать трейты. Бывают и более сложные сценарии с аннотациями времени жизни, но они понадобятся только в очень продвинутых случаях; о них читайте в справочнике Rust. А дальше вы научитесь писать тесты на Rust, чтобы убеждаться, что код работает так, как должен.
Автоматические тесты
В эссе 1972 года «Смиренный программист» (The Humble Programmer) Эдсгер Дейкстра заметил, что «тестирование программ может весьма эффективно показывать наличие ошибок, но безнадёжно непригодно для доказательства их отсутствия». Но это не значит, что тестировать нужно меньше!
Корректность программы — это то, насколько код делает именно то, что мы задумали. Rust спроектирован с большим вниманием к корректности программ, но корректность — штука сложная, и доказать её непросто. Огромную часть этой работы берёт на себя система типов Rust, но поймать всё она не может. Поэтому в Rust встроена поддержка автоматических тестов.
Допустим, мы пишем функцию add_two, которая прибавляет 2 к переданному ей
числу. Судя по сигнатуре, она принимает целое число и возвращает целое число. Когда
мы реализуем и компилируем эту функцию, Rust выполняет все уже знакомые вам
проверки типов и заимствований — и гарантирует, например, что мы не передадим
в функцию String или недействительную ссылку. Но Rust не может проверить,
что функция делает ровно то, что мы задумали: возвращает параметр плюс 2, а
не, скажем, плюс 10 или минус 50! Вот тут-то и нужны тесты.
Можно написать тесты, которые проверяют, например, что если передать в
add_two число 3, вернётся 5. Такие тесты можно запускать после каждого
изменения кода, чтобы убедиться, что всё, что работало правильно, так и
работает.
Тестирование — непростой навык. В одной главе не охватить все тонкости написания хороших тестов, но мы разберём, как устроены средства тестирования в Rust. Поговорим об аннотациях и макросах, которые доступны при написании тестов, о поведении по умолчанию и настройках запуска тестов, а также о том, как организовать тесты в модульные и интеграционные.
Как писать тесты
Как писать тесты
Тесты — это функции на Rust, которые проверяют, что остальной (не тестовый) код работает как ожидается. Тело тестовой функции обычно делает три вещи:
- готовит нужные данные или состояние;
- запускает код, который нужно проверить;
- проверяет, что результат такой, как ожидалось.
Посмотрим, что Rust даёт специально для написания таких тестов: атрибут
test, несколько макросов и атрибут should_panic.
Устройство тестовой функции
В простейшем случае тест в Rust — это функция с атрибутом test. Атрибуты —
это метаданные о частях кода на Rust; один из них, derive, мы уже
использовали со структурами в главе 5. Чтобы превратить функцию в тестовую,
добавьте #[test] на строке перед fn. Когда вы запускаете тесты командой
cargo test, Rust собирает специальный бинарник для запуска тестов (test
runner), который выполняет помеченные функции и сообщает, прошёл каждый тест
или провалился.
Каждый раз, когда мы создаём через Cargo новый библиотечный проект, в нём автоматически генерируется тестовый модуль с тестовой функцией. Это шаблон для ваших тестов, чтобы не вспоминать каждый раз точную структуру и синтаксис. Тестовых функций и тестовых модулей можно добавлять сколько угодно!
Сначала поэкспериментируем с шаблонным тестом и разберёмся, как устроены тесты. А потом напишем настоящие тесты, которые вызывают наш код и проверяют, что он ведёт себя правильно.
Создадим новый библиотечный проект adder, который будет складывать два
числа:
$ cargo new adder --lib
Created library `adder` project
$ cd adder
Содержимое файла src/lib.rs в библиотеке adder должно выглядеть как в
листинге 11-1.
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_works() {
let result = add(2, 2);
assert_eq!(result, 4);
}
}cargo newФайл начинается с примера функции add, чтобы было что тестировать.
Пока сосредоточимся только на функции it_works. Обратите внимание на
аннотацию #[test]: этот атрибут говорит, что функция тестовая, и
запускатель тестов будет считать её тестом. В модуле tests могут быть и
обычные функции — например, для подготовки общих сценариев или выполнения
общих операций, — поэтому тесты всегда нужно явно помечать.
Тело функции-примера с помощью макроса assert_eq! проверяет, что result, в
котором лежит результат вызова add с 2 и 2, равен 4. Эта проверка
(assertion) — пример того, как обычно выглядит тест. Запустим его и
убедимся, что он проходит.
Команда cargo test запускает все тесты проекта, как показано в листинге
11-2.
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.57s
Running unittests src/lib.rs (target/debug/deps/adder-01ad14159ff659ab)
running 1 test
test tests::it_works ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Cargo скомпилировал и запустил тест. Видим строку running 1 test. Следующая
строка показывает имя сгенерированной тестовой функции — tests::it_works — и
что результат её выполнения — ok. Итоговая строка test result: ok.
означает, что все тесты прошли, а часть 1 passed; 0 failed подсчитывает,
сколько тестов прошло и сколько провалилось.
Тест можно пометить как игнорируемый, чтобы он не запускался в обычных
случаях; об этом — в разделе «Игнорируем тесты, если их не запросили
явно» далее в этой главе. Здесь мы этого не делали,
поэтому в итогах 0 ignored. Ещё можно передать cargo test аргумент, чтобы
запустить только тесты, имя которых совпадает со строкой, — это называется
фильтрацией, и о ней пойдёт речь в разделе «Запуск части тестов по
имени». Здесь мы ничего не фильтровали, поэтому в
конце итогов — 0 filtered out.
Значение 0 measured относится к бенчмаркам — тестам, измеряющим
производительность. На момент написания книги бенчмарки доступны только в
nightly Rust. Подробнее — в документации о бенчмарках.
Следующая часть вывода, начинающаяся с Doc-tests adder, — результаты
документационных тестов. Их у нас пока нет, но Rust умеет компилировать любые
примеры кода из документации к API. Это помогает поддерживать документацию и
код в согласии! О том, как писать документационные тесты, мы поговорим в
разделе «Документационные комментарии как тесты» главы 14. А пока не будем обращать внимания на вывод Doc-tests.
Начнём подстраивать тест под себя. Сначала переименуем функцию it_works,
например, в exploration:
Файл: src/lib.rs
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn exploration() {
let result = add(2, 2);
assert_eq!(result, 4);
}
}Снова запустите cargo test. Теперь вместо it_works в выводе exploration:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.59s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::exploration ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Добавим ещё один тест, но на этот раз — проваливающийся! Тест проваливается,
когда что-то в тестовой функции паникует. Каждый тест запускается в
отдельном потоке, и когда главный поток видит, что поток теста умер, тест
помечается как проваленный. В главе 9 мы говорили, что проще всего вызвать
панику макросом panic!. Добавьте новый тест — функцию another, — чтобы
файл src/lib.rs выглядел как в листинге 11-3.
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn exploration() {
let result = add(2, 2);
assert_eq!(result, 4);
}
#[test]
fn another() {
panic!("Make this test fail");
}
}panic!Снова запустите тесты через cargo test. Вывод должен быть как в листинге
11-4: тест exploration прошёл, а another — провалился.
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.72s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 2 tests
test tests::another ... FAILED
test tests::exploration ... ok
failures:
---- tests::another stdout ----
thread 'tests::another' (6019162) panicked at src/lib.rs:17:9:
Make this test fail
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::another
test result: FAILED. 1 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Вместо ok в строке test tests::another теперь FAILED. Между
результатами отдельных тестов и итогами появились два новых раздела. Первый
подробно объясняет причину провала каждого теста: в нашем случае
tests::another провалился, потому что запаниковал с сообщением
Make this test fail в строке 17 файла src/lib.rs. Второй раздел просто
перечисляет имена всех проваленных тестов — это удобно, когда тестов много и
подробного вывода о провалах тоже много. По имени проваленного теста можно
запустить только его, чтобы проще было отлаживать; подробнее о способах
запуска тестов — в разделе «Управление запуском
тестов».
В конце — итоговая строка: общий результат тестов — FAILED. Один тест
прошёл, один провалился.
Теперь, когда вы видели, как выглядят результаты тестов в разных ситуациях,
посмотрим на другие макросы, кроме panic!, которые пригодятся в тестах.
Проверка результатов с assert!
Макрос assert! из стандартной библиотеки пригодится, когда нужно убедиться,
что какое-то условие в тесте истинно. Ему передаётся аргумент, который
вычисляется в логическое значение. Если оно true, ничего не происходит, и
тест проходит. Если false, макрос assert! вызывает panic!, и тест
проваливается. Макрос assert! помогает проверить, что код работает так, как
мы задумали.
В листинге 5-15 главы 5 у нас были структура Rectangle и метод can_hold —
они повторены в листинге 11-5. Поместим этот код в src/lib.rs и напишем к
нему тесты с макросом assert!.
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn can_hold(&self, other: &Rectangle) -> bool {
self.width > other.width && self.height > other.height
}
}Rectangle и её метод can_hold из главы 5Метод can_hold возвращает логическое значение — идеальный случай для
макроса assert!. В листинге 11-6 мы пишем тест для метода can_hold:
создаём экземпляр Rectangle шириной 8 и высотой 7 и проверяем, что он может
вместить другой экземпляр Rectangle шириной 5 и высотой 1.
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn can_hold(&self, other: &Rectangle) -> bool {
self.width > other.width && self.height > other.height
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn larger_can_hold_smaller() {
let larger = Rectangle {
width: 8,
height: 7,
};
let smaller = Rectangle {
width: 5,
height: 1,
};
assert!(larger.can_hold(&smaller));
}
}can_hold, который проверяет, что больший прямоугольник действительно может вместить меньшийОбратите внимание на строку use super::*; внутри модуля tests. Модуль
tests — обычный модуль, который подчиняется обычным правилам видимости,
описанным в разделе «Пути к элементам в дереве
модулей»
главы 7. Модуль tests — внутренний, поэтому тестируемый код из внешнего
модуля нужно подключить в его область видимости. Здесь используется *, так
что всё, что определено во внешнем модуле, доступно модулю tests.
Мы назвали тест larger_can_hold_smaller («больший вмещает меньший») и
создали два нужных экземпляра Rectangle. Затем вызвали макрос assert! и
передали ему результат вызова larger.can_hold(&smaller). Это выражение
должно вернуть true, так что тест должен пройти. Проверим!
$ cargo test
Compiling rectangle v0.1.0 (file:///projects/rectangle)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.66s
Running unittests src/lib.rs (target/debug/deps/rectangle-6584c4561e48942e)
running 1 test
test tests::larger_can_hold_smaller ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests rectangle
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Проходит! Добавим ещё один тест — на этот раз проверим, что меньший прямоугольник не может вместить больший:
Файл: src/lib.rs
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn can_hold(&self, other: &Rectangle) -> bool {
self.width > other.width && self.height > other.height
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn larger_can_hold_smaller() {
// --пропуск--
let larger = Rectangle {
width: 8,
height: 7,
};
let smaller = Rectangle {
width: 5,
height: 1,
};
assert!(larger.can_hold(&smaller));
}
#[test]
fn smaller_cannot_hold_larger() {
let larger = Rectangle {
width: 8,
height: 7,
};
let smaller = Rectangle {
width: 5,
height: 1,
};
assert!(!smaller.can_hold(&larger));
}
}Правильный результат can_hold в этом случае — false, поэтому перед
передачей в assert! его нужно инвертировать. Тогда тест пройдёт, если
can_hold вернёт false:
$ cargo test
Compiling rectangle v0.1.0 (file:///projects/rectangle)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.66s
Running unittests src/lib.rs (target/debug/deps/rectangle-6584c4561e48942e)
running 2 tests
test tests::larger_can_hold_smaller ... ok
test tests::smaller_cannot_hold_larger ... ok
test result: ok. 2 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests rectangle
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Два теста проходят! Теперь посмотрим, что будет с результатами тестов, если
внести в код баг. Изменим реализацию метода can_hold, заменив при сравнении
ширин знак «больше» (>) на «меньше» (<):
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
// --пропуск--
impl Rectangle {
fn can_hold(&self, other: &Rectangle) -> bool {
self.width < other.width && self.height > other.height
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn larger_can_hold_smaller() {
let larger = Rectangle {
width: 8,
height: 7,
};
let smaller = Rectangle {
width: 5,
height: 1,
};
assert!(larger.can_hold(&smaller));
}
#[test]
fn smaller_cannot_hold_larger() {
let larger = Rectangle {
width: 8,
height: 7,
};
let smaller = Rectangle {
width: 5,
height: 1,
};
assert!(!smaller.can_hold(&larger));
}
}Теперь при запуске тестов получаем:
$ cargo test
Compiling rectangle v0.1.0 (file:///projects/rectangle)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.66s
Running unittests src/lib.rs (target/debug/deps/rectangle-6584c4561e48942e)
running 2 tests
test tests::larger_can_hold_smaller ... FAILED
test tests::smaller_cannot_hold_larger ... ok
failures:
---- tests::larger_can_hold_smaller stdout ----
thread 'tests::larger_can_hold_smaller' (6020788) panicked at src/lib.rs:28:9:
assertion failed: larger.can_hold(&smaller)
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::larger_can_hold_smaller
test result: FAILED. 1 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Тесты поймали баг! larger.width равно 8, а smaller.width — 5, поэтому
сравнение ширин в can_hold теперь возвращает false: 8 не меньше 5.
Проверка равенства с assert_eq! и assert_ne!
Частый способ проверить работу кода — сравнить результат тестируемого кода со
значением, которое он должен вернуть. Можно сделать это макросом assert!,
передав ему выражение с оператором ==. Но такая проверка настолько
распространена, что в стандартной библиотеке для неё есть пара макросов —
assert_eq! и assert_ne!. Они проверяют два аргумента на равенство или
неравенство соответственно. А ещё при провале проверки они выводят оба
значения, так что легче понять, почему тест провалился. Макрос assert! же
сообщает лишь, что выражение == дало false, но не показывает значений,
которые к этому привели.
В листинге 11-7 мы пишем функцию add_two, которая прибавляет к параметру
2, и тестируем её макросом assert_eq!.
pub fn add_two(a: u64) -> u64 {
a + 2
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_adds_two() {
let result = add_two(2);
assert_eq!(result, 4);
}
}add_two макросом assert_eq!Проверим, что тест проходит!
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.58s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::it_adds_two ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Мы создаём переменную result с результатом вызова add_two(2) и передаём
result и 4 аргументами в макрос assert_eq!. Строка вывода для этого
теста — test tests::it_adds_two ... ok, и ok означает, что тест прошёл!
Внесём в код баг, чтобы посмотреть, как выглядит провал assert_eq!. Пусть
функция add_two прибавляет 3:
pub fn add_two(a: u64) -> u64 {
a + 3
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_adds_two() {
let result = add_two(2);
assert_eq!(result, 4);
}
}Снова запустим тесты:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.61s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::it_adds_two ... FAILED
failures:
---- tests::it_adds_two stdout ----
thread 'tests::it_adds_two' (6020955) panicked at src/lib.rs:12:9:
assertion `left == right` failed
left: 5
right: 4
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::it_adds_two
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Тест поймал баг! tests::it_adds_two провалился, и сообщение говорит, что
не выполнилась проверка left == right, а также показывает значения left и
right. Это хорошая отправная точка для отладки: аргумент left, где лежал
результат вызова add_two(2), равен 5, а аргумент right — 4. Нетрудно
представить, как это выручает, когда тестов много.
Заметьте: в некоторых языках и тестовых фреймворках параметры функций проверки
равенства называются expected (ожидаемое) и actual (фактическое), и
порядок аргументов важен. В Rust же они называются left и right, и неважно,
в каком порядке указывать ожидаемое значение и значение, которое выдаёт код.
Проверку в этом тесте можно записать как assert_eq!(4, result) — сообщение о
провале будет тем же: assertion `left == right` failed.
Макрос assert_ne! проходит, если два переданных значения не равны, и
проваливается, если равны. Он особенно полезен, когда мы не знаем, каким
будет значение, но точно знаем, каким оно не должно быть. Например, если
тестируемая функция гарантированно как-то меняет входные данные, но как
именно — зависит от дня недели, в который запускаются тесты, лучше всего
проверить, что выход функции не равен входу.
Под капотом макросы assert_eq! и assert_ne! используют операторы == и
!= соответственно. При провале эти макросы выводят свои аргументы в
отладочном формате, а значит, сравниваемые значения должны реализовывать
трейты PartialEq и Debug. Все примитивные типы и большинство типов
стандартной библиотеки их реализуют. Для собственных структур и
перечислений, чтобы проверять их на равенство, нужно реализовать
PartialEq, а чтобы выводить значения при провале — Debug. Оба трейта
выводимые, как говорилось в листинге 5-12 главы 5, поэтому обычно достаточно
добавить к определению структуры или перечисления аннотацию
#[derive(PartialEq, Debug)]. Подробнее об этих и других выводимых трейтах —
в приложении C, «Выводимые трейты».
Свои сообщения о провале
В макросы assert!, assert_eq! и assert_ne! можно необязательными
аргументами передать собственное сообщение, которое выведется вместе с
сообщением о провале. Все аргументы после обязательных передаются в макрос
format! (о нём — в разделе «Склеивание через + и
format!» главы 8), так что можно передать
строку формата с заполнителями {} и значения для них. Свои сообщения полезны,
чтобы пояснить смысл проверки: когда тест провалится, будет понятнее, в чём
проблема с кодом.
Например, у нас есть функция, которая приветствует человека по имени, и мы хотим проверить, что переданное имя появляется в выводе:
Файл: src/lib.rs
pub fn greeting(name: &str) -> String {
format!("Hello {name}!")
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn greeting_contains_name() {
let result = greeting("Carol");
assert!(result.contains("Carol"));
}
}Требования к программе ещё не согласованы, и мы почти уверены, что Hello в
начале приветствия поменяется. Мы не хотим править тест при каждом изменении
требований, поэтому проверяем не точное равенство значению, которое вернула
greeting, а лишь то, что вывод содержит текст входного параметра.
Теперь внесём баг: пусть greeting не включает name — и посмотрим, как
выглядит провал теста по умолчанию:
pub fn greeting(name: &str) -> String {
String::from("Hello!")
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn greeting_contains_name() {
let result = greeting("Carol");
assert!(result.contains("Carol"));
}
}Запуск теста даёт:
$ cargo test
Compiling greeter v0.1.0 (file:///projects/greeter)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.91s
Running unittests src/lib.rs (target/debug/deps/greeter-170b942eb5bf5e3a)
running 1 test
test tests::greeting_contains_name ... FAILED
failures:
---- tests::greeting_contains_name stdout ----
thread 'tests::greeting_contains_name' (6021143) panicked at src/lib.rs:12:9:
assertion failed: result.contains("Carol")
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::greeting_contains_name
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Здесь сказано лишь, что проверка не прошла и в какой она строке. Полезнее
было бы вывести значение, которое вернула greeting. Добавим своё сообщение
о провале — строку формата с заполнителем, в который подставится фактическое
значение из greeting:
pub fn greeting(name: &str) -> String {
String::from("Hello!")
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn greeting_contains_name() {
let result = greeting("Carol");
assert!(
result.contains("Carol"),
"Greeting did not contain name, value was `{result}`"
);
}
}Теперь при запуске теста сообщение об ошибке информативнее:
$ cargo test
Compiling greeter v0.1.0 (file:///projects/greeter)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.93s
Running unittests src/lib.rs (target/debug/deps/greeter-170b942eb5bf5e3a)
running 1 test
test tests::greeting_contains_name ... FAILED
failures:
---- tests::greeting_contains_name stdout ----
thread 'tests::greeting_contains_name' (6021333) panicked at src/lib.rs:12:9:
Greeting did not contain name, value was `Hello!`
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::greeting_contains_name
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
В выводе теста видно значение, которое мы получили на самом деле, — это поможет понять, что произошло вместо ожидаемого.
Проверка паники с should_panic
Важно проверять не только возвращаемые значения, но и то, что код
обрабатывает ошибочные ситуации так, как мы ожидаем. Вспомните тип Guess,
который мы создали в листинге 9-13 главы 9. Другой код, использующий Guess,
полагается на гарантию, что экземпляры Guess содержат только значения от 1
до 100. Можно написать тест, который проверит, что попытка создать Guess со
значением вне этого диапазона вызывает панику.
Для этого к тестовой функции добавляют атрибут should_panic. Тест проходит,
если код внутри функции паникует, и проваливается, если не паникует.
В листинге 11-8 — тест, проверяющий, что ошибочные ситуации в Guess::new
возникают тогда, когда мы ожидаем.
pub struct Guess {
value: i32,
}
impl Guess {
pub fn new(value: i32) -> Guess {
if value < 1 || value > 100 {
panic!("Guess value must be between 1 and 100, got {value}.");
}
Guess { value }
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
#[should_panic]
fn greater_than_100() {
Guess::new(200);
}
}panic!Атрибут #[should_panic] ставится после атрибута #[test] и перед тестовой
функцией, к которой относится. Посмотрим на результат, когда тест проходит:
$ cargo test
Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.58s
Running unittests src/lib.rs (target/debug/deps/guessing_game-57d70c3acb738f4d)
running 1 test
test tests::greater_than_100 - should panic ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests guessing_game
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Выглядит отлично! Теперь внесём баг: уберём условие, при котором функция new
паникует, если значение больше 100:
pub struct Guess {
value: i32,
}
// --пропуск--
impl Guess {
pub fn new(value: i32) -> Guess {
if value < 1 {
panic!("Guess value must be between 1 and 100, got {value}.");
}
Guess { value }
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
#[should_panic]
fn greater_than_100() {
Guess::new(200);
}
}Тест из листинга 11-8 провалится:
$ cargo test
Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.62s
Running unittests src/lib.rs (target/debug/deps/guessing_game-57d70c3acb738f4d)
running 1 test
test tests::greater_than_100 - should panic ... FAILED
failures:
---- tests::greater_than_100 stdout ----
note: test did not panic as expected at src/lib.rs:21:8
failures:
tests::greater_than_100
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Сообщение здесь не очень информативное, но, взглянув на тестовую функцию, мы
увидим, что она помечена #[should_panic]. Значит, провал означает, что код в
тестовой функции не вызвал панику.
Тесты с should_panic бывают неточными: такой тест пройдёт, даже если код
запаникует совсем по другой причине, чем мы ожидали. Чтобы сделать тесты с
should_panic точнее, в атрибут should_panic можно добавить необязательный
параметр expected. Тогда тестовая обвязка проверит, что сообщение о панике
содержит указанный текст. Например, в листинге 11-9 изменённый код Guess,
где функция new паникует с разными сообщениями в зависимости от того,
слишком мало значение или слишком велико.
pub struct Guess {
value: i32,
}
// --пропуск--
impl Guess {
pub fn new(value: i32) -> Guess {
if value < 1 {
panic!(
"Guess value must be greater than or equal to 1, got {value}."
);
} else if value > 100 {
panic!(
"Guess value must be less than or equal to 100, got {value}."
);
}
Guess { value }
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
#[should_panic(expected = "less than or equal to 100")]
fn greater_than_100() {
Guess::new(200);
}
}panic! вызывается с сообщением, содержащим указанную подстрокуЭтот тест пройдёт: значение параметра expected в атрибуте should_panic —
подстрока сообщения, с которым паникует Guess::new. Можно было указать и
всё ожидаемое сообщение целиком — в данном случае
Guess value must be less than or equal to 100, got 200. Что именно указывать,
зависит от того, какая часть сообщения уникальна или меняется и насколько
точным должен быть тест. Здесь подстроки достаточно, чтобы убедиться, что код
в тестовой функции выполняет ветку else if value > 100.
Чтобы увидеть, что происходит при провале теста should_panic с expected,
снова внесём баг: поменяем местами тела блоков if value < 1 и
else if value > 100:
pub struct Guess {
value: i32,
}
impl Guess {
pub fn new(value: i32) -> Guess {
if value < 1 {
panic!(
"Guess value must be less than or equal to 100, got {value}."
);
} else if value > 100 {
panic!(
"Guess value must be greater than or equal to 1, got {value}."
);
}
Guess { value }
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
#[should_panic(expected = "less than or equal to 100")]
fn greater_than_100() {
Guess::new(200);
}
}Теперь тест should_panic провалится:
$ cargo test
Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.66s
Running unittests src/lib.rs (target/debug/deps/guessing_game-57d70c3acb738f4d)
running 1 test
test tests::greater_than_100 - should panic ... FAILED
failures:
---- tests::greater_than_100 stdout ----
thread 'tests::greater_than_100' (6021675) panicked at src/lib.rs:12:13:
Guess value must be greater than or equal to 1, got 200.
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
note: panic did not contain expected string
panic message: "Guess value must be greater than or equal to 1, got 200."
expected substring: "less than or equal to 100"
failures:
tests::greater_than_100
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Сообщение говорит, что тест действительно запаниковал, как и ожидалось, но в
сообщении о панике нет ожидаемой строки less than or equal to 100. На самом
деле сообщение было Guess value must be greater than or equal to 1, got 200.
Теперь можно разбираться, где баг!
Result<T, E> в тестах
До сих пор все наши тесты при провале паниковали. Но можно писать и тесты,
использующие Result<T, E>! Вот тест из листинга 11-1, переписанный так, чтобы
использовать Result<T, E> и возвращать Err вместо паники:
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_works() -> Result<(), String> {
let result = add(2, 2);
if result == 4 {
Ok(())
} else {
Err(String::from("two plus two does not equal four"))
}
}
}Теперь функция it_works возвращает Result<(), String>. Вместо вызова
макроса assert_eq! она возвращает Ok(()), если тест прошёл, и Err со
String внутри, если провалился.
Тесты, возвращающие Result<T, E>, позволяют использовать в теле оператор
?. Это удобно, когда тест должен провалиться, если любая операция внутри
него вернёт Err.
К тестам, использующим Result<T, E>, нельзя применять аннотацию
#[should_panic]. Чтобы проверить, что операция возвращает Err, не
применяйте к значению Result<T, E> оператор ?, а используйте
assert!(value.is_err()).
Теперь, когда вы знаете несколько способов писать тесты, посмотрим, что
происходит при их запуске, и разберём разные настройки cargo test.
Управление запуском тестов
Управление запуском тестов
Как cargo run компилирует код и запускает получившийся бинарник, так и
cargo test компилирует код в тестовом режиме и запускает получившийся
тестовый бинарник. По умолчанию бинарник, собранный cargo test, запускает
все тесты параллельно и перехватывает весь вывод, который появляется во время
их работы: этот вывод не показывается, и результаты тестов читать проще. Но
это поведение по умолчанию можно изменить с помощью параметров командной
строки.
Часть параметров командной строки адресована cargo test, а часть —
получившемуся тестовому бинарнику. Чтобы разделить эти два вида аргументов,
сначала пишут аргументы для cargo test, затем разделитель --, а после него
— аргументы для тестового бинарника. cargo test --help покажет параметры,
доступные для cargo test, а cargo test -- --help — параметры, которые можно
указывать после разделителя. Они также описаны в разделе «Tests» книги
The rustc Book.
Параллельный или последовательный запуск
Когда тестов несколько, по умолчанию они запускаются параллельно в разных потоках: так они быстрее заканчиваются, и обратную связь вы получаете раньше. Но раз тесты выполняются одновременно, нужно следить, чтобы они не зависели друг от друга и от общего состояния — в том числе от общего окружения, например текущей рабочей папки или переменных окружения.
Допустим, каждый ваш тест запускает код, который создаёт на диске файл test-output.txt и пишет в него какие-то данные. Затем тест читает данные из файла и проверяет, что в нём определённое значение — своё для каждого теста. Поскольку тесты идут одновременно, один тест может перезаписать файл в промежутке между тем, как другой тест записал файл и прочитал его. Тогда этот второй тест провалится — не потому, что код неправильный, а потому, что тесты помешали друг другу, работая параллельно. Одно решение — сделать так, чтобы каждый тест писал в свой файл. Другое — запускать тесты по одному.
Если вы не хотите запускать тесты параллельно или хотите точнее управлять
количеством потоков, передайте тестовому бинарнику флаг --test-threads с
нужным числом потоков. Например:
$ cargo test -- --test-threads=1
Мы задали число тестовых потоков равным 1, то есть запретили программе
всякий параллелизм. В одном потоке тесты будут идти дольше, чем параллельно,
зато не помешают друг другу, даже если у них общее состояние.
Вывод функций в тестах
По умолчанию, если тест прошёл, тестовая библиотека Rust перехватывает всё,
что выводится в стандартный вывод. Например, если вызвать в тесте println!
и тест пройдёт, вывода println! в терминале мы не увидим — только строку о
том, что тест прошёл. А если тест провалится, всё, что было выведено в
стандартный вывод, появится вместе с остальным сообщением о провале.
Для примера в листинге 11-10 — нелепая функция, которая выводит значение своего параметра и возвращает 10, а также один проходящий тест и один проваливающийся.
fn prints_and_returns_10(a: i32) -> i32 {
println!("I got the value {a}");
10
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn this_test_will_pass() {
let value = prints_and_returns_10(4);
assert_eq!(value, 10);
}
#[test]
fn this_test_will_fail() {
let value = prints_and_returns_10(8);
assert_eq!(value, 5);
}
}println!Запустив эти тесты через cargo test, мы увидим:
$ cargo test
Compiling silly-function v0.1.0 (file:///projects/silly-function)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.58s
Running unittests src/lib.rs (target/debug/deps/silly_function-160869f38cff9166)
running 2 tests
test tests::this_test_will_fail ... FAILED
test tests::this_test_will_pass ... ok
failures:
---- tests::this_test_will_fail stdout ----
I got the value 8
thread 'tests::this_test_will_fail' (6019863) panicked at src/lib.rs:19:9:
assertion `left == right` failed
left: 10
right: 5
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::this_test_will_fail
test result: FAILED. 1 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Обратите внимание: нигде в выводе нет строки I got the value 4, которую
печатает проходящий тест, — этот вывод перехвачен. А вывод проваленного теста,
I got the value 8, появляется в разделе итогов вместе с причиной провала.
Если мы хотим видеть выведенные значения и у проходящих тестов, можно
попросить Rust показывать вывод успешных тестов флагом --show-output:
$ cargo test -- --show-output
Снова запустив тесты из листинга 11-10 с флагом --show-output, увидим:
$ cargo test -- --show-output
Compiling silly-function v0.1.0 (file:///projects/silly-function)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.60s
Running unittests src/lib.rs (target/debug/deps/silly_function-160869f38cff9166)
running 2 tests
test tests::this_test_will_fail ... FAILED
test tests::this_test_will_pass ... ok
successes:
---- tests::this_test_will_pass stdout ----
I got the value 4
successes:
tests::this_test_will_pass
failures:
---- tests::this_test_will_fail stdout ----
I got the value 8
thread 'tests::this_test_will_fail' (6022313) panicked at src/lib.rs:19:9:
assertion `left == right` failed
left: 10
right: 5
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::this_test_will_fail
test result: FAILED. 1 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Запуск части тестов по имени
Полный набор тестов иногда выполняется долго. Если вы работаете над
конкретной частью кода, вам, скорее всего, захочется запускать только
относящиеся к ней тесты. Выбрать, какие тесты запускать, можно, передав cargo test аргументом
имя или имена нужных тестов.
Чтобы показать, как запускать часть тестов, создадим сначала три теста для
функции add_two, как в листинге 11-11, и будем выбирать, какие из них
запускать.
pub fn add_two(a: u64) -> u64 {
a + 2
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn add_two_and_two() {
let result = add_two(2);
assert_eq!(result, 4);
}
#[test]
fn add_three_and_two() {
let result = add_two(3);
assert_eq!(result, 5);
}
#[test]
fn one_hundred() {
let result = add_two(100);
assert_eq!(result, 102);
}
}Если запустить тесты без аргументов, то, как мы уже видели, все они пойдут параллельно:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.62s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 3 tests
test tests::add_three_and_two ... ok
test tests::add_two_and_two ... ok
test tests::one_hundred ... ok
test result: ok. 3 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Запуск одного теста
Чтобы запустить только один тест, передайте cargo test имя его функции:
$ cargo test one_hundred
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.69s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::one_hundred ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 2 filtered out; finished in 0.00s
Запустился только тест one_hundred — два других под это имя не подошли.
Строка 2 filtered out в конце вывода сообщает, что были и другие тесты, но
они не запускались.
Указать так имена нескольких тестов нельзя: cargo test использует только
первое переданное значение. Но способ запустить несколько тестов есть.
Фильтрация: запуск нескольких тестов
Можно указать часть имени теста — тогда запустятся все тесты, в имени которых
она встречается. Например, в именах двух наших тестов есть add, так что их
можно запустить командой cargo test add:
$ cargo test add
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.61s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 2 tests
test tests::add_three_and_two ... ok
test tests::add_two_and_two ... ok
test result: ok. 2 passed; 0 failed; 0 ignored; 0 measured; 1 filtered out; finished in 0.00s
Эта команда запустила все тесты, в имени которых есть add, и отфильтровала
тест one_hundred. Заметьте также, что модуль, в котором находится тест,
становится частью имени теста, — так что можно запустить все тесты модуля,
отфильтровав по его имени.
Игнорируем тесты, если их не запросили явно
Иногда отдельные тесты выполняются очень долго, и при большинстве запусков
cargo test их хочется пропускать. Вместо того чтобы перечислять аргументами
все тесты, которые нужно запустить, можно пометить долгие тесты атрибутом
ignore и тем самым исключить их:
Файл: src/lib.rs
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_works() {
let result = add(2, 2);
assert_eq!(result, 4);
}
#[test]
#[ignore]
fn expensive_test() {
// код, который выполняется целый час
}
}После #[test] у теста, который хотим исключить, добавляем строку
#[ignore]. Теперь при запуске тестов it_works выполняется, а
expensive_test — нет:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.60s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 2 tests
test tests::expensive_test ... ignored
test tests::it_works ... ok
test result: ok. 1 passed; 0 failed; 1 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Функция expensive_test отмечена как ignored. Если нужно запустить только
игнорируемые тесты, используйте cargo test -- --ignored:
$ cargo test -- --ignored
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.61s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::expensive_test ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 1 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Управляя тем, какие тесты запускаются, можно добиться, чтобы cargo test
выдавал результаты быстро. А когда придёт время проверить и ignored-тесты и
будет время дождаться результатов, запустите cargo test -- --ignored. Чтобы
запустить все тесты — и игнорируемые, и обычные, — используйте
cargo test -- --include-ignored.
Организация тестов
Организация тестов
Как мы говорили в начале главы, тестирование — сложная дисциплина, и разные люди используют разную терминологию и по-разному организуют тесты. Сообщество Rust делит тесты на две основные категории: модульные и интеграционные. Модульные тесты (unit tests) — маленькие и узконаправленные: они проверяют один модуль в изоляции от остального кода и могут тестировать приватные интерфейсы. Интеграционные тесты (integration tests) находятся полностью вне вашей библиотеки и пользуются вашим кодом так же, как любой другой внешний код: только через публичный интерфейс, причём один тест может затрагивать сразу несколько модулей.
Важно писать тесты обоих видов, чтобы убедиться, что части вашей библиотеки делают то, что ожидается, — и по отдельности, и вместе.
Модульные тесты
Задача модульных тестов — проверить каждую единицу кода отдельно от
остального кода, чтобы быстро найти, где код работает как надо, а где нет.
Модульные тесты кладут в папку src — в каждый файл рядом с тем кодом,
который они проверяют. По соглашению в каждом файле создают модуль tests
для тестовых функций и помечают его атрибутом cfg(test).
Модуль tests и #[cfg(test)]
Аннотация #[cfg(test)] у модуля tests говорит Rust компилировать и
запускать тестовый код только при cargo test, но не при cargo build. Это
экономит время компиляции, когда нужно просто собрать библиотеку, и место в
скомпилированном результате, потому что тесты туда не попадают. Как вы
увидите, интеграционные тесты лежат в другой папке, поэтому аннотация
#[cfg(test)] им не нужна. А вот модульные тесты находятся в тех же файлах,
что и код, поэтому с помощью #[cfg(test)] нужно указать, что в
скомпилированный результат их включать не надо.
Вспомните: когда в первом разделе этой главы мы создали проект adder, Cargo
сгенерировал для нас такой код:
Файл: src/lib.rs
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_works() {
let result = add(2, 2);
assert_eq!(result, 4);
}
}У автоматически созданного модуля tests атрибут cfg (от configuration —
конфигурация) говорит Rust, что следующий за ним элемент нужно включать,
только если задан определённый параметр конфигурации. Здесь это параметр
test, который Rust задаёт при компиляции и запуске тестов. Благодаря
атрибуту cfg Cargo компилирует тестовый код, только когда мы явно
запускаем тесты через cargo test. Это касается не только функций с
#[test], но и любых вспомогательных функций в этом модуле.
Тестирование приватных функций
В сообществе тестировщиков спорят, стоит ли тестировать приватные функции
напрямую, а в других языках это бывает сложно или вовсе невозможно. Каких бы
взглядов на тестирование вы ни придерживались, правила приватности Rust
позволяют тестировать приватные функции. Посмотрите на код в листинге 11-12 с
приватной функцией internal_adder.
pub fn add_two(a: u64) -> u64 {
internal_adder(a, 2)
}
fn internal_adder(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn internal() {
let result = internal_adder(2, 2);
assert_eq!(result, 4);
}
}Обратите внимание: функция internal_adder не помечена pub. Тесты — это
просто код на Rust, а модуль tests — просто ещё один модуль. Как мы
обсуждали в разделе «Пути к элементам в дереве модулей», элементы дочерних модулей могут пользоваться элементами модулей-предков.
В этом тесте мы подключаем все элементы родителя модуля tests через
use super::*, и тест может вызвать internal_adder. Если вы считаете, что
приватные функции тестировать не нужно, — Rust вас к этому никак не
принуждает.
Интеграционные тесты
В Rust интеграционные тесты находятся полностью вне вашей библиотеки. Они пользуются ею так же, как любой другой код, а значит, могут вызывать только функции из её публичного API. Их задача — проверить, правильно ли работают вместе многие части библиотеки. Код, который по отдельности работает правильно, может давать сбои при совместной работе, поэтому покрывать тестами связки частей тоже важно. Чтобы создать интеграционные тесты, сначала нужна папка tests.
Папка tests
Папку tests создают на верхнем уровне проекта, рядом с src. Cargo знает, что в этой папке нужно искать файлы интеграционных тестов. Файлов с тестами можно сделать сколько угодно, и Cargo скомпилирует каждый из них как отдельный крейт.
Создадим интеграционный тест. Оставив в src/lib.rs код из листинга 11-12, создайте папку tests и в ней новый файл tests/integration_test.rs. Структура папок должна выглядеть так:
adder
├── Cargo.lock
├── Cargo.toml
├── src
│ └── lib.rs
└── tests
└── integration_test.rs
Введите в файл tests/integration_test.rs код из листинга 11-13.
use adder::add_two;
#[test]
fn it_adds_two() {
let result = add_two(2);
assert_eq!(result, 4);
}adderКаждый файл в папке tests — отдельный крейт, поэтому нашу библиотеку нужно
подключать в область видимости каждого тестового крейта. Для этого в начале
кода стоит use adder::add_two; — в модульных тестах такое не требовалось.
Помечать код в tests/integration_test.rs атрибутом #[cfg(test)] не нужно:
Cargo обрабатывает папку tests особым образом и компилирует файлы в ней,
только когда запускается cargo test. Запустите cargo test:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 1.31s
Running unittests src/lib.rs (target/debug/deps/adder-1082c4b063a8fbe6)
running 1 test
test tests::internal ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running tests/integration_test.rs (target/debug/deps/integration_test-1082c4b063a8fbe6)
running 1 test
test it_adds_two ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
В выводе три раздела: модульные тесты, интеграционный тест и документационные тесты. Учтите: если в каком-то разделе провалится хотя бы один тест, следующие разделы не запустятся. Например, если провалится модульный тест, вывода для интеграционных и документационных тестов не будет — они запускаются, только если все модульные тесты прошли.
Первый раздел, с модульными тестами, такой же, как мы видели раньше: по
строке на каждый модульный тест (у нас это internal, добавленный в листинге
11-12), а затем итоговая строка для модульных тестов.
Раздел интеграционных тестов начинается со строки
Running tests/integration_test.rs. Дальше идёт по строке на каждую тестовую
функцию этого интеграционного теста и итоговая строка с результатами — прямо
перед началом раздела Doc-tests adder.
У каждого файла интеграционных тестов свой раздел, так что если добавить в папку tests ещё файлы, разделов интеграционных тестов станет больше.
Конкретную функцию интеграционного теста по-прежнему можно запустить, передав
её имя аргументом cargo test. А чтобы запустить все тесты из определённого
файла интеграционных тестов, используйте аргумент --test команды
cargo test и имя файла:
$ cargo test --test integration_test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.64s
Running tests/integration_test.rs (target/debug/deps/integration_test-82e7799c1bc62298)
running 1 test
test it_adds_two ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Эта команда запускает только тесты из файла tests/integration_test.rs.
Подмодули в интеграционных тестах
Когда интеграционных тестов становится больше, может захотеться разложить их по нескольким файлам в папке tests — например, сгруппировать тестовые функции по проверяемой функциональности. Как уже говорилось, каждый файл в папке tests компилируется как отдельный крейт. Это удобно: получаются отдельные области видимости, и тесты ближе имитируют то, как конечные пользователи будут работать с вашим крейтом. Но это также значит, что файлы в tests ведут себя не так, как файлы в src, — а ведь в главе 7 вы учились разносить код по модулям и файлам именно в src.
Особенно заметна эта разница, когда у вас есть набор вспомогательных
функций, нужных в нескольких файлах интеграционных тестов, и вы пытаетесь
вынести их в общий модуль, следуя разделу «Разделение модулей на
файлы» главы 7. Например, если
создать tests/common.rs и поместить туда функцию setup с кодом, который мы
хотим вызывать из нескольких тестовых функций в разных файлах:
Файл: tests/common.rs
pub fn setup() {
// здесь был бы код подготовки, нужный тестам вашей библиотеки
}то при следующем запуске тестов в выводе появится новый раздел для файла
common.rs, хотя тестовых функций в нём нет и setup мы ниоткуда не
вызывали:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.89s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::internal ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running tests/common.rs (target/debug/deps/common-92948b65e88960b4)
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running tests/integration_test.rs (target/debug/deps/integration_test-92948b65e88960b4)
running 1 test
test it_adds_two ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Нам вовсе не нужно, чтобы common появлялся в результатах тестов с пометкой
running 0 tests. Мы просто хотели поделиться кодом с другими файлами
интеграционных тестов. Чтобы common не появлялся в выводе, создадим не
tests/common.rs, а tests/common/mod.rs. Теперь структура проекта такая:
├── Cargo.lock
├── Cargo.toml
├── src
│ └── lib.rs
└── tests
├── common
│ └── mod.rs
└── integration_test.rs
Это старое соглашение об именах, которое Rust тоже понимает, — мы упоминали
его в разделе «Альтернативные пути к файлам»
главы 7. Такое имя файла говорит Rust не считать модуль common файлом
интеграционных тестов. Если перенести код функции setup в
tests/common/mod.rs и удалить tests/common.rs, лишний раздел в выводе
тестов исчезнет. Файлы во вложенных папках внутри tests не компилируются как
отдельные крейты, и разделов в выводе тестов у них нет.
Теперь tests/common/mod.rs можно подключать как модуль в любом файле
интеграционных тестов. Вот пример вызова функции setup из теста
it_adds_two в tests/integration_test.rs:
Файл: tests/integration_test.rs
use adder::add_two;
mod common;
#[test]
fn it_adds_two() {
common::setup();
let result = add_two(2);
assert_eq!(result, 4);
}Заметьте, что объявление mod common; — точно такое же объявление модуля, как
в листинге 7-21. А в тестовой функции можно вызвать common::setup().
Интеграционные тесты для бинарных крейтов
Если проект — бинарный крейт, в котором есть только src/main.rs и нет
src/lib.rs, то создать интеграционные тесты в папке tests и подключить
через use функции из src/main.rs не получится. Функции, которыми могут
пользоваться другие крейты, открывают только библиотечные крейты, а бинарные
предназначены для самостоятельного запуска.
Это одна из причин, по которым в проектах на Rust с бинарником файл
src/main.rs обычно простой и вызывает логику, которая лежит в src/lib.rs.
При такой структуре интеграционные тесты могут тестировать библиотечный
крейт, подключая через use всю важную функциональность. Если важная
функциональность работает, то и немногочисленный код в src/main.rs тоже
будет работать, и тестировать его отдельно не нужно.
Итоги
Средства тестирования в Rust позволяют описать, как должен работать код, и убедиться, что он продолжает работать как ожидается, даже когда вы его меняете. Модульные тесты проверяют разные части библиотеки по отдельности и могут тестировать приватные детали реализации. Интеграционные тесты проверяют, что многие части библиотеки правильно работают вместе, и пользуются её публичным API — так же, как будет пользоваться внешний код. Хотя система типов и правила владения в Rust помогают предотвратить некоторые виды багов, тесты всё равно важны: они помогают ловить логические ошибки в том, как должен вести себя ваш код.
Давайте соединим знания из этой и предыдущих глав и поработаем над проектом!
Проект с вводом-выводом: утилита командной строки
Эта глава — повторение многих навыков, которые вы уже освоили, плюс знакомство с ещё несколькими возможностями стандартной библиотеки. Мы напишем утилиту командной строки, которая работает с файлами и с вводом-выводом командной строки, и попрактикуемся в тех понятиях Rust, которые вы уже знаете.
Скорость, безопасность, сборка в один бинарный файл и кроссплатформенность
делают Rust идеальным языком для утилит командной строки. Поэтому в нашем
проекте мы сделаем собственную версию классической утилиты поиска grep
(globally search a regular expression and print — «глобально
найти по регулярному выражению и вывести»). В простейшем случае grep ищет
заданный текст в заданном файле. Для этого grep принимает аргументами путь
к файлу и искомую строку, затем читает файл, находит в нём строки, где
встречается искомый текст, и выводит их.
По ходу дела мы покажем, как научить нашу утилиту пользоваться теми
возможностями терминала, которыми пользуются многие другие утилиты командной
строки. Мы будем читать значение переменной окружения, чтобы пользователь мог
настраивать поведение утилиты. А сообщения об ошибках будем выводить в
стандартный поток ошибок (stderr), а не в стандартный вывод (stdout), —
чтобы, например, пользователь мог перенаправить обычный вывод в файл и при
этом видеть сообщения об ошибках на экране.
Один из участников сообщества Rust, Эндрю Галлант (Andrew Gallant), уже создал
полнофункциональную и очень быструю версию grep — ripgrep. Наша версия
будет куда проще, но эта глава даст вам часть знаний, которые нужны, чтобы
разобраться в настоящем проекте вроде ripgrep.
В нашем проекте grep сойдутся многие понятия, которые вы уже изучили:
- организация кода (глава 7);
- векторы и строки (глава 8);
- обработка ошибок (глава 9);
- трейты и времена жизни там, где они уместны (глава 10);
- тесты (глава 11).
Ещё мы бегло познакомимся с замыканиями, итераторами и трейт-объектами — подробно они разбираются в главе 13 и главе 18.
Аргументы командной строки
Аргументы командной строки
Как обычно, создадим новый проект командой cargo new. Назовём его
minigrep, чтобы не путать с утилитой grep, которая, возможно, уже есть в
вашей системе:
$ cargo new minigrep
Created binary (application) `minigrep` project
$ cd minigrep
Первая задача — научить minigrep принимать два аргумента командной строки:
путь к файлу и строку для поиска. То есть мы хотим запускать программу через
cargo run, затем два дефиса (они говорят, что следующие аргументы — для
нашей программы, а не для cargo), строку для поиска и путь к файлу, в
котором искать:
$ cargo run -- searchstring example-filename.txt
Сейчас программа, сгенерированная cargo new, не умеет обрабатывать
переданные ей аргументы. На crates.io есть библиотеки,
которые помогают писать программы с аргументами командной строки, но раз вы
только изучаете эту тему, реализуем всё сами.
Чтение значений аргументов
Чтобы minigrep мог читать переданные ему аргументы командной строки,
понадобится функция std::env::args из стандартной библиотеки Rust. Она
возвращает итератор по аргументам командной строки, переданным minigrep.
Подробно итераторы мы разберём в главе 13. А пока
достаточно знать о них две вещи: итератор выдаёт последовательность значений,
и у итератора можно вызвать метод collect, чтобы превратить его в
коллекцию — например, в вектор, — содержащую все выданные им элементы.
Код из листинга 12-1 позволяет программе minigrep прочитать все переданные
ей аргументы командной строки и собрать их в вектор.
use std::env;
fn main() {
let args: Vec<String> = env::args().collect();
dbg!(args);
}Сначала инструкцией use подключаем модуль std::env, чтобы пользоваться его
функцией args. Заметьте, что функция std::env::args вложена в два уровня
модулей. Как мы обсуждали в главе 7, если
нужная функция вложена больше чем в один модуль, мы подключаем родительский
модуль, а не саму функцию. Так можно легко пользоваться и другими функциями
из std::env. К тому же это однозначнее, чем написать use std::env::args и
вызывать функцию просто как args: args легко принять за функцию,
определённую в текущем модуле.
Функция args и некорректный Юникод
Учтите, что std::env::args запаникует, если какой-то аргумент содержит
некорректный Юникод. Если программе нужно принимать такие аргументы,
используйте std::env::args_os. Эта функция возвращает итератор, который
выдаёт значения OsString вместо String. Здесь мы для простоты взяли
std::env::args: значения OsString на разных платформах устроены
по-разному, и работать с ними сложнее, чем со String.
В первой строке main мы вызываем env::args и сразу же с помощью collect
превращаем итератор в вектор со всеми значениями, которые он выдаёт. Функция
collect умеет создавать коллекции самых разных видов, поэтому мы явно
указываем тип args: нам нужен вектор строк. В Rust аннотации типов нужны
очень редко, но collect — как раз одна из функций, где они часто нужны:
Rust не может сам вывести, какая коллекция вам нужна.
Наконец, выводим вектор отладочным макросом. Запустим код сначала без аргументов, а потом с двумя аргументами:
$ cargo run
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.61s
Running `target/debug/minigrep`
[src/main.rs:5:5] args = [
"target/debug/minigrep",
]
$ cargo run -- needle haystack
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 1.57s
Running `target/debug/minigrep needle haystack`
[src/main.rs:5:5] args = [
"target/debug/minigrep",
"needle",
"haystack",
]
Обратите внимание: первое значение в векторе — "target/debug/minigrep", имя
нашего бинарника. Так же устроен список аргументов в C: программа может
узнать, под каким именем её запустили. Это часто удобно: например, чтобы
выводить имя программы в сообщениях или менять поведение программы в
зависимости от того, через какой псевдоним командной строки её вызвали. Но в
этой главе оно нам не нужно, так что мы его пропустим и сохраним только два
нужных аргумента.
Сохраняем значения аргументов в переменные
Программа уже умеет получать значения, переданные как аргументы командной строки. Теперь нужно сохранить значения двух аргументов в переменные, чтобы пользоваться ими в остальной программе. Это сделано в листинге 12-2.
use std::env;
fn main() {
let args: Vec<String> = env::args().collect();
let query = &args[1];
let file_path = &args[2];
println!("Searching for {query}");
println!("In file {file_path}");
}Как мы видели при выводе вектора, имя программы занимает первый элемент
вектора, args[0], поэтому аргументы начинаются с индекса 1. Первый аргумент
minigrep — строка для поиска, и ссылку на него мы кладём в переменную
query (запрос). Второй аргумент — путь к файлу, и ссылку на него мы кладём в
переменную file_path.
Мы временно выводим значения этих переменных, чтобы убедиться, что код
работает как задумано. Запустим программу снова с аргументами test и
sample.txt:
$ cargo run -- test sample.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep test sample.txt`
Searching for test
In file sample.txt
Отлично, программа работает! Значения нужных аргументов сохраняются в правильные переменные. Позже мы добавим обработку ошибок для некоторых нештатных ситуаций — например, когда пользователь не передал ни одного аргумента. А пока не будем об этом думать и займёмся чтением файла.
Чтение файла
Чтение файла
Теперь добавим чтение файла, путь к которому передан в аргументе
file_path. Сначала нужен тестовый файл: возьмём файл с небольшим
многострочным текстом, где некоторые слова повторяются. Отлично подойдёт
стихотворение Эмили Дикинсон из листинга 12-3! Создайте в корне проекта файл
poem.txt и введите в него стихотворение «I’m Nobody! Who are you?» («Я —
никто! А ты кто?»).
I'm nobody! Who are you?
Are you nobody, too?
Then there's a pair of us - don't tell!
They'd banish us, you know.
How dreary to be somebody!
How public, like a frog
To tell your name the livelong day
To an admiring bog!
Текст на месте — теперь отредактируйте src/main.rs и добавьте код чтения файла, как в листинге 12-4.
use std::env;
use std::fs;
fn main() {
// --пропуск--
let args: Vec<String> = env::args().collect();
let query = &args[1];
let file_path = &args[2];
println!("Searching for {query}");
println!("In file {file_path}");
let contents = fs::read_to_string(file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}Сначала инструкцией use подключаем нужную часть стандартной библиотеки: для
работы с файлами нам понадобится std::fs.
В main новая инструкция fs::read_to_string принимает file_path,
открывает этот файл и возвращает значение типа std::io::Result<String> с
содержимым файла.
После этого мы снова добавляем временный println!, который выводит значение
contents после чтения файла, — чтобы проверить, что программа пока работает.
Запустим код, передав первым аргументом любую строку (поиск мы ещё не реализовали), а вторым — файл poem.txt:
$ cargo run -- the poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep the poem.txt`
Searching for the
In file poem.txt
With text:
I'm nobody! Who are you?
Are you nobody, too?
Then there's a pair of us - don't tell!
They'd banish us, you know.
How dreary to be somebody!
How public, like a frog
To tell your name the livelong day
To an admiring bog!
Отлично! Код прочитал и вывел содержимое файла. Но у него есть недостатки.
Сейчас у функции main несколько обязанностей, а функции обычно понятнее и
проще в поддержке, если каждая отвечает только за что-то одно. Другая
проблема — мы обрабатываем ошибки не так хорошо, как могли бы. Программа пока
маленькая, и эти недостатки не страшны, но по мере её роста исправлять их
аккуратно будет всё труднее. Рефакторинг лучше начинать на ранних этапах
разработки: маленький объём кода переделывать гораздо проще. Этим мы сейчас и
займёмся.
Рефакторинг: модульность и обработка ошибок
Рефакторинг: модульность и обработка ошибок
Чтобы улучшить программу, исправим четыре проблемы, связанные с её
структурой и обработкой возможных ошибок. Первая: сейчас функция main делает
две вещи — разбирает аргументы и читает файл. По мере роста программы
отдельных задач у main будет становиться всё больше. Чем больше
обязанностей у функции, тем сложнее о ней рассуждать, тем труднее её
тестировать и тем легче, меняя её, что-нибудь сломать. Лучше разделить
функциональность так, чтобы каждая функция отвечала за одну задачу.
С этим связана и вторая проблема: query и file_path — это настройки
программы, а переменные вроде contents нужны для её логики. Чем длиннее
main, тем больше переменных придётся держать в области видимости, а чем их
больше, тем сложнее помнить, зачем нужна каждая. Лучше собрать настройки в
одну структуру, чтобы их назначение было очевидным.
Третья проблема: при ошибке чтения файла мы выводим сообщение через expect,
но оно говорит только Should have been able to read the file («файл должен
был прочитаться»). А прочитать файл не удаётся по разным причинам: например,
файла нет или у нас нет прав на его открытие. Сейчас при любой ситуации мы
выводим одно и то же сообщение, которое ничего не говорит пользователю!
Четвёртая: мы обрабатываем ошибку через expect, и если пользователь
запустит программу, не передав достаточно аргументов, он получит от Rust
ошибку index out of bounds, которая толком не объясняет проблему. Лучше,
чтобы весь код обработки ошибок был в одном месте: тогда тем, кто будет
поддерживать код, придётся заглядывать только в одно место, если логику
обработки ошибок понадобится поменять. Заодно так мы точно будем выводить
сообщения, понятные конечным пользователям.
Решим эти четыре проблемы, проведя рефакторинг проекта.
Разделение ответственности в бинарных проектах
Проблема с тем, что на функцию main взвалено несколько задач, свойственна
многим бинарным проектам. Поэтому многие программисты на Rust, когда main
начинает разрастаться, разделяют обязанности бинарной программы. Делается это
так:
- Разбейте программу на файлы main.rs и lib.rs и перенесите логику программы в lib.rs.
- Пока логика разбора командной строки небольшая, она может оставаться в
функции
main. - Когда логика разбора командной строки начинает усложняться, вынесите её из
mainв отдельные функции или типы.
После этого у функции main должны остаться только такие обязанности:
- вызвать логику разбора командной строки со значениями аргументов;
- выполнить прочую настройку;
- вызвать функцию
runиз lib.rs; - обработать ошибку, если
runеё вернула.
Суть этого шаблона — разделение ответственности: main.rs отвечает за запуск
программы, а lib.rs — за всю логику решаемой задачи. Функцию main нельзя
протестировать напрямую, а при такой структуре вся логика программы вынесена
из main, и её можно тестировать. Код, оставшийся в main, будет настолько
маленьким, что в его правильности можно убедиться, просто прочитав его.
Переделаем нашу программу по этой схеме.
Выносим разбор аргументов
Вынесем разбор аргументов в функцию, которую будет вызывать main. В
листинге 12-5 — новое начало функции main, которое вызывает новую функцию
parse_config; определим её в src/main.rs.
use std::env;
use std::fs;
fn main() {
let args: Vec<String> = env::args().collect();
let (query, file_path) = parse_config(&args);
// --пропуск--
println!("Searching for {query}");
println!("In file {file_path}");
let contents = fs::read_to_string(file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}
fn parse_config(args: &[String]) -> (&str, &str) {
let query = &args[1];
let file_path = &args[2];
(query, file_path)
}main функцию parse_configМы по-прежнему собираем аргументы командной строки в вектор. Но теперь main
не раскладывает их сама (аргумент с индексом 1 — в query, с индексом 2 — в
file_path), а передаёт весь вектор в функцию parse_config. Решать, какой
аргумент в какую переменную попадает, теперь будет parse_config, а готовые
значения она вернёт в main.
Переменные query и file_path мы по-прежнему создаём в main, но main
больше не отвечает за соответствие между аргументами командной строки и
переменными.
Для нашей маленькой программы такая переделка может показаться излишней, но мы проводим рефакторинг маленькими шагами. После этого изменения снова запустите программу и убедитесь, что разбор аргументов работает. Полезно почаще проверять результат: если что-то сломается, проще будет найти причину.
Группируем настройки
Функцию parse_config можно улучшить ещё одним маленьким шагом. Сейчас она
возвращает кортеж, который мы тут же снова разбираем на части. Это признак
того, что подходящей абстракции у нас пока нет.
Есть и другой признак, что код можно улучшить: часть config в имени
parse_config подразумевает, что два возвращаемых значения связаны между
собой и вместе составляют одну конфигурацию. Сейчас мы никак не выражаем этот
смысл в структуре данных, разве что объединяем два значения в кортеж. Вместо
этого положим оба значения в одну структуру и дадим каждому полю осмысленное
имя. Так тем, кто будет поддерживать код, будет проще понять, как связаны
разные значения и зачем они нужны.
В листинге 12-6 — улучшенная функция parse_config.
use std::env;
use std::fs;
fn main() {
let args: Vec<String> = env::args().collect();
let config = parse_config(&args);
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
// --пропуск--
println!("With text:\n{contents}");
}
struct Config {
query: String,
file_path: String,
}
fn parse_config(args: &[String]) -> Config {
let query = args[1].clone();
let file_path = args[2].clone();
Config { query, file_path }
}parse_config, чтобы она возвращала экземпляр структуры ConfigМы добавили структуру Config с полями query и file_path. Сигнатура
parse_config теперь говорит, что функция возвращает значение Config. Раньше
в теле parse_config мы возвращали строковые срезы, ссылающиеся на значения
String в args, а теперь Config хранит собственные значения String.
Владелец значений аргументов — переменная args в main, и она лишь даёт
parse_config их позаимствовать. Значит, если бы Config попыталась забрать
владение значениями из args, мы нарушили бы правила заимствования Rust.
Управлять данными String можно по-разному. Самый простой, хоть и не самый
эффективный путь — вызвать у значений метод clone. Так Config получит
собственную полную копию данных, что требует больше времени и памяти, чем
хранение ссылки на строку. Зато клонирование делает код очень простым: не
нужно управлять временами жизни ссылок. В данной ситуации пожертвовать
небольшой долей производительности ради простоты — разумный компромисс.
Цена clone
Многие растацеаны стараются не решать проблемы владения через clone из-за
его цены во время выполнения. В главе 13 вы узнаете
более эффективные способы для таких ситуаций. Но сейчас вполне можно
скопировать пару строк, чтобы двигаться дальше: копирование происходит лишь
один раз, а путь к файлу и строка запроса очень маленькие. Лучше рабочая,
хоть и не самая эффективная программа, чем попытка сверхоптимизировать код с
первого захода. С опытом вам будет проще сразу писать самое эффективное
решение, а пока вызывать clone — совершенно нормально.
Мы изменили main: теперь экземпляр Config, который возвращает
parse_config, кладётся в переменную config. А код, который раньше
использовал отдельные переменные query и file_path, теперь использует поля
структуры Config.
Теперь из кода яснее видно, что query и file_path связаны и что они
задают поведение программы. Любой код, которому нужны эти значения, знает, что
искать их надо в экземпляре config, в полях с говорящими именами.
Конструктор для Config
Мы вынесли из main логику разбора аргументов командной строки в функцию
parse_config. Это помогло увидеть, что значения query и file_path связаны
и эту связь нужно выразить в коде. Затем мы добавили структуру Config: она
даёт общее имя связке query и file_path, а parse_config теперь
возвращает именованные поля, а не безымянный кортеж.
Раз теперь задача parse_config — создавать экземпляр Config, её можно
превратить из обычной функции в функцию new, ассоциированную со структурой
Config. Так код станет идиоматичнее. Экземпляры типов стандартной
библиотеки, например String, создаются вызовом String::new. Точно так же,
превратив parse_config в функцию new, ассоциированную с Config, мы сможем
создавать экземпляры Config вызовом Config::new. В листинге 12-7 показаны
нужные изменения.
use std::env;
use std::fs;
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::new(&args);
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
// --пропуск--
}
// --пропуск--
struct Config {
query: String,
file_path: String,
}
impl Config {
fn new(args: &[String]) -> Config {
let query = args[1].clone();
let file_path = args[2].clone();
Config { query, file_path }
}
}parse_config в Config::newВ main вместо вызова parse_config теперь вызывается Config::new. Мы
переименовали parse_config в new и перенесли её в блок impl, который
связывает функцию new с Config. Скомпилируйте код ещё раз и убедитесь, что
всё работает.
Исправляем обработку ошибок
Теперь займёмся обработкой ошибок. Напомним: если в векторе args меньше трёх
элементов, обращение к элементам с индексами 1 или 2 вызовет панику.
Попробуйте запустить программу без аргументов — получится так:
$ cargo run
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep`
thread 'main' (6023615) panicked at src/main.rs:27:21:
index out of bounds: the len is 1 but the index is 1
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
Строка index out of bounds: the len is 1 but the index is 1 — сообщение для
программистов. Конечному пользователю оно не поможет понять, что делать.
Исправим это.
Улучшаем сообщение об ошибке
В листинге 12-8 мы добавляем в функцию new проверку, что срез достаточно
длинный, прежде чем обращаться к индексам 1 и 2. Если срез слишком короткий,
программа паникует и выводит более понятное сообщение.
use std::env;
use std::fs;
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::new(&args);
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}
struct Config {
query: String,
file_path: String,
}
impl Config {
// --пропуск--
fn new(args: &[String]) -> Config {
if args.len() < 3 {
panic!("not enough arguments");
}
// --пропуск--
let query = args[1].clone();
let file_path = args[2].clone();
Config { query, file_path }
}
}Этот код похож на функцию Guess::new из листинга 9-13, где мы вызывали panic!, если аргумент value выходил за пределы
допустимых значений. Только здесь мы проверяем не диапазон значений, а длину
args: в нём должно быть хотя бы три элемента, и остальная часть функции
может на это рассчитывать. Если элементов меньше трёх, условие в if
истинно, и мы вызываем макрос panic!, чтобы сразу завершить программу.
С этими несколькими строками в new снова запустим программу без аргументов
и посмотрим, как теперь выглядит ошибка:
$ cargo run
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep`
thread 'main' (6023776) panicked at src/main.rs:26:13:
not enough arguments
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
Так лучше: теперь сообщение об ошибке осмысленное. Но в выводе есть и лишняя
информация, которую пользователям показывать не нужно. Возможно, приём из
листинга 9-13 здесь не лучший: как обсуждалось в главе
9, panic! больше подходит для ошибок
программирования, чем для ошибок использования. Вместо этого воспользуемся
другим приёмом из главы 9 — вернём Result,
который означает либо успех, либо ошибку.
Возвращаем Result вместо вызова panic!
Можно возвращать значение Result, в котором при успехе будет экземпляр
Config, а при ошибке — описание проблемы. Заодно переименуем функцию из
new в build: многие программисты ожидают, что функции new никогда не
завершаются неудачей. Через тип Result функция Config::build сможет
сообщить main, что возникла проблема. А main уже превратит вариант Err
в понятную пользователю ошибку — без сопутствующего текста про thread 'main'
и RUST_BACKTRACE, который появляется при вызове panic!.
В листинге 12-9 показано, что нужно изменить в возвращаемом значении функции,
которую мы теперь называем Config::build, и в её теле, чтобы она возвращала
Result. Учтите, что код не скомпилируется, пока мы не обновим и main, —
это мы сделаем в следующем листинге.
use std::env;
use std::fs;
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::new(&args);
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}Config::build возвращает ResultФункция build возвращает Result: при успехе — экземпляр Config, при
ошибке — строковый литерал. Значениями ошибок у нас всегда будут строковые
литералы со временем жизни 'static.
В теле функции мы сделали два изменения: вместо вызова panic!, когда
пользователь передал недостаточно аргументов, теперь возвращается значение
Err, а возвращаемое значение Config мы обернули в Ok. С этими
изменениями функция соответствует своей новой сигнатуре.
Теперь, когда Config::build умеет возвращать Err, функция main может
сама разобрать Result, который вернула build, и при ошибке завершить
процесс аккуратнее.
Вызываем Config::build и обрабатываем ошибки
Чтобы обработать ошибку и вывести понятное пользователю сообщение, нужно
изменить main так, чтобы она обрабатывала Result, который возвращает
Config::build, — как в листинге 12-10. Заодно мы забираем у panic!
обязанность завершать утилиту с ненулевым кодом ошибки и реализуем это сами.
Ненулевой код завершения — это соглашение, которым программа сообщает
вызвавшему её процессу, что завершилась с ошибкой.
use std::env;
use std::fs;
use std::process;
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
// --пропуск--
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}Config не удалосьВ этом листинге используется метод, который мы ещё не разбирали подробно, —
unwrap_or_else, определённый в стандартной библиотеке для Result<T, E>.
unwrap_or_else позволяет задать собственную обработку ошибки без panic!.
Если Result — это Ok, метод ведёт себя как unwrap: возвращает значение,
обёрнутое в Ok. Если же это Err, метод вызывает код замыкания — анонимной
функции, которую мы определяем и передаём аргументом в unwrap_or_else.
Подробнее о замыканиях — в главе 13. Пока достаточно
знать, что unwrap_or_else передаст внутреннее значение Err — в нашем
случае статическую строку "not enough arguments" из листинга 12-9 — в наше
замыкание, в аргумент err, указанный между вертикальными чертами. Код
замыкания может пользоваться значением err.
Мы добавили строку use, чтобы подключить process из стандартной
библиотеки. Код замыкания, который выполняется при ошибке, — всего две
строки: выводим значение err и вызываем process::exit. Функция
process::exit немедленно останавливает программу и возвращает переданное
число как код завершения. Это похоже на обработку через panic! из листинга
12-8, только без лишнего вывода. Попробуем:
$ cargo run
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.48s
Running `target/debug/minigrep`
Problem parsing arguments: not enough arguments
Отлично! Такой вывод гораздо дружелюбнее к пользователям.
Выносим логику из main
С разбором конфигурации разобрались — займёмся логикой программы. Как мы
говорили в разделе «Разделение ответственности в бинарных
проектах»,
вынесем функцию run, в которой будет вся логика из main, не связанная с
настройкой конфигурации и обработкой ошибок. В итоге main станет короткой, и
её правильность можно будет проверить на глаз, а для всей остальной логики
можно будет написать тесты.
В листинге 12-11 — небольшое пошаговое улучшение: выносим функцию run.
use std::env;
use std::fs;
use std::process;
fn main() {
// --пропуск--
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
run(config);
}
fn run(config: Config) {
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}
// --пропуск--
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}run с остальной логикой программыТеперь в функции run вся оставшаяся логика из main, начиная с чтения
файла. Функция run принимает аргументом экземпляр Config.
Возвращаем ошибки из run
Когда остальная логика вынесена в run, можно улучшить обработку ошибок — так
же, как мы сделали с Config::build в листинге 12-9. Вместо того чтобы
давать программе паниковать через expect, функция run будет возвращать
Result<T, E>, если что-то пошло не так. Так мы сможем собрать всю логику
обработки ошибок в main и сделать её дружелюбной к пользователю. В листинге
12-12 — изменения в сигнатуре и теле run.
use std::env;
use std::fs;
use std::process;
use std::error::Error;
// --пропуск--
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
run(config);
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
println!("With text:\n{contents}");
Ok(())
}
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}run теперь возвращает ResultЗдесь три важных изменения. Во-первых, возвращаемый тип run теперь
Result<(), Box<dyn Error>>. Раньше функция возвращала единичный тип (), и
его мы оставляем как значение в случае Ok.
Для типа ошибки мы взяли трейт-объект Box<dyn Error> (и подключили
std::error::Error инструкцией use в начале файла). О трейт-объектах мы
поговорим в главе 18. Пока достаточно знать, что
Box<dyn Error> означает: функция вернёт тип, реализующий трейт Error, но
какой именно — указывать не нужно. Это даёт гибкость: в разных ситуациях
можно возвращать ошибки разных типов. Ключевое слово dyn — сокращение от
dynamic (динамический).
Во-вторых, вместо вызова expect теперь оператор ?, о котором мы говорили в
главе 9. Вместо паники при ошибке ?
вернёт значение ошибки из текущей функции, и её обработает вызывающий код.
В-третьих, при успехе функция run теперь возвращает значение Ok. В
сигнатуре мы объявили тип успеха run как (), значит, нужно обернуть
единичное значение в Ok. Запись Ok(()) поначалу может показаться
странной, но такое использование () — идиоматичный способ показать, что
run вызывается только ради побочных эффектов и нужного нам значения не
возвращает.
Этот код скомпилируется, но с предупреждением:
$ cargo run -- the poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
warning: unused `Result` that must be used
--> src/main.rs:19:5
|
19 | run(config);
| ^^^^^^^^^^^
|
= note: this `Result` may be an `Err` variant, which should be handled
= note: `#[warn(unused_must_use)]` (part of `#[warn(unused)]`) on by default
help: use `let _ = ...` to ignore the resulting value
|
19 | let _ = run(config);
| +++++++
warning: `minigrep` (bin "minigrep") generated 1 warning
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.71s
Running `target/debug/minigrep the poem.txt`
Searching for the
In file poem.txt
With text:
I'm nobody! Who are you?
Are you nobody, too?
Then there's a pair of us - don't tell!
They'd banish us, you know.
How dreary to be somebody!
How public, like a frog
To tell your name the livelong day
To an admiring bog!
Rust сообщает, что наш код проигнорировал значение Result, а это значение
может означать, что произошла ошибка. Мы не проверяем, была ли ошибка, и
компилятор напоминает, что здесь, скорее всего, должен быть код обработки
ошибок! Исправим это.
Обрабатываем в main ошибки из run
Проверять и обрабатывать ошибки будем примерно так же, как с Config::build в
листинге 12-10, но с небольшим отличием:
Файл: src/main.rs
use std::env;
use std::error::Error;
use std::fs;
use std::process;
fn main() {
// --пропуск--
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
println!("With text:\n{contents}");
Ok(())
}
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}Здесь вместо unwrap_or_else используется if let: он проверяет, вернула
ли run значение Err, и если да — вызывает process::exit(1). В отличие от
Config::build, которая возвращает экземпляр Config, run не возвращает
значения, которое нужно было бы «развернуть» (unwrap). При успехе run
возвращает (), так что нас интересует только обнаружение ошибки, и
unwrap_or_else, возвращающий развёрнутое значение (а это был бы просто
()), не нужен.
Тела if let и unwrap_or_else в обоих случаях одинаковы: выводим ошибку и
завершаемся.
Выносим код в библиотечный крейт
Пока проект minigrep выглядит неплохо! Теперь разделим файл src/main.rs и
перенесём часть кода в src/lib.rs. Так код можно будет тестировать, а у
src/main.rs станет меньше обязанностей.
Определим код поиска текста в src/lib.rs, а не в src/main.rs: тогда мы (или
кто угодно, кто пользуется нашей библиотекой minigrep) сможем вызывать
функцию поиска не только из бинарника minigrep.
Сначала определим в src/lib.rs сигнатуру функции search, как в листинге
12-13, а в теле вызовем макрос unimplemented!. Подробнее сигнатуру разберём,
когда будем писать реализацию.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
unimplemented!();
}search в src/lib.rsКлючевое слово pub в определении функции делает search частью публичного
API нашего библиотечного крейта. Теперь у нас есть библиотечный крейт, которым
можно пользоваться из бинарного и который можно тестировать!
Теперь нужно подключить код из src/lib.rs в область видимости бинарного крейта в src/main.rs и вызвать его, как в листинге 12-14.
use std::env;
use std::error::Error;
use std::fs;
use std::process;
// --пропуск--
use minigrep::search;
fn main() {
// --пропуск--
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
// --пропуск--
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
for line in search(&config.query, &contents) {
println!("{line}");
}
Ok(())
}search из библиотечного крейта minigrep в src/main.rsСтрока use minigrep::search подключает функцию search из библиотечного
крейта в область видимости бинарного. Затем в функции run вместо вывода
содержимого файла мы вызываем search, передавая аргументами config.query и
contents. А run в цикле for выводит каждую строку, которую вернула
search, то есть каждую строку, совпавшую с запросом. Самое время убрать и
вызовы println! в main, которые выводили запрос и путь к файлу, — чтобы
программа выводила только результаты поиска (если не произошло ошибок).
Обратите внимание: функция поиска сначала собирает все результаты в вектор, который возвращает, и лишь потом что-то выводится. При поиске в больших файлах результаты могут появляться медленно, ведь они выводятся не по мере нахождения. Как это можно исправить с помощью итераторов, мы обсудим в главе 13.
Уф! Работы было много, но мы заложили основу для будущих успехов. Теперь обрабатывать ошибки гораздо проще, а код стал модульнее. Дальше почти вся работа будет происходить в src/lib.rs.
Воспользуемся новой модульностью и сделаем то, что со старым кодом было бы трудно, а с новым — легко: напишем тесты!
Разработка через тестирование
Разработка через тестирование
Теперь, когда логика поиска лежит в src/lib.rs отдельно от функции main,
писать тесты для основной функциональности гораздо проще. Можно напрямую
вызывать функции с разными аргументами и проверять возвращаемые значения, не
запуская бинарник из командной строки.
В этом разделе мы добавим в программу minigrep логику поиска, следуя
процессу разработки через тестирование (test-driven development, TDD):
- Пишем тест, который проваливается, и запускаем его, чтобы убедиться, что он проваливается именно по той причине, которую мы ожидаем.
- Пишем или меняем ровно столько кода, сколько нужно, чтобы новый тест прошёл.
- Рефакторим только что добавленный или изменённый код и следим, чтобы тесты по-прежнему проходили.
- Повторяем с первого шага!
TDD — лишь один из многих способов писать программы, но он помогает направлять проектирование кода. Если писать тест раньше кода, который его проходит, на протяжении всей работы сохраняется хорошее покрытие тестами.
Тесты будут направлять нас, пока мы пишем саму логику поиска: найти запрос в
содержимом файла и выдать список строк, где он встречается. Эта логика будет
в функции search.
Пишем проваливающийся тест
Добавим в src/lib.rs модуль tests с тестовой функцией, как мы делали в
главе 11. Тестовая функция описывает, как должна
вести себя функция search: она принимает запрос и текст для поиска и
возвращает только те строки текста, в которых есть запрос. Этот тест — в
листинге 12-15.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
unimplemented!();
}
// --пропуск--
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}search проваливающийся тест — на ту функциональность, которую хотим получитьЭтот тест ищет строку "duct". В тексте, где идёт поиск, три строки, и только
в одной из них есть "duct" (обратная косая черта сразу после открывающей
двойной кавычки говорит Rust не ставить перевод строки в начале этого
строкового литерала). Мы проверяем, что функция search вернула только ту
строку, которую мы ожидаем.
Сейчас этот тест провалится: макрос unimplemented! паникует с сообщением
«not implemented». Следуя принципам TDD, сделаем маленький шаг — добавим ровно
столько кода, чтобы вызов функции не паниковал: пусть search всегда
возвращает пустой вектор, как в листинге 12-16. Тогда тест скомпилируется, но
провалится, потому что пустой вектор не совпадает с вектором, где лежит строка
"safe, fast, productive.".
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
vec![]
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}search ровно настолько, чтобы её вызов не паниковалТеперь разберёмся, зачем в сигнатуре search нужно явное время жизни 'a и
почему оно указано у аргумента contents и у возвращаемого значения.
Вспомните из главы 10: параметры времени
жизни указывают, время жизни какого аргумента связано со временем жизни
возвращаемого значения. Здесь мы говорим, что возвращаемый вектор будет
содержать строковые срезы, ссылающиеся на части аргумента contents (а не
аргумента query).
Иными словами, мы сообщаем Rust: данные, которые возвращает search, будут
жить столько же, сколько данные, переданные в search через аргумент
contents. Это важно! Чтобы ссылка была действительной, данные, на которые
указывает срез, тоже должны быть действительными. Если бы компилятор считал,
что мы делаем срезы из query, а не из contents, его проверки безопасности
работали бы неправильно.
Если забыть аннотации времени жизни и попытаться скомпилировать функцию, получим ошибку:
$ cargo build
Compiling minigrep v0.1.0 (file:///projects/minigrep)
error[E0106]: missing lifetime specifier
--> src/lib.rs:1:51
|
1 | pub fn search(query: &str, contents: &str) -> Vec<&str> {
| ---- ---- ^ expected named lifetime parameter
|
= help: this function's return type contains a borrowed value, but the signature does not say whether it is borrowed from `query` or `contents`
help: consider introducing a named lifetime parameter
|
1 | pub fn search<'a>(query: &'a str, contents: &'a str) -> Vec<&'a str> {
| ++++ ++ ++ ++
For more information about this error, try `rustc --explain E0106`.
error: could not compile `minigrep` (lib) due to 1 previous error
Rust не может знать, какой из двух параметров нужен для результата, поэтому
указать это нужно явно. Заметьте: подсказка в сообщении советует указать
одинаковый параметр времени жизни для всех параметров и возвращаемого типа — и
это неверно! Весь наш текст лежит в параметре contents, и возвращаем мы
совпавшие части именно этого текста. Значит, с возвращаемым значением с
помощью синтаксиса времён жизни нужно связать только contents.
В других языках программирования не требуется связывать в сигнатуре аргументы с возвращаемыми значениями, но со временем это войдёт в привычку. Полезно сравнить этот пример с примерами из раздела «Проверка ссылок с помощью времён жизни» главы 10.
Пишем код, проходящий тест
Сейчас тест проваливается, потому что мы всегда возвращаем пустой вектор. Чтобы
это исправить и реализовать search, программа должна:
- Перебрать все строки содержимого.
- Проверить, встречается ли в ней запрос.
- Если есть — добавить строку в список возвращаемых значений.
- Если нет — ничего не делать.
- Вернуть список совпавших строк.
Пройдём по шагам, начав с перебора строк.
Перебор строк методом lines
Чтобы перебрать текст по строкам, в Rust есть удобный метод с подходящим
именем lines. Работает он как в листинге 12-17. Учтите, что пока код не
компилируется.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
for line in contents.lines() {
// что-то делаем со строкой line
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}contentsМетод lines возвращает итератор. Подробно об итераторах мы поговорим в
главе 13. Но вспомните, что такой способ
использовать итератор вы уже видели в листинге 3-5,
где цикл for с итератором выполнял код для каждого элемента коллекции.
Ищем запрос в каждой строке
Дальше проверим, встречается ли в текущей строке запрос. К счастью, у строк
есть полезный метод contains, который делает это за нас! Добавьте в функцию
search вызов метода contains, как в листинге 12-18. Код всё ещё не
компилируется.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
for line in contents.lines() {
if line.contains(query) {
// что-то делаем со строкой line
}
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}queryМы пока только наращиваем функциональность. Чтобы код скомпилировался, тело функции должно вернуть значение, как обещано в сигнатуре.
Сохраняем совпавшие строки
Чтобы закончить функцию, нужно где-то хранить совпавшие строки, которые мы
вернём. Для этого перед циклом for создадим изменяемый вектор и будем
складывать в него line методом push. После цикла вернём вектор, как в
листинге 12-19.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
let mut results = Vec::new();
for line in contents.lines() {
if line.contains(query) {
results.push(line);
}
}
results
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}Теперь функция search должна возвращать только строки, содержащие query, и
тест должен пройти. Запустим его:
$ cargo test
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `test` profile [unoptimized + debuginfo] target(s) in 1.22s
Running unittests src/lib.rs (target/debug/deps/minigrep-9cd200e5fac0fc94)
running 1 test
test tests::one_result ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running unittests src/main.rs (target/debug/deps/minigrep-9cd200e5fac0fc94)
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests minigrep
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Тест прошёл — значит, всё работает!
Сейчас можно подумать о рефакторинге реализации функции поиска, следя, чтобы
тесты проходили и функциональность не менялась. Код функции search неплох,
но не пользуется некоторыми полезными возможностями итераторов. Мы вернёмся к
этому примеру в главе 13, где подробно
разберём итераторы и посмотрим, как его улучшить.
Теперь должна работать вся программа! Попробуем — сначала со словом, которое должно вернуть ровно одну строку из стихотворения Эмили Дикинсон: frog (лягушка).
$ cargo run -- frog poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.38s
Running `target/debug/minigrep frog poem.txt`
How public, like a frog
Здорово! Теперь попробуем слово, которое встречается в нескольких строках, например body:
$ cargo run -- body poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep body poem.txt`
I'm nobody! Who are you?
Are you nobody, too?
How dreary to be somebody!
И наконец, убедимся, что по слову, которого в стихотворении нет, — например, monomorphization — не найдётся ни одной строки:
$ cargo run -- monomorphization poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep monomorphization poem.txt`
Превосходно! Мы написали собственную мини-версию классической утилиты и многое узнали о том, как структурировать приложения. А ещё немного разобрались с файловым вводом-выводом, временами жизни, тестированием и разбором командной строки.
В завершение проекта коротко покажем, как работать с переменными окружения и как выводить в стандартный поток ошибок, — и то и другое пригодится при написании программ командной строки.
Переменные окружения
Переменные окружения
Улучшим бинарник minigrep, добавив ещё одну возможность: поиск без учёта
регистра, который пользователь может включить через переменную окружения.
Можно было бы сделать это параметром командной строки, который пользователю
приходилось бы указывать каждый раз. Но если сделать это переменной
окружения, пользователь сможет задать её один раз — и в этом сеансе терминала
все поиски будут без учёта регистра.
Пишем проваливающийся тест для поиска без учёта регистра
Сначала добавим в библиотеку minigrep новую функцию
search_case_insensitive, которая будет вызываться, если у переменной
окружения есть значение. Мы продолжаем следовать TDD, так что первым шагом
снова пишем проваливающийся тест. Добавим новый тест для новой функции
search_case_insensitive, а старый тест переименуем из one_result в
case_sensitive, чтобы было понятно, чем они отличаются, — как в листинге
12-20.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
let mut results = Vec::new();
for line in contents.lines() {
if line.contains(query) {
results.push(line);
}
}
results
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn case_sensitive() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Duct tape.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
#[test]
fn case_insensitive() {
let query = "rUsT";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Trust me.";
assert_eq!(
vec!["Rust:", "Trust me."],
search_case_insensitive(query, contents)
);
}
}Заметьте, что contents в старом тесте мы тоже поменяли: добавили строку
"Duct tape." с заглавной D, которая не должна совпадать с запросом
"duct" при поиске с учётом регистра. Такое изменение старого теста помогает
убедиться, что мы случайно не сломаем уже реализованный поиск с учётом
регистра. Этот тест должен проходить сейчас и продолжать проходить, пока мы
работаем над поиском без учёта регистра.
Новый тест для поиска без учёта регистра использует запрос "rUsT". В
функции search_case_insensitive, которую мы сейчас напишем, запрос "rUsT"
должен совпасть и со строкой "Rust:" с заглавной R, и со строкой
"Trust me.", хотя регистр у обеих отличается от запроса. Это наш
проваливающийся тест, и он не скомпилируется, потому что функцию
search_case_insensitive мы ещё не определили. Если хотите, добавьте
заготовку, которая всегда возвращает пустой вектор, — как мы делали для
функции search в листинге 12-16, — чтобы увидеть, как тест компилируется и
проваливается.
Реализуем функцию search_case_insensitive
Функция search_case_insensitive из листинга 12-21 почти такая же, как
search. Разница лишь в том, что мы приводим query и каждую строку line к
нижнему регистру. Тогда, каким бы ни был регистр входных аргументов, при
проверке, есть ли в строке запрос, регистр у них будет одинаковым.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
let mut results = Vec::new();
for line in contents.lines() {
if line.contains(query) {
results.push(line);
}
}
results
}
pub fn search_case_insensitive<'a>(
query: &str,
contents: &'a str,
) -> Vec<&'a str> {
let query = query.to_lowercase();
let mut results = Vec::new();
for line in contents.lines() {
if line.to_lowercase().contains(&query) {
results.push(line);
}
}
results
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn case_sensitive() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Duct tape.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
#[test]
fn case_insensitive() {
let query = "rUsT";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Trust me.";
assert_eq!(
vec!["Rust:", "Trust me."],
search_case_insensitive(query, contents)
);
}
}search_case_insensitive приводит запрос и строку к нижнему регистру, прежде чем сравнивать ихСначала приводим строку query к нижнему регистру и сохраняем в новую
переменную с тем же именем, затеняя исходную query. to_lowercase нужен
затем, чтобы любой вариант запроса — "rust", "RUST", "Rust" или
"rUsT" — обрабатывался одинаково, как "rust", то есть без учёта
регистра. to_lowercase справляется с базовым Юникодом, но не
идеально. В настоящем приложении здесь пришлось бы поработать ещё, но этот
раздел о переменных окружения, а не о Юникоде, так что на этом остановимся.
Обратите внимание: query теперь не строковый срез, а String, потому что
вызов to_lowercase создаёт новые данные, а не ссылается на существующие.
Скажем, если запрос — "rUsT", в этом строковом срезе нет строчных u и t,
которые можно было бы использовать, поэтому приходится выделить память под
новую String со значением "rust". А когда мы теперь передаём query
аргументом в метод contains, нужно добавить амперсанд: сигнатура contains
принимает строковый срез.
Затем добавляем вызов to_lowercase для каждой строки line, чтобы привести
к нижнему регистру все её символы. Теперь, когда и line, и query в нижнем
регистре, совпадения найдутся при любом регистре запроса.
Посмотрим, проходит ли эта реализация тесты:
$ cargo test
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `test` profile [unoptimized + debuginfo] target(s) in 1.33s
Running unittests src/lib.rs (target/debug/deps/minigrep-9cd200e5fac0fc94)
running 2 tests
test tests::case_insensitive ... ok
test tests::case_sensitive ... ok
test result: ok. 2 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running unittests src/main.rs (target/debug/deps/minigrep-9cd200e5fac0fc94)
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests minigrep
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Отлично! Проходят. Теперь вызовем новую функцию search_case_insensitive из
функции run. Сначала добавим в структуру Config параметр, переключающий
поиск с учётом регистра и без. Добавление этого поля вызовет ошибки
компиляции, потому что мы его пока нигде не инициализируем:
Файл: src/main.rs
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
// --пропуск--
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}Мы добавили поле ignore_case с логическим значением. Теперь функция run
должна проверять значение поля ignore_case и по нему решать, вызывать
search или search_case_insensitive, как в листинге 12-22. Код всё ещё не
компилируется.
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
// --пропуск--
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}search или search_case_insensitive в зависимости от значения config.ignore_caseНаконец, нужно проверить переменную окружения. Функции для работы с
переменными окружения находятся в модуле env стандартной библиотеки, который
уже подключён в начале src/main.rs. С помощью функции var из модуля env
проверим, задано ли какое-нибудь значение у переменной окружения
IGNORE_CASE, как в листинге 12-23.
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}IGNORE_CASEЗдесь мы создаём новую переменную ignore_case. Чтобы задать её значение,
вызываем функцию env::var и передаём ей имя переменной окружения
IGNORE_CASE. Функция env::var возвращает Result: если переменная
окружения задана (с любым значением), это будет успешный вариант Ok со
значением переменной. Если не задана — вариант Err.
С помощью метода is_ok у Result мы проверяем, задана ли переменная
окружения, — если задана, программа должна искать без учёта регистра. Если
IGNORE_CASE не задана, is_ok вернёт false, и программа будет искать
с учётом регистра. Значение переменной окружения нас не интересует — только
то, задана она или нет. Поэтому мы проверяем is_ok, а не используем
unwrap, expect или другие уже знакомые методы Result.
Значение переменной ignore_case мы передаём в экземпляр Config, чтобы
функция run могла его прочитать и решить, вызывать search_case_insensitive
или search, как мы реализовали в листинге 12-22.
Попробуем! Сначала запустим программу без переменной окружения с запросом
to — он должен совпасть со всеми строками, где есть слово to строчными
буквами:
$ cargo run -- to poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep to poem.txt`
Are you nobody, too?
How dreary to be somebody!
Похоже, всё по-прежнему работает! Теперь запустим программу с IGNORE_CASE,
равной 1, и тем же запросом to:
$ IGNORE_CASE=1 cargo run -- to poem.txt
В PowerShell переменную окружения нужно задать и запустить программу отдельными командами:
PS> $Env:IGNORE_CASE=1; cargo run -- to poem.txt
Так IGNORE_CASE сохранится до конца сеанса оболочки. Убрать её можно
командлетом Remove-Item:
PS> Remove-Item Env:IGNORE_CASE
Мы должны получить строки с to, в которых могут быть и заглавные буквы:
Are you nobody, too?
How dreary to be somebody!
To tell your name the livelong day
To an admiring bog!
Превосходно, нашлись и строки с To! Теперь minigrep умеет искать без учёта
регистра, а включается это переменной окружения. Теперь вы знаете, как
управлять настройками и через аргументы командной строки, и через переменные
окружения.
Некоторые программы позволяют задавать одну и ту же настройку и аргументами, и переменными окружения. В таких случаях программа решает, что из них имеет приоритет. В качестве самостоятельного упражнения попробуйте управлять учётом регистра и через аргумент командной строки, и через переменную окружения. Решите, что должно иметь приоритет, если программу запустили с аргументом «учитывать регистр» и переменной «не учитывать» (или наоборот).
В модуле std::env есть ещё много полезного для работы с переменными
окружения — загляните в его документацию и посмотрите, что там доступно.
Вывод ошибок в stderr
Вывод ошибок в stderr
Сейчас весь вывод мы пишем в терминал макросом println!. В большинстве
терминалов есть два вида вывода: стандартный вывод (standard output,
stdout) для обычной информации и стандартный поток ошибок (standard
error, stderr) для сообщений об ошибках. Благодаря этому разделению
пользователь может направить обычный вывод программы в файл, а сообщения об
ошибках по-прежнему видеть на экране.
Макрос println! умеет выводить только в стандартный вывод, так что для
вывода в стандартный поток ошибок понадобится что-то другое.
Куда сейчас пишутся ошибки
Сначала посмотрим, как сейчас всё, что выводит minigrep, попадает в
стандартный вывод — включая сообщения об ошибках, которые мы хотели бы
выводить в стандартный поток ошибок. Для этого перенаправим стандартный вывод в
файл и намеренно вызовем ошибку. Стандартный поток ошибок перенаправлять не
будем, так что всё, что туда попадёт, по-прежнему будет показываться на
экране.
От программ командной строки ожидают, что сообщения об ошибках они отправляют в стандартный поток ошибок: тогда, даже перенаправив стандартный вывод в файл, мы увидим ошибки на экране. Наша программа пока ведёт себя не так: сейчас мы увидим, что сообщение об ошибке она сохраняет в файл!
Чтобы это показать, запустим программу с > и путём к файлу output.txt, в
который хотим перенаправить стандартный вывод. Аргументов передавать не будем
— это должно вызвать ошибку:
$ cargo run > output.txt
Синтаксис > говорит оболочке писать содержимое стандартного вывода не на
экран, а в output.txt. Ожидаемого сообщения об ошибке на экране мы не
увидели — значит, оно оказалось в файле. Вот что в output.txt:
Problem parsing arguments: not enough arguments
Так и есть: сообщение об ошибке выводится в стандартный вывод. Куда полезнее, чтобы такие сообщения шли в стандартный поток ошибок, а в файл попадали только данные успешного запуска. Исправим это.
Выводим ошибки в стандартный поток ошибок
Изменим вывод сообщений об ошибках с помощью кода из листинга 12-24. Благодаря
рефакторингу, который мы сделали в этой главе, весь код вывода сообщений об
ошибках находится в одной функции — main. В стандартной библиотеке есть
макрос eprintln!, который выводит в стандартный поток ошибок, так что
заменим на eprintln! оба вызова println!, выводившие ошибки.
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
eprintln!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
eprintln!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}eprintln!Снова запустим программу так же — без аргументов и с перенаправлением
стандартного вывода через >:
$ cargo run > output.txt
Problem parsing arguments: not enough arguments
Теперь ошибка видна на экране, а output.txt пуст — именно так и должны вести себя программы командной строки.
Запустим программу ещё раз — с аргументами, которые не вызывают ошибку, но по-прежнему перенаправляя стандартный вывод в файл:
$ cargo run -- to poem.txt > output.txt
В терминале ничего не появится, а в output.txt окажутся результаты:
Файл: output.txt
Are you nobody, too?
How dreary to be somebody!
Это показывает, что теперь мы, как и положено, используем стандартный вывод для результатов успешной работы, а стандартный поток ошибок — для ошибок.
Итоги
В этой главе мы повторили основные понятия, которые вы уже изучили, и
разобрались, как выполнять в Rust типичные операции ввода-вывода. Умея
работать с аргументами командной строки, файлами, переменными окружения и
выводить ошибки макросом eprintln!, вы готовы писать приложения командной
строки. Вместе с понятиями из предыдущих глав это позволит вам писать хорошо
организованный код, эффективно хранить данные в подходящих структурах,
аккуратно обрабатывать ошибки и как следует всё тестировать.
Дальше мы рассмотрим возможности Rust, появившиеся под влиянием функциональных языков: замыкания и итераторы.
Функциональные возможности: итераторы и замыкания
Дизайн Rust вдохновлялся многими существующими языками и приёмами, и одно из заметных влияний — функциональное программирование. Программирование в функциональном стиле часто подразумевает, что функции используются как значения: их передают аргументами, возвращают из других функций, сохраняют в переменных, чтобы выполнить позже, и так далее.
В этой главе мы не будем спорить о том, что такое функциональное программирование, а что нет. Вместо этого поговорим о возможностях Rust, похожих на возможности многих языков, которые часто называют функциональными.
А именно, мы рассмотрим:
- замыкания (closures) — похожую на функцию конструкцию, которую можно сохранить в переменной;
- итераторы (iterators) — способ обрабатывать последовательность элементов;
- как с помощью замыканий и итераторов улучшить проект с вводом-выводом из главы 12;
- производительность замыканий и итераторов (спойлер: они быстрее, чем вы думаете!).
Некоторые другие возможности Rust, тоже появившиеся под влиянием функционального стиля, — например, сопоставление с образцом и перечисления — мы уже разобрали. Умение пользоваться замыканиями и итераторами — важная часть написания быстрого идиоматичного кода на Rust, поэтому им посвящена целая глава.
Замыкания
Замыкания
Замыкания в Rust — это анонимные функции, которые можно сохранить в переменной или передать аргументом в другую функцию. Замыкание можно создать в одном месте, а вызвать в другом — и выполнить его уже в другом контексте. В отличие от функций, замыкания могут захватывать значения из области видимости, в которой они определены. Покажем, как эти возможности замыканий помогают повторно использовать код и настраивать поведение.
Захват окружения
Сначала посмотрим, как с помощью замыканий захватывать значения из окружения, в котором они определены, чтобы воспользоваться ими позже. Сценарий такой: время от времени наша компания, выпускающая футболки, в рамках промоакции дарит кому-нибудь из подписчиков рассылки эксклюзивную футболку ограниченной серии. Подписчики могут по желанию указать в профиле любимый цвет. Если у победителя указан любимый цвет, он получает футболку этого цвета. Если нет — получает футболку того цвета, которого у компании сейчас больше всего.
Реализовать это можно по-разному. В этом примере мы используем перечисление
ShirtColor с вариантами Red и Blue (для простоты ограничим число цветов).
Складские запасы компании представим структурой Inventory с полем shirts
типа Vec<ShirtColor> — это цвета футболок, которые сейчас есть на складе.
Метод giveaway, определённый для Inventory, получает необязательное
предпочтение победителя по цвету и возвращает цвет футболки, которую тот
получит. Всё это показано в листинге 13-1.
#[derive(Debug, PartialEq, Copy, Clone)]
enum ShirtColor {
Red,
Blue,
}
struct Inventory {
shirts: Vec<ShirtColor>,
}
impl Inventory {
fn giveaway(&self, user_preference: Option<ShirtColor>) -> ShirtColor {
user_preference.unwrap_or_else(|| self.most_stocked())
}
fn most_stocked(&self) -> ShirtColor {
let mut num_red = 0;
let mut num_blue = 0;
for color in &self.shirts {
match color {
ShirtColor::Red => num_red += 1,
ShirtColor::Blue => num_blue += 1,
}
}
if num_red > num_blue {
ShirtColor::Red
} else {
ShirtColor::Blue
}
}
}
fn main() {
let store = Inventory {
shirts: vec![ShirtColor::Blue, ShirtColor::Red, ShirtColor::Blue],
};
let user_pref1 = Some(ShirtColor::Red);
let giveaway1 = store.giveaway(user_pref1);
println!(
"The user with preference {:?} gets {:?}",
user_pref1, giveaway1
);
let user_pref2 = None;
let giveaway2 = store.giveaway(user_pref2);
println!(
"The user with preference {:?} gets {:?}",
user_pref2, giveaway2
);
}У склада store, определённого в main, для этой акции осталось две синие
футболки и одна красная. Мы вызываем метод giveaway для пользователя,
который предпочитает красный цвет, и для пользователя без предпочтений.
Повторимся: этот код можно было написать по-разному, и, чтобы сосредоточиться
на замыканиях, мы обошлись уже знакомыми вам понятиями — кроме тела метода
giveaway, где используется замыкание. В методе giveaway предпочтение
пользователя приходит параметром типа Option<ShirtColor>, и мы вызываем у
user_preference метод unwrap_or_else. Метод unwrap_or_else у
Option<T> определён в стандартной
библиотеке. Он принимает один аргумент — замыкание без аргументов, которое
возвращает значение типа T (того же типа, что хранится в варианте Some у
Option<T>, в нашем случае ShirtColor). Если Option<T> — вариант Some,
unwrap_or_else возвращает значение из Some. Если None — вызывает
замыкание и возвращает то, что вернуло замыкание.
Аргументом unwrap_or_else мы передаём выражение-замыкание
|| self.most_stocked(). Это замыкание без параметров (если бы параметры
были, они стояли бы между двумя вертикальными чертами). Тело замыкания
вызывает self.most_stocked(). Здесь мы замыкание только определяем, а
реализация unwrap_or_else выполнит его позже — если результат понадобится.
Этот код выводит:
$ cargo run
Compiling shirt-company v0.1.0 (file:///projects/shirt-company)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.27s
Running `target/debug/shirt-company`
The user with preference Some(Red) gets Red
The user with preference None gets Blue
Интересно здесь то, что мы передали замыкание, которое вызывает
self.most_stocked() у текущего экземпляра Inventory. Стандартной
библиотеке не нужно было ничего знать ни о наших типах Inventory и
ShirtColor, ни о логике, которую мы хотим использовать в этом сценарии.
Замыкание захватывает неизменяемую ссылку на экземпляр Inventory из self
и передаёт её вместе с нашим кодом методу unwrap_or_else. Функции так
захватывать своё окружение не умеют.
Выведение и аннотации типов замыканий
Есть и другие различия между функциями и замыканиями. Замыкания обычно не
требуют аннотировать типы параметров и возвращаемого значения, как это нужно
для функций fn. У функций аннотации типов обязательны, потому что типы —
часть явного интерфейса, открытого пользователям. Жёстко зафиксировать этот
интерфейс важно, чтобы все сходились в том, значения каких типов функция
принимает и возвращает. Замыкания же не используются в таком открытом
интерфейсе: их хранят в переменных и используют, не давая им имён и не
открывая пользователям библиотеки.
Замыкания обычно короткие и имеют смысл только в узком контексте, а не в произвольной ситуации. В таких ограниченных контекстах компилятор может вывести типы параметров и возвращаемый тип — примерно так же, как он выводит типы большинства переменных (хотя изредка аннотации типов для замыканий компилятору всё-таки нужны).
Как и с переменными, аннотации типов можно добавить, если хочется большей явности и ясности ценой лишней многословности. Замыкание с аннотациями типов выглядит как в листинге 13-2. Здесь мы определяем замыкание и сохраняем его в переменной, а не определяем прямо там, где передаём аргументом, как в листинге 13-1.
use std::thread;
use std::time::Duration;
fn generate_workout(intensity: u32, random_number: u32) {
let expensive_closure = |num: u32| -> u32 {
println!("calculating slowly...");
thread::sleep(Duration::from_secs(2));
num
};
if intensity < 25 {
println!("Today, do {} pushups!", expensive_closure(intensity));
println!("Next, do {} situps!", expensive_closure(intensity));
} else {
if random_number == 3 {
println!("Take a break today! Remember to stay hydrated!");
} else {
println!(
"Today, run for {} minutes!",
expensive_closure(intensity)
);
}
}
}
fn main() {
let simulated_user_specified_value = 10;
let simulated_random_number = 7;
generate_workout(simulated_user_specified_value, simulated_random_number);
}С аннотациями типов синтаксис замыканий больше похож на синтаксис функций. Для сравнения определим функцию, которая прибавляет 1 к своему параметру, и замыкание с таким же поведением. Мы добавили пробелы, чтобы выровнять соответствующие части. Видно, что синтаксис замыканий похож на синтаксис функций, только используются вертикальные черты и многое можно не писать:
fn add_one_v1 (x: u32) -> u32 { x + 1 }
let add_one_v2 = |x: u32| -> u32 { x + 1 };
let add_one_v3 = |x| { x + 1 };
let add_one_v4 = |x| x + 1 ;В первой строке — определение функции, во второй — полностью аннотированное
определение замыкания. В третьей строке мы убрали из определения замыкания
аннотации типов. В четвёртой убрали и фигурные скобки — они необязательны,
потому что в теле замыкания одно выражение. Все эти определения допустимы и
при вызове ведут себя одинаково. Но чтобы строки с add_one_v3 и
add_one_v4 скомпилировались, эти замыкания нужно где-то вызвать: типы будут
выведены из того, как они используются. Это похоже на let v = Vec::new();,
где Rust нужна либо аннотация типа, либо значения какого-то типа, вставленные
в Vec, чтобы вывести тип.
Для каждого параметра замыкания и для его возвращаемого значения компилятор
выводит один конкретный тип. Например, в листинге 13-3 — определение
короткого замыкания, которое просто возвращает полученный параметр. Пользы от
него мало, разве что для этого примера. Заметьте, что аннотаций типов в
определении нет. Раз их нет, замыкание можно вызвать с любым типом — в первый
раз мы вызываем его со String. Но если затем попытаться вызвать
example_closure с целым числом, получим ошибку.
fn main() {
let example_closure = |x| x;
let s = example_closure(String::from("hello"));
let n = example_closure(5);
}Компилятор выдаёт ошибку:
$ cargo run
Compiling closure-example v0.1.0 (file:///projects/closure-example)
error[E0308]: mismatched types
--> src/main.rs:5:29
|
5 | let n = example_closure(5);
| --------------- ^ expected `String`, found integer
| |
| arguments to this function are incorrect
|
note: expected because the closure was earlier called with an argument of type `String`
--> src/main.rs:4:29
|
4 | let s = example_closure(String::from("hello"));
| --------------- ^^^^^^^^^^^^^^^^^^^^^ expected because this argument is of type `String`
| |
| in this closure call
note: closure parameter defined here
--> src/main.rs:2:28
|
2 | let example_closure = |x| x;
| ^
help: try using a conversion method
|
5 | let n = example_closure(5.to_string());
| ++++++++++++
For more information about this error, try `rustc --explain E0308`.
error: could not compile `closure-example` (bin "closure-example") due to 1 previous error
Когда мы в первый раз вызываем example_closure со значением String,
компилятор выводит, что тип x и возвращаемый тип замыкания — String. Эти
типы закрепляются за замыканием в example_closure, и при попытке вызвать то
же замыкание с другим типом мы получаем ошибку типа.
Захват ссылок или перемещение владения
Замыкания могут захватывать значения из окружения тремя способами — ровно теми же, какими функция может принимать параметр: неизменяемое заимствование, изменяемое заимствование и забирание владения. Какой способ использовать, замыкание решает само — в зависимости от того, что его тело делает с захваченными значениями.
В листинге 13-4 мы определяем замыкание, которое захватывает неизменяемую
ссылку на вектор list: чтобы вывести значение, ему достаточно неизменяемой
ссылки.
fn main() {
let list = vec![1, 2, 3];
println!("Before defining closure: {list:?}");
let only_borrows = || println!("From closure: {list:?}");
println!("Before calling closure: {list:?}");
only_borrows();
println!("After calling closure: {list:?}");
}Этот пример также показывает, что переменную можно привязать к определению замыкания, а потом вызвать замыкание по имени переменной с круглыми скобками — как будто это имя функции.
Неизменяемых ссылок на list одновременно может быть сколько угодно, поэтому
list доступен и в коде до определения замыкания, и после определения, но до
вызова, и после вызова. Этот код компилируется, запускается и выводит:
$ cargo run
Compiling closure-example v0.1.0 (file:///projects/closure-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.43s
Running `target/debug/closure-example`
Before defining closure: [1, 2, 3]
Before calling closure: [1, 2, 3]
From closure: [1, 2, 3]
After calling closure: [1, 2, 3]
Теперь, в листинге 13-5, изменим тело замыкания так, чтобы оно добавляло
элемент в вектор list. Теперь замыкание захватывает изменяемую ссылку.
fn main() {
let mut list = vec![1, 2, 3];
println!("Before defining closure: {list:?}");
let mut borrows_mutably = || list.push(7);
borrows_mutably();
println!("After calling closure: {list:?}");
}Этот код компилируется, запускается и выводит:
$ cargo run
Compiling closure-example v0.1.0 (file:///projects/closure-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.43s
Running `target/debug/closure-example`
Before defining closure: [1, 2, 3]
After calling closure: [1, 2, 3, 7]
Заметьте, что между определением и вызовом замыкания borrows_mutably больше
нет println!. Когда borrows_mutably определяется, оно захватывает
изменяемую ссылку на list. После вызова мы замыканием больше не пользуемся,
так что изменяемое заимствование на этом заканчивается. А между определением
и вызовом замыкания неизменяемое заимствование ради вывода не допускается:
пока есть изменяемое заимствование, никаких других быть не может. Попробуйте
добавить туда println! и посмотрите, какое будет сообщение об ошибке!
Если нужно, чтобы замыкание обязательно забрало владение значениями из
окружения, хотя телу замыкания владение строго говоря не нужно, перед списком
параметров можно написать ключевое слово move.
Чаще всего это нужно, когда замыкание передаётся в новый поток: данные
перемещаются, и ими владеет уже новый поток. Подробно о потоках и о том, зачем
они нужны, мы поговорим в главе 16, посвящённой конкурентности, а пока бегло
посмотрим, как создать новый поток с замыканием, которому нужно move. В
листинге 13-6 — листинг 13-4, изменённый так, чтобы вектор выводился не в
главном потоке, а в новом.
use std::thread;
fn main() {
let list = vec![1, 2, 3];
println!("Before defining closure: {list:?}");
thread::spawn(move || println!("From thread: {list:?}"))
.join()
.unwrap();
}move заставляет замыкание потока забрать владение listМы создаём новый поток и передаём ему аргументом замыкание, которое нужно
выполнить. Тело замыкания выводит список. В листинге 13-4 замыкание захватило
list только по неизменяемой ссылке — это минимальный доступ, нужный для
вывода. Здесь телу замыкания тоже хватило бы неизменяемой ссылки, но нужно
явно указать, что list перемещается в замыкание, поставив move в начале
определения замыкания. Если главный поток выполнит ещё какие-то операции до
вызова join у нового потока, новый поток может закончиться раньше главного, а
может и главный закончиться первым. Если бы главный поток владел list, но
завершился раньше нового и уничтожил list, неизменяемая ссылка в новом
потоке стала бы недействительной. Поэтому компилятор требует переместить
list в замыкание, которое получает новый поток, — так ссылка останется
действительной. Попробуйте убрать move или использовать list в главном
потоке после определения замыкания и посмотрите, какие будут ошибки
компиляции!
Перемещение захваченных значений из замыканий
С замыканием и захваченными значениями связаны два отдельных вопроса:
- Как замыкание захватывает значения при определении — по ссылке или забирая владение. От этого зависит, что перемещается в замыкание.
- Что делает с захваченным тело замыкания, когда его вызывают. От этого зависит, что перемещается из замыкания.
Тело замыкания может: переместить захваченное значение из замыкания, изменить захваченное значение, ни перемещать, ни изменять значение — или вообще ничего не захватывать из окружения.
От того, как замыкание захватывает значения из окружения и что с ними делает,
зависит, какие трейты оно реализует. А через трейты функции и структуры
указывают, какие замыкания они готовы принимать. В зависимости от того, что
тело замыкания делает со значениями, замыкание автоматически реализует один,
два или все три трейта Fn — по нарастающей:
FnOnce— для замыканий, которые можно вызвать один раз. Этот трейт реализуют все замыкания, ведь любое замыкание можно вызвать. Замыкание, которое перемещает захваченные значения из своего тела, реализует толькоFnOnceи никакие другие трейтыFn: вызвать его можно лишь однажды.FnMut— для замыканий, которые не перемещают захваченные значения из тела, но могут их изменять. Такие замыкания можно вызывать многократно.Fn— для замыканий, которые не перемещают захваченные значения из тела и не изменяют их, а также для замыканий, которые вообще ничего не захватывают из окружения. Такие замыкания можно вызывать многократно, не меняя их окружение, — это важно, например, когда замыкание вызывается много раз одновременно.
Посмотрим на определение метода unwrap_or_else у Option<T>, которым мы
пользовались в листинге 13-1:
impl<T> Option<T> {
pub fn unwrap_or_else<F>(self, f: F) -> T
where
F: FnOnce() -> T
{
match self {
Some(x) => x,
None => f(),
}
}
}Напомним, что T — обобщённый тип значения в варианте Some у Option. Этот
же тип T — и возвращаемый тип функции unwrap_or_else: например, код,
вызвавший unwrap_or_else у Option<String>, получит String.
Дальше заметьте, что у функции unwrap_or_else есть ещё один обобщённый
параметр типа — F. Это тип параметра f, то есть замыкания, которое мы
передаём при вызове unwrap_or_else.
Ограничение трейтом у обобщённого типа F — FnOnce() -> T. Это значит, что
значение типа F можно вызвать хотя бы один раз, аргументов оно не принимает
и возвращает T. Ограничение FnOnce выражает требование, что unwrap_or_else
вызовет f не больше одного раза. По телу unwrap_or_else видно: если
Option — это Some, f не вызывается; если None — вызывается один раз. А
раз FnOnce реализуют все замыкания, unwrap_or_else принимает все три вида
замыканий и максимально гибок.
Примечание: если для нашей задачи не нужно захватывать значения из
окружения, там, где требуется что-то реализующее один из трейтов Fn, можно
указать имя функции, а не замыкание. Например, у значения Option<Vec<T>>
можно вызвать unwrap_or_else(Vec::new), чтобы при None получить новый
пустой вектор. Для определений функций компилятор автоматически реализует
подходящие трейты Fn.
Теперь посмотрим на метод стандартной библиотеки sort_by_key, определённый
для срезов, и разберёмся, чем он отличается от unwrap_or_else и почему в его
ограничении стоит FnMut, а не FnOnce. Замыкание получает один аргумент —
ссылку на текущий рассматриваемый элемент среза — и возвращает значение типа
K, которое можно упорядочить. Эта функция удобна, когда срез нужно
отсортировать по какому-то свойству элементов. В листинге 13-7 у нас список
экземпляров Rectangle, и мы с помощью sort_by_key упорядочиваем их по
полю width — по возрастанию.
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
fn main() {
let mut list = [
Rectangle { width: 10, height: 1 },
Rectangle { width: 3, height: 5 },
Rectangle { width: 7, height: 12 },
];
list.sort_by_key(|r| r.width);
println!("{list:#?}");
}sort_by_keyЭтот код выводит:
$ cargo run
Compiling rectangles v0.1.0 (file:///projects/rectangles)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.41s
Running `target/debug/rectangles`
[
Rectangle {
width: 3,
height: 5,
},
Rectangle {
width: 7,
height: 12,
},
Rectangle {
width: 10,
height: 1,
},
]
sort_by_key принимает замыкание FnMut потому, что вызывает его
многократно — по разу для каждого элемента среза. Замыкание |r| r.width
ничего не захватывает, не изменяет и не перемещает из окружения, так что
требованиям ограничения оно удовлетворяет.
А в листинге 13-8 — пример замыкания, которое реализует только FnOnce,
потому что перемещает значение из окружения. С sort_by_key компилятор такое
замыкание использовать не даст.
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
fn main() {
let mut list = [
Rectangle { width: 10, height: 1 },
Rectangle { width: 3, height: 5 },
Rectangle { width: 7, height: 12 },
];
let mut sort_operations = vec![];
let value = String::from("closure called");
list.sort_by_key(|r| {
sort_operations.push(value);
r.width
});
println!("{list:#?}");
}FnOnce с sort_by_keyЭто надуманный и запутанный (к тому же неработающий) способ посчитать, сколько
раз sort_by_key вызывает замыкание при сортировке list. Код пытается
считать вызовы, добавляя value — значение String из окружения замыкания —
в вектор sort_operations. Замыкание захватывает value, а затем перемещает
его из себя, передавая владение value вектору sort_operations. Такое
замыкание можно вызвать только один раз: при втором вызове value в окружении
уже не будет, и класть в sort_operations будет нечего! Поэтому это замыкание
реализует только FnOnce. При компиляции получаем ошибку: value нельзя
переместить из замыкания, потому что замыкание должно реализовывать FnMut:
$ cargo run
Compiling rectangles v0.1.0 (file:///projects/rectangles)
error[E0507]: cannot move out of `value`, a captured variable in an `FnMut` closure
--> src/main.rs:18:30
|
15 | let value = String::from("closure called");
| ----- ------------------------------ move occurs because `value` has type `String`, which does not implement the `Copy` trait
| |
| captured outer variable
16 |
17 | list.sort_by_key(|r| {
| --- captured by this `FnMut` closure
18 | sort_operations.push(value);
| ^^^^^ `value` is moved here
|
help: `Fn` and `FnMut` closures require captured values to be able to be consumed multiple times, but `FnOnce` closures may consume them only once
--> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/alloc/src/slice.rs:249:11
help: consider cloning the value if the performance cost is acceptable
|
18 | sort_operations.push(value.clone());
| ++++++++
For more information about this error, try `rustc --explain E0507`.
error: could not compile `rectangles` (bin "rectangles") due to 1 previous error
Ошибка указывает на строку в теле замыкания, которая перемещает value из
окружения. Чтобы это исправить, нужно, чтобы тело замыкания ничего не
перемещало из окружения. Посчитать вызовы замыкания проще так: держать в окружении
счётчик и увеличивать его в теле замыкания. Замыкание из листинга 13-9
работает с sort_by_key, потому что захватывает только изменяемую ссылку на
счётчик num_sort_operations и, значит, может вызываться многократно.
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
fn main() {
let mut list = [
Rectangle { width: 10, height: 1 },
Rectangle { width: 3, height: 5 },
Rectangle { width: 7, height: 12 },
];
let mut num_sort_operations = 0;
list.sort_by_key(|r| {
num_sort_operations += 1;
r.width
});
println!("{list:#?}, sorted in {num_sort_operations} operations");
}FnMut с sort_by_key использовать можноТрейты Fn важны, когда вы определяете или используете функции и типы,
работающие с замыканиями. В следующем разделе мы поговорим об итераторах.
Многие методы итераторов принимают аргументами замыкания, так что держите эти
подробности о замыканиях в голове!
Обработка последовательностей итераторами
Обработка последовательностей итераторами
Шаблон «итератор» позволяет по очереди выполнить какое-то действие для каждого элемента последовательности. Итератор берёт на себя логику перебора элементов и определения того, когда последовательность закончилась. С итераторами эту логику не нужно каждый раз писать заново.
В Rust итераторы ленивые (lazy): они ничего не делают, пока не вызван
метод, который поглощает итератор, то есть расходует его. Например, код в
листинге 13-10 создаёт итератор по элементам вектора v1, вызывая метод
iter, определённый для Vec<T>. Сам по себе этот код ничего полезного не
делает.
fn main() {
let v1 = vec![1, 2, 3];
let v1_iter = v1.iter();
}Итератор хранится в переменной v1_iter. Пользоваться созданным итератором
можно по-разному. В листинге 3-5 мы перебирали массив циклом for,
выполняя код для каждого элемента. Под капотом при этом неявно создавался и
поглощался итератор, но до сих пор мы не вдавались в то, как именно это
работает.
В листинге 13-11 мы разделяем создание итератора и его использование в цикле
for. Когда цикл for запускается с итератором из v1_iter, каждый элемент
итератора используется в одной итерации цикла, и цикл выводит все значения.
fn main() {
let v1 = vec![1, 2, 3];
let v1_iter = v1.iter();
for val in v1_iter {
println!("Got: {val}");
}
}forВ языках, где в стандартной библиотеке нет итераторов, ту же функциональность вы бы, скорее всего, написали так: завели бы переменную-индекс, равную 0, брали бы по этому индексу значение из вектора и увеличивали бы индекс в цикле, пока он не достигнет количества элементов в векторе.
Итераторы берут всю эту логику на себя и избавляют от повторяющегося кода, в котором легко ошибиться. К тому же они дают больше гибкости: одну и ту же логику можно применять к самым разным последовательностям, а не только к структурам данных с индексацией, вроде векторов. Посмотрим, как итераторы этого добиваются.
Трейт Iterator и метод next
Все итераторы реализуют трейт Iterator, определённый в стандартной
библиотеке. Его определение выглядит так:
#![allow(unused)]
fn main() {
pub trait Iterator {
type Item;
fn next(&mut self) -> Option<Self::Item>;
// методы с реализациями по умолчанию опущены
}
}Заметьте, что здесь новый синтаксис: type Item и Self::Item определяют
ассоциированный тип этого трейта. Подробно об ассоциированных типах мы
поговорим в главе 20. Пока достаточно понимать: этот код говорит, что для
реализации трейта Iterator нужно также определить тип Item, и этот тип
Item используется в возвращаемом типе метода next. Иначе говоря, Item —
тип элементов, которые возвращает итератор.
Трейт Iterator требует от реализующих его типов определить лишь один метод —
next. Он возвращает элементы итератора по одному, обёрнутыми в Some, а
когда перебор закончен, возвращает None.
Метод next у итератора можно вызывать и напрямую. В листинге 13-12 видно,
какие значения возвращают последовательные вызовы next у итератора,
созданного из вектора.
#[cfg(test)]
mod tests {
#[test]
fn iterator_demonstration() {
let v1 = vec![1, 2, 3];
let mut v1_iter = v1.iter();
assert_eq!(v1_iter.next(), Some(&1));
assert_eq!(v1_iter.next(), Some(&2));
assert_eq!(v1_iter.next(), Some(&3));
assert_eq!(v1_iter.next(), None);
}
}next у итератораОбратите внимание: v1_iter пришлось сделать изменяемым. Вызов next меняет
внутреннее состояние итератора, по которому тот отслеживает, где он находится
в последовательности. Иными словами, этот код поглощает (consumes)
итератор — расходует его. Каждый вызов next «съедает» один элемент
итератора. В цикле for делать v1_iter изменяемым не требовалось: цикл
забирал владение v1_iter и незаметно для нас делал его изменяемым.
Заметьте также, что next возвращает неизменяемые ссылки на значения в
векторе: метод iter создаёт итератор по неизменяемым ссылкам. Если нужен
итератор, который забирает владение v1 и возвращает значения во владение,
вызовите вместо iter метод into_iter. А если нужно перебирать изменяемые
ссылки — iter_mut.
Методы, поглощающие итератор
У трейта Iterator много методов, реализации по умолчанию для которых даёт
стандартная библиотека; они перечислены в документации по API стандартной
библиотеки для трейта Iterator. Некоторые из этих методов вызывают в своём
определении next — поэтому при реализации трейта Iterator метод next
обязательно нужно реализовать.
Методы, которые вызывают next, называются поглощающими адаптерами
(consuming adapters): их вызов расходует итератор. Пример — метод sum: он
забирает владение итератором и перебирает элементы, раз за разом вызывая
next, то есть поглощает итератор. По ходу перебора он прибавляет каждый
элемент к промежуточной сумме и, когда перебор закончен, возвращает её. В
листинге 13-13 — тест, демонстрирующий метод sum.
#[cfg(test)]
mod tests {
#[test]
fn iterator_sum() {
let v1 = vec![1, 2, 3];
let v1_iter = v1.iter();
let total: i32 = v1_iter.sum();
assert_eq!(total, 6);
}
}sum, чтобы получить сумму всех элементов итератораПосле вызова sum пользоваться v1_iter нельзя: sum забирает владение
итератором, у которого его вызвали.
Методы, создающие другие итераторы
Адаптеры итераторов (iterator adapters) — методы трейта Iterator,
которые не поглощают итератор. Вместо этого они создают другие итераторы,
меняя какую-то сторону исходного.
В листинге 13-14 — пример вызова адаптера map, который принимает замыкание и
вызывает его для каждого элемента по ходу перебора. Метод map возвращает
новый итератор, выдающий изменённые элементы. Здесь замыкание прибавляет к
каждому элементу 1, так что новый итератор выдаёт элементы вектора,
увеличенные на 1.
fn main() {
let v1: Vec<i32> = vec![1, 2, 3];
v1.iter().map(|x| x + 1);
}map, чтобы создать новый итераторОднако этот код выдаёт предупреждение:
$ cargo run
Compiling iterators v0.1.0 (file:///projects/iterators)
warning: unused `Map` that must be used
--> src/main.rs:4:5
|
4 | v1.iter().map(|x| x + 1);
| ^^^^^^^^^^^^^^^^^^^^^^^^
|
= note: iterators are lazy and do nothing unless consumed
= note: `#[warn(unused_must_use)]` (part of `#[warn(unused)]`) on by default
help: use `let _ = ...` to ignore the resulting value
|
4 | let _ = v1.iter().map(|x| x + 1);
| +++++++
warning: `iterators` (bin "iterators") generated 1 warning
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.47s
Running `target/debug/iterators`
Код из листинга 13-14 ничего не делает: переданное замыкание так и не вызывается. Предупреждение напоминает, почему: адаптеры итераторов ленивые, и итератор здесь нужно поглотить.
Чтобы убрать предупреждение и поглотить итератор, воспользуемся методом
collect, который мы уже применяли к env::args в листинге 12-1. Этот метод
поглощает итератор и собирает получившиеся значения в коллекцию.
В листинге 13-15 мы собираем в вектор результаты перебора итератора,
который вернул вызов map. В итоге в векторе окажутся все элементы
исходного вектора, увеличенные на 1.
fn main() {
let v1: Vec<i32> = vec![1, 2, 3];
let v2: Vec<_> = v1.iter().map(|x| x + 1).collect();
assert_eq!(v2, vec![2, 3, 4]);
}map, чтобы создать новый итератор, а затем collect, чтобы поглотить его и создать векторРаз map принимает замыкание, для каждого элемента можно указать любую
операцию. Это отличный пример того, как замыкания позволяют настроить часть
поведения, повторно используя логику перебора, которую даёт трейт Iterator.
Вызовы адаптеров итераторов можно выстраивать в цепочку и так понятно описывать сложные действия. Но поскольку все итераторы ленивые, чтобы получить результат вызовов адаптеров, нужно вызвать один из поглощающих методов.
Замыкания, захватывающие окружение
Многие адаптеры итераторов принимают аргументами замыкания, и чаще всего это замыкания, которые захватывают своё окружение.
Для примера возьмём метод filter, принимающий замыкание. Замыкание получает
элемент итератора и возвращает bool. Если оно вернёт true, значение
попадёт в итератор, который создаёт filter. Если false — не попадёт.
В листинге 13-16 мы используем filter с замыканием, которое захватывает из
окружения переменную shoe_size, чтобы перебрать коллекцию экземпляров
структуры Shoe (обувь). Метод вернёт только обувь указанного размера.
#[derive(PartialEq, Debug)]
struct Shoe {
size: u32,
style: String,
}
fn shoes_in_size(shoes: Vec<Shoe>, shoe_size: u32) -> Vec<Shoe> {
shoes.into_iter().filter(|s| s.size == shoe_size).collect()
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn filters_by_size() {
let shoes = vec![
Shoe {
size: 10,
style: String::from("sneaker"),
},
Shoe {
size: 13,
style: String::from("sandal"),
},
Shoe {
size: 10,
style: String::from("boot"),
},
];
let in_my_size = shoes_in_size(shoes, 10);
assert_eq!(
in_my_size,
vec![
Shoe {
size: 10,
style: String::from("sneaker")
},
Shoe {
size: 10,
style: String::from("boot")
},
]
);
}
}filter с замыканием, которое захватывает shoe_sizeФункция shoes_in_size принимает параметрами вектор обуви (забирая
владение им) и размер. Она возвращает вектор, в котором только обувь
указанного размера.
В теле shoes_in_size мы вызываем into_iter, чтобы создать итератор,
который забирает владение вектором. Затем вызываем filter, чтобы превратить
этот итератор в новый, где останутся только элементы, для которых замыкание
вернуло true.
Замыкание захватывает из окружения параметр shoe_size и сравнивает его с
размером каждой пары обуви, оставляя только подходящие. Наконец, collect
собирает значения, которые выдаёт адаптированный итератор, в вектор, и
функция его возвращает.
Тест показывает, что при вызове shoes_in_size мы получаем обратно только
обувь того же размера, что мы указали.
Улучшаем наш проект
Улучшаем наш проект
Теперь, зная об итераторах, можно улучшить проект с вводом-выводом из главы
12: с их помощью сделать некоторые места кода понятнее и короче. Посмотрим,
как итераторы улучшат реализацию функций Config::build и search.
Избавляемся от clone с помощью итератора
В листинге 12-6 мы написали код, который брал срез значений String и
создавал экземпляр структуры Config, обращаясь к элементам среза по индексу и
клонируя значения, чтобы структура Config могла ими владеть. В листинге
13-17 — реализация функции Config::build в том виде, в каком она была в
листинге 12-23.
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}Config::build из листинга 12-23Тогда мы сказали не беспокоиться о неэффективных вызовах clone — мол, уберём
их позже. Это время пришло!
clone был нужен потому, что в параметре args у нас срез с элементами
String, а функция build не владеет args. Чтобы вернуть экземпляр Config
во владение, нам приходилось клонировать значения для полей query и
file_path структуры Config — тогда экземпляр Config сам владеет своими
значениями.
Зная об итераторах, можно изменить функцию build так, чтобы она принимала
не заимствованный срез, а итератор во владение. Вместо кода, который проверяет
длину среза и обращается к конкретным индексам, воспользуемся возможностями
итератора. Так станет понятнее, что делает Config::build, — ведь значения
будет выдавать итератор.
Когда Config::build будет владеть итератором и перестанет пользоваться
индексацией, которая лишь заимствует, значения String можно будет
перемещать из итератора в Config, а не вызывать clone с новым выделением
памяти.
Используем возвращённый итератор напрямую
Откройте файл src/main.rs проекта с вводом-выводом. Он должен выглядеть так:
Файл: src/main.rs
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
eprintln!("Problem parsing arguments: {err}");
process::exit(1);
});
// --пропуск--
if let Err(e) = run(config) {
eprintln!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}Сначала заменим начало функции main из листинга 12-24 на код из листинга
13-18 — на этот раз с итератором. Он не скомпилируется, пока мы не обновим и
Config::build.
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let config = Config::build(env::args()).unwrap_or_else(|err| {
eprintln!("Problem parsing arguments: {err}");
process::exit(1);
});
// --пропуск--
if let Err(e) = run(config) {
eprintln!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}Config::build то, что вернула env::argsФункция env::args возвращает итератор! Вместо того чтобы собирать значения
итератора в вектор и передавать в Config::build срез, мы теперь передаём в
Config::build владение самим итератором, который вернула env::args.
Теперь нужно обновить определение Config::build. Изменим её сигнатуру, как в
листинге 13-19. Код всё ещё не скомпилируется: нужно обновить и тело функции.
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let config = Config::build(env::args()).unwrap_or_else(|err| {
eprintln!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
eprintln!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(
mut args: impl Iterator<Item = String>,
) -> Result<Config, &'static str> {
// --пропуск--
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}Config::build, чтобы она ожидала итераторИз документации стандартной библиотеки к функции env::args видно, что она
возвращает итератор типа std::env::Args, а этот тип реализует трейт
Iterator и выдаёт значения String.
Мы изменили сигнатуру Config::build: у параметра args теперь не тип
&[String], а обобщённый тип с ограничением impl Iterator<Item = String>.
Это синтаксис impl Trait из раздела «Трейты как параметры» главы 10: args может быть любого типа, который реализует трейт
Iterator и выдаёт элементы String.
Мы забираем владение args и будем менять его, перебирая элементы, поэтому в
описание параметра args можно добавить mut, чтобы сделать его изменяемым.
Методы трейта Iterator вместо индексации
Теперь исправим тело Config::build. Раз args реализует трейт Iterator,
у него можно вызывать метод next! В листинге 13-20 код из листинга 12-23
переписан с использованием next.
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let config = Config::build(env::args()).unwrap_or_else(|err| {
eprintln!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
eprintln!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(
mut args: impl Iterator<Item = String>,
) -> Result<Config, &'static str> {
args.next();
let query = match args.next() {
Some(arg) => arg,
None => return Err("Didn't get a query string"),
};
let file_path = match args.next() {
Some(arg) => arg,
None => return Err("Didn't get a file path"),
};
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}Config::build с методами итератораНапомним, что первое значение среди того, что возвращает env::args, — имя
программы. Оно нам не нужно, мы хотим перейти к следующему, поэтому сначала
вызываем next и ничего не делаем с результатом. Затем снова вызываем next,
чтобы получить значение для поля query структуры Config. Если next
вернул Some, достаём значение через match. Если None — значит,
аргументов передали недостаточно, и мы досрочно возвращаем Err. То же самое
делаем для file_path.
Код понятнее с адаптерами итераторов
Итераторы пригодятся и в функции search нашего проекта. В листинге 13-21 она
показана в том виде, в каком была в листинге 12-19.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
let mut results = Vec::new();
for line in contents.lines() {
if line.contains(query) {
results.push(line);
}
}
results
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}search из листинга 12-19С адаптерами итераторов этот код можно записать короче — и заодно избавиться
от изменяемого промежуточного вектора results. Функциональный стиль
стремится свести изменяемое состояние к минимуму, чтобы код был понятнее.
Без изменяемого состояния в будущем, возможно, получится сделать поиск
параллельным: не придётся управлять одновременным доступом к вектору
results. Это изменение — в листинге 13-22.
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
contents
.lines()
.filter(|line| line.contains(query))
.collect()
}
pub fn search_case_insensitive<'a>(
query: &str,
contents: &'a str,
) -> Vec<&'a str> {
let query = query.to_lowercase();
let mut results = Vec::new();
for line in contents.lines() {
if line.to_lowercase().contains(&query) {
results.push(line);
}
}
results
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn case_sensitive() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Duct tape.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
#[test]
fn case_insensitive() {
let query = "rUsT";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Trust me.";
assert_eq!(
vec!["Rust:", "Trust me."],
search_case_insensitive(query, contents)
);
}
}search с адаптерами итераторовНапомним: задача функции search — вернуть все строки из contents, в которых
есть query. Как и в примере с filter из листинга 13-16, этот код с помощью
адаптера filter оставляет только строки, для которых line.contains(query)
возвращает true. Затем совпавшие строки собираются в новый вектор через
collect. Гораздо проще! Можете сделать такое же изменение и в функции
search_case_insensitive.
А чтобы улучшить код ещё больше, сделайте так, чтобы search возвращала
итератор: уберите вызов collect и поменяйте возвращаемый тип на
impl Iterator<Item = &'a str> — тогда функция сама станет адаптером
итератора. Учтите, что придётся обновить и тесты! Попробуйте поискать
что-нибудь в большом файле утилитой minigrep до и после этого изменения и
сравните поведение. До изменения программа ничего не выводит, пока не соберёт
все результаты. А после — результаты выводятся по мере нахождения совпадающих
строк, потому что цикл for в функции run пользуется ленивостью итератора.
Что выбрать: циклы или итераторы
Логичный следующий вопрос: какой стиль выбирать в собственном коде и почему — исходную реализацию из листинга 13-21 или версию с итераторами из листинга 13-22 (если считать, что мы собираем все результаты перед возвратом, а не возвращаем итератор)? Большинство программистов на Rust предпочитают стиль с итераторами. Освоиться с ним поначалу чуть сложнее, но когда разберёшься в разных адаптерах и в том, что они делают, итераторы читаются легче. Вместо возни с деталями цикла и построением новых векторов код сосредоточен на высокоуровневой цели цикла. Рутинный код уходит в абстракцию, и проще увидеть то, что уникально именно для этого кода, — например, условие фильтрации, которое должен пройти каждый элемент итератора.
Но действительно ли эти две реализации равноценны? Интуиция подсказывает, что низкоуровневый цикл будет быстрее. Поговорим о производительности.
Производительность: циклы против итераторов
Производительность: циклы против итераторов
Чтобы решить, что использовать — циклы или итераторы, — нужно знать, какая
реализация быстрее: версия функции search с явным циклом for или версия с
итераторами.
Мы провели замер (benchmark): загрузили в String весь текст «Приключений
Шерлока Холмса» сэра Артура Конан Дойла и искали в нём слово the. Вот
результаты для версии search с циклом for и для версии с итераторами:
test bench_search_for ... bench: 19,620,300 ns/iter (+/- 915,700)
test bench_search_iter ... bench: 19,234,900 ns/iter (+/- 657,200)
Производительность у двух реализаций почти одинаковая! Код замера мы здесь разбирать не будем: цель не в том, чтобы доказать равноценность двух версий, а в том, чтобы получить общее представление, как они соотносятся по производительности.
Для более полного замера стоило бы проверить разные тексты разного объёма в
качестве contents, разные слова разной длины в качестве query и всякие
другие варианты. Главное вот что: итераторы, хоть и являются
высокоуровневой абстракцией, компилируются примерно в тот же код, какой вы
написали бы сами на низком уровне. Итераторы — одна из абстракций с нулевой
стоимостью (zero-cost abstractions) в Rust: их использование не добавляет
накладных расходов во время выполнения. Это похоже на то, как Бьёрн
Страуструп, создатель и первый разработчик C++, определяет принцип нулевых
накладных расходов в своём докладе 2012 года на ETAPS «Foundations of C++»:
В целом реализации C++ подчиняются принципу нулевых накладных расходов: за то, чем не пользуешься, не платишь. И более того: то, чем пользуешься, вручную лучше не написать.
Во многих случаях код на Rust с итераторами компилируется в тот же ассемблер, что вы написали бы вручную. Применяются оптимизации вроде развёртывания циклов и устранения проверок границ при доступе к массиву, и итоговый код получается чрезвычайно эффективным. Зная это, можно смело пользоваться итераторами и замыканиями! Код с ними выглядит высокоуровневым, но платить за это производительностью во время выполнения не приходится.
Итоги
Замыкания и итераторы — возможности Rust, вдохновлённые идеями функциональных языков программирования. Они помогают Rust ясно выражать высокоуровневые идеи с производительностью низкоуровневого кода. Замыкания и итераторы реализованы так, что на производительность во время выполнения они не влияют. Это часть стремления Rust давать абстракции с нулевой стоимостью.
Теперь, когда наш проект с вводом-выводом стал выразительнее, посмотрим на
другие возможности cargo, которые помогут поделиться проектом с миром.
Подробнее о Cargo и Crates.io
До сих пор мы пользовались лишь самыми базовыми возможностями Cargo: собирали, запускали и тестировали код. Но умеет он гораздо больше. В этой главе мы обсудим некоторые более продвинутые возможности и покажем, как:
- настраивать сборку с помощью профилей сборки;
- публиковать библиотеки на crates.io;
- организовывать большие проекты с помощью рабочих пространств;
- устанавливать бинарники с crates.io;
- расширять Cargo своими командами.
Cargo умеет ещё больше, чем мы разберём в этой главе; полное описание всех его возможностей — в документации.
Профили сборки
Профили сборки
В Rust профили сборки (release profiles) — это заранее определённые настраиваемые профили с разными конфигурациями, которые дают программисту больше контроля над параметрами компиляции кода. Каждый профиль настраивается независимо от остальных.
У Cargo два основных профиля: dev, который используется при cargo build, и
release, который используется при cargo build --release. У профиля dev
настройки по умолчанию хорошо подходят для разработки, а у release — для
сборки релизов.
Эти имена профилей могут быть вам знакомы по выводу сборки:
$ cargo build
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.00s
$ cargo build --release
Finished `release` profile [optimized] target(s) in 0.32s
dev и release — это и есть разные профили, которые использует компилятор.
Для каждого профиля у Cargo есть настройки по умолчанию, которые действуют,
пока вы явно не добавили в Cargo.toml проекта секции [profile.*]. Добавив
секцию [profile.*] для профиля, который хотите настроить, можно
переопределить любую часть настроек по умолчанию. Например, вот значения
настройки opt-level по умолчанию для профилей dev и release:
Файл: Cargo.toml
[profile.dev]
opt-level = 0
[profile.release]
opt-level = 3
Настройка opt-level управляет тем, сколько оптимизаций Rust применит к
коду, — от 0 до 3. Чем больше оптимизаций, тем дольше компиляция. Поэтому во
время разработки, когда код компилируется часто, лучше меньше оптимизаций —
пусть компиляция будет быстрее, даже если итоговый код работает медленнее.
Поэтому opt-level по умолчанию для dev равен 0. А когда код готов к
выпуску, на компиляцию лучше потратить больше времени: в режиме релиза вы
скомпилируете программу один раз, а запускать будете много раз. Режим релиза
жертвует временем компиляции ради более быстрого кода. Поэтому opt-level по
умолчанию для профиля release равен 3.
Настройку по умолчанию можно переопределить, указав другое значение в Cargo.toml. Например, если в профиле разработки мы хотим использовать уровень оптимизации 1, добавим в Cargo.toml проекта две строки:
Файл: Cargo.toml
[profile.dev]
opt-level = 1
Этот код переопределяет значение по умолчанию 0. Теперь cargo build будет
использовать настройки профиля dev по умолчанию плюс нашу настройку
opt-level. Раз мы задали opt-level равным 1, Cargo применит больше
оптимизаций, чем по умолчанию, но не столько, сколько при сборке релиза.
Полный список параметров и их значения по умолчанию для каждого профиля — в документации Cargo.
Публикация крейта на Crates.io
Публикация крейта на Crates.io
Мы уже подключали пакеты с crates.io как зависимости нашего проекта, но можно и самим делиться кодом с другими, публикуя собственные пакеты. Реестр крейтов на crates.io распространяет исходный код пакетов, поэтому там в основном хранится код с открытыми исходниками.
В Rust и Cargo есть возможности, которые помогают людям находить ваш опубликованный пакет и пользоваться им. Сначала мы поговорим о некоторых из них, а потом объясним, как опубликовать пакет.
Полезные документационные комментарии
Точная документация помогает другим понять, как и когда пользоваться вашими
пакетами, так что время на неё стоит потратить. В главе 3 мы говорили, как
комментировать код на Rust двумя косыми чертами, //. Но в Rust есть и
особый вид комментариев для документации — так и называемые
документационные комментарии (documentation comments), — из которых
генерируется HTML-документация. В HTML показывается содержимое
документационных комментариев к элементам публичного API — для программистов,
которым интересно, как пользоваться вашим крейтом, а не как он устроен.
Документационные комментарии начинаются с трёх косых черт, ///, и
поддерживают разметку Markdown для форматирования текста. Пишите их прямо
перед элементом, который документируете. В листинге 14-1 — документационные
комментарии к функции add_one из крейта my_crate.
/// Прибавляет единицу к переданному числу.
///
/// # Примеры
///
/// ```
/// let arg = 5;
/// let answer = my_crate::add_one(arg);
///
/// assert_eq!(6, answer);
/// ```
pub fn add_one(x: i32) -> i32 {
x + 1
}Здесь мы описываем, что делает функция add_one, открываем раздел с
заголовком Examples (примеры) и приводим код, показывающий, как
пользоваться add_one. HTML-документацию из этого комментария можно
сгенерировать командой cargo doc. Она запускает утилиту rustdoc, которая
поставляется вместе с Rust, и кладёт сгенерированную HTML-документацию в папку
target/doc.
Для удобства есть cargo doc --open: эта команда соберёт HTML-документацию
текущего крейта (и всех его зависимостей) и откроет её в браузере. Перейдите к
функции add_one — и увидите, как отображается текст документационных
комментариев (рисунок 14-1).
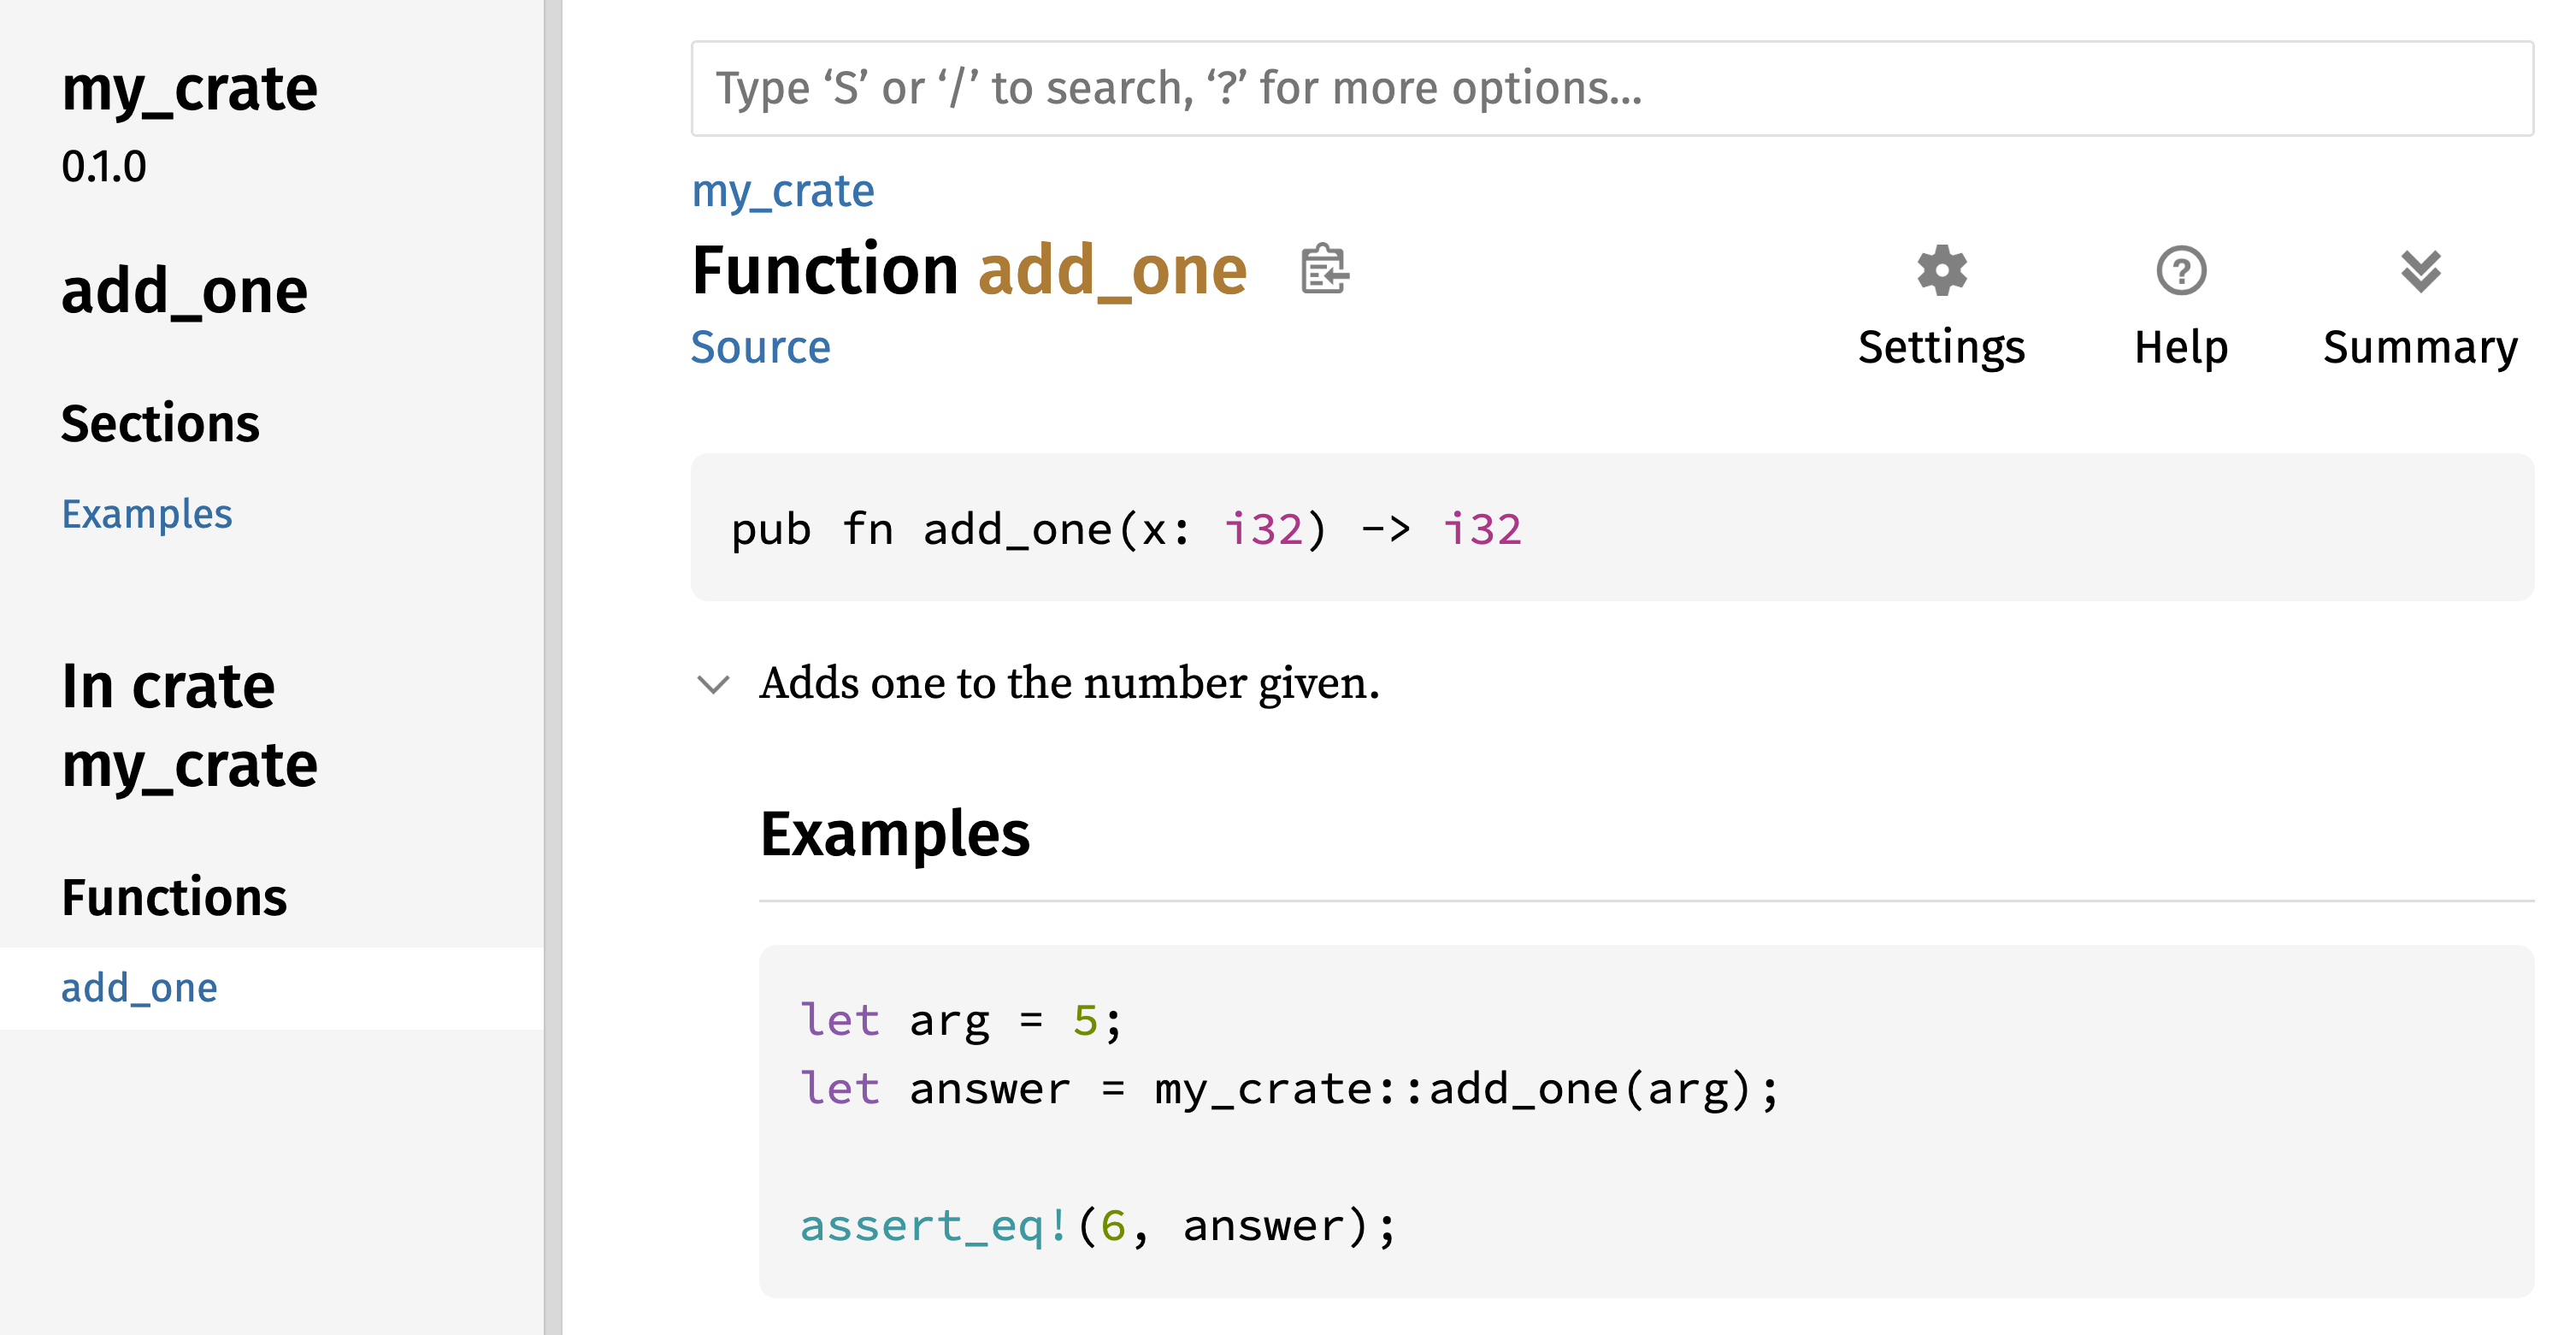
Рисунок 14-1: HTML-документация функции add_one
Часто используемые разделы
В листинге 14-1 Markdown-заголовок # Examples создал в HTML раздел
«Examples». Вот какие ещё разделы авторы крейтов часто добавляют в
документацию:
- Panics (паника): в каких ситуациях документируемая функция может паниковать. Те, кто вызывает функцию и не хочет, чтобы программа паниковала, должны следить, чтобы не вызывать её в таких ситуациях.
- Errors (ошибки): если функция возвращает
Result, полезно описать, какие ошибки возможны и при каких условиях они возвращаются, — чтобы вызывающие могли по-разному обрабатывать разные виды ошибок. - Safety (безопасность): если вызов функции —
unsafe(о небезопасном коде мы поговорим в главе 20), нужен раздел, объясняющий, почему функция небезопасна, и описывающий инварианты, которые функция ожидает от вызывающих.
Большинству документационных комментариев все эти разделы не нужны, но этот список — хорошая памятка о том, что пользователям вашего кода может быть интересно узнать.
Документационные комментарии как тесты
Примеры кода в документационных комментариях показывают, как пользоваться
библиотекой, и дают ещё один бонус: cargo test запускает примеры кода из
документации как тесты! Нет ничего лучше документации с примерами. Но нет
ничего хуже примеров, которые не работают, потому что код изменился с тех пор,
как писалась документация. Если запустить cargo test с документацией к
функции add_one из листинга 14-1, в результатах тестов появится такой раздел:
Doc-tests my_crate
running 1 test
test src/lib.rs - add_one (line 5) ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.27s
Если теперь изменить функцию или пример так, чтобы assert_eq! в примере
паниковал, и снова запустить cargo test, документационные тесты поймают
расхождение между примером и кодом!
Комментарии к содержащему элементу
Документационный комментарий вида //! документирует элемент, который
содержит этот комментарий, а не элемент, следующий за комментарием. Обычно
такие комментарии пишут в файле корня крейта (по соглашению это src/lib.rs)
или внутри модуля, чтобы задокументировать крейт или модуль целиком.
Например, чтобы описать назначение крейта my_crate, в котором находится
функция add_one, добавим в начало файла src/lib.rs документационные
комментарии, начинающиеся с //!, как в листинге 14-2.
//! # Мой крейт
//!
//! `my_crate` — набор утилит, упрощающих некоторые
//! вычисления.
/// Прибавляет единицу к переданному числу.
// --пропуск--
///
/// # Примеры
///
/// ```
/// let arg = 5;
/// let answer = my_crate::add_one(arg);
///
/// assert_eq!(6, answer);
/// ```
pub fn add_one(x: i32) -> i32 {
x + 1
}my_crate в целомЗаметьте, что после последней строки, начинающейся с //!, нет никакого кода.
Раз комментарии начинаются с //!, а не с ///, мы документируем элемент,
который содержит этот комментарий, а не элемент после него. В нашем случае это
файл src/lib.rs — корень крейта. Эти комментарии описывают весь крейт.
Если запустить cargo doc --open, эти комментарии появятся на главной
странице документации my_crate, над списком публичных элементов крейта, как
на рисунке 14-2.
Документационные комментарии внутри элементов особенно полезны для описания крейтов и модулей. Пишите в них общее назначение контейнера, чтобы пользователям было проще понять, как организован крейт.
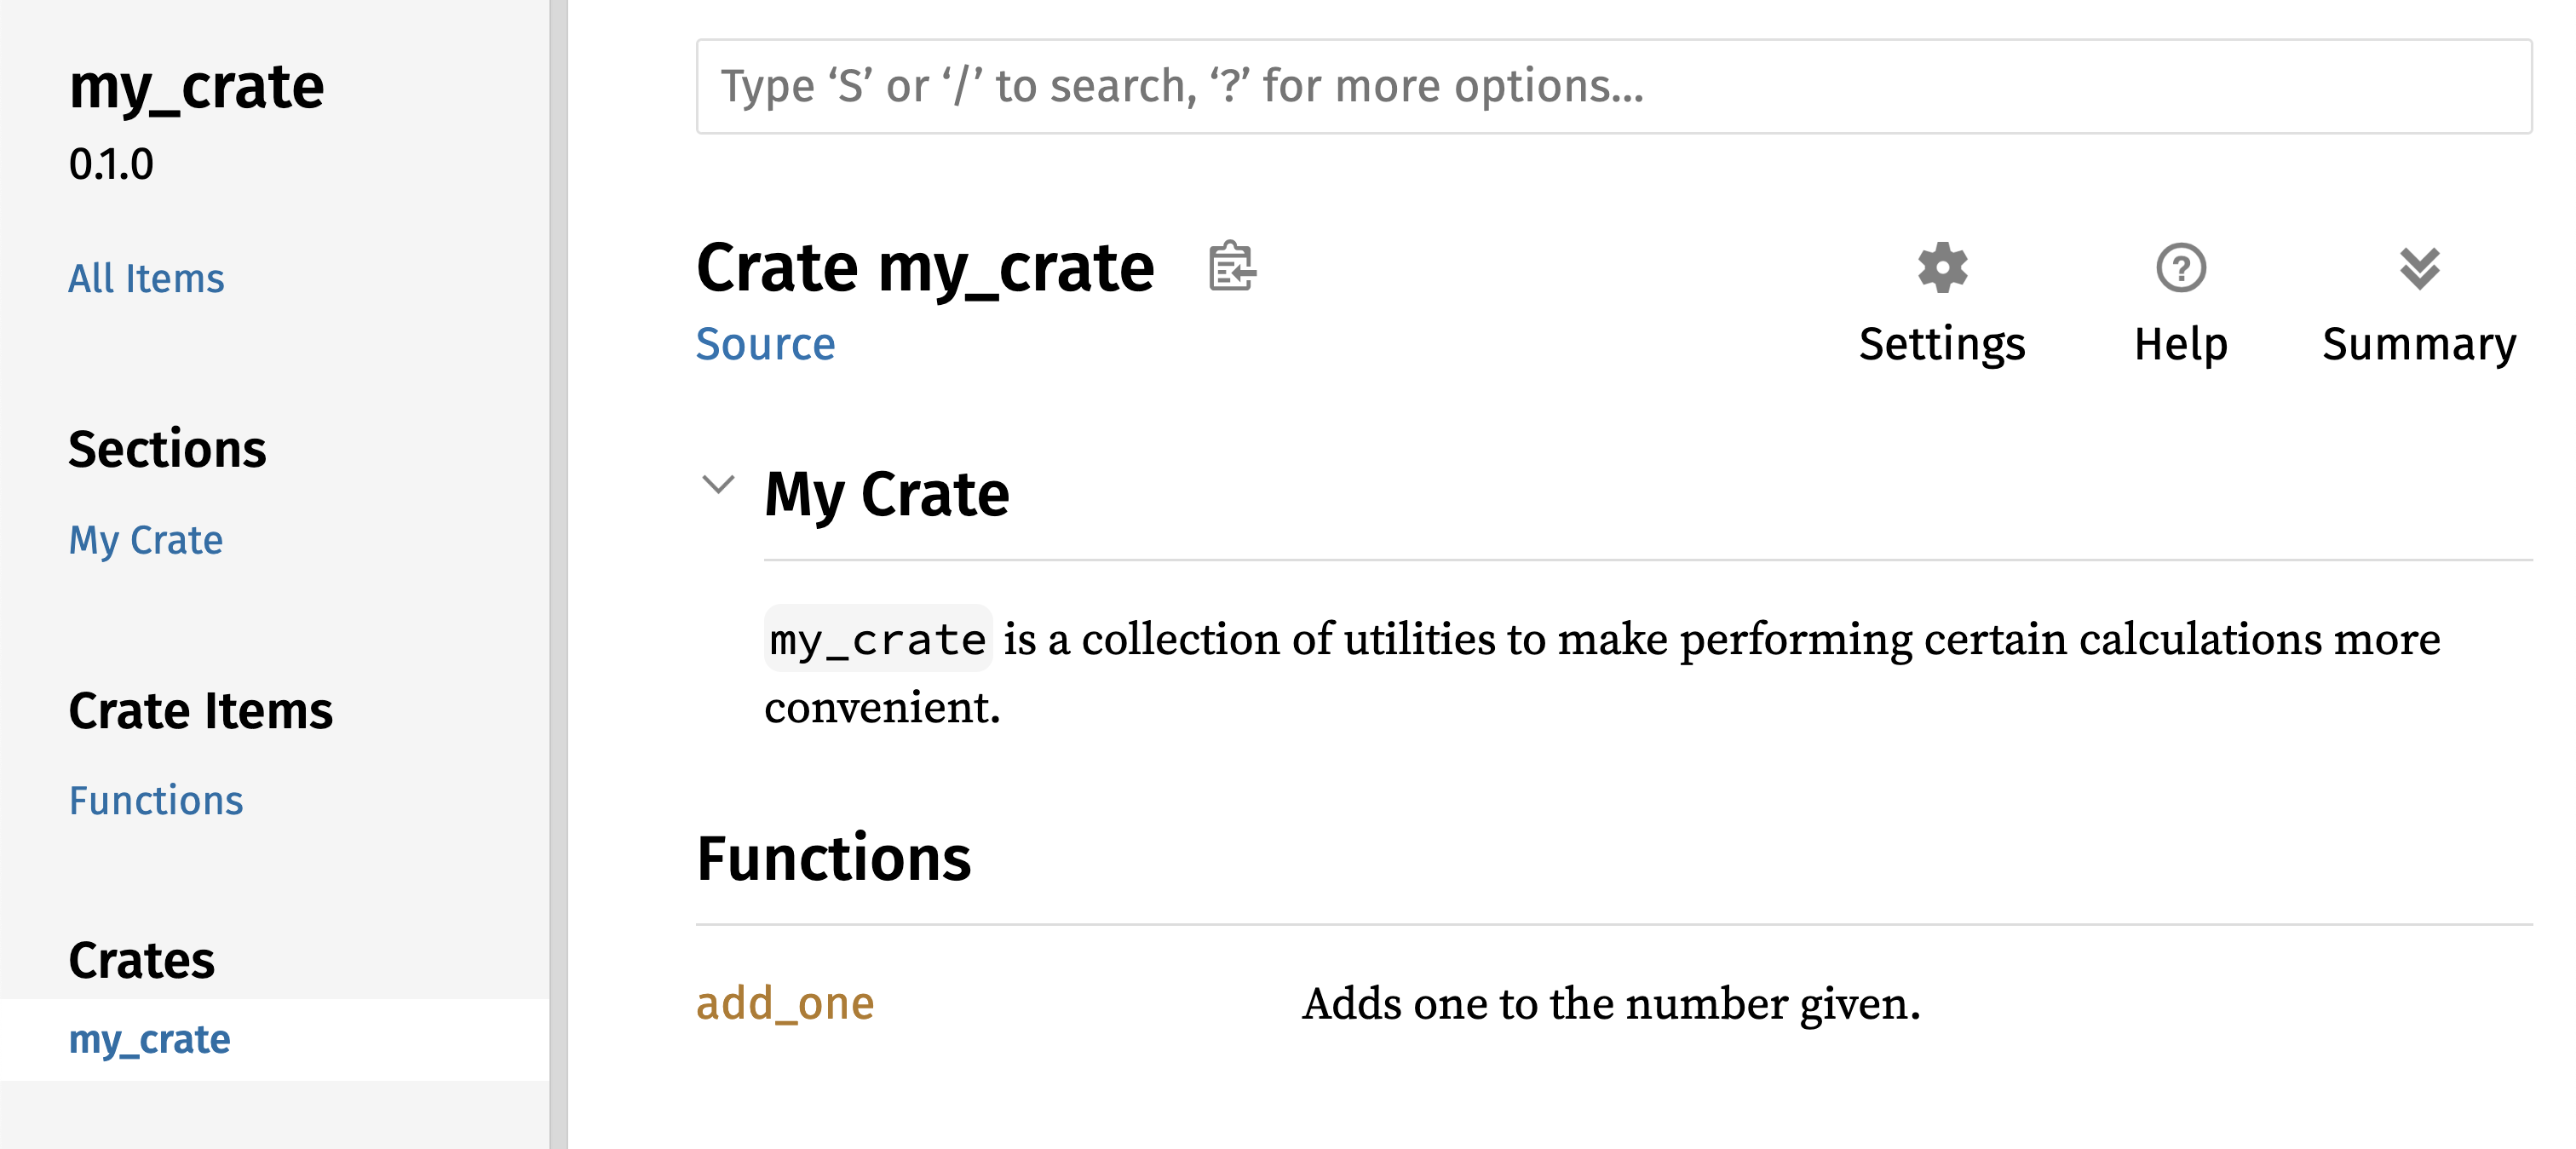
Рисунок 14-2: Документация my_crate с комментарием,
описывающим крейт целиком
Экспорт удобного публичного API
При публикации крейта очень важна структура его публичного API. Те, кто пользуется вашим крейтом, знакомы с его структурой хуже вас и, если иерархия модулей большая, могут с трудом находить нужное.
В главе 7 мы разобрали, как делать элементы публичными ключевым словом pub и
подключать их в область видимости ключевым словом use. Но структура, удобная
вам при разработке крейта, может оказаться не очень удобной для пользователей.
Вам может захотеться разложить структуры по многоуровневой иерархии, но тогда
тем, кому нужен тип, определённый где-то в глубине, может быть трудно даже
узнать, что такой тип существует. Да и писать
use my_crate::some_module::another_module::UsefulType; вместо
use my_crate::UsefulType; им будет неприятно.
Хорошая новость: если структура неудобна для использования из другой
библиотеки, перестраивать внутреннюю организацию не нужно. Вместо этого можно
реэкспортировать элементы с помощью pub use и сделать публичную структуру,
отличную от внутренней. Реэкспорт (re-exporting) берёт публичный элемент
из одного места и делает его публичным в другом — так, будто он там и
определён.
Допустим, мы сделали библиотеку art для моделирования понятий из мира
искусства. В ней два модуля: kinds с двумя перечислениями, PrimaryColor
(основной цвет) и SecondaryColor (составной цвет), и utils с функцией mix
(смешать), как в листинге 14-3.
//! # Art
//!
//! Библиотека для моделирования понятий из мира искусства.
pub mod kinds {
/// Основные цвета в цветовой модели RYB.
pub enum PrimaryColor {
Red,
Yellow,
Blue,
}
/// Составные цвета в цветовой модели RYB.
pub enum SecondaryColor {
Orange,
Green,
Purple,
}
}
pub mod utils {
use crate::kinds::*;
/// Смешивает два основных цвета в равных долях
/// и получает составной цвет.
pub fn mix(c1: PrimaryColor, c2: PrimaryColor) -> SecondaryColor {
// --пропуск--
unimplemented!();
}
}art, элементы которой разложены по модулям kinds и utilsНа рисунке 14-3 — как выглядела бы главная страница документации этого
крейта, сгенерированная cargo doc.
Рисунок 14-3: Главная страница документации art со
списком модулей kinds и utils
Обратите внимание: ни типов PrimaryColor и SecondaryColor, ни функции
mix на главной странице нет. Чтобы их увидеть, нужно перейти в kinds и
utils.
Другому крейту, который зависит от этой библиотеки, понадобятся инструкции
use, подключающие элементы из art с указанием текущей структуры модулей. В
листинге 14-4 — пример крейта, который использует элементы PrimaryColor и
mix из крейта art.
use art::kinds::PrimaryColor;
use art::utils::mix;
fn main() {
let red = PrimaryColor::Red;
let yellow = PrimaryColor::Yellow;
mix(red, yellow);
}art с его внутренней структуройАвтору кода из листинга 14-4 пришлось выяснять, что PrimaryColor лежит в
модуле kinds, а mix — в модуле utils. Структура модулей крейта art
важна скорее тем, кто его разрабатывает, чем тем, кто им пользуется. Тому, кто
пытается понять, как пользоваться крейтом art, внутренняя структура ничего
полезного не говорит, а только запутывает: приходится выяснять, где что
искать, и указывать имена модулей в инструкциях use.
Чтобы убрать внутреннюю организацию из публичного API, изменим код крейта art
из листинга 14-3: добавим инструкции pub use, которые реэкспортируют элементы
на верхний уровень, как в листинге 14-5.
//! # Art
//!
//! Библиотека для моделирования понятий из мира искусства.
pub use self::kinds::PrimaryColor;
pub use self::kinds::SecondaryColor;
pub use self::utils::mix;
pub mod kinds {
// --пропуск--
/// Основные цвета в цветовой модели RYB.
pub enum PrimaryColor {
Red,
Yellow,
Blue,
}
/// Составные цвета в цветовой модели RYB.
pub enum SecondaryColor {
Orange,
Green,
Purple,
}
}
pub mod utils {
// --пропуск--
use crate::kinds::*;
/// Смешивает два основных цвета в равных долях
/// и получает составной цвет.
pub fn mix(c1: PrimaryColor, c2: PrimaryColor) -> SecondaryColor {
SecondaryColor::Orange
}
}pub use для реэкспорта элементовТеперь документация к API, которую генерирует cargo doc, будет перечислять
реэкспорты на главной странице со ссылками на них, как на рисунке 14-4, — и
найти типы PrimaryColor и SecondaryColor и функцию mix станет проще.
Рисунок 14-4: Главная страница документации art со
списком реэкспортов
Пользователи крейта art по-прежнему могут видеть и использовать внутреннюю
структуру из листинга 14-3, как в листинге 14-4, а могут пользоваться более
удобной структурой из листинга 14-5, как в листинге 14-6.
use art::PrimaryColor;
use art::mix;
fn main() {
// --пропуск--
let red = PrimaryColor::Red;
let yellow = PrimaryColor::Yellow;
mix(red, yellow);
}artКогда вложенных модулей много, реэкспорт типов на верхний уровень через
pub use может сильно облегчить жизнь пользователям крейта. Ещё одно частое
применение pub use — реэкспортировать определения из зависимости, чтобы они
стали частью публичного API вашего крейта.
Удобная структура публичного API — скорее искусство, чем наука, и подходящий
для пользователей API можно искать итерациями. pub use даёт свободу во
внутренней организации крейта и отвязывает её от того, что видят
пользователи. Загляните в код установленных у вас крейтов — отличается ли их
внутренняя структура от публичного API?
Учётная запись на Crates.io
Прежде чем публиковать крейты, нужно завести учётную запись на
crates.io и получить API-токен. Для этого
зайдите на главную страницу crates.io и
войдите через аккаунт GitHub. (Сейчас аккаунт GitHub обязателен, но в будущем
сайт может поддерживать и другие способы регистрации.) Войдя, откройте
настройки учётной записи на
https://crates.io/me/ и получите свой
API-ключ. Затем выполните команду cargo login и вставьте ключ, когда его
попросят:
$ cargo login
abcdefghijklmnopqrstuvwxyz012345
Эта команда сообщит Cargo ваш API-токен и сохранит его локально в ~/.cargo/credentials.toml. Учтите: токен — секрет, никому его не показывайте. Если по какой-то причине вы всё-таки им с кем-то поделились, отзовите его и сгенерируйте новый на crates.io.
Метаданные нового крейта
Допустим, у вас есть крейт, который вы хотите опубликовать. Перед публикацией
нужно добавить кое-какие метаданные в секцию [package] файла Cargo.toml
крейта.
Крейту нужно уникальное имя. Пока вы работаете над крейтом локально, назвать
его можно как угодно. Но имена крейтов на crates.io раздаются по принципу «кто первым встал, того и тапки». Если имя
занято, никто другой опубликовать крейт с таким именем уже не сможет. Прежде
чем публиковать крейт, поищите на сайте имя, которое хотите использовать.
Если оно занято, придумайте другое и для публикации поменяйте поле name в
секции [package] файла Cargo.toml:
Файл: Cargo.toml
[package]
name = "guessing_game"
Даже с уникальным именем, если сейчас запустить cargo publish, вы получите
предупреждение, а затем ошибку:
$ cargo publish
Updating crates.io index
warning: manifest has no description, license, license-file, documentation, homepage or repository.
See https://doc.rust-lang.org/cargo/reference/manifest.html#package-metadata for more info.
--snip--
error: failed to publish to registry at https://crates.io
Caused by:
the remote server responded with an error (status 400 Bad Request): missing or empty metadata fields: description, license. Please see https://doc.rust-lang.org/cargo/reference/manifest.html for more information on configuring these fields
Ошибка возникает потому, что не хватает важной информации: описание и
лицензия обязательны, чтобы люди знали, что делает ваш крейт и на каких условиях им
можно пользоваться. Добавьте в Cargo.toml описание из одного-двух
предложений — оно будет показываться рядом с крейтом в результатах поиска. В
поле license нужно указать идентификатор лицензии. Допустимые
идентификаторы перечислены в Software Package Data Exchange (SPDX) от Linux
Foundation. Например, чтобы указать, что крейт распространяется под
лицензией MIT, добавьте идентификатор MIT:
Файл: Cargo.toml
[package]
name = "guessing_game"
license = "MIT"
Если вы хотите использовать лицензию, которой нет в SPDX, положите её текст в
файл, включите его в проект и вместо ключа license укажите имя этого файла в
ключе license-file.
Советы о том, какая лицензия подойдёт вашему проекту, выходят за рамки этой
книги. Многие в сообществе Rust лицензируют свои проекты так же, как сам Rust,
— двойной лицензией MIT OR Apache-2.0. Отсюда видно, что можно указать и
несколько идентификаторов лицензий через OR, чтобы у проекта было несколько
лицензий.
С уникальным именем, версией, описанием и лицензией файл Cargo.toml проекта, готового к публикации, может выглядеть так:
Файл: Cargo.toml
[package]
name = "guessing_game"
version = "0.1.0"
edition = "2024"
description = "A fun game where you guess what number the computer has chosen."
license = "MIT OR Apache-2.0"
[dependencies]
В документации Cargo описаны и другие метаданные, которые помогут людям находить ваш крейт и пользоваться им.
Публикация на Crates.io
Учётная запись создана, API-токен сохранён, имя для крейта выбрано, нужные метаданные указаны — можно публиковать! Публикация загружает определённую версию крейта на crates.io, чтобы ею могли пользоваться другие.
Будьте внимательны: публикация необратима. Версию нельзя перезаписать, а код нельзя удалить — разве что в особых случаях. Одна из главных целей Crates.io — быть постоянным архивом кода, чтобы сборки всех проектов, зависящих от крейтов с crates.io, продолжали работать. Если бы версии можно было удалять, этой цели было бы не достичь. Зато количество публикуемых версий крейта не ограничено.
Снова запустите cargo publish. Теперь всё должно получиться:
$ cargo publish
Updating crates.io index
Packaging guessing_game v0.1.0 (file:///projects/guessing_game)
Packaged 6 files, 1.2KiB (895.0B compressed)
Verifying guessing_game v0.1.0 (file:///projects/guessing_game)
Compiling guessing_game v0.1.0
(file:///projects/guessing_game/target/package/guessing_game-0.1.0)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.19s
Uploading guessing_game v0.1.0 (file:///projects/guessing_game)
Uploaded guessing_game v0.1.0 to registry `crates-io`
note: waiting for `guessing_game v0.1.0` to be available at registry
`crates-io`.
You may press ctrl-c to skip waiting; the crate should be available shortly.
Published guessing_game v0.1.0 at registry `crates-io`
Поздравляем! Вы поделились своим кодом с сообществом Rust, и теперь любой может легко подключить ваш крейт как зависимость своего проекта.
Публикация новой версии существующего крейта
Когда вы внесли в крейт изменения и готовы выпустить новую версию, поменяйте
значение version в Cargo.toml и опубликуйте крейт заново. Каким должен
быть следующий номер версии, решайте по правилам семантического
версионирования в зависимости от характера изменений. Затем
запустите cargo publish, чтобы загрузить новую версию.
Отзыв версий с Crates.io
Удалить прежние версии крейта нельзя, но можно запретить новым проектам добавлять их в зависимости. Это пригодится, если какая-то версия крейта оказалась сломанной. Для таких случаев Cargo поддерживает отзыв версии (yank).
Отзыв версии не даёт новым проектам начать от неё зависеть, но все существующие проекты, которые уже от неё зависят, продолжают работать. По сути, отзыв означает, что проекты с Cargo.lock не сломаются, а во всех новых файлах Cargo.lock отозванная версия использоваться не будет.
Чтобы отозвать версию крейта, в папке ранее опубликованного крейта запустите
cargo yank и укажите, какую версию отозвать. Например, если мы опубликовали
крейт guessing_game версии 1.0.1 и хотим её отозвать, выполним в папке
проекта guessing_game:
$ cargo yank --vers 1.0.1
Updating crates.io index
Yank guessing_game@1.0.1
Добавив к команде --undo, отзыв можно отменить и снова разрешить проектам
зависеть от этой версии:
$ cargo yank --vers 1.0.1 --undo
Updating crates.io index
Unyank guessing_game@1.0.1
Отзыв не удаляет код. С его помощью, например, нельзя удалить случайно загруженные секреты. Если такое случилось, немедленно смените эти секреты.
Рабочие пространства Cargo
Рабочие пространства Cargo
В главе 12 мы сделали пакет с бинарным и библиотечным крейтом. По мере развития проекта библиотечный крейт может разрастаться, и захочется разбить пакет на несколько библиотечных крейтов. Для управления несколькими связанными пакетами, которые разрабатываются вместе, в Cargo есть рабочие пространства (workspaces).
Создание рабочего пространства
Рабочее пространство — это набор пакетов с общим файлом Cargo.lock и общей
папкой для результатов сборки. Сделаем проект с рабочим пространством — код
будет тривиальным, чтобы сосредоточиться на структуре. Устроить рабочее
пространство можно по-разному; мы покажем один распространённый вариант. В
нашем рабочем пространстве будут бинарник и две библиотеки. Бинарник, в
котором основная функциональность, будет зависеть от обеих библиотек. Одна
библиотека даст функцию add_one, другая — функцию add_two. Все три крейта
войдут в одно рабочее пространство. Начнём с новой папки для рабочего
пространства:
$ mkdir add
$ cd add
Затем в папке add создадим файл Cargo.toml, который настраивает всё
рабочее пространство. Секции [package] в нём не будет. Вместо этого он
начнётся с секции [workspace], через которую в рабочее пространство
добавляются участники. Заодно укажем самую свежую версию алгоритма разрешения
зависимостей Cargo, задав resolver равным "3":
Файл: Cargo.toml
[workspace]
resolver = "3"
Теперь создадим бинарный крейт adder, запустив cargo new внутри папки
add:
$ cargo new adder
Created binary (application) `adder` package
Adding `adder` as member of workspace at `file:///projects/add`
Если запустить cargo new внутри рабочего пространства, новый пакет
автоматически добавится в ключ members определения [workspace] в
Cargo.toml рабочего пространства:
[workspace]
resolver = "3"
members = ["adder"]
Теперь рабочее пространство можно собрать командой cargo build. Файлы в
папке add должны выглядеть так:
├── Cargo.lock
├── Cargo.toml
├── adder
│ ├── Cargo.toml
│ └── src
│ └── main.rs
└── target
У рабочего пространства одна папка target на верхнем уровне, куда попадают
результаты компиляции; своей папки target у пакета adder нет. Даже если
запустить cargo build изнутри папки adder, результаты сборки всё равно
окажутся в add/target, а не в add/adder/target. Cargo устраивает папку
target так потому, что крейты рабочего пространства, как правило, зависят
друг от друга. Будь у каждого крейта своя папка target, каждому пришлось бы заново
компилировать все остальные крейты рабочего пространства, чтобы положить
результаты к себе. С общей папкой target крейты избегают лишних пересборок.
Второй пакет в рабочем пространстве
Добавим в рабочее пространство ещё одного участника и назовём его add_one.
Создадим новый библиотечный крейт add_one:
$ cargo new add_one --lib
Created library `add_one` package
Adding `add_one` as member of workspace at `file:///projects/add`
Теперь в списке members в Cargo.toml верхнего уровня есть путь add_one:
Файл: Cargo.toml
[workspace]
resolver = "3"
members = ["adder", "add_one"]
А в папке add теперь такие папки и файлы:
├── Cargo.lock
├── Cargo.toml
├── add_one
│ ├── Cargo.toml
│ └── src
│ └── lib.rs
├── adder
│ ├── Cargo.toml
│ └── src
│ └── main.rs
└── target
Добавим в файл add_one/src/lib.rs функцию add_one:
Файл: add_one/src/lib.rs
pub fn add_one(x: i32) -> i32 {
x + 1
}Теперь пакет adder с бинарником может зависеть от пакета add_one с
библиотекой. Сначала добавим в adder/Cargo.toml зависимость от add_one по
пути:
Файл: adder/Cargo.toml
[dependencies]
add_one = { path = "../add_one" }
Cargo не предполагает, что крейты рабочего пространства зависят друг от друга, поэтому зависимости нужно указывать явно.
Теперь воспользуемся функцией add_one (из крейта add_one) в крейте
adder. Откройте файл adder/src/main.rs и измените функцию main так,
чтобы она вызывала add_one, как в листинге 14-7.
fn main() {
let num = 10;
println!("Hello, world! {num} plus one is {}!", add_one::add_one(num));
}add_one из крейта adderСоберём рабочее пространство, запустив cargo build в папке add верхнего
уровня!
$ cargo build
Compiling add_one v0.1.0 (file:///projects/add/add_one)
Compiling adder v0.1.0 (file:///projects/add/adder)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.22s
Чтобы запустить бинарный крейт из папки add, укажите, какой пакет рабочего
пространства запускать, с помощью аргумента -p и имени пакета в cargo run:
$ cargo run -p adder
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.00s
Running `target/debug/adder`
Hello, world! 10 plus one is 11!
Так запускается код из adder/src/main.rs, который зависит от крейта
add_one.
Зависимость от внешнего пакета
Заметьте, что у рабочего пространства только один файл Cargo.lock — на
верхнем уровне, а не по файлу в папке каждого крейта. Так все крейты
гарантированно используют одни и те же версии всех зависимостей. Если
добавить пакет rand и в adder/Cargo.toml, и в add_one/Cargo.toml, Cargo
сведёт оба к одной версии rand и запишет её в единственный Cargo.lock.
Когда все крейты рабочего пространства используют одни и те же зависимости,
они всегда совместимы друг с другом. Добавим крейт rand в секцию
[dependencies] файла add_one/Cargo.toml, чтобы пользоваться им в крейте
add_one:
Файл: add_one/Cargo.toml
[dependencies]
rand = "0.10.1"
Теперь можно добавить use rand; в файл add_one/src/lib.rs, и сборка всего
рабочего пространства командой cargo build в папке add скачает и
скомпилирует крейт rand. Будет одно предупреждение — ведь подключённый rand
мы нигде не используем:
$ cargo build
Updating crates.io index
Downloaded rand v0.10.1
--snip--
Compiling rand v0.10.1
Compiling add_one v0.1.0 (file:///projects/add/add_one)
warning: unused import: `rand`
--> add_one/src/lib.rs:1:5
|
1 | use rand;
| ^^^^
|
= note: `#[warn(unused_imports)]` (part of `#[warn(unused)]`) on by default
warning: `add_one` (lib) generated 1 warning (run `cargo fix --lib -p add_one` to apply 1 suggestion)
Compiling adder v0.1.0 (file:///projects/add/adder)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.95s
Теперь в Cargo.lock верхнего уровня записано, что add_one зависит от
rand. Но хотя rand где-то в рабочем пространстве используется, в других
его крейтах пользоваться rand нельзя, пока вы не добавите rand и в их
Cargo.toml. Например, если добавить use rand; в файл adder/src/main.rs
пакета adder, получим ошибку:
$ cargo build
--snip--
Compiling adder v0.1.0 (file:///projects/add/adder)
error[E0432]: unresolved import `rand`
--> adder/src/main.rs:2:5
|
2 | use rand;
| ^^^^ no external crate `rand`
Чтобы это исправить, отредактируйте Cargo.toml пакета adder и укажите, что
он тоже зависит от rand. При сборке пакета adder в Cargo.lock в список
зависимостей adder добавится rand, но ещё одна копия rand скачиваться не
будет. Cargo проследит, чтобы все крейты всех пакетов рабочего пространства,
использующие rand, использовали одну и ту же его версию — если указанные
версии совместимы. Это экономит место и гарантирует совместимость крейтов
рабочего пространства между собой.
Если же крейты рабочего пространства укажут несовместимые версии одной зависимости, Cargo подберёт подходящую версию для каждого из них, но постарается обойтись как можно меньшим числом разных версий.
Тесты в рабочем пространстве
Улучшим проект ещё: добавим в крейт add_one тест для функции
add_one::add_one:
Файл: add_one/src/lib.rs
pub fn add_one(x: i32) -> i32 {
x + 1
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_works() {
assert_eq!(3, add_one(2));
}
}Теперь запустим cargo test в папке add верхнего уровня. В рабочем
пространстве такой структуры cargo test запускает тесты всех его крейтов:
$ cargo test
Compiling add_one v0.1.0 (file:///projects/add/add_one)
Compiling adder v0.1.0 (file:///projects/add/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.20s
Running unittests src/lib.rs (target/debug/deps/add_one-93c49ee75dc46543)
running 1 test
test tests::it_works ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running unittests src/main.rs (target/debug/deps/adder-3a47283c568d2b6a)
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests add_one
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Первый раздел вывода показывает, что тест it_works в крейте add_one
прошёл. Следующий — что в крейте adder тестов не нашлось. А последний — что
в крейте add_one нет документационных тестов.
Тесты отдельного крейта рабочего пространства тоже можно запустить из папки
верхнего уровня: укажите флаг -p и имя крейта, который нужно протестировать:
$ cargo test -p add_one
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.00s
Running unittests src/lib.rs (target/debug/deps/add_one-93c49ee75dc46543)
running 1 test
test tests::it_works ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests add_one
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Видно, что cargo test запустил только тесты крейта add_one, а тесты крейта
adder — нет.
Если публиковать крейты рабочего пространства на
crates.io, каждый придётся публиковать
отдельно. Как и с cargo test, конкретный крейт рабочего пространства можно
опубликовать, указав флаг -p и имя крейта.
Для дополнительной практики добавьте в это рабочее пространство крейт
add_two — так же, как add_one!
Когда проект разрастается, подумайте о рабочем пространстве: с ним можно работать с небольшими, понятными компонентами вместо одного большого куска кода. К тому же, если крейты часто меняются одновременно, держать их в одном рабочем пространстве удобнее для согласования изменений.
Установка бинарников через cargo install
Установка бинарников через cargo install
Команда cargo install позволяет установить бинарные крейты локально и
пользоваться ими. Она не призвана заменить системные пакеты — это просто
удобный способ для разработчиков на Rust устанавливать инструменты, которыми
другие поделились на crates.io. Учтите,
что установить можно только пакеты с бинарными целями сборки. Бинарная цель
(binary target) — это исполняемая программа, которая получается, если в
крейте есть файл src/main.rs или другой файл, указанный как бинарный. В
отличие от неё, библиотечная цель сама по себе не запускается, а
предназначена для включения в другие программы. Обычно в README крейта
написано, библиотека ли это, есть ли у него бинарная цель или и то и другое.
Все бинарники, установленные через cargo install, хранятся в папке bin
корня установки. Если вы ставили Rust через rustup.rs и ничего особо не
настраивали, это папка $HOME/.cargo/bin. Убедитесь, что она есть в вашем
$PATH, чтобы запускать программы, установленные через cargo install.
Например, в главе 12 мы упоминали, что есть реализация утилиты поиска по
файлам grep на Rust — ripgrep. Чтобы установить ripgrep, выполните:
$ cargo install ripgrep
Updating crates.io index
Downloaded ripgrep v14.1.1
Downloaded 1 crate (213.6 KB) in 0.40s
Installing ripgrep v14.1.1
--snip--
Compiling grep v0.3.2
Finished `release` profile [optimized + debuginfo] target(s) in 6.73s
Installing ~/.cargo/bin/rg
Installed package `ripgrep v14.1.1` (executable `rg`)
Предпоследняя строка вывода показывает, где лежит установленный бинарник и как
он называется — у ripgrep это rg. Если папка установки есть в $PATH, как
говорилось выше, можно запустить rg --help и начать пользоваться быстрым
инструментом поиска по файлам, который написан на Rust!
Свои команды для Cargo
Свои команды для Cargo
Cargo устроен так, что его можно расширять новыми подкомандами, не меняя сам
Cargo. Если в вашем $PATH есть бинарник с именем cargo-something, его
можно запускать как подкоманду Cargo: cargo something. Такие собственные
команды показываются и в выводе cargo --list. Возможность установить
расширения через cargo install и запускать их так же, как встроенные
инструменты Cargo, — очень удобное следствие его архитектуры!
Итоги
Обмен кодом через Cargo и crates.io — одна из причин, по которым экосистема Rust полезна для самых разных задач. Стандартная библиотека Rust небольшая и стабильная, а крейтами легко делиться, пользоваться и улучшать их в собственном темпе, независимо от выпусков языка. Не стесняйтесь публиковать на crates.io код, который полезен вам, — скорее всего, он пригодится и кому-то ещё!
Умные указатели
Указатель — общее название переменной, которая хранит адрес в памяти. Этот
адрес ссылается, или «указывает», на какие-то другие данные. Самый
распространённый вид указателя в Rust — ссылка, с которой вы познакомились в
главе 4. Ссылки обозначаются символом & и заимствуют значение, на которое
указывают. Никаких особых возможностей, кроме обращения к данным, у них нет,
зато нет и накладных расходов.
Умные указатели (smart pointers) — это структуры данных, которые ведут себя как указатель, но вдобавок хранят метаданные и обладают дополнительными возможностями. Умные указатели придуманы не в Rust: они появились в C++ и есть в других языках. В стандартной библиотеке Rust определено несколько умных указателей, которые умеют больше, чем ссылки. Чтобы разобраться в общей идее, рассмотрим несколько примеров умных указателей, в том числе тип с подсчётом ссылок (reference counting). Такой указатель позволяет данным иметь нескольких владельцев: он следит за количеством владельцев и, когда их не остаётся, освобождает данные.
Поскольку в Rust есть владение и заимствование, между ссылками и умными указателями есть ещё одно различие: ссылки только заимствуют данные, а умные указатели во многих случаях владеют данными, на которые указывают.
Умные указатели обычно реализуют в виде структур. Но, в отличие от обычной
структуры, умные указатели реализуют трейты Deref и Drop. Трейт Deref
позволяет экземпляру умного указателя вести себя как ссылка, так что код можно
писать так, чтобы он работал и со ссылками, и с умными указателями. Трейт
Drop позволяет задать код, который выполняется, когда экземпляр умного
указателя выходит из области видимости. В этой главе мы разберём оба трейта и
покажем, почему они так важны для умных указателей.
Умный указатель — общий шаблон проектирования, который часто встречается в Rust, поэтому мы не будем разбирать все существующие умные указатели. У многих библиотек есть собственные, и вы даже можете написать свой. Мы рассмотрим самые распространённые умные указатели стандартной библиотеки:
Box<T>— для размещения значений в куче;Rc<T>— тип с подсчётом ссылок, позволяющий иметь нескольких владельцев;RefCell<T>— тип, который проверяет правила заимствования не при компиляции, а во время выполнения; доступ к значению внутри него даютRef<T>иRefMut<T>.
Кроме того, мы разберём шаблон внутренней изменяемости (interior mutability), когда неизменяемый тип предоставляет API для изменения внутреннего значения. А ещё обсудим циклы ссылок: как они приводят к утечкам памяти и как их избежать.
Начнём!
Box<T>: данные в куче
Box<T>: данные в куче
Самый простой умный указатель — «коробка» (box), её тип записывается как
Box<T>. Коробки позволяют хранить данные не на стеке, а в куче. На стеке
остаётся лишь указатель на данные в куче. Чем стек отличается от кучи, можно
освежить в памяти по главе 4.
Накладных расходов на производительность у коробок нет, если не считать того, что данные хранятся в куче, а не на стеке. Но и особых дополнительных возможностей у них тоже нет. Чаще всего коробки нужны в таких ситуациях:
- когда размер типа неизвестен при компиляции, а значение этого типа нужно использовать там, где требуется точный размер;
- когда данных много и нужно передать владение ими, гарантировав, что при этом данные не будут копироваться;
- когда нужно владеть значением и важно лишь то, что его тип реализует определённый трейт, а не то, какой это конкретно тип.
Первую ситуацию мы разберём в разделе «Рекурсивные типы с помощью коробок». Во втором случае передача владения большим объёмом данных может занимать много времени, ведь данные копируются по стеку. Чтобы ускорить это, большой объём данных можно положить в коробку в куче. Тогда по стеку копируется лишь маленький указатель, а данные, на которые он указывает, остаются на одном месте в куче. Третий случай называется трейт-объектом (trait object); ему посвящён раздел «Трейт-объекты: абстракция над общим поведением» главы 18. Так что то, что вы узнаете здесь, пригодится вам снова и там!
Хранение данных в куче
Прежде чем обсуждать, когда Box<T> нужна для хранения данных в куче,
разберём синтаксис и то, как работать со значениями внутри Box<T>.
В листинге 15-1 показано, как с помощью коробки хранить значение i32 в куче.
fn main() {
let b = Box::new(5);
println!("b = {b}");
}i32 в куче с помощью коробкиМы определяем переменную b со значением Box, которая указывает на значение
5, размещённое в куче. Программа выведет b = 5: к данным в коробке здесь
можно обращаться почти так же, как если бы они лежали на стеке. Как и любое
значение-владелец, коробка освобождается, когда выходит из области видимости
(как b в конце main). Освобождается и сама коробка (она на стеке), и данные,
на которые она указывает (они в куче).
Класть в кучу одно-единственное значение не очень полезно, так что сами по
себе коробки в таком виде вы будете использовать редко. В большинстве случаев
значения вроде одного i32 уместнее хранить на стеке, где они и хранятся по
умолчанию. Давайте посмотрим на случай, когда коробки позволяют определить
типы, которые без них определить было бы нельзя.
Рекурсивные типы с помощью коробок
Значение рекурсивного типа может содержать внутри себя другое значение того же типа. С рекурсивными типами есть проблема: Rust должен знать при компиляции, сколько места занимает тип. А вложенность значений рекурсивного типа теоретически может продолжаться бесконечно, так что Rust не может знать, сколько места нужно значению. А размер коробки известен, поэтому если вставить коробку в определение рекурсивного типа, такой тип становится возможным.
В качестве примера рекурсивного типа рассмотрим cons-список. Это тип данных, часто встречающийся в функциональных языках программирования. Тип cons-списка, который мы определим, простой, если не считать рекурсии, так что понятия из этого примера пригодятся вам всякий раз, когда вы столкнётесь с более сложными ситуациями с рекурсивными типами.
Что такое cons-список
Cons-список (cons list) — структура данных, пришедшая из языка
программирования Lisp и его диалектов. Он состоит из вложенных пар и
представляет собой лисповскую версию связного списка. Название идёт от функции
cons в Lisp (сокращение от construct function — «функция-конструктор»),
которая создаёт новую пару из двух своих аргументов. Вызывая cons для пары
из значения и другой пары, можно строить cons-списки из рекурсивно вложенных
пар.
Вот, например, cons-список со списком 1, 2, 3 в псевдокоде — каждая пара в
скобках:
(1, (2, (3, Nil)))
Каждый элемент cons-списка содержит две части: значение текущего элемента и
следующий элемент. Последний элемент списка содержит только значение Nil и
не имеет следующего. Cons-список получается рекурсивными вызовами функции
cons. Каноническое название базового случая рекурсии — Nil. Учтите, что это
не то же самое, что «null» или «nil» из главы 6, то есть недопустимое или
отсутствующее значение.
В Rust cons-список используется нечасто. Когда в Rust нужен список элементов,
обычно лучше подходит Vec<T>. Другие, более сложные рекурсивные типы данных
действительно бывают полезны в разных ситуациях, но, начав в этой главе с
cons-списка, мы сможем разобраться, как коробки позволяют определить
рекурсивный тип данных, не отвлекаясь на лишнее.
В листинге 15-2 — определение перечисления для cons-списка. Учтите, что этот
код пока не скомпилируется: размер типа List неизвестен, и сейчас мы это
покажем.
enum List {
Cons(i32, List),
Nil,
}
fn main() {}i32Примечание: для этого примера мы реализуем cons-список только для значений
i32. Можно было бы реализовать его с обобщениями, как в главе 10, и
получить тип cons-списка для значений любого типа.
Список 1, 2, 3 в типе List выглядел бы как в листинге 15-3.
enum List {
Cons(i32, List),
Nil,
}
// --пропуск--
use crate::List::{Cons, Nil};
fn main() {
let list = Cons(1, Cons(2, Cons(3, Nil)));
}1, 2, 3 с помощью перечисления ListПервое значение Cons хранит 1 и ещё одно значение List. Это значение
List — ещё один Cons, который хранит 2 и ещё один List. А тот — ещё
один Cons с 3 и значением List, которое наконец-то равно Nil —
нерекурсивному варианту, обозначающему конец списка.
Если попытаться скомпилировать код из листинга 15-3, получим ошибку из листинга 15-4.
$ cargo run
Compiling cons-list v0.1.0 (file:///projects/cons-list)
error[E0072]: recursive type `List` has infinite size
--> src/main.rs:1:1
|
1 | enum List {
| ^^^^^^^^^
2 | Cons(i32, List),
| ---- recursive without indirection
|
help: insert some indirection (e.g., a `Box`, `Rc`, or `&`) to break the cycle
|
2 | Cons(i32, Box<List>),
| ++++ +
For more information about this error, try `rustc --explain E0072`.
error: could not compile `cons-list` (bin "cons-list") due to 1 previous error
Ошибка говорит, что у этого типа «бесконечный размер» (has infinite size).
Причина в том, что мы определили List с рекурсивным вариантом: он напрямую
содержит ещё одно значение того же типа. Из-за этого Rust не может понять,
сколько места нужно для хранения значения List. Разберёмся, почему так.
Сначала посмотрим, как Rust определяет, сколько места нужно для значения
нерекурсивного типа.
Размер нерекурсивного типа
Вспомните перечисление Message, которое мы определили в листинге 6-2, когда
обсуждали перечисления в главе 6:
enum Message {
Quit,
Move { x: i32, y: i32 },
Write(String),
ChangeColor(i32, i32, i32),
}
fn main() {}Чтобы определить, сколько места выделить под значение Message, Rust
перебирает все варианты и смотрит, какому нужно больше всего места. Rust видит,
что Message::Quit места не нужно вовсе, Message::Move — столько, чтобы
поместились два значения i32, и так далее. Использоваться будет только один
вариант, так что значению Message нужно не больше места, чем занимает самый
большой из его вариантов.
А теперь посмотрим, что происходит, когда Rust пытается определить, сколько
места нужно рекурсивному типу вроде перечисления List из листинга 15-2.
Компилятор начинает с варианта Cons, который хранит значение типа i32 и
значение типа List. Значит, Cons нужно столько места, сколько занимает
i32 плюс сколько занимает List. Чтобы узнать, сколько памяти нужно типу
List, компилятор смотрит на варианты, начиная с Cons. Вариант Cons
хранит значение типа i32 и значение типа List — и так до бесконечности, как
показано на рисунке 15-1.
Рисунок 15-1: Бесконечный List из бесконечного числа
вариантов Cons
Рекурсивный тип известного размера
Раз Rust не может понять, сколько места выделить под рекурсивно определённый тип, компилятор выдаёт ошибку с полезной подсказкой:
help: insert some indirection (e.g., a `Box`, `Rc`, or `&`) to break the cycle
|
2 | Cons(i32, Box<List>),
| ++++ +
Косвенность (indirection) в этой подсказке означает, что значение нужно хранить не напрямую, а косвенно — изменить структуру данных так, чтобы она хранила указатель на значение.
Box<T> — указатель, поэтому Rust всегда знает, сколько места нужно Box<T>:
размер указателя не зависит от объёма данных, на которые он указывает. Значит,
в вариант Cons можно положить не само значение List, а Box<T>. Box<T>
будет указывать на следующее значение List, которое будет лежать в куче, а не
внутри варианта Cons. По сути, у нас по-прежнему список, составленный из
списков, содержащих другие списки, но теперь элементы лежат не друг внутри
друга, а скорее друг за другом.
Изменим определение перечисления List из листинга 15-2 и его использование
из листинга 15-3 на код из листинга 15-5 — и он скомпилируется.
enum List {
Cons(i32, Box<List>),
Nil,
}
use crate::List::{Cons, Nil};
fn main() {
let list = Cons(1, Box::new(Cons(2, Box::new(Cons(3, Box::new(Nil))))));
}List с Box<T>, чтобы размер был известенВарианту Cons нужно столько места, сколько занимает i32, плюс место под
указатель коробки. Вариант Nil не хранит значений, поэтому на стеке ему
нужно меньше места, чем Cons. Теперь мы знаем, что любое значение List
займёт размер i32 плюс размер указателя коробки. С помощью коробки мы
разорвали бесконечную рекурсивную цепочку, и компилятор может определить,
сколько места нужно для хранения значения List. Как теперь выглядит вариант
Cons, показано на рисунке 15-2.
Рисунок 15-2: List конечного размера — потому что
Cons хранит Box
Коробки дают только косвенность и размещение в куче; других особых возможностей, вроде тех, что мы увидим у других умных указателей, у них нет. Зато нет и накладных расходов, которые эти возможности влекут, поэтому коробки полезны в случаях вроде cons-списка, где косвенность — единственное, что нам нужно. Другие применения коробок мы рассмотрим в главе 18.
Тип Box<T> — умный указатель, потому что реализует трейт Deref, благодаря
которому со значениями Box<T> можно обращаться как со ссылками. А когда
значение Box<T> выходит из области видимости, данные в куче, на которые
указывает коробка, тоже освобождаются — благодаря реализации трейта Drop. Эти
два трейта ещё важнее для функциональности других умных указателей, о
которых пойдёт речь в остальной части главы. Разберём их подробнее.
Умные указатели как обычные ссылки
Умные указатели как обычные ссылки
Реализация трейта Deref позволяет настроить поведение оператора
разыменования * (не путать с умножением и с оператором * в use). Если
реализовать Deref так, чтобы с умным указателем можно было обращаться как с
обычной ссылкой, то код, написанный для ссылок, будет работать и с умными
указателями.
Сначала посмотрим, как оператор разыменования работает с обычными ссылками.
Затем попробуем определить собственный тип, похожий на Box<T>, и увидим,
почему с ним оператор разыменования не работает так, как со ссылкой.
Разберёмся, как реализация трейта Deref позволяет умным указателям вести себя
похоже на ссылки. А потом посмотрим на неявное разыменование (deref
coercion) в Rust — и на то, как оно позволяет одинаково работать и со
ссылками, и с умными указателями.
Переход по ссылке к значению
Обычная ссылка — разновидность указателя, а указатель можно представлять как
стрелку, направленную на значение, которое хранится где-то ещё. В листинге
15-6 мы создаём ссылку на значение i32 и с помощью оператора разыменования
переходим по ссылке к значению.
fn main() {
let x = 5;
let y = &x;
assert_eq!(5, x);
assert_eq!(5, *y);
}i32 с помощью оператора разыменованияПеременная x хранит значение 5 типа i32. В y мы кладём ссылку на x.
Можно проверить, что x равно 5. Но чтобы проверить значение в y, нужно
написать *y — перейти по ссылке к значению, на которое она указывает
(отсюда и разыменование), чтобы компилятор сравнил само значение.
Разыменовав y, мы получаем доступ к целому числу, на которое указывает y, и
можем сравнить его с 5.
Если бы мы написали assert_eq!(5, y);, получили бы ошибку компиляции:
$ cargo run
Compiling deref-example v0.1.0 (file:///projects/deref-example)
error[E0277]: can't compare `{integer}` with `&{integer}`
--> src/main.rs:6:5
|
6 | assert_eq!(5, y);
| ^^^^^^^^^^^^^^^^ no implementation for `{integer} == &{integer}`
|
= help: the trait `PartialEq<&{integer}>` is not implemented for `{integer}`
= help: the following other types implement trait `PartialEq<Rhs>`:
f128
f16
f32
f64
i128
i16
i32
i64
and 8 others
For more information about this error, try `rustc --explain E0277`.
error: could not compile `deref-example` (bin "deref-example") due to 1 previous error
Сравнивать число со ссылкой на число нельзя — это разные типы. Нужно с помощью оператора разыменования перейти по ссылке к значению.
Box<T> как ссылка
Код из листинга 15-6 можно переписать, используя вместо ссылки Box<T>. В
листинге 15-7 оператор разыменования, применённый к Box<T>, работает так же,
как оператор разыменования для ссылки в листинге 15-6.
fn main() {
let x = 5;
let y = Box::new(x);
assert_eq!(5, x);
assert_eq!(5, *y);
}Box<i32>Главное отличие листинга 15-7 от листинга 15-6 в том, что y здесь —
экземпляр коробки, указывающей на копию значения x, а не ссылка на значение
x. В последней проверке оператором разыменования можно перейти по указателю
коробки так же, как когда y была ссылкой. Дальше мы определим собственный
тип коробки и разберёмся, что именно позволяет применять к Box<T> оператор
разыменования.
Собственный умный указатель
Сделаем тип-обёртку, похожий на Box<T> из стандартной библиотеки, и на
практике увидим, чем умные указатели по умолчанию отличаются от ссылок. А
потом посмотрим, как добавить возможность пользоваться оператором
разыменования.
Примечание: между типом MyBox<T>, который мы сейчас напишем, и настоящим
Box<T> есть одно большое различие: наша версия не хранит данные в куче.
Этот пример посвящён Deref, поэтому то, где на самом деле лежат данные,
менее важно, чем поведение, похожее на указатель.
В конечном счёте Box<T> определён как кортежная структура с одним
элементом, поэтому и MyBox<T> в листинге 15-8 определён так же. Ещё мы
определим функцию new — по образцу функции new у Box<T>.
struct MyBox<T>(T);
impl<T> MyBox<T> {
fn new(x: T) -> MyBox<T> {
MyBox(x)
}
}
fn main() {}MyBox<T>Мы определяем структуру MyBox и объявляем обобщённый параметр T, потому
что хотим, чтобы наш тип мог хранить значения любого типа. MyBox — кортежная
структура с одним элементом типа T. Функция MyBox::new принимает один
параметр типа T и возвращает экземпляр MyBox с переданным значением.
Попробуем добавить в листинг 15-8 функцию main из листинга 15-7, заменив
Box<T> на наш тип MyBox<T>. Код из листинга 15-9 не скомпилируется: Rust
не знает, как разыменовать MyBox.
struct MyBox<T>(T);
impl<T> MyBox<T> {
fn new(x: T) -> MyBox<T> {
MyBox(x)
}
}
fn main() {
let x = 5;
let y = MyBox::new(x);
assert_eq!(5, x);
assert_eq!(5, *y);
}MyBox<T> так же, как ссылки и Box<T>Вот получившаяся ошибка компиляции:
$ cargo run
Compiling deref-example v0.1.0 (file:///projects/deref-example)
error[E0614]: type `MyBox<{integer}>` cannot be dereferenced
--> src/main.rs:14:19
|
14 | assert_eq!(5, *y);
| ^^ can't be dereferenced
For more information about this error, try `rustc --explain E0614`.
error: could not compile `deref-example` (bin "deref-example") due to 1 previous error
Наш тип MyBox<T> нельзя разыменовать: мы не реализовали для него такую
возможность. Чтобы разыменование оператором * заработало, нужно реализовать
трейт Deref.
Реализация трейта Deref
Как говорилось в разделе «Реализация трейта для типа» главы 10, чтобы реализовать трейт, нужно реализовать его обязательные
методы. Трейт Deref из стандартной библиотеки требует реализовать один
метод — deref, который заимствует self и возвращает ссылку на внутренние
данные. В листинге 15-10 — реализация Deref, которую нужно добавить к
определению MyBox<T>.
use std::ops::Deref;
impl<T> Deref for MyBox<T> {
type Target = T;
fn deref(&self) -> &Self::Target {
&self.0
}
}
struct MyBox<T>(T);
impl<T> MyBox<T> {
fn new(x: T) -> MyBox<T> {
MyBox(x)
}
}
fn main() {
let x = 5;
let y = MyBox::new(x);
assert_eq!(5, x);
assert_eq!(5, *y);
}Deref для MyBox<T>Запись type Target = T; определяет ассоциированный тип, который использует
трейт Deref. Ассоциированные типы — немного другой способ объявить
обобщённый параметр; пока не беспокойтесь о них, подробнее мы разберём их в
главе 20.
В тело метода deref мы пишем &self.0, чтобы deref возвращал ссылку на то
значение, к которому мы хотим обращаться оператором *. Напомним из раздела
«Кортежные структуры: разные типы из похожих кортежей» главы 5, что .0 — обращение к первому значению кортежной
структуры. Теперь функция main из листинга 15-9, которая применяет * к
значению MyBox<T>, компилируется, и проверки проходят!
Без трейта Deref компилятор умеет разыменовывать только ссылки &. Метод
deref позволяет компилятору взять значение любого типа, реализующего
Deref, и вызвать у него deref, чтобы получить обычную ссылку & — а её
компилятор разыменовывать уже умеет.
Когда мы написали *y в листинге 15-9, за кулисами Rust на самом деле
выполнил такой код:
*(y.deref())Rust заменяет оператор * вызовом метода deref и обычным разыменованием,
так что нам не нужно задумываться, вызывать deref или нет. Благодаря этому
можно писать код, который работает одинаково, будь у нас обычная ссылка или
тип, реализующий Deref.
Почему метод deref возвращает ссылку на значение и почему обычное
разыменование снаружи скобок в *(y.deref()) всё равно нужно? Дело в системе
владения. Если бы deref возвращал само значение, а не ссылку на него,
значение переместилось бы из self. А забирать владение внутренним значением
MyBox<T> ни здесь, ни в большинстве других случаев использования оператора
разыменования мы не хотим.
Учтите, что каждый * в нашем коде заменяется вызовом deref и
разыменованием * ровно один раз. Подстановка не повторяется бесконечно,
поэтому в итоге мы получаем данные типа i32, которые совпадают с 5 в
assert_eq! из листинга 15-9.
Неявное разыменование в функциях и методах
Неявное разыменование (deref coercion) превращает ссылку на тип,
реализующий трейт Deref, в ссылку на другой тип. Например, оно может
превратить &String в &str, потому что String реализует трейт Deref так,
что тот возвращает &str. Это удобство, которое Rust применяет к аргументам
функций и методов, и работает оно только с типами, реализующими Deref.
Происходит оно автоматически, когда мы передаём в функцию или метод ссылку на
значение какого-то типа, а тип параметра в определении функции или метода
другой. Цепочка вызовов deref превращает переданный тип в тот, который нужен
параметру.
Неявное разыменование добавили в Rust для того, чтобы при вызове функций и
методов не приходилось писать столько явных & и *. Заодно оно позволяет
писать больше кода, работающего и со ссылками, и с умными указателями.
Чтобы увидеть неявное разыменование в действии, возьмём тип MyBox<T> из
листинга 15-8 и реализацию Deref из листинга 15-10. В листинге 15-11 —
определение функции с параметром — строковым срезом.
fn hello(name: &str) {
println!("Hello, {name}!");
}
fn main() {}hello с параметром name типа &strФункцию hello можно вызвать со строковым срезом в качестве аргумента,
например hello("Rust");. А благодаря неявному разыменованию её можно вызвать
и со ссылкой на значение типа MyBox<String>, как в листинге 15-12.
use std::ops::Deref;
impl<T> Deref for MyBox<T> {
type Target = T;
fn deref(&self) -> &T {
&self.0
}
}
struct MyBox<T>(T);
impl<T> MyBox<T> {
fn new(x: T) -> MyBox<T> {
MyBox(x)
}
}
fn hello(name: &str) {
println!("Hello, {name}!");
}
fn main() {
let m = MyBox::new(String::from("Rust"));
hello(&m);
}hello со ссылкой на значение MyBox<String> — это работает благодаря неявному разыменованиюЗдесь мы вызываем hello с аргументом &m — ссылкой на значение
MyBox<String>. Раз в листинге 15-10 мы реализовали трейт Deref для
MyBox<T>, Rust может превратить &MyBox<String> в &String, вызвав
deref. Стандартная библиотека реализует Deref для String так, что тот
возвращает строковый срез, — это указано в документации к API Deref. Rust
ещё раз вызывает deref и превращает &String в &str, что совпадает с
определением функции hello.
Если бы в Rust не было неявного разыменования, для вызова hello со значением
типа &MyBox<String> вместо кода из листинга 15-12 пришлось бы писать код из
листинга 15-13.
use std::ops::Deref;
impl<T> Deref for MyBox<T> {
type Target = T;
fn deref(&self) -> &T {
&self.0
}
}
struct MyBox<T>(T);
impl<T> MyBox<T> {
fn new(x: T) -> MyBox<T> {
MyBox(x)
}
}
fn hello(name: &str) {
println!("Hello, {name}!");
}
fn main() {
let m = MyBox::new(String::from("Rust"));
hello(&(*m)[..]);
}(*m) разыменовывает MyBox<String> в String. Затем & и [..] берут
строковый срез всей String, чтобы он соответствовал сигнатуре hello. Без
неявного разыменования код со всеми этими значками труднее читать, писать и
понимать. Неявное разыменование позволяет Rust делать эти преобразования за
нас.
Если для участвующих типов определён трейт Deref, Rust проанализирует типы
и вызовет Deref::deref столько раз, сколько нужно, чтобы получить ссылку
подходящего для параметра типа. Сколько раз вставить Deref::deref,
решается при компиляции, так что за неявное разыменование не приходится
платить во время выполнения!
Неявное разыменование и изменяемые ссылки
Как трейт Deref переопределяет оператор * для неизменяемых ссылок, так
трейт DerefMut переопределяет его для изменяемых.
Rust выполняет неявное разыменование, когда находит типы и реализации трейтов в трёх случаях:
- Из
&Tв&U, когдаT: Deref<Target=U>. - Из
&mut Tв&mut U, когдаT: DerefMut<Target=U>. - Из
&mut Tв&U, когдаT: Deref<Target=U>.
Первые два случая одинаковы, только второй — для изменяемых ссылок. Первый
говорит: если у вас есть &T, а T реализует Deref к какому-то типу U,
можно незаметно получить &U. Второй — что такое же неявное разыменование
происходит и с изменяемыми ссылками.
Третий случай хитрее: Rust приводит изменяемую ссылку к неизменяемой. А вот обратное невозможно: неизменяемая ссылка никогда не превратится в изменяемую. По правилам заимствования, если у вас есть изменяемая ссылка, она должна быть единственной ссылкой на эти данные (иначе программа не скомпилируется). Превращение одной изменяемой ссылки в одну неизменяемую правил заимствования не нарушит никогда. А чтобы превратить неизменяемую ссылку в изменяемую, исходная неизменяемая ссылка должна быть единственной ссылкой на эти данные, но правила заимствования этого не гарантируют. Поэтому Rust не может считать, что превратить неизменяемую ссылку в изменяемую возможно.
Код при очистке: трейт Drop
Код при очистке: трейт Drop
Второй трейт, важный для умных указателей, — Drop. Он позволяет задать, что
происходит, когда значение вот-вот выйдет из области видимости. Реализовать
трейт Drop можно для любого типа, а в его реализации — освобождать ресурсы
вроде файлов или сетевых соединений.
Мы рассказываем о Drop в контексте умных указателей потому, что его
функциональность почти всегда используется при реализации умного указателя.
Например, когда уничтожается Box<T>, он освобождает место в куче, на которое
указывает.
В некоторых языках для некоторых типов программист должен каждый раз, закончив работу с экземпляром, вызывать код, освобождающий память или ресурсы. Примеры — дескрипторы файлов, сокеты, блокировки. Если программист забудет, система может оказаться перегруженной и упасть. В Rust можно указать код, который будет выполняться всякий раз, когда значение выходит из области видимости, и компилятор вставит его автоматически. В итоге не нужно следить за тем, чтобы расставить код очистки везде, где программа заканчивает работу с экземпляром определённого типа, — ресурсы всё равно не утекут!
Код, который выполняется при выходе значения из области видимости, задаётся
реализацией трейта Drop. Трейт Drop требует реализовать один метод —
drop, который принимает изменяемую ссылку на self. Чтобы увидеть, когда Rust
вызывает drop, пока реализуем его с помощью println!.
В листинге 15-14 — структура CustomSmartPointer, вся особая
функциональность которой в том, что при выходе экземпляра из области видимости
она выводит Dropping CustomSmartPointer! — так видно, когда Rust вызывает
метод drop.
struct CustomSmartPointer {
data: String,
}
impl Drop for CustomSmartPointer {
fn drop(&mut self) {
println!("Dropping CustomSmartPointer with data `{}`!", self.data);
}
}
fn main() {
let c = CustomSmartPointer {
data: String::from("my stuff"),
};
let d = CustomSmartPointer {
data: String::from("other stuff"),
};
println!("CustomSmartPointers created");
}CustomSmartPointer, реализующая трейт Drop, — сюда мы поместили бы код очисткиТрейт Drop входит в прелюдию, так что подключать его не нужно. Мы реализуем
Drop для CustomSmartPointer, а в методе drop вызываем println!. В тело
метода drop помещают любую логику, которая должна выполняться, когда
экземпляр вашего типа выходит из области видимости. Здесь мы просто выводим
текст, чтобы наглядно показать, когда Rust вызывает drop.
В main мы создаём два экземпляра CustomSmartPointer и выводим
CustomSmartPointers created. В конце main наши экземпляры выйдут из
области видимости, и Rust выполнит код из метода drop, выведя финальное
сообщение. Заметьте, что вызывать drop явно нам не пришлось.
Запустив программу, увидим:
$ cargo run
Compiling drop-example v0.1.0 (file:///projects/drop-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.60s
Running `target/debug/drop-example`
CustomSmartPointers created
Dropping CustomSmartPointer with data `other stuff`!
Dropping CustomSmartPointer with data `my stuff`!
Когда экземпляры вышли из области видимости, Rust сам вызвал drop и выполнил
наш код. Переменные уничтожаются в порядке, обратном созданию, поэтому d был
уничтожен раньше c. Этот пример лишь наглядно показывает, как работает метод
drop; обычно в нём пишут код очистки, нужный вашему типу, а не вывод
сообщения.
К сожалению, отключить автоматический вызов drop не так просто. Обычно это и
не нужно: весь смысл трейта Drop в том, что о нём заботятся автоматически.
Но иногда значение хочется освободить пораньше. Например, когда умные
указатели управляют блокировками: может понадобиться принудительно вызвать
drop, который снимает блокировку, чтобы другой код в той же области
видимости мог её захватить. Вызывать метод drop трейта Drop вручную Rust не
позволяет. Если нужно принудительно уничтожить значение раньше конца его
области видимости, вызывайте функцию std::mem::drop из стандартной
библиотеки.
Если изменить функцию main из листинга 15-14 и попытаться вручную вызвать
метод drop трейта Drop, ничего не выйдет — см. листинг 15-15.
struct CustomSmartPointer {
data: String,
}
impl Drop for CustomSmartPointer {
fn drop(&mut self) {
println!("Dropping CustomSmartPointer with data `{}`!", self.data);
}
}
fn main() {
let c = CustomSmartPointer {
data: String::from("some data"),
};
println!("CustomSmartPointer created");
c.drop();
println!("CustomSmartPointer dropped before the end of main");
}drop трейта Drop, чтобы очистить значение досрочноПри компиляции получим ошибку:
$ cargo run
Compiling drop-example v0.1.0 (file:///projects/drop-example)
error[E0040]: explicit use of destructor method
--> src/main.rs:16:7
|
16 | c.drop();
| ^^^^ explicit destructor calls not allowed
|
help: consider using `drop` function
|
16 - c.drop();
16 + drop(c);
|
For more information about this error, try `rustc --explain E0040`.
error: could not compile `drop-example` (bin "drop-example") due to 1 previous error
Сообщение говорит, что вызывать drop явно нельзя. В нём используется термин
деструктор (destructor) — общепринятое в программировании название функции,
которая очищает экземпляр. Деструктор — пара к конструктору, который
экземпляр создаёт. Функция drop в Rust — один из видов деструктора.
Rust не даёт вызывать drop явно, потому что в конце main он всё равно
автоматически вызвал бы drop для этого значения. Получилась бы ошибка
двойного освобождения: Rust попытался бы очистить одно и то же значение
дважды.
Отключить автоматическую вставку drop при выходе значения из области
видимости нельзя, вызвать метод drop явно — тоже. Поэтому, если значение
нужно очистить досрочно, используют функцию std::mem::drop.
Функция std::mem::drop — это не метод drop трейта Drop. Её вызывают,
передавая аргументом значение, которое нужно принудительно уничтожить. Эта
функция есть в прелюдии, так что main из листинга 15-15 можно изменить так,
чтобы она вызывала функцию drop, как в листинге 15-16.
struct CustomSmartPointer {
data: String,
}
impl Drop for CustomSmartPointer {
fn drop(&mut self) {
println!("Dropping CustomSmartPointer with data `{}`!", self.data);
}
}
fn main() {
let c = CustomSmartPointer {
data: String::from("some data"),
};
println!("CustomSmartPointer created");
drop(c);
println!("CustomSmartPointer dropped before the end of main");
}std::mem::drop, чтобы явно уничтожить значение до выхода из области видимостиЭтот код выведет:
$ cargo run
Compiling drop-example v0.1.0 (file:///projects/drop-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.73s
Running `target/debug/drop-example`
CustomSmartPointer created
Dropping CustomSmartPointer with data `some data`!
CustomSmartPointer dropped before the end of main
Текст Dropping CustomSmartPointer with data `some data`! выводится между
CustomSmartPointer created и
CustomSmartPointer dropped before the end of main. Значит, c уничтожается
именно в этот момент — тогда и выполняется код метода drop.
Код из реализации трейта Drop можно использовать по-разному, чтобы очистка
была удобной и безопасной: например, на его основе можно написать собственный
распределитель памяти! С трейтом Drop и системой владения Rust помнить об
очистке не нужно — Rust делает это автоматически.
Не нужно беспокоиться и о проблемах из-за случайной очистки значений, которые
ещё используются: система владения, гарантирующая, что ссылки всегда
действительны, гарантирует и то, что drop будет вызван лишь один раз — когда
значение больше не используется.
Теперь, когда мы разобрали Box<T> и некоторые особенности умных указателей,
посмотрим на несколько других умных указателей из стандартной библиотеки.
Rc<T> — указатель с подсчётом ссылок
Rc<T> — указатель с подсчётом ссылок
В большинстве случаев с владением всё ясно: точно известно, какая переменная владеет тем или иным значением. Но бывает, что у одного значения может быть несколько владельцев. Например, в графах на один узел могут указывать несколько рёбер, и по смыслу этот узел принадлежит всем рёбрам, которые на него указывают. Узел нельзя удалять, пока на него указывает хоть одно ребро — то есть пока у него есть владельцы.
Множественное владение нужно включать явно — с помощью типа Rust Rc<T>
(сокращение от reference counting — подсчёт ссылок). Тип Rc<T> считает,
сколько ссылок указывает на значение, и по этому определяет, используется ли
ещё значение. Если ссылок на значение не осталось, его можно освободить, и ни
одна ссылка при этом не станет недействительной.
Представьте Rc<T> как телевизор в гостиной. Первый, кто приходит смотреть
телевизор, включает его. Другие могут прийти и тоже смотреть. А последний, кто
уходит из комнаты, выключает телевизор — им больше никто не пользуется. Если
кто-то выключит телевизор, пока остальные ещё смотрят, оставшиеся зрители
возмутятся!
Rc<T> используют, когда хотят разместить в куче данные, которые будут читать
несколько частей программы, и при компиляции невозможно определить, какая из
частей закончит работу с данными последней. Если бы мы знали, какая часть
закончит последней, можно было бы просто сделать её владельцем данных — и
действовали бы обычные правила владения, проверяемые при компиляции.
Учтите, что Rc<T> годится только для однопоточных сценариев. Когда в главе
16 мы будем обсуждать конкурентность, то разберём, как подсчитывать ссылки в
многопоточных программах.
Совместное использование данных
Вернёмся к примеру с cons-списком из листинга 15-5. Напомним, что мы
определили его с помощью Box<T>. На этот раз создадим два списка, которые
совместно владеют третьим. Схематично это выглядит как на рисунке 15-3.
Рисунок 15-3: Два списка, b и c, совместно владеют
третьим списком, a
Создадим список a с элементами 5 и 10. Затем — ещё два списка: b,
начинающийся с 3, и c, начинающийся с 4. И b, и c продолжаются первым
списком a с 5 и 10. Иначе говоря, оба списка совместно используют первый
список с 5 и 10.
С нашим определением List через Box<T> реализовать такое не получится, как
видно из листинга 15-17.
enum List {
Cons(i32, Box<List>),
Nil,
}
use crate::List::{Cons, Nil};
fn main() {
let a = Cons(5, Box::new(Cons(10, Box::new(Nil))));
let b = Cons(3, Box::new(a));
let c = Cons(4, Box::new(a));
}Box<T> не могут совместно владеть третьимПри компиляции получаем ошибку:
$ cargo run
Compiling cons-list v0.1.0 (file:///projects/cons-list)
error[E0382]: use of moved value: `a`
--> src/main.rs:11:30
|
9 | let a = Cons(5, Box::new(Cons(10, Box::new(Nil))));
| - move occurs because `a` has type `List`, which does not implement the `Copy` trait
10 | let b = Cons(3, Box::new(a));
| - value moved here
11 | let c = Cons(4, Box::new(a));
| ^ value used here after move
|
note: if `List` implemented `Clone`, you could clone the value
--> src/main.rs:1:1
|
1 | enum List {
| ^^^^^^^^^ consider implementing `Clone` for this type
...
10 | let b = Cons(3, Box::new(a));
| - you could clone this value
For more information about this error, try `rustc --explain E0382`.
error: could not compile `cons-list` (bin "cons-list") due to 1 previous error
Варианты Cons владеют своими данными, поэтому, когда мы создаём список b,
a перемещается в b, и b становится владельцем a. А когда при создании
c мы снова пытаемся использовать a, это запрещено: a уже перемещён.
Можно было бы изменить определение Cons так, чтобы он хранил ссылки, но
тогда пришлось бы указывать параметры времени жизни. А указав их, мы бы
заявили, что каждый элемент списка живёт как минимум столько же, сколько весь
список. Для элементов и списков из листинга 15-17 так и есть, но не во всех
сценариях.
Вместо этого изменим определение List, заменив Box<T> на Rc<T>, как в
листинге 15-18. Теперь каждый вариант Cons хранит значение и Rc<T>,
указывающий на List. При создании b мы не забираем владение a, а
клонируем Rc<List>, который хранит a. Так число ссылок увеличивается с
одной до двух, и a и b совместно владеют данными в этом Rc<List>. При
создании c мы тоже клонируем a, и число ссылок увеличивается с двух до
трёх. Каждый вызов Rc::clone увеличивает счётчик ссылок на данные внутри
Rc<List>, и данные не будут освобождены, пока ссылок на них не останется.
enum List {
Cons(i32, Rc<List>),
Nil,
}
use crate::List::{Cons, Nil};
use std::rc::Rc;
fn main() {
let a = Rc::new(Cons(5, Rc::new(Cons(10, Rc::new(Nil)))));
let b = Cons(3, Rc::clone(&a));
let c = Cons(4, Rc::clone(&a));
}List с использованием Rc<T>Rc<T> нет в прелюдии, поэтому его нужно подключить инструкцией use. В
main мы создаём список с 5 и 10 и сохраняем его в новом Rc<List> в a.
Затем при создании b и c вызываем функцию Rc::clone, передавая ей
аргументом ссылку на Rc<List> из a.
Можно было написать и a.clone() вместо Rc::clone(&a), но в Rust в таких
случаях принято использовать Rc::clone. Реализация Rc::clone не делает
глубокую копию всех данных, как большинство реализаций clone у других
типов. Вызов Rc::clone лишь увеличивает счётчик ссылок, а это быстро. А
глубокое копирование данных может занимать много времени. Используя
Rc::clone для подсчёта ссылок, мы визуально отличаем клонирование с глубоким
копированием от клонирования, которое лишь увеличивает счётчик. Когда ищешь в
коде проблемы с производительностью, достаточно смотреть на клонирование с
глубоким копированием, а вызовы Rc::clone можно не учитывать.
Клонирование увеличивает счётчик ссылок
Изменим наш рабочий пример из листинга 15-18, чтобы видеть, как меняется
счётчик ссылок, когда мы создаём и уничтожаем ссылки на Rc<List> из a.
В листинге 15-19 мы меняем main так, чтобы вокруг списка c была внутренняя
область видимости, — тогда видно, как меняется счётчик ссылок, когда c
выходит из области видимости.
enum List {
Cons(i32, Rc<List>),
Nil,
}
use crate::List::{Cons, Nil};
use std::rc::Rc;
// --пропуск--
fn main() {
let a = Rc::new(Cons(5, Rc::new(Cons(10, Rc::new(Nil)))));
println!("count after creating a = {}", Rc::strong_count(&a));
let b = Cons(3, Rc::clone(&a));
println!("count after creating b = {}", Rc::strong_count(&a));
{
let c = Cons(4, Rc::clone(&a));
println!("count after creating c = {}", Rc::strong_count(&a));
}
println!("count after c goes out of scope = {}", Rc::strong_count(&a));
}В каждой точке программы, где меняется счётчик ссылок, мы выводим его
значение, полученное функцией Rc::strong_count. Она называется
strong_count, а не count, потому что у типа Rc<T> есть ещё и
weak_count; для чего он нужен, мы увидим в разделе «Предотвращаем циклы
ссылок с помощью Weak<T>».
Этот код выводит:
$ cargo run
Compiling cons-list v0.1.0 (file:///projects/cons-list)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.45s
Running `target/debug/cons-list`
count after creating a = 1
count after creating b = 2
count after creating c = 3
count after c goes out of scope = 2
Видно, что у Rc<List> в a начальный счётчик ссылок равен 1, а каждый вызов
clone увеличивает его на 1. Когда c выходит из области видимости, счётчик
уменьшается на 1. Чтобы уменьшить счётчик, не нужно вызывать никакую функцию,
как приходится вызывать Rc::clone, чтобы его увеличить: реализация трейта
Drop автоматически уменьшает счётчик, когда значение Rc<T> выходит из
области видимости.
Чего в этом примере не видно: когда в конце main из области видимости
выходят b, а затем a, счётчик становится равен 0, и Rc<List> полностью
освобождается. Rc<T> позволяет одному значению иметь нескольких владельцев,
а счётчик гарантирует, что значение остаётся действительным, пока существует
хотя бы один из них.
С помощью неизменяемых ссылок Rc<T> позволяет разным частям программы
совместно пользоваться данными — но только для чтения. Если бы Rc<T>
позволял иметь и несколько изменяемых ссылок, можно было бы нарушить одно из
правил заимствования из главы 4: несколько изменяемых заимствований одного и
того же места могут привести к гонкам данных и несогласованности. Но менять
данные бывает очень полезно! В следующем разделе мы обсудим шаблон внутренней
изменяемости и тип RefCell<T>, который можно использовать вместе с Rc<T>,
чтобы обойти это ограничение неизменяемости.
RefCell<T> и внутренняя изменяемость
RefCell<T> и внутренняя изменяемость
Внутренняя изменяемость (interior mutability) — шаблон проектирования в
Rust, который позволяет менять данные, даже когда на них есть неизменяемые
ссылки; обычно правила заимствования такое запрещают. Чтобы менять данные, этот
шаблон использует внутри структуры данных небезопасный код (unsafe), который
обходит обычные правила Rust об изменении и заимствовании. Небезопасный код
сообщает компилятору, что правила мы проверяем сами, а не полагаемся на него;
подробнее о небезопасном коде мы поговорим в главе 20.
Типы с внутренней изменяемостью можно использовать, только когда мы можем
гарантировать, что правила заимствования будут соблюдены во время выполнения,
даже если компилятор этого гарантировать не может. Задействованный при этом
unsafe-код спрятан за безопасным API, а внешний тип по-прежнему
неизменяемый.
Разберёмся в этой идее на примере типа RefCell<T>, который реализует шаблон
внутренней изменяемости.
Проверка правил заимствования во время выполнения
В отличие от Rc<T>, у данных внутри RefCell<T> один владелец. Чем же тогда
RefCell<T> отличается от, скажем, Box<T>? Вспомните правила заимствования
из главы 4:
- В каждый момент времени может быть либо одна изменяемая ссылка, либо сколько угодно неизменяемых (но не то и другое сразу).
- Ссылки всегда должны быть действительными.
Для ссылок и Box<T> эти правила проверяются при компиляции. Для RefCell<T>
— во время выполнения. Если нарушить правила со ссылками, получится ошибка
компиляции. А если нарушить их с RefCell<T>, программа запаникует и
завершится.
У проверки правил заимствования при компиляции есть преимущества: ошибки обнаруживаются раньше, а на производительность во время работы это не влияет — весь анализ сделан заранее. Поэтому в большинстве случаев проверка при компиляции — лучший выбор, и в Rust она по умолчанию.
А преимущество проверки во время выполнения в том, что она допускает некоторые безопасные для памяти сценарии, которые проверка при компиляции отвергла бы. Статический анализ, который выполняет и компилятор Rust, по своей природе консервативен. Некоторые свойства кода невозможно установить, просто анализируя код. Самый известный пример — проблема остановки (Halting Problem): она выходит за рамки этой книги, но в ней интересно покопаться.
Раз некоторый анализ невозможен, компилятор Rust, если не уверен, что код
соблюдает правила владения, может отвергнуть и корректную программу — в этом
и состоит его консервативность. Если бы Rust пропускал некорректные
программы, пользователи не могли бы доверять его гарантиям. А если Rust
отвергнет корректную программу, программисту будет неудобно, но ничего
катастрофического не случится. Тип RefCell<T> полезен, когда вы уверены, что
код соблюдает правила заимствования, а компилятор не может этого понять и
гарантировать.
Как и Rc<T>, RefCell<T> годится только для однопоточных сценариев, и при
попытке использовать его в многопоточном контексте будет ошибка компиляции.
Как получить функциональность RefCell<T> в многопоточной программе, мы
поговорим в главе 16.
Подытожим, когда выбирать Box<T>, Rc<T> или RefCell<T>:
Rc<T>позволяет иметь нескольких владельцев одних и тех же данных; уBox<T>иRefCell<T>владелец один.Box<T>допускает неизменяемые и изменяемые заимствования, проверяемые при компиляции;Rc<T>— только неизменяемые, проверяемые при компиляции;RefCell<T>— неизменяемые и изменяемые, проверяемые во время выполнения.- Раз
RefCell<T>допускает изменяемые заимствования с проверкой во время выполнения, значение внутриRefCell<T>можно менять, даже если самRefCell<T>неизменяемый.
Изменение значения внутри неизменяемого значения — это и есть шаблон внутренней изменяемости. Посмотрим, в какой ситуации он полезен и как он вообще возможен.
Применение внутренней изменяемости
Из правил заимствования следует, что неизменяемое значение нельзя позаимствовать изменяемо. Например, этот код не скомпилируется:
fn main() {
let x = 5;
let y = &mut x;
}При компиляции получим ошибку:
$ cargo run
Compiling borrowing v0.1.0 (file:///projects/borrowing)
error[E0596]: cannot borrow `x` as mutable, as it is not declared as mutable
--> src/main.rs:3:13
|
3 | let y = &mut x;
| ^^^^^^ cannot borrow as mutable
|
help: consider changing this to be mutable
|
2 | let mut x = 5;
| +++
For more information about this error, try `rustc --explain E0596`.
error: could not compile `borrowing` (bin "borrowing") due to 1 previous error
Но бывают ситуации, когда полезно, чтобы значение могло менять себя в
собственных методах, но для остального кода выглядело неизменяемым. Код вне
методов значения изменить его не сможет. RefCell<T> — один из способов
получить такую внутреннюю изменяемость. Но правила заимствования RefCell<T>
не отменяет полностью: анализатор заимствований в компиляторе разрешает эту
внутреннюю изменяемость, а сами правила проверяются уже во время выполнения.
Нарушите их — получите panic!, а не ошибку компиляции.
Разберём практический пример, где с помощью RefCell<T> можно менять
неизменяемое значение, и посмотрим, чем это полезно.
Тестирование с мок-объектами
Иногда при тестировании программист подставляет вместо одного типа другой, чтобы понаблюдать за определённым поведением и проверить, что оно реализовано правильно. Такой тип-заменитель называется тестовым двойником (test double) — по аналогии с дублёром в кино, который подменяет актёра в особенно сложной сцене. Тестовые двойники подменяют другие типы во время тестов. Мок-объекты (mock objects) — особый вид тестовых двойников: они записывают, что происходило во время теста, чтобы потом можно было проверить, что выполнились нужные действия.
Объектов в том смысле, в каком они есть в других языках, в Rust нет, и встроенной в стандартную библиотеку поддержки мок-объектов, как в некоторых других языках, тоже нет. Но создать структуру, которая будет служить тем же целям, что мок-объект, вполне можно.
Вот сценарий, который мы будем тестировать. Сделаем библиотеку, которая следит за значением относительно максимума и отправляет сообщения в зависимости от того, насколько текущее значение близко к максимуму. Такую библиотеку можно использовать, например, чтобы отслеживать квоту пользователя на количество обращений к API.
Наша библиотека будет только следить за тем, насколько значение близко к
максимуму, и решать, какие сообщения и когда отправлять. А механизм отправки
сообщений должны предоставить приложения, которые её используют: приложение
может показать сообщение пользователю, отправить письмо, SMS или сделать
что-то ещё. Библиотеке эта деталь не важна. Ей нужно лишь что-нибудь,
реализующее трейт Messenger, который мы предоставим. Код библиотеки — в
листинге 15-20.
pub trait Messenger {
fn send(&self, msg: &str);
}
pub struct LimitTracker<'a, T: Messenger> {
messenger: &'a T,
value: usize,
max: usize,
}
impl<'a, T> LimitTracker<'a, T>
where
T: Messenger,
{
pub fn new(messenger: &'a T, max: usize) -> LimitTracker<'a, T> {
LimitTracker {
messenger,
value: 0,
max,
}
}
pub fn set_value(&mut self, value: usize) {
self.value = value;
let percentage_of_max = self.value as f64 / self.max as f64;
if percentage_of_max >= 1.0 {
self.messenger.send("Error: You are over your quota!");
} else if percentage_of_max >= 0.9 {
self.messenger
.send("Urgent warning: You've used up over 90% of your quota!");
} else if percentage_of_max >= 0.75 {
self.messenger
.send("Warning: You've used up over 75% of your quota!");
}
}
}Важная часть этого кода — у трейта Messenger есть метод send, который
принимает неизменяемую ссылку на self и текст сообщения. Это интерфейс,
который должен реализовать наш мок-объект, чтобы им можно было пользоваться
так же, как настоящим объектом. Другая важная часть — мы хотим протестировать
поведение метода set_value у LimitTracker. Мы можем менять то, что
передаём в параметр value, но set_value ничего не возвращает, и проверять
нечего. Мы хотим убедиться в следующем: если создать LimitTracker с чем-то,
что реализует трейт Messenger, и с определённым значением max, то при
передаче разных чисел в value LimitTracker поручает мессенджеру отправить
нужные сообщения.
Нам нужен мок-объект, который при вызове send не отправляет письмо или SMS, а
лишь запоминает сообщения, которые ему поручили отправить. Можно создать
новый экземпляр мок-объекта, создать LimitTracker, использующий этот
мок-объект, вызвать у LimitTracker метод set_value и проверить, что в
мок-объекте оказались ожидаемые сообщения. В листинге 15-21 — попытка
реализовать такой мок-объект, но анализатор заимствований её не пропустит.
pub trait Messenger {
fn send(&self, msg: &str);
}
pub struct LimitTracker<'a, T: Messenger> {
messenger: &'a T,
value: usize,
max: usize,
}
impl<'a, T> LimitTracker<'a, T>
where
T: Messenger,
{
pub fn new(messenger: &'a T, max: usize) -> LimitTracker<'a, T> {
LimitTracker {
messenger,
value: 0,
max,
}
}
pub fn set_value(&mut self, value: usize) {
self.value = value;
let percentage_of_max = self.value as f64 / self.max as f64;
if percentage_of_max >= 1.0 {
self.messenger.send("Error: You are over your quota!");
} else if percentage_of_max >= 0.9 {
self.messenger
.send("Urgent warning: You've used up over 90% of your quota!");
} else if percentage_of_max >= 0.75 {
self.messenger
.send("Warning: You've used up over 75% of your quota!");
}
}
}
#[cfg(test)]
mod tests {
use super::*;
struct MockMessenger {
sent_messages: Vec<String>,
}
impl MockMessenger {
fn new() -> MockMessenger {
MockMessenger {
sent_messages: vec![],
}
}
}
impl Messenger for MockMessenger {
fn send(&self, message: &str) {
self.sent_messages.push(String::from(message));
}
}
#[test]
fn it_sends_an_over_75_percent_warning_message() {
let mock_messenger = MockMessenger::new();
let mut limit_tracker = LimitTracker::new(&mock_messenger, 100);
limit_tracker.set_value(80);
assert_eq!(mock_messenger.sent_messages.len(), 1);
}
}MockMessenger, которую не пропускает анализатор заимствованийЭтот тестовый код определяет структуру MockMessenger с полем
sent_messages — вектором значений String, в котором запоминаются сообщения,
которые ей поручили отправить. Ещё мы определяем ассоциированную функцию
new, чтобы удобно создавать новые значения MockMessenger с пустым списком
сообщений. Затем реализуем для MockMessenger трейт Messenger, чтобы можно
было передать MockMessenger в LimitTracker. В методе send мы берём
переданное параметром сообщение и сохраняем его в списке sent_messages
структуры MockMessenger.
В тесте мы проверяем, что происходит, когда LimitTracker просят установить
value больше 75 процентов от max. Сначала создаём новый MockMessenger с
пустым списком сообщений. Затем создаём новый LimitTracker и передаём ему
ссылку на этот MockMessenger и значение max, равное 100. Вызываем у
LimitTracker метод set_value со значением 80 — это больше 75 процентов от
100. И проверяем, что в списке сообщений, который ведёт MockMessenger,
теперь одно сообщение.
Но с этим тестом есть одна проблема:
$ cargo test
Compiling limit-tracker v0.1.0 (file:///projects/limit-tracker)
error[E0596]: cannot borrow `self.sent_messages` as mutable, as it is behind a `&` reference
--> src/lib.rs:58:13
|
58 | self.sent_messages.push(String::from(message));
| ^^^^^^^^^^^^^^^^^^ `self` is a `&` reference, so it cannot be borrowed as mutable
|
help: consider changing this to be a mutable reference in the `impl` method and the `trait` definition
|
2 ~ fn send(&mut self, msg: &str);
3 | }
...
56 | impl Messenger for MockMessenger {
57 ~ fn send(&mut self, message: &str) {
|
For more information about this error, try `rustc --explain E0596`.
error: could not compile `limit-tracker` (lib test) due to 1 previous error
Изменить MockMessenger, чтобы запомнить сообщения, мы не можем: метод send
принимает неизменяемую ссылку на self. Последовать совету из сообщения об
ошибке и написать &mut self и в методе impl, и в определении трейта тоже
нельзя: менять трейт Messenger только ради тестов мы не хотим. Нужно найти
способ заставить тестовый код правильно работать с текущим дизайном.
Вот здесь-то и поможет внутренняя изменяемость! Будем хранить sent_messages
внутри RefCell<T> — тогда метод send сможет менять sent_messages и
запоминать сообщения. Как это выглядит, показано в листинге 15-22.
pub trait Messenger {
fn send(&self, msg: &str);
}
pub struct LimitTracker<'a, T: Messenger> {
messenger: &'a T,
value: usize,
max: usize,
}
impl<'a, T> LimitTracker<'a, T>
where
T: Messenger,
{
pub fn new(messenger: &'a T, max: usize) -> LimitTracker<'a, T> {
LimitTracker {
messenger,
value: 0,
max,
}
}
pub fn set_value(&mut self, value: usize) {
self.value = value;
let percentage_of_max = self.value as f64 / self.max as f64;
if percentage_of_max >= 1.0 {
self.messenger.send("Error: You are over your quota!");
} else if percentage_of_max >= 0.9 {
self.messenger
.send("Urgent warning: You've used up over 90% of your quota!");
} else if percentage_of_max >= 0.75 {
self.messenger
.send("Warning: You've used up over 75% of your quota!");
}
}
}
#[cfg(test)]
mod tests {
use super::*;
use std::cell::RefCell;
struct MockMessenger {
sent_messages: RefCell<Vec<String>>,
}
impl MockMessenger {
fn new() -> MockMessenger {
MockMessenger {
sent_messages: RefCell::new(vec![]),
}
}
}
impl Messenger for MockMessenger {
fn send(&self, message: &str) {
self.sent_messages.borrow_mut().push(String::from(message));
}
}
#[test]
fn it_sends_an_over_75_percent_warning_message() {
// --пропуск--
let mock_messenger = MockMessenger::new();
let mut limit_tracker = LimitTracker::new(&mock_messenger, 100);
limit_tracker.set_value(80);
assert_eq!(mock_messenger.sent_messages.borrow().len(), 1);
}
}RefCell<T> позволяет менять внутреннее значение, хотя внешнее считается неизменяемымТеперь поле sent_messages имеет тип RefCell<Vec<String>>, а не
Vec<String>. В функции new мы создаём новый экземпляр
RefCell<Vec<String>>, обёрнутый вокруг пустого вектора.
В реализации метода send первый параметр по-прежнему — неизменяемое
заимствование self, что соответствует определению трейта. У
RefCell<Vec<String>> в self.sent_messages мы вызываем borrow_mut и
получаем изменяемую ссылку на значение внутри RefCell<Vec<String>>, то есть
на вектор. Затем у изменяемой ссылки на вектор можно вызвать push и
запомнить сообщение, отправленное во время теста.
Последнее изменение — в проверке: чтобы узнать, сколько элементов во
внутреннем векторе, вызываем у RefCell<Vec<String>> метод borrow и
получаем неизменяемую ссылку на вектор.
Теперь, когда вы увидели, как пользоваться RefCell<T>, разберёмся, как он
устроен!
Учёт заимствований во время выполнения
Неизменяемые и изменяемые ссылки мы создаём с помощью & и &mut. А у
RefCell<T> для этого есть методы borrow и borrow_mut — часть его
безопасного API. Метод borrow возвращает умный указатель типа Ref<T>, а
borrow_mut — умный указатель типа RefMut<T>. Оба типа реализуют Deref,
так что с ними можно обращаться как с обычными ссылками.
RefCell<T> следит, сколько умных указателей Ref<T> и RefMut<T> сейчас
активно. При каждом вызове borrow RefCell<T> увеличивает счётчик активных
неизменяемых заимствований. Когда значение Ref<T> выходит из области
видимости, счётчик неизменяемых заимствований уменьшается на 1. Как и при
проверке правил заимствования при компиляции, RefCell<T> позволяет в каждый
момент иметь либо много неизменяемых заимствований, либо одно изменяемое.
Если попытаться нарушить эти правила, то, в отличие от ссылок, ошибки
компиляции не будет — реализация RefCell<T> запаникует во время выполнения. В
листинге 15-23 — изменённая реализация send из листинга 15-22. Мы нарочно
пытаемся создать два активных изменяемых заимствования в одной области
видимости, чтобы показать, что RefCell<T> не даст этого сделать во время
выполнения.
pub trait Messenger {
fn send(&self, msg: &str);
}
pub struct LimitTracker<'a, T: Messenger> {
messenger: &'a T,
value: usize,
max: usize,
}
impl<'a, T> LimitTracker<'a, T>
where
T: Messenger,
{
pub fn new(messenger: &'a T, max: usize) -> LimitTracker<'a, T> {
LimitTracker {
messenger,
value: 0,
max,
}
}
pub fn set_value(&mut self, value: usize) {
self.value = value;
let percentage_of_max = self.value as f64 / self.max as f64;
if percentage_of_max >= 1.0 {
self.messenger.send("Error: You are over your quota!");
} else if percentage_of_max >= 0.9 {
self.messenger
.send("Urgent warning: You've used up over 90% of your quota!");
} else if percentage_of_max >= 0.75 {
self.messenger
.send("Warning: You've used up over 75% of your quota!");
}
}
}
#[cfg(test)]
mod tests {
use super::*;
use std::cell::RefCell;
struct MockMessenger {
sent_messages: RefCell<Vec<String>>,
}
impl MockMessenger {
fn new() -> MockMessenger {
MockMessenger {
sent_messages: RefCell::new(vec![]),
}
}
}
impl Messenger for MockMessenger {
fn send(&self, message: &str) {
let mut one_borrow = self.sent_messages.borrow_mut();
let mut two_borrow = self.sent_messages.borrow_mut();
one_borrow.push(String::from(message));
two_borrow.push(String::from(message));
}
}
#[test]
fn it_sends_an_over_75_percent_warning_message() {
let mock_messenger = MockMessenger::new();
let mut limit_tracker = LimitTracker::new(&mock_messenger, 100);
limit_tracker.set_value(80);
assert_eq!(mock_messenger.sent_messages.borrow().len(), 1);
}
}RefCell<T> запаникуетМы создаём переменную one_borrow для умного указателя RefMut<T>, который
вернул borrow_mut. Затем точно так же создаём второе изменяемое
заимствование в переменной two_borrow. Получаются две изменяемые ссылки в
одной области видимости, а так нельзя. Код из листинга 15-23 скомпилируется без
ошибок, но при запуске тестов библиотеки тест провалится:
$ cargo test
Compiling limit-tracker v0.1.0 (file:///projects/limit-tracker)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.91s
Running unittests src/lib.rs (target/debug/deps/limit_tracker-e599811fa246dbde)
running 1 test
test tests::it_sends_an_over_75_percent_warning_message ... FAILED
failures:
---- tests::it_sends_an_over_75_percent_warning_message stdout ----
thread 'tests::it_sends_an_over_75_percent_warning_message' (6028024) panicked at src/lib.rs:60:53:
RefCell already borrowed
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::it_sends_an_over_75_percent_warning_message
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
Заметьте, что код запаниковал с сообщением
already borrowed: BorrowMutError («уже заимствовано»). Так RefCell<T>
обрабатывает нарушения правил заимствования во время выполнения.
Если ловить ошибки заимствования не при компиляции, а во время выполнения, как
здесь, ошибки в коде могут обнаружиться позже — возможно, только когда код уже
окажется в продакшене. Кроме того, учёт заимствований во время выполнения
немного снижает производительность. Зато RefCell<T> позволяет написать
мок-объект, который может менять себя, запоминая увиденные сообщения, даже в
контексте, где разрешены только неизменяемые значения. Несмотря на эти
компромиссы, RefCell<T> даёт больше возможностей, чем обычные ссылки.
Несколько владельцев изменяемых данных
RefCell<T> часто используют вместе с Rc<T>. Напомним, что Rc<T> позволяет
иметь нескольких владельцев данных, но даёт к ним только неизменяемый доступ.
Если же Rc<T> хранит RefCell<T>, получается значение, у которого может быть
несколько владельцев и которое можно менять!
Вспомните пример с cons-списком из листинга 15-18, где с помощью Rc<T>
несколько списков совместно владели другим списком. Rc<T> хранит только
неизменяемые значения, поэтому, создав значения списка, изменить их уже
нельзя. Добавим RefCell<T>, чтобы значения в списках можно было менять. В
листинге 15-24 видно, что, используя RefCell<T> в определении Cons, можно
изменить значение, хранящееся во всех списках.
#[derive(Debug)]
enum List {
Cons(Rc<RefCell<i32>>, Rc<List>),
Nil,
}
use crate::List::{Cons, Nil};
use std::cell::RefCell;
use std::rc::Rc;
fn main() {
let value = Rc::new(RefCell::new(5));
let a = Rc::new(Cons(Rc::clone(&value), Rc::new(Nil)));
let b = Cons(Rc::new(RefCell::new(3)), Rc::clone(&a));
let c = Cons(Rc::new(RefCell::new(4)), Rc::clone(&a));
*value.borrow_mut() += 10;
println!("a after = {a:?}");
println!("b after = {b:?}");
println!("c after = {c:?}");
}Rc<RefCell<i32>> позволяет создать List, который можно менятьМы создаём экземпляр Rc<RefCell<i32>> и сохраняем его в переменную value,
чтобы потом обращаться к нему напрямую. Затем создаём в a список List с
вариантом Cons, который хранит value. value нужно клонировать: тогда
внутренним значением 5 будут владеть и a, и value. Без клонирования
владение перешло бы от value к a (или a лишь заимствовал бы его у
value).
Список a мы оборачиваем в Rc<T>, чтобы созданные затем списки b и c
могли оба ссылаться на a, — как в листинге 15-18.
Создав списки a, b и c, мы хотим прибавить 10 к значению в value. Для
этого вызываем у value метод borrow_mut. Тут срабатывает автоматическое
разыменование, о котором мы говорили в разделе «А где же оператор
->?» главы 5: Rc<T> разыменовывается
до внутреннего значения RefCell<T>. Метод borrow_mut возвращает умный
указатель RefMut<T>, к которому мы применяем оператор разыменования и меняем
внутреннее значение.
Выведя a, b и c, мы увидим, что во всех теперь изменённое значение 15,
а не 5:
$ cargo run
Compiling cons-list v0.1.0 (file:///projects/cons-list)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.63s
Running `target/debug/cons-list`
a after = Cons(RefCell { value: 15 }, Nil)
b after = Cons(RefCell { value: 3 }, Cons(RefCell { value: 15 }, Nil))
c after = Cons(RefCell { value: 4 }, Cons(RefCell { value: 15 }, Nil))
Ловко, правда? Благодаря RefCell<T> у нас есть внешне неизменяемое значение
List. Но с помощью методов RefCell<T>, открывающих доступ к его внутренней
изменяемости, мы можем менять данные, когда нужно. Проверки правил
заимствования во время выполнения защищают нас от гонок данных, и иногда
стоит пожертвовать небольшой долей скорости ради такой гибкости структур
данных. Учтите, что RefCell<T> не работает в многопоточном коде!
Потокобезопасная версия RefCell<T> — это Mutex<T>; о нём мы поговорим в
главе 16.
Циклы ссылок и утечки памяти
Циклы ссылок и утечки памяти
Гарантии безопасности памяти в Rust затрудняют, но не исключают полностью
утечку памяти (memory leak) — ситуацию, когда память выделена и случайно
так никогда и не освобождается. Полностью предотвращать утечки Rust не
гарантирует — то есть утечка памяти в Rust считается безопасной для памяти.
Что Rust допускает утечки, видно на примере Rc<T> и RefCell<T>: с ними
можно создать ссылки, при которых элементы ссылаются друг на друга по кругу.
Это и приводит к утечке: счётчик ссылок каждого элемента в таком цикле никогда
не опустится до 0, и значения никогда не будут уничтожены.
Создание цикла ссылок
Посмотрим, как может возникнуть цикл ссылок и как его предотвратить. Начнём с
определения перечисления List и метода tail из листинга 15-25.
use crate::List::{Cons, Nil};
use std::cell::RefCell;
use std::rc::Rc;
#[derive(Debug)]
enum List {
Cons(i32, RefCell<Rc<List>>),
Nil,
}
impl List {
fn tail(&self) -> Option<&RefCell<Rc<List>>> {
match self {
Cons(_, item) => Some(item),
Nil => None,
}
}
}
fn main() {}RefCell<T>, позволяющим менять то, на что ссылается вариант ConsЭто ещё один вариант определения List из листинга 15-5. Второй элемент
варианта Cons теперь имеет тип RefCell<Rc<List>>. То есть менять мы хотим
не значение i32, как в листинге 15-24, а то значение List, на которое
указывает вариант Cons. Ещё мы добавили метод tail, чтобы удобно получать
второй элемент варианта Cons.
В листинге 15-26 мы добавляем функцию main, которая использует определения из
листинга 15-25. Этот код создаёт список в a и список в b, указывающий на
список в a. Затем он меняет список в a так, чтобы тот указывал на b, — и
получается цикл ссылок. По ходу дела вызовы println! показывают, какими
бывают счётчики ссылок в разные моменты.
use crate::List::{Cons, Nil};
use std::cell::RefCell;
use std::rc::Rc;
#[derive(Debug)]
enum List {
Cons(i32, RefCell<Rc<List>>),
Nil,
}
impl List {
fn tail(&self) -> Option<&RefCell<Rc<List>>> {
match self {
Cons(_, item) => Some(item),
Nil => None,
}
}
}
fn main() {
let a = Rc::new(Cons(5, RefCell::new(Rc::new(Nil))));
println!("a initial rc count = {}", Rc::strong_count(&a));
println!("a next item = {:?}", a.tail());
let b = Rc::new(Cons(10, RefCell::new(Rc::clone(&a))));
println!("a rc count after b creation = {}", Rc::strong_count(&a));
println!("b initial rc count = {}", Rc::strong_count(&b));
println!("b next item = {:?}", b.tail());
if let Some(link) = a.tail() {
*link.borrow_mut() = Rc::clone(&b);
}
println!("b rc count after changing a = {}", Rc::strong_count(&b));
println!("a rc count after changing a = {}", Rc::strong_count(&a));
// Раскомментируйте следующую строку, чтобы убедиться, что получился цикл;
// она переполнит стек.
// println!("a next item = {:?}", a.tail());
}List, указывающих друг на другаМы создаём в переменной a экземпляр Rc<List> со значением List —
начальным списком 5, Nil. Затем создаём в переменной b экземпляр Rc<List>
с другим значением List, которое содержит 10 и указывает на список в a.
Затем меняем a так, чтобы он указывал не на Nil, а на b, — так и
возникает цикл. Для этого методом tail получаем ссылку на
RefCell<Rc<List>> в a и кладём её в переменную link. Затем методом
borrow_mut у RefCell<Rc<List>> меняем внутреннее значение: вместо
Rc<List> со значением Nil теперь там Rc<List> из b.
Если запустить этот код, пока оставив последний println! закомментированным,
получим:
$ cargo run
Compiling cons-list v0.1.0 (file:///projects/cons-list)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.53s
Running `target/debug/cons-list`
a initial rc count = 1
a next item = Some(RefCell { value: Nil })
a rc count after b creation = 2
b initial rc count = 1
b next item = Some(RefCell { value: Cons(5, RefCell { value: Nil }) })
b rc count after changing a = 2
a rc count after changing a = 2
После того как список в a начал указывать на b, счётчики ссылок у
экземпляров Rc<List> и в a, и в b равны 2. В конце main Rust уничтожает
переменную b, и счётчик ссылок экземпляра Rc<List> из b уменьшается с 2
до 1. Память, которую этот Rc<List> занимает в куче, в этот момент не
освобождается: счётчик равен 1, а не 0. Затем Rust уничтожает a, и счётчик
экземпляра Rc<List> из a тоже уменьшается с 2 до 1. Его память тоже не
освободить: на него всё ещё ссылается другой экземпляр Rc<List>. Память,
выделенная под списки, так и останется неосвобождённой навсегда. Чтобы
наглядно показать этот цикл ссылок, мы нарисовали схему на рисунке 15-4.
Рисунок 15-4: Цикл ссылок из списков a и b,
указывающих друг на друга
Если раскомментировать последний println! и запустить программу, Rust
попытается вывести этот цикл: a указывает на b, который указывает на a, и
так далее, пока не переполнится стек.
По сравнению с настоящей программой последствия цикла ссылок в этом примере не так страшны: сразу после создания цикла программа завершается. Но если бы сложная программа выделила в цикле много памяти и долго её удерживала, она расходовала бы больше памяти, чем нужно, и могла бы перегрузить систему — вплоть до того, что память закончится.
Создать цикл ссылок непросто, но возможно. Если у вас есть значения
RefCell<T>, содержащие значения Rc<T>, или похожие вложенные сочетания типов
с внутренней изменяемостью и подсчётом ссылок, следите за тем, чтобы не
создавать циклов: рассчитывать, что их поймает Rust, нельзя. Цикл ссылок — это
логическая ошибка в программе, и бороться с ней нужно автоматическими
тестами, ревью кода и другими практиками разработки.
Другой способ избежать циклов ссылок — перестроить структуры данных так, чтобы
одни ссылки выражали владение, а другие — нет. Тогда циклы могут состоять из
отношений владения и отношений без владения, и на то, можно ли уничтожить
значение, влияют только отношения владения. В листинге 15-25 варианты Cons
всегда должны владеть своим списком, так что перестроить структуру данных не
получится. Рассмотрим пример с графами из родительских и дочерних узлов и
увидим, когда отношения без владения — подходящий способ избежать циклов
ссылок.
Предотвращаем циклы ссылок с помощью Weak<T>
Мы уже видели, что вызов Rc::clone увеличивает strong_count экземпляра
Rc<T>, а экземпляр Rc<T> освобождается, только когда его strong_count
равен 0. Но можно создать и слабую ссылку на значение внутри экземпляра
Rc<T>: для этого вызывают Rc::downgrade и передают ссылку на Rc<T>.
Сильные ссылки (strong references) — это способ совместно владеть
экземпляром Rc<T>. Слабые ссылки (weak references) отношения владения не
выражают, и их количество не влияет на то, когда экземпляр Rc<T> будет
освобождён. Цикла ссылок они не создадут: любой цикл, в котором есть слабые
ссылки, разорвётся, как только счётчик сильных ссылок участвующих значений
станет равен 0.
Вызов Rc::downgrade возвращает умный указатель типа Weak<T>. Вместо того
чтобы увеличивать на 1 strong_count экземпляра Rc<T>, Rc::downgrade
увеличивает на 1 weak_count. Через weak_count тип Rc<T> отслеживает,
сколько существует ссылок Weak<T>, — так же, как через strong_count.
Разница в том, что для освобождения экземпляра Rc<T> weak_count не обязан
быть равен 0.
Значение, на которое ссылается Weak<T>, могло уже быть уничтожено. Поэтому,
чтобы что-то сделать со значением, на которое указывает Weak<T>, нужно
убедиться, что оно ещё существует. Для этого у экземпляра Weak<T> вызывают
метод upgrade, который возвращает Option<Rc<T>>. Если значение Rc<T> ещё
не уничтожено, результат будет Some, а если уже уничтожено — None. Раз
upgrade возвращает Option<Rc<T>>, Rust проследит, чтобы были обработаны оба
случая — и Some, и None, — и недействительного указателя не будет.
Для примера вместо списка, элементы которого знают только о следующем элементе, создадим дерево, элементы которого знают и о своих детях, и о своём родителе.
Создаём дерево
Для начала построим дерево, узлы которого знают о своих дочерних узлах.
Создадим структуру Node, которая хранит собственное значение i32 и ссылки
на дочерние значения Node:
Файл: src/main.rs
use std::cell::RefCell;
use std::rc::Rc;
#[derive(Debug)]
struct Node {
value: i32,
children: RefCell<Vec<Rc<Node>>>,
}
fn main() {
let leaf = Rc::new(Node {
value: 3,
children: RefCell::new(vec![]),
});
let branch = Rc::new(Node {
value: 5,
children: RefCell::new(vec![Rc::clone(&leaf)]),
});
}Мы хотим, чтобы Node владел своими детьми, и при этом хотим делить это
владение с переменными, чтобы обращаться к любому узлу дерева напрямую. Для
этого элементы Vec<T> у нас будут типа Rc<Node>. Ещё мы хотим менять, какие
узлы являются детьми другого узла, поэтому в поле children вектор
Vec<Rc<Node>> обёрнут в RefCell<T>.
Теперь с помощью этого определения создадим экземпляр Node с именем leaf
(лист), значением 3 и без детей, а также экземпляр branch (ветка) со
значением 5, у которого leaf — один из детей, как в листинге 15-27.
use std::cell::RefCell;
use std::rc::Rc;
#[derive(Debug)]
struct Node {
value: i32,
children: RefCell<Vec<Rc<Node>>>,
}
fn main() {
let leaf = Rc::new(Node {
value: 3,
children: RefCell::new(vec![]),
});
let branch = Rc::new(Node {
value: 5,
children: RefCell::new(vec![Rc::clone(&leaf)]),
});
}leaf без детей и узел branch, у которого leaf — один из детейМы клонируем Rc<Node> из leaf и сохраняем его в branch. Значит, у Node в
leaf теперь два владельца: leaf и branch. От branch к leaf можно
добраться через branch.children, а вот от leaf к branch — никак: у leaf
нет ссылки на branch, и он не знает, что они связаны. Мы хотим, чтобы leaf
знал, что branch — его родитель. Этим и займёмся.
Ссылка от ребёнка к родителю
Чтобы дочерний узел знал о родителе, добавим в определение структуры Node
поле parent. Трудность в том, какой тип выбрать для parent. Rc<T> здесь
не подходит: получился бы цикл ссылок — leaf.parent указывал бы на branch,
а branch.children — на leaf, и их strong_count никогда не опустились бы до
0.
Посмотрим на отношения с другой стороны: родительский узел должен владеть детьми — если родитель уничтожается, его дочерние узлы тоже должны уничтожаться. А вот ребёнок не должен владеть родителем: если уничтожить дочерний узел, родитель должен остаться. Это как раз случай для слабых ссылок!
Так что вместо Rc<T> сделаем тип parent на основе Weak<T>, а точнее —
RefCell<Weak<Node>>. Теперь определение структуры Node выглядит так:
Файл: src/main.rs
use std::cell::RefCell;
use std::rc::{Rc, Weak};
#[derive(Debug)]
struct Node {
value: i32,
parent: RefCell<Weak<Node>>,
children: RefCell<Vec<Rc<Node>>>,
}
fn main() {
let leaf = Rc::new(Node {
value: 3,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![]),
});
println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
let branch = Rc::new(Node {
value: 5,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![Rc::clone(&leaf)]),
});
*leaf.parent.borrow_mut() = Rc::downgrade(&branch);
println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
}Узел сможет ссылаться на родителя, но не будет им владеть. В листинге 15-28 мы
обновляем main под новое определение, чтобы у узла leaf был способ
сослаться на своего родителя, branch.
use std::cell::RefCell;
use std::rc::{Rc, Weak};
#[derive(Debug)]
struct Node {
value: i32,
parent: RefCell<Weak<Node>>,
children: RefCell<Vec<Rc<Node>>>,
}
fn main() {
let leaf = Rc::new(Node {
value: 3,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![]),
});
println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
let branch = Rc::new(Node {
value: 5,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![Rc::clone(&leaf)]),
});
*leaf.parent.borrow_mut() = Rc::downgrade(&branch);
println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
}leaf со слабой ссылкой на родительский узел branchСоздание узла leaf похоже на листинг 15-27, кроме поля parent: сначала у
leaf нет родителя, поэтому мы создаём новый пустой экземпляр ссылки
Weak<Node>.
Если сейчас попытаться получить ссылку на родителя leaf методом upgrade,
получим None. Это видно по выводу первого println!:
leaf parent = None
Узел branch при создании тоже получит в поле parent новую ссылку
Weak<Node>, ведь у branch родителя нет. leaf по-прежнему один из детей
branch. Когда экземпляр Node в branch создан, можно изменить leaf и
дать ему ссылку Weak<Node> на родителя. Вызываем borrow_mut у RefCell<Weak<Node>>
в поле parent узла leaf, а затем функцией Rc::downgrade создаём из
Rc<Node> в branch ссылку Weak<Node> на branch.
Если снова вывести родителя leaf, на этот раз получим вариант Some с
branch внутри: теперь leaf может обратиться к родителю! А при выводе leaf
не возникает цикла, который в листинге 15-26 заканчивался переполнением стека:
ссылки Weak<Node> выводятся как (Weak):
leaf parent = Some(Node { value: 5, parent: RefCell { value: (Weak) },
children: RefCell { value: [Node { value: 3, parent: RefCell { value: (Weak) },
children: RefCell { value: [] } }] } })
Отсутствие бесконечного вывода говорит о том, что этот код не создал цикл
ссылок. Это видно и по значениям, которые возвращают Rc::strong_count и
Rc::weak_count.
Как меняются strong_count и weak_count
Посмотрим, как меняются значения strong_count и weak_count у экземпляров
Rc<Node>. Для этого создадим новую внутреннюю область видимости и перенесём
в неё создание branch. Так видно, что происходит, когда branch создаётся, а
затем уничтожается при выходе из области видимости. Изменения — в листинге
15-29.
use std::cell::RefCell;
use std::rc::{Rc, Weak};
#[derive(Debug)]
struct Node {
value: i32,
parent: RefCell<Weak<Node>>,
children: RefCell<Vec<Rc<Node>>>,
}
fn main() {
let leaf = Rc::new(Node {
value: 3,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![]),
});
println!(
"leaf strong = {}, weak = {}",
Rc::strong_count(&leaf),
Rc::weak_count(&leaf),
);
{
let branch = Rc::new(Node {
value: 5,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![Rc::clone(&leaf)]),
});
*leaf.parent.borrow_mut() = Rc::downgrade(&branch);
println!(
"branch strong = {}, weak = {}",
Rc::strong_count(&branch),
Rc::weak_count(&branch),
);
println!(
"leaf strong = {}, weak = {}",
Rc::strong_count(&leaf),
Rc::weak_count(&leaf),
);
}
println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
println!(
"leaf strong = {}, weak = {}",
Rc::strong_count(&leaf),
Rc::weak_count(&leaf),
);
}branch во внутренней области видимости и смотрим на счётчики сильных и слабых ссылокПосле создания leaf у его Rc<Node> счётчик сильных ссылок равен 1, а
слабых — 0. Во внутренней области мы создаём branch и связываем его с
leaf. Если в этот момент вывести счётчики, у Rc<Node> в branch будет 1
сильная ссылка и 1 слабая (это leaf.parent, указывающий на branch через
Weak<Node>). А у leaf будет 2 сильные ссылки — ведь branch теперь хранит в
branch.children клон Rc<Node> узла leaf, — и по-прежнему 0 слабых.
Когда внутренняя область заканчивается, branch выходит из области видимости,
счётчик сильных ссылок его Rc<Node> падает до 0, и его Node уничтожается.
Одна слабая ссылка из leaf.parent на это никак не влияет, так что утечки
памяти нет!
Если после конца области видимости попытаться обратиться к родителю leaf,
снова получим None. В конце программы у Rc<Node> в leaf 1 сильная ссылка и
0 слабых: переменная leaf снова единственная ссылка на этот Rc<Node>.
Вся логика подсчёта и уничтожения значений встроена в Rc<T> и Weak<T> и в
их реализации трейта Drop. Указав в определении Node, что связь от ребёнка
к родителю — ссылка Weak<T>, мы можем сделать так, чтобы родители указывали
на детей, а дети на родителей, и при этом не возникало ни циклов ссылок, ни
утечек памяти.
Итоги
В этой главе мы разобрали, как с помощью умных указателей получать другие
гарантии и компромиссы, чем те, что Rust даёт по умолчанию с обычными
ссылками. Тип Box<T> имеет известный размер и указывает на данные в куче. Тип
Rc<T> считает ссылки на данные в куче, чтобы у данных могло быть несколько
владельцев. Тип RefCell<T> с его внутренней изменяемостью пригодится, когда
нужен неизменяемый тип, но внутреннее значение этого типа надо менять; к тому
же он проверяет правила заимствования не при компиляции, а во время
выполнения.
Ещё мы обсудили трейты Deref и Drop, на которых держится большая часть
возможностей умных указателей. И разобрали циклы ссылок, которые могут
приводить к утечкам памяти, а также то, как предотвращать их с помощью
Weak<T>.
Если эта глава вас заинтересовала и вы хотите писать собственные умные указатели, загляните в «The Rustonomicon» — там много полезного.
Дальше поговорим о конкурентности в Rust. Заодно вы познакомитесь с ещё несколькими умными указателями.
Конкурентность без страха
Безопасное и эффективное конкурентное программирование — ещё одна важная цель Rust. Конкурентное программирование (concurrent programming), при котором разные части программы выполняются независимо, и параллельное программирование (parallel programming), при котором разные части программы выполняются одновременно, становятся всё важнее: всё больше компьютеров используют несколько процессоров. Исторически программирование в таких условиях было сложным и чреватым ошибками. Rust надеется это изменить.
Поначалу команда Rust считала, что обеспечение безопасности памяти и предотвращение проблем конкурентности — две разные задачи, которые решаются разными методами. Со временем выяснилось, что системы владения и типов — мощный набор инструментов, помогающий справиться и с безопасностью памяти, и с проблемами конкурентности! Благодаря владению и проверке типов многие ошибки конкурентности в Rust — это ошибки компиляции, а не ошибки времени выполнения. Поэтому вместо того, чтобы тратить массу времени, пытаясь воспроизвести точные условия, при которых возникает баг конкурентности, вы получаете код, который просто не компилируется, и сообщение об ошибке с объяснением проблемы. В итоге код можно исправить, пока вы над ним работаете, а не когда он, возможно, уже ушёл в продакшен. Эту особенность Rust прозвали конкурентностью без страха (fearless concurrency). Она позволяет писать код без коварных багов, который легко рефакторить, не внося новых.
Примечание: для простоты мы будем называть многие проблемы конкурентными, а не уточнять каждый раз «конкурентные и/или параллельные». В этой главе, встречая слово «конкурентный», мысленно читайте «конкурентный и/или параллельный». В следующей главе, где разница важнее, мы будем точнее.
Многие языки догматичны в том, какие решения для конкурентных задач они предлагают. Например, в Erlang есть изящные средства конкурентности на основе передачи сообщений, но лишь малопонятные способы делить состояние между потоками. Поддерживать только часть возможных решений — разумная стратегия для высокоуровневых языков: они обещают выгоду от того, что вы отказываетесь от части контроля ради абстракций. А от низкоуровневых языков ожидают, что в любой ситуации они дадут самое производительное решение и будут меньше абстрагироваться от железа. Поэтому Rust предлагает разные инструменты, чтобы вы могли смоделировать задачу так, как подходит именно вашей ситуации и требованиям.
Вот о чём пойдёт речь в этой главе:
- как создавать потоки, чтобы выполнять несколько фрагментов кода одновременно;
- конкурентность на основе передачи сообщений (message passing), когда потоки обмениваются сообщениями через каналы;
- конкурентность с общим состоянием (shared state), когда у нескольких потоков есть доступ к одним и тем же данным;
- трейты
SyncиSend, которые распространяют гарантии конкурентности Rust на пользовательские типы, а не только на типы стандартной библиотеки.
Потоки: одновременное выполнение кода
Потоки: одновременное выполнение кода
В большинстве современных операционных систем код запущенной программы выполняется в процессе (process), и операционная система управляет сразу многими процессами. Внутри программы тоже могут быть независимые части, работающие одновременно. То, что выполняет эти независимые части, называется потоками (threads). Например, у веб-сервера может быть несколько потоков, чтобы отвечать сразу на несколько запросов.
Если разбить вычисления программы на несколько потоков и выполнять несколько задач одновременно, производительность может вырасти, но и сложность тоже. Потоки могут работать одновременно, поэтому нет никакой гарантии, в каком порядке выполнятся части кода в разных потоках. Это может приводить к проблемам:
- состояниям гонки (race conditions), когда потоки обращаются к данным или ресурсам в непредсказуемом порядке;
- взаимным блокировкам (deadlocks), когда два потока ждут друг друга и ни один не может продолжить работу;
- багам, которые проявляются лишь в определённых ситуациях, и их трудно надёжно воспроизвести и исправить.
Rust старается смягчить негативные стороны работы с потоками, но программирование в многопоточном контексте всё равно требует тщательного обдумывания и иной структуры кода, чем в однопоточных программах.
Языки программирования реализуют потоки по-разному, и многие операционные системы предоставляют API, через который язык может создавать новые потоки. Стандартная библиотека Rust использует модель потоков 1:1: на каждый поток языка приходится один поток операционной системы. Есть крейты, реализующие другие модели потоков, с другими компромиссами по сравнению с моделью 1:1. (Асинхронность в Rust, с которой мы познакомимся в следующей главе, — тоже другой подход к конкурентности.)
Создание потока через spawn
Чтобы создать новый поток, вызывают функцию thread::spawn и передают ей
замыкание (о замыканиях мы говорили в главе 13) с кодом, который нужно
выполнить в новом потоке. В примере из листинга 16-1 главный поток выводит
один текст, а новый поток — другой.
use std::thread;
use std::time::Duration;
fn main() {
thread::spawn(|| {
for i in 1..10 {
println!("hi number {i} from the spawned thread!");
thread::sleep(Duration::from_millis(1));
}
});
for i in 1..5 {
println!("hi number {i} from the main thread!");
thread::sleep(Duration::from_millis(1));
}
}Учтите: когда главный поток программы на Rust завершается, все порождённые потоки останавливаются — неважно, закончили они работу или нет. Вывод этой программы может немного отличаться от запуска к запуску, но в целом будет таким:
hi number 1 from the main thread!
hi number 1 from the spawned thread!
hi number 2 from the main thread!
hi number 2 from the spawned thread!
hi number 3 from the main thread!
hi number 3 from the spawned thread!
hi number 4 from the main thread!
hi number 4 from the spawned thread!
hi number 5 from the spawned thread!
Вызовы thread::sleep заставляют поток ненадолго приостановиться и дают
поработать другому потоку. Скорее всего, потоки будут чередоваться, но это не
гарантировано: всё зависит от того, как операционная система планирует потоки.
В этом запуске главный поток вывел текст первым, хотя в коде вывод из
порождённого потока стоит раньше. И хотя мы велели порождённому потоку
выводить, пока i не станет 9, он успел дойти лишь до 5, прежде чем
главный поток завершился.
Если при запуске вы видите вывод только главного потока или вывод не перемешивается, попробуйте увеличить числа в диапазонах, чтобы у операционной системы было больше возможностей переключаться между потоками.
Ждём завершения всех потоков
С кодом из листинга 16-1 две проблемы. Во-первых, порождённый поток обычно останавливается раньше времени — потому что завершается главный. Во-вторых, порядок выполнения потоков не гарантирован, так что нельзя гарантировать даже то, что порождённый поток вообще успеет поработать!
Чтобы это исправить, сохраним в переменную значение, которое возвращает
thread::spawn. Его тип — JoinHandle<T>. JoinHandle<T> — значение, которым
мы владеем; если вызвать у него метод join, он дождётся завершения своего
потока. В листинге 16-2 показано, как использовать JoinHandle<T> потока из
листинга 16-1 и вызвать join, чтобы порождённый поток закончился раньше, чем
завершится main.
use std::thread;
use std::time::Duration;
fn main() {
let handle = thread::spawn(|| {
for i in 1..10 {
println!("hi number {i} from the spawned thread!");
thread::sleep(Duration::from_millis(1));
}
});
for i in 1..5 {
println!("hi number {i} from the main thread!");
thread::sleep(Duration::from_millis(1));
}
handle.join().unwrap();
}JoinHandle<T> из thread::spawn, чтобы гарантировать, что поток доработает до концаВызов join у дескриптора блокирует текущий поток, пока не завершится поток,
которому принадлежит дескриптор. Блокировка потока означает, что поток не
может ни выполнять работу, ни завершиться. Мы поставили вызов join после
цикла for главного потока, поэтому листинг 16-2 выведет примерно такое:
hi number 1 from the main thread!
hi number 2 from the main thread!
hi number 1 from the spawned thread!
hi number 3 from the main thread!
hi number 2 from the spawned thread!
hi number 4 from the main thread!
hi number 3 from the spawned thread!
hi number 4 from the spawned thread!
hi number 5 from the spawned thread!
hi number 6 from the spawned thread!
hi number 7 from the spawned thread!
hi number 8 from the spawned thread!
hi number 9 from the spawned thread!
Потоки по-прежнему чередуются, но главный поток из-за вызова handle.join()
ждёт и не завершается, пока не закончит порождённый.
А теперь посмотрим, что будет, если перенести handle.join() в main перед
циклом for:
use std::thread;
use std::time::Duration;
fn main() {
let handle = thread::spawn(|| {
for i in 1..10 {
println!("hi number {i} from the spawned thread!");
thread::sleep(Duration::from_millis(1));
}
});
handle.join().unwrap();
for i in 1..5 {
println!("hi number {i} from the main thread!");
thread::sleep(Duration::from_millis(1));
}
}Главный поток дождётся завершения порождённого и только потом запустит свой
цикл for, так что вывод больше не будет перемешан:
hi number 1 from the spawned thread!
hi number 2 from the spawned thread!
hi number 3 from the spawned thread!
hi number 4 from the spawned thread!
hi number 5 from the spawned thread!
hi number 6 from the spawned thread!
hi number 7 from the spawned thread!
hi number 8 from the spawned thread!
hi number 9 from the spawned thread!
hi number 1 from the main thread!
hi number 2 from the main thread!
hi number 3 from the main thread!
hi number 4 from the main thread!
Мелкие детали — например, где вызван join, — влияют на то, будут ли ваши
потоки работать одновременно.
Замыкания move и потоки
С замыканиями, которые передаются в thread::spawn, часто используют
ключевое слово move: тогда замыкание забирает владение значениями, которые
использует из окружения, и тем самым владение передаётся из одного потока в
другой. Мы обсуждали move применительно к замыканиям в разделе «Захват
ссылок или перемещение владения» главы 13. Теперь
сосредоточимся на том, как move взаимодействует с thread::spawn.
Обратите внимание: замыкание, которое мы передаём в thread::spawn в листинге
16-1, не принимает аргументов — в коде порождённого потока мы не используем
никаких данных из главного. Чтобы использовать в порождённом потоке данные
главного, замыкание порождённого потока должно захватить нужные значения. В
листинге 16-3 — попытка создать вектор в главном потоке и использовать его в
порождённом. Но пока это не сработает, как вы сейчас увидите.
use std::thread;
fn main() {
let v = vec![1, 2, 3];
let handle = thread::spawn(|| {
println!("Here's a vector: {v:?}");
});
handle.join().unwrap();
}Замыкание использует v, поэтому захватит v и сделает его частью своего
окружения. thread::spawn выполняет замыкание в новом потоке, так что внутри
нового потока к v вроде бы можно обратиться. Но при компиляции получаем
ошибку:
$ cargo run
Compiling threads v0.1.0 (file:///projects/threads)
error[E0373]: closure may outlive the current function, but it borrows `v`, which is owned by the current function
--> src/main.rs:6:32
|
6 | let handle = thread::spawn(|| {
| ^^ may outlive borrowed value `v`
7 | println!("Here's a vector: {v:?}");
| - `v` is borrowed here
|
note: function requires argument type to outlive `'static`
--> src/main.rs:6:18
|
6 | let handle = thread::spawn(|| {
| __________________^
7 | | println!("Here's a vector: {v:?}");
8 | | });
| |______^
help: to force the closure to take ownership of `v` (and any other referenced variables), use the `move` keyword
|
6 | let handle = thread::spawn(move || {
| ++++
For more information about this error, try `rustc --explain E0373`.
error: could not compile `threads` (bin "threads") due to 1 previous error
Rust сам выводит, как захватить v, и поскольку println! нужна только
ссылка на v, замыкание пытается позаимствовать v. Но есть проблема: Rust не
может знать, сколько будет работать порождённый поток, а значит, не знает,
останется ли ссылка на v действительной.
В листинге 16-4 сценарий, где ссылка на v с ещё большей вероятностью окажется
недействительной.
use std::thread;
fn main() {
let v = vec![1, 2, 3];
let handle = thread::spawn(|| {
println!("Here's a vector: {v:?}");
});
drop(v); // ой-ой!
handle.join().unwrap();
}v из главного потока, а главный поток уничтожает vЕсли бы Rust разрешил запустить этот код, порождённый поток мог бы сразу уйти
в фон, так и не начав работу. Внутри у него ссылка на v, а главный поток тут
же уничтожает v функцией drop, о которой мы говорили в главе 15. Тогда,
когда порождённый поток начнёт работу, v уже недействителен — а значит,
недействительна и ссылка на него. Беда!
Чтобы исправить ошибку компиляции из листинга 16-3, воспользуемся советом из сообщения об ошибке:
help: to force the closure to take ownership of `v` (and any other referenced variables), use the `move` keyword
|
6 | let handle = thread::spawn(move || {
| ++++
Добавив ключевое слово move перед замыканием, мы заставляем его забрать
владение используемыми значениями, а не позволяем Rust решить, что их нужно
позаимствовать. Изменённый листинг 16-3, показанный в листинге 16-5,
скомпилируется и будет работать как задумано.
use std::thread;
fn main() {
let v = vec![1, 2, 3];
let handle = thread::spawn(move || {
println!("Here's a vector: {v:?}");
});
handle.join().unwrap();
}move заставляет замыкание забрать владение используемыми значениямиМожет возникнуть соблазн так же исправить и код из листинга 16-4, где главный
поток вызывал drop, — замыканием move. Но это не сработает: то, что
пытается сделать листинг 16-4, запрещено по другой причине. Если добавить к
замыканию move, v переместится в окружение замыкания, и вызвать для него
drop в главном потоке уже не получится. Вместо этого будет такая ошибка
компиляции:
$ cargo run
Compiling threads v0.1.0 (file:///projects/threads)
error[E0382]: use of moved value: `v`
--> src/main.rs:10:10
|
4 | let v = vec![1, 2, 3];
| - move occurs because `v` has type `Vec<i32>`, which does not implement the `Copy` trait
5 |
6 | let handle = thread::spawn(move || {
| ------- value moved into closure here
7 | println!("Here's a vector: {v:?}");
| - variable moved due to use in closure
...
10 | drop(v); // ой-ой!
| ^ value used here after move
|
help: consider cloning the value before moving it into the closure
|
6 ~ let value = v.clone();
7 ~ let handle = thread::spawn(move || {
8 ~ println!("Here's a vector: {value:?}");
|
For more information about this error, try `rustc --explain E0382`.
error: could not compile `threads` (bin "threads") due to 1 previous error
Правила владения Rust снова нас спасли! Код из листинга 16-3 выдавал ошибку,
потому что Rust действовал осторожно и лишь заимствовал v для потока, а
значит, главный поток теоретически мог сделать ссылку порождённого потока
недействительной. Когда мы говорим Rust передать владение v порождённому
потоку, мы тем самым гарантируем Rust, что главный поток больше не будет
пользоваться v. А если
так же изменить листинг 16-4, то, попытавшись использовать v в главном
потоке, мы нарушим правила владения. Ключевое слово move отменяет
осторожное поведение по умолчанию — заимствование, — но не позволяет нарушать
правила владения.
Теперь, когда мы разобрались, что такое потоки и какие методы даёт API потоков, посмотрим, в каких ситуациях потоки можно применять.
Передача данных между потоками через сообщения
Передача данных между потоками через сообщения
Один из всё более популярных подходов к безопасной конкурентности — передача сообщений: потоки или акторы общаются, отправляя друг другу сообщения с данными. Идея хорошо выражена в лозунге из документации языка Go: «Не обменивайтесь данными через общую память — вместо этого делитесь данными, обмениваясь сообщениями».
Для конкурентности на основе передачи сообщений в стандартной библиотеке Rust есть реализация каналов. Канал (channel) — общее понятие в программировании: механизм, по которому данные пересылаются из одного потока в другой.
Канал в программировании можно представить как русло, по которому течёт вода, — ручей или реку. Если пустить в реку что-нибудь вроде резиновой уточки, её унесёт вниз по течению до самого конца русла.
У канала две половины: передатчик (transmitter) и приёмник (receiver). Передатчик — это место выше по течению, где вы пускаете уточку в реку, а приёмник — место ниже по течению, куда уточка в итоге приплывает. Одна часть вашего кода вызывает у передатчика методы с данными, которые нужно отправить, а другая проверяет, не пришли ли сообщения на приёмную сторону. Канал считается закрытым, если уничтожена хотя бы одна из его половин — передатчик или приёмник.
Мы постепенно напишем программу, в которой один поток генерирует значения и отправляет их по каналу, а другой получает их и выводит. Чтобы показать, как это работает, будем пересылать между потоками простые значения. Освоив этот приём, вы сможете использовать каналы для любых потоков, которым нужно общаться: например, для чата или для системы, где много потоков выполняют части вычисления и отправляют результаты одному потоку, который их собирает.
Сначала, в листинге 16-6, создадим канал, но ничего с ним делать не будем. Учтите, что код пока не скомпилируется: Rust не может понять, значения какого типа мы хотим отправлять по каналу.
use std::sync::mpsc;
fn main() {
let (tx, rx) = mpsc::channel();
}tx и rxНовый канал создаётся функцией mpsc::channel; mpsc расшифровывается как
multiple producer, single consumer — «много производителей, один
потребитель». Коротко говоря, в стандартной библиотеке Rust каналы устроены
так, что у канала может быть несколько отправляющих концов, производящих
значения, но лишь один принимающий, который их потребляет. Представьте
несколько ручьёв, впадающих в одну большую реку: всё, что пустили по любому из
ручьёв, в итоге окажется в одной реке. Пока начнём с одного производителя, а
когда пример заработает, добавим ещё.
Функция mpsc::channel возвращает кортеж: первый элемент — отправляющий
конец, передатчик, а второй — принимающий конец, приёмник. Сокращения tx и
rx во многих областях традиционно обозначают transmitter (передатчик) и
receiver (приёмник), поэтому мы так и называем переменные. Мы используем
инструкцию let с образцом, который разбирает кортеж; об образцах в let и
деструктуризации мы поговорим в главе 19. Пока достаточно знать, что такая
инструкция let — удобный способ достать части кортежа, который возвращает
mpsc::channel.
Перенесём передающий конец в порождённый поток и отправим одну строку, чтобы порождённый поток пообщался с главным, как в листинге 16-7. Это как пустить уточку в реку выше по течению или отправить сообщение в чате из одного потока в другой.
use std::sync::mpsc;
use std::thread;
fn main() {
let (tx, rx) = mpsc::channel();
thread::spawn(move || {
let val = String::from("hi");
tx.send(val).unwrap();
});
}tx в порождённый поток и отправляем "hi"Снова создаём новый поток через thread::spawn и с помощью move перемещаем
tx в замыкание, чтобы им владел порождённый поток. Чтобы отправлять сообщения
по каналу, порождённый поток должен владеть передатчиком.
У передатчика есть метод send, который принимает отправляемое значение.
Метод send возвращает Result<T, E>: если приёмник уже уничтожен и
отправлять значение некуда, операция отправки вернёт ошибку. В этом примере
мы вызываем unwrap, чтобы при ошибке запаниковать. Но в настоящем приложении
её нужно было бы обработать как следует — стратегии правильной обработки
ошибок описаны в главе 9.
В листинге 16-8 мы получаем значение из приёмника в главном потоке. Это как выловить уточку из воды в конце реки или получить сообщение в чате.
use std::sync::mpsc;
use std::thread;
fn main() {
let (tx, rx) = mpsc::channel();
thread::spawn(move || {
let val = String::from("hi");
tx.send(val).unwrap();
});
let received = rx.recv().unwrap();
println!("Got: {received}");
}"hi" в главном потоке и выводим егоУ приёмника два полезных метода: recv и try_recv. Мы используем recv (от
receive — получить). Он блокирует выполнение главного потока и ждёт, пока по
каналу не придёт значение. Когда значение отправлено, recv вернёт его в
Result<T, E>. А когда передатчик закроется, recv вернёт ошибку — знак того,
что значений больше не будет.
Метод try_recv не блокирует поток, а сразу возвращает Result<T, E>: Ok с
сообщением, если оно есть, и Err, если сообщений пока нет. try_recv
полезен, если у потока есть и другая работа, пока он ждёт сообщений: можно
написать цикл, который время от времени вызывает try_recv, обрабатывает
сообщение, если оно пришло, а иначе немного занимается другой работой до
следующей проверки.
В этом примере мы для простоты используем recv: никакой другой работы, кроме
ожидания сообщений, у главного потока нет, так что блокировать его вполне
уместно.
Запустив код из листинга 16-8, увидим значение, выведенное главным потоком:
Got: hi
Отлично!
Передача владения через каналы
Правила владения играют в передаче сообщений ключевую роль: они помогают
писать безопасный конкурентный код. Предотвращение ошибок в конкурентном
программировании — та выгода, которую даёт привычка думать о владении во
всех программах на Rust. Проведём эксперимент и покажем, как каналы и
владение вместе предотвращают проблемы: попробуем использовать значение val
в порождённом потоке после того, как отправили его по каналу. Скомпилируйте
код из листинга 16-9 и посмотрите, почему так нельзя.
use std::sync::mpsc;
use std::thread;
fn main() {
let (tx, rx) = mpsc::channel();
thread::spawn(move || {
let val = String::from("hi");
tx.send(val).unwrap();
println!("val is {val}");
});
let received = rx.recv().unwrap();
println!("Got: {received}");
}val после того, как отправили его по каналуЗдесь мы пытаемся вывести val после того, как отправили его по каналу через
tx.send. Разрешать такое было бы плохой идеей: как только значение отправлено
в другой поток, тот может изменить или уничтожить его раньше, чем мы снова им
воспользуемся. Изменения в другом потоке могли бы привести к ошибкам или
неожиданным результатам из-за несогласованных или уже несуществующих данных.
Но при попытке скомпилировать код из листинга 16-9 Rust выдаёт ошибку:
$ cargo run
Compiling message-passing v0.1.0 (file:///projects/message-passing)
error[E0382]: borrow of moved value: `val`
--> src/main.rs:10:27
|
8 | let val = String::from("hi");
| --- move occurs because `val` has type `String`, which does not implement the `Copy` trait
9 | tx.send(val).unwrap();
| --- value moved here
10 | println!("val is {val}");
| ^^^ value borrowed here after move
For more information about this error, try `rustc --explain E0382`.
error: could not compile `message-passing` (bin "message-passing") due to 1 previous error
Наша ошибка конкурентности стала ошибкой компиляции. Функция send забирает
владение своим параметром, а когда значение перемещается, владельцем
становится приёмник. Это не даёт случайно снова воспользоваться значением после
отправки: система владения проверяет, что всё в порядке.
Отправка нескольких значений
Код из листинга 16-8 скомпилировался и заработал, но не показал наглядно, что два отдельных потока общаются по каналу.
В листинге 16-10 мы внесли изменения, которые докажут, что код из листинга 16-8 работает конкурентно: теперь порождённый поток отправляет несколько сообщений и делает паузу в секунду между ними.
use std::sync::mpsc;
use std::thread;
use std::time::Duration;
fn main() {
let (tx, rx) = mpsc::channel();
thread::spawn(move || {
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("thread"),
];
for val in vals {
tx.send(val).unwrap();
thread::sleep(Duration::from_secs(1));
}
});
for received in rx {
println!("Got: {received}");
}
}На этот раз у порождённого потока есть вектор строк, которые нужно отправить
главному потоку. Мы перебираем их, отправляем по одной и между отправками
делаем паузу, вызывая thread::sleep со значением Duration в одну секунду.
В главном потоке мы больше не вызываем recv явно, а обращаемся с rx как с
итератором: каждое полученное значение выводим. Когда канал закроется, перебор
закончится.
Запустив код из листинга 16-10, вы увидите следующий вывод — строки будут появляться с паузой в секунду:
Got: hi
Got: from
Got: the
Got: thread
В цикле for главного потока нет кода с паузами или задержками, значит,
главный поток действительно ждёт значения от порождённого.
Несколько производителей
Выше мы говорили, что mpsc — сокращение от multiple producer, single
consumer. Воспользуемся этим и расширим код из листинга 16-10: создадим
несколько потоков, которые отправляют значения одному и тому же приёмнику.
Для этого передатчик можно клонировать, как в листинге 16-11.
use std::sync::mpsc;
use std::thread;
use std::time::Duration;
fn main() {
// --пропуск--
let (tx, rx) = mpsc::channel();
let tx1 = tx.clone();
thread::spawn(move || {
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("thread"),
];
for val in vals {
tx1.send(val).unwrap();
thread::sleep(Duration::from_secs(1));
}
});
thread::spawn(move || {
let vals = vec![
String::from("more"),
String::from("messages"),
String::from("for"),
String::from("you"),
];
for val in vals {
tx.send(val).unwrap();
thread::sleep(Duration::from_secs(1));
}
});
for received in rx {
println!("Got: {received}");
}
// --пропуск--
}На этот раз, прежде чем создать первый порождённый поток, мы вызываем у
передатчика clone. Так получается новый передатчик, который мы отдаём первому
порождённому потоку. А исходный передатчик отдаём второму порождённому потоку.
В итоге два потока отправляют разные сообщения одному приёмнику.
Запустив код, вы увидите примерно такой вывод:
Got: hi
Got: more
Got: from
Got: messages
Got: for
Got: the
Got: thread
Got: you
В зависимости от системы значения могут прийти в другом порядке. Именно это
делает конкурентность одновременно интересной и сложной. Если поэкспериментировать
с thread::sleep, задавая разные значения в разных потоках, каждый запуск будет
ещё менее предсказуемым и давать разный вывод.
Теперь, когда мы посмотрели, как работают каналы, рассмотрим другой подход к конкурентности.
Конкурентность с общим состоянием
Конкурентность с общим состоянием
Передача сообщений — хороший способ организовать конкурентность, но не единственный. Другой способ — дать нескольким потокам доступ к одним и тем же общим данным. Вспомните ещё раз часть лозунга из документации Go: «Не обменивайтесь данными через общую память».
Как выглядел бы обмен данными через общую память? И почему сторонники передачи сообщений предостерегают от общей памяти?
В каком-то смысле каналы в любом языке похожи на единоличное владение: отправив значение по каналу, пользоваться им больше нельзя. А конкурентность с общей памятью похожа на множественное владение: несколько потоков могут одновременно обращаться к одному и тому же участку памяти. Как вы видели в главе 15, где умные указатели сделали множественное владение возможным, оно усложняет дело: разными владельцами нужно управлять. Система типов и правила владения Rust сильно помогают сделать это правильно. Для примера рассмотрим мьютексы — один из самых распространённых примитивов конкурентности для общей памяти.
Управление доступом с помощью мьютексов
Мьютекс (mutex) — сокращение от mutual exclusion, «взаимное исключение»: мьютекс в каждый момент времени даёт доступ к данным только одному потоку. Чтобы обратиться к данным внутри мьютекса, поток должен сначала заявить, что хочет доступа, — попросить захватить блокировку (lock) мьютекса. Блокировка — это структура данных внутри мьютекса, которая отмечает, у кого сейчас исключительный доступ к данным. Поэтому говорят, что мьютекс охраняет свои данные с помощью системы блокировок.
У мьютексов репутация сложного инструмента, потому что нужно помнить два правила:
- Прежде чем пользоваться данными, нужно попытаться захватить блокировку.
- Закончив работу с данными, которые охраняет мьютекс, нужно снять блокировку, чтобы её могли захватить другие потоки.
Вот метафора из жизни: представьте дискуссию на конференции, где у участников всего один микрофон. Прежде чем участник заговорит, он должен попросить микрофон или подать знак, что хочет его взять. Получив микрофон, он может говорить сколько угодно, а потом передаёт микрофон следующему, кто попросил слова. Если участник, закончив, забудет передать микрофон, больше никто не сможет говорить. Если с общим микрофоном что-то пойдёт не так, дискуссия не сложится!
Правильно управлять мьютексами бывает невероятно сложно — поэтому многие так любят каналы. Но благодаря системе типов и правилам владения в Rust ошибиться с захватом и снятием блокировки невозможно.
API Mutex<T>
Чтобы показать, как пользоваться мьютексом, начнём с мьютекса в однопоточном контексте, как в листинге 16-12.
use std::sync::Mutex;
fn main() {
let m = Mutex::new(5);
{
let mut num = m.lock().unwrap();
*num = 6;
}
println!("m = {m:?}");
}Mutex<T> для простоты в однопоточном контекстеКак и многие типы, Mutex<T> создаётся ассоциированной функцией new. Чтобы
добраться до данных внутри мьютекса, захватываем блокировку методом lock.
Этот вызов блокирует текущий поток: тот не может ничего делать, пока не придёт
наша очередь владеть блокировкой.
Вызов lock завершится неудачей, если другой поток, державший блокировку,
запаниковал. Тогда блокировку уже никто никогда не получит, поэтому мы решили
вызвать unwrap и в такой ситуации запаниковать и в этом потоке.
Когда блокировка захвачена, с возвращённым значением — здесь оно называется
num — можно обращаться как с изменяемой ссылкой на данные внутри. Система типов
гарантирует, что мы захватим блокировку, прежде чем пользоваться значением в
m. Тип m — Mutex<i32>, а не i32, поэтому, чтобы воспользоваться
значением i32, обязательно нужно вызвать lock. Забыть не получится:
иначе система типов не даст добраться до внутреннего i32.
Вызов lock возвращает тип MutexGuard, обёрнутый в LockResult, который мы
обработали вызовом unwrap. Тип MutexGuard реализует Deref и указывает на
внутренние данные; а ещё у него есть реализация Drop, которая автоматически
снимает блокировку, когда MutexGuard выходит из области видимости, — в нашем
случае в конце внутренней области. Поэтому мы не рискуем забыть снять
блокировку и не дать другим потокам пользоваться мьютексом: блокировка
снимается сама.
Сняв блокировку, мы выводим значение мьютекса и видим, что внутреннее i32
удалось изменить на 6.
Общий доступ к Mutex<T>
Теперь попробуем с помощью Mutex<T> разделить значение между несколькими
потоками. Запустим 10 потоков, и пусть каждый увеличит счётчик на 1, чтобы
счётчик дошёл от 0 до 10. Пример из листинга 16-13 не скомпилируется, и по этой
ошибке мы узнаем больше о том, как пользоваться Mutex<T> и как Rust помогает
делать это правильно.
use std::sync::Mutex;
use std::thread;
fn main() {
let counter = Mutex::new(0);
let mut handles = vec![];
for _ in 0..10 {
let handle = thread::spawn(move || {
let mut num = counter.lock().unwrap();
*num += 1;
});
handles.push(handle);
}
for handle in handles {
handle.join().unwrap();
}
println!("Result: {}", *counter.lock().unwrap());
}Mutex<T>Мы создаём переменную counter, которая хранит i32 внутри Mutex<T>, как в
листинге 16-12. Затем создаём 10 потоков, перебирая диапазон чисел. Через
thread::spawn даём всем потокам одно и то же замыкание: оно перемещает
счётчик в поток, захватывает блокировку Mutex<T> методом lock и прибавляет
1 к значению в мьютексе. Когда поток заканчивает выполнять замыкание, num
выходит из области видимости и снимает блокировку, чтобы её мог захватить
другой поток.
В главном потоке мы собираем все дескрипторы потоков. Затем, как в листинге
16-2, вызываем join у каждого, чтобы дождаться завершения всех потоков. После
этого главный поток захватывает блокировку и выводит результат программы.
Мы намекали, что этот пример не скомпилируется. Посмотрим почему!
$ cargo run
Compiling shared-state v0.1.0 (file:///projects/shared-state)
error[E0382]: borrow of moved value: `counter`
--> src/main.rs:21:29
|
5 | let counter = Mutex::new(0);
| ------- move occurs because `counter` has type `std::sync::Mutex<i32>`, which does not implement the `Copy` trait
...
8 | for _ in 0..10 {
| -------------- inside of this loop
9 | let handle = thread::spawn(move || {
| ------- value moved into closure here, in previous iteration of loop
...
21 | println!("Result: {}", *counter.lock().unwrap());
| ^^^^^^^ value borrowed here after move
For more information about this error, try `rustc --explain E0382`.
error: could not compile `shared-state` (bin "shared-state") due to 1 previous error
Сообщение об ошибке говорит, что значение counter было перемещено на
предыдущей итерации цикла. Rust сообщает, что нельзя перемещать владение
мьютексом counter сразу в несколько потоков. Исправим ошибку компиляции
способом множественного владения из главы 15.
Множественное владение в нескольких потоках
В главе 15 мы давали значению нескольких владельцев с помощью умного указателя
Rc<T>, создавая значение с подсчётом ссылок. Сделаем то же самое здесь и
посмотрим, что получится. В листинге 16-14 мы оборачиваем Mutex<T> в Rc<T>
и клонируем Rc<T>, прежде чем передать владение в поток.
use std::rc::Rc;
use std::sync::Mutex;
use std::thread;
fn main() {
let counter = Rc::new(Mutex::new(0));
let mut handles = vec![];
for _ in 0..10 {
let counter = Rc::clone(&counter);
let handle = thread::spawn(move || {
let mut num = counter.lock().unwrap();
*num += 1;
});
handles.push(handle);
}
for handle in handles {
handle.join().unwrap();
}
println!("Result: {}", *counter.lock().unwrap());
}Rc<T> дать нескольким потокам владеть Mutex<T>Снова компилируем и получаем… другие ошибки! Компилятор многому нас учит:
$ cargo run
Compiling shared-state v0.1.0 (file:///projects/shared-state)
error[E0277]: `Rc<std::sync::Mutex<i32>>` cannot be sent between threads safely
--> src/main.rs:11:36
|
11 | let handle = thread::spawn(move || {
| ------------- ^------
| | |
| ______________________|_____________within this `{closure@src/main.rs:11:36: 11:43}`
| | |
| | required by a bound introduced by this call
12 | | let mut num = counter.lock().unwrap();
13 | |
14 | | *num += 1;
15 | | });
| |_________^ `Rc<std::sync::Mutex<i32>>` cannot be sent between threads safely
|
= help: within `{closure@src/main.rs:11:36: 11:43}`, the trait `Send` is not implemented for `Rc<std::sync::Mutex<i32>>`
note: required because it's used within this closure
--> src/main.rs:11:36
|
11 | let handle = thread::spawn(move || {
| ^^^^^^^
note: required by a bound in `spawn`
--> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/std/src/thread/functions.rs:125:0
For more information about this error, try `rustc --explain E0277`.
error: could not compile `shared-state` (bin "shared-state") due to 1 previous error
Ничего себе многословное сообщение! Вот на чём стоит сосредоточиться:
`Rc<Mutex<i32>>` cannot be sent between threads safely — «Rc<Mutex<i32>>
нельзя безопасно передавать между потоками». Компилятор называет и причину:
the trait `Send` is not implemented for `Rc<Mutex<i32>>` — «для
Rc<Mutex<i32>> не реализован трейт Send». О Send мы поговорим в
следующем разделе: это один из трейтов, гарантирующих, что типы, которые мы
используем с потоками, предназначены для конкурентных ситуаций.
К сожалению, делить Rc<T> между потоками небезопасно. Управляя счётчиком
ссылок, Rc<T> увеличивает его при каждом вызове clone и уменьшает при
уничтожении каждого клона. Но при этом он не использует никаких примитивов
конкурентности, которые гарантировали бы, что изменение счётчика не прервёт
другой поток. Это может привести к неверным значениям счётчика — коварным
багам, которые, в свою очередь, ведут к утечкам памяти или к тому, что значение
уничтожается раньше, чем мы закончили с ним работать. Нам нужен тип, ровно
такой же, как Rc<T>, но изменяющий счётчик ссылок потокобезопасно.
Атомарный подсчёт ссылок: Arc<T>
К счастью, Arc<T> — именно такой тип, как Rc<T>, но безопасный в
конкурентных ситуациях. Буква a означает atomic (атомарный): это тип с
атомарным подсчётом ссылок (atomically reference-counted). Атомарные типы —
ещё один вид примитивов конкурентности, подробно разбирать их мы не будем;
подробности — в документации стандартной библиотеки к
std::sync::atomic. Пока достаточно знать, что
атомарные типы работают как примитивные, но их безопасно делить между
потоками.
Возможно, вы спросите: почему тогда не все примитивные типы атомарные и почему
типы стандартной библиотеки не используют Arc<T> по умолчанию? Дело в том,
что за потокобезопасность приходится платить производительностью, а платить
стоит только тогда, когда это действительно нужно. Если вы работаете со
значениями в одном потоке, код будет быстрее без гарантий, которые дают
атомарные типы.
Вернёмся к примеру. У Arc<T> и Rc<T> одинаковый API, так что исправить
программу можно, поменяв строку use, вызов new и вызов clone. Код из
листинга 16-15 наконец скомпилируется и заработает.
use std::sync::{Arc, Mutex};
use std::thread;
fn main() {
let counter = Arc::new(Mutex::new(0));
let mut handles = vec![];
for _ in 0..10 {
let counter = Arc::clone(&counter);
let handle = thread::spawn(move || {
let mut num = counter.lock().unwrap();
*num += 1;
});
handles.push(handle);
}
for handle in handles {
handle.join().unwrap();
}
println!("Result: {}", *counter.lock().unwrap());
}Mutex<T> в Arc<T>, чтобы несколько потоков могли совместно им владетьЭтот код выведет:
Result: 10
Получилось! Мы посчитали от 0 до 10 — вроде бы не так уж впечатляюще, зато
многое узнали о Mutex<T> и потокобезопасности. По такой же схеме можно
делать и операции сложнее, чем увеличение счётчика. Например, разбить
вычисление на независимые части, раздать их потокам, а затем с помощью
Mutex<T> дать каждому потоку дописать свою часть в итоговый результат.
Учтите: для простых числовых операций есть типы попроще Mutex<T> — в модуле
std::sync::atomic стандартной библиотеки. Они дают
безопасный конкурентный атомарный доступ к примитивным типам. В этом примере
мы взяли Mutex<T> с примитивным типом, чтобы сосредоточиться на том, как
работает Mutex<T>.
RefCell<T>/Rc<T> и Mutex<T>/Arc<T>
Вы, наверное, заметили, что counter неизменяемый, но мы смогли получить
изменяемую ссылку на значение внутри него. Значит, Mutex<T> даёт внутреннюю
изменяемость — как семейство типов Cell. Как в главе 15 мы с помощью
RefCell<T> меняли содержимое внутри Rc<T>, так и здесь с помощью Mutex<T>
меняем содержимое внутри Arc<T>.
Учтите и ещё одно: когда вы используете Mutex<T>, Rust не может защитить
вас от всех логических ошибок. Вспомните из главы 15, что с Rc<T> есть риск создать
цикл ссылок, когда два значения Rc<T> ссылаются друг на друга, и память
утекает. Точно так же с Mutex<T> есть риск создать взаимную блокировку
(deadlock). Она возникает, когда операции нужно захватить два ресурса, а два
потока захватили по одной блокировке и вечно ждут друг друга. Если вам
интересны взаимные блокировки, попробуйте написать программу на Rust со
взаимной блокировкой, затем изучите стратегии борьбы с ними для мьютексов в
любом языке и попробуйте реализовать их на Rust. Полезные сведения есть в
документации стандартной библиотеки к API Mutex<T> и MutexGuard.
Завершим главу разговором о трейтах Send и Sync и о том, как использовать их
с собственными типами.
Расширяемая конкурентность: Send и Sync
Расширяемая конкурентность: Send и Sync
Интересно, что почти все средства конкурентности, о которых шла речь в этой главе, — часть стандартной библиотеки, а не языка. Ваши возможности не ограничены языком и стандартной библиотекой: можно писать собственные средства конкурентности или пользоваться написанными другими.
Однако среди ключевых понятий конкурентности есть и встроенные в сам язык, а не
в стандартную библиотеку, — это трейты Send и Sync из std::marker.
Передача владения между потоками
Трейт-маркер Send означает, что владение значениями типа, который его
реализует, можно передавать между потоками. Send реализуют почти все типы
Rust, но есть исключения, в том числе Rc<T>. Он не может реализовать Send:
если склонировать значение Rc<T> и передать владение клоном в другой поток,
оба потока могут одновременно изменить счётчик ссылок. Поэтому Rc<T>
предназначен для однопоточных ситуаций, где не хочется платить
производительностью за потокобезопасность.
Таким образом, система типов и ограничения трейтами в Rust гарантируют, что
значение Rc<T> нельзя случайно небезопасно отправить в другой поток. Когда мы
попытались сделать это в листинге 16-14, то получили ошибку
the trait `Send` is not implemented for `Rc<Mutex<i32>>`. А когда перешли
на Arc<T>, который Send реализует, код скомпилировался.
Любой тип, целиком состоящий из типов Send, автоматически тоже помечается как
Send. Почти все примитивные типы — Send, кроме сырых указателей, о которых
мы поговорим в главе 20.
Доступ из нескольких потоков
Трейт-маркер Sync означает, что на значение типа, который его реализует,
безопасно ссылаться из нескольких потоков. Иначе говоря, тип T реализует
Sync, если &T (неизменяемая ссылка на T) реализует Send — то есть ссылку
можно безопасно отправить в другой поток. Как и в случае с Send, все
примитивные типы реализуют Sync, а типы, целиком состоящие из типов с Sync,
тоже реализуют Sync.
Умный указатель Rc<T> не реализует и Sync — по тем же причинам, по которым
не реализует Send. Тип RefCell<T> (о нём мы говорили в главе 15) и
родственные типы семейства Cell<T> тоже не реализуют Sync: проверка
заимствований, которую RefCell<T> выполняет во время работы, не
потокобезопасна. А умный указатель Mutex<T> реализует Sync и годится для
общего доступа из нескольких потоков, как вы видели в разделе «Общий доступ к
Mutex<T>».
Ручная реализация Send и Sync небезопасна
Раз типы, целиком состоящие из других типов с Send и Sync, реализуют Send
и Sync автоматически, реализовывать эти трейты вручную не нужно. Как
трейты-маркеры, они даже не содержат методов. Они нужны лишь для того, чтобы
обеспечивать инварианты, связанные с конкурентностью.
Ручная реализация этих трейтов требует небезопасного кода на Rust. О
небезопасном Rust мы поговорим в главе 20; пока важно понимать, что создание
новых конкурентных типов, которые состоят не из частей с Send и Sync,
требует тщательного обдумывания, чтобы сохранить гарантии безопасности.
Подробнее об этих гарантиях и о том, как их соблюдать, — в «The
Rustonomicon».
Итоги
Это не последняя встреча с конкурентностью в книге: следующая глава посвящена асинхронному программированию, а проект из главы 21 применит понятия этой главы в ситуации, более приближенной к реальной, чем небольшие примеры здесь.
Как уже говорилось, в самом языке Rust очень мало средств конкурентности, поэтому многие решения реализованы в виде крейтов. Они развиваются быстрее стандартной библиотеки, так что обязательно поищите в интернете актуальные современные крейты для многопоточных задач.
Стандартная библиотека Rust даёт каналы для передачи сообщений и умные
указатели вроде Mutex<T> и Arc<T>, которые безопасно использовать в
конкурентном контексте. Система типов и анализатор заимствований гарантируют,
что в коде, использующем эти решения, не будет гонок данных и
недействительных ссылок. Как только код скомпилировался, можно быть спокойным:
он будет прекрасно работать в нескольких потоках — без трудноуловимых багов,
обычных для других языков. Конкурентное программирование больше не нужно
бояться: вперёд — делайте свои программы конкурентными без страха!
Основы асинхронного программирования: async, await, футуры и стримы
Многие операции, которые мы поручаем компьютеру, выполняются небыстро. Было бы хорошо заниматься чем-то другим, пока эти долгие процессы идут. Современные компьютеры умеют работать над несколькими операциями сразу двумя способами: параллелизмом и конкурентностью. Но логику программ мы пишем в основном линейно. Хотелось бы описывать, какие операции программа должна выполнить и в каких местах функция может приостановиться, чтобы вместо неё поработала другая часть программы, — не расписывая заранее точно, в каком порядке и как должен выполняться каждый кусочек кода. Асинхронное программирование (asynchronous programming) — это абстракция, которая позволяет описывать код через возможные точки приостановки и результаты, которые появятся когда-нибудь потом, а все детали координации берёт на себя.
Эта глава опирается на главу 16, где для параллелизма и конкурентности
использовались потоки, и знакомит с другим подходом к написанию кода: футурами
(futures), стримами (streams) и синтаксисом async и await в Rust,
которые позволяют выразить, что операции могут быть асинхронными. А также со
сторонними крейтами, реализующими асинхронные среды выполнения (runtimes) —
код, который управляет выполнением асинхронных операций и координирует его.
Рассмотрим пример. Допустим, вы экспортируете видео с семейного праздника — это может занять от нескольких минут до нескольких часов. Экспорт видео использует столько процессорных и графических мощностей, сколько сможет. Представьте, что у вас всего одно ядро процессора, а операционная система не прерывает экспорт, пока он не закончится, — то есть выполняет его синхронно. Тогда, пока идёт экспорт, вы ничего больше не смогли бы делать на компьютере. Довольно неприятно. К счастью, операционная система может незаметно для вас прерывать экспорт — и прерывает его достаточно часто, чтобы вы параллельно могли заниматься другими делами.
Теперь допустим, вы скачиваете видео, которым кто-то поделился. Это тоже может занять время, но процессорного времени требует немного: процессору приходится ждать, пока данные придут по сети. Читать данные можно начать, как только они начнут поступать, но пока придут все, пройдёт время. И даже когда данные уже на месте, большое видео может загружаться секунду-другую. Звучит немного, но для современного процессора, выполняющего миллиарды операций в секунду, это очень долго. И снова операционная система незаметно прерывает вашу программу, чтобы процессор мог заняться другой работой, пока ждёт ответа сети.
Экспорт видео — пример операции, ограниченной процессором (CPU-bound, или compute-bound): её скорость упирается в то, насколько быстро процессор или видеокарта могут обрабатывать данные и сколько этой мощности можно выделить на операцию. Скачивание видео — пример операции, ограниченной вводом-выводом (I/O-bound): её скорость упирается в скорость ввода и вывода компьютера, и быстрее, чем данные приходят по сети, она не пойдёт.
В обоих примерах незаметные прерывания со стороны операционной системы дают своего рода конкурентность. Но эта конкурентность — только на уровне программы целиком: операционная система прерывает одну программу, чтобы поработали другие. Во многих случаях мы понимаем свою программу гораздо детальнее, чем операционная система, и можем заметить возможности для конкурентности, которых она не видит.
Например, если мы делаем менеджер загрузок, хочется написать программу так, чтобы начало одной загрузки не подвешивало интерфейс и чтобы пользователи могли запускать несколько загрузок одновременно. Однако многие API операционных систем для работы с сетью блокирующие (blocking): они не дают программе двигаться дальше, пока обрабатываемые данные не будут полностью готовы.
Примечание: если подумать, так работает большинство вызовов функций. Но термин блокирующий обычно приберегают для вызовов, которые работают с файлами, сетью и другими ресурсами компьютера: именно в этих случаях отдельной программе выгодно, чтобы операция была _не_блокирующей.
Чтобы не блокировать главный поток, можно запускать отдельный поток для загрузки каждого файла. Но системные ресурсы, которые тратятся на эти потоки, в какой-то момент станут проблемой. Лучше, чтобы вызов вообще не блокировал, а мы могли описать набор задач, которые программа должна выполнить, и позволить среде выполнения самой выбрать наилучший порядок и способ их выполнения.
Именно это и даёт абстракция async (сокращение от asynchronous — асинхронный) в Rust. В этой главе вы узнаете об async всё, что нужно. Мы разберём:
- как пользоваться синтаксисом
asyncиawaitв Rust и выполнять асинхронные функции с помощью среды выполнения; - как с помощью асинхронной модели решать некоторые из тех же задач, что мы рассматривали в главе 16;
- как многопоточность и async дополняют друг друга и как во многих случаях их можно сочетать.
Но прежде чем смотреть, как async работает на практике, нужно ненадолго отвлечься и обсудить разницу между параллелизмом и конкурентностью.
Параллелизм и конкурентность
До сих пор мы считали параллелизм и конкурентность почти синонимами. Теперь их нужно различать точнее: разница проявится, как только мы возьмёмся за работу.
Посмотрим, как команда может разделить работу над программным проектом. Можно поручить одному участнику несколько задач, каждому по одной задаче или сочетать оба подхода.
Когда один человек работает над несколькими задачами, прежде чем закончить хотя бы одну, — это конкурентность (concurrency). Один из вариантов — держать на компьютере два разных проекта и, когда надоест или застрянешь в одном, переключаться на другой. Вы один человек, так что продвигаться в обеих задачах ровно одновременно не можете, но можете работать в режиме многозадачности: продвигаться то в одной, то в другой, переключаясь между ними (рисунок 17-1).
Когда команда делит набор задач так, что каждый участник берёт одну задачу и работает над ней сам, — это параллелизм (parallelism). Все члены команды могут продвигаться одновременно (рисунок 17-2).
В обоих случаях задачи, возможно, придётся согласовывать. Вы думали, что задача, порученная одному человеку, совершенно независима от остальных, а оказалось, что сначала свою задачу должен закончить другой член команды. Часть работы можно было делать параллельно, а часть на самом деле была последовательной (serial): её можно было делать только по очереди, одну задачу за другой, как на рисунке 17-3.
Точно так же может оказаться, что одна ваша задача зависит от другой вашей же задачи. Тогда и конкурентная работа становится последовательной.
Параллелизм и конкурентность могут и пересекаться. Если вы узнаете, что коллега застрял, пока вы не закончите одну из своих задач, вы, скорее всего, бросите все силы на неё, чтобы «разблокировать» коллегу. Тогда вы с коллегой уже не можете работать параллельно, а вы сами — конкурентно над своими задачами.
Те же законы действуют и в программах, и в железе. На компьютере с одним ядром процессор может выполнять только одну операцию за раз, но всё равно может работать конкурентно. С помощью потоков, процессов и async компьютер может приостановить одно занятие, переключиться на другие, а потом вернуться к первому. А на компьютере с несколькими ядрами работа может идти и параллельно: одно ядро выполняет одну задачу, другое — совершенно не связанную с ней, и эти операции действительно происходят одновременно.
Асинхронный код в Rust обычно выполняется конкурентно. В зависимости от железа, операционной системы и используемой асинхронной среды выполнения (о них — совсем скоро) под капотом эта конкурентность может использовать и параллелизм.
А теперь погрузимся в то, как на самом деле устроено асинхронное программирование в Rust.
Футуры и синтаксис async
Футуры и синтаксис async
Ключевые элементы асинхронного программирования в Rust — футуры (futures)
и ключевые слова async и await.
Футура — это значение, которое, может быть, ещё не готово сейчас, но будет
готово когда-нибудь в будущем. (Та же идея есть во многих языках, иногда под
другими названиями — например, task или promise.) В Rust есть трейт
Future — строительный блок, благодаря которому разные асинхронные операции
можно реализовывать разными структурами данных, но с общим интерфейсом. В Rust
футуры — это типы, реализующие трейт Future. Каждая футура сама хранит
сведения о том, насколько она продвинулась и что для неё значит «готово».
Ключевое слово async можно применять к блокам и функциям, чтобы указать, что
их выполнение может прерываться и возобновляться. Внутри асинхронного блока или
асинхронной функции можно использовать ключевое слово await, чтобы
дождаться футуры (await a future) — то есть подождать, пока она станет
готовой. Каждое место, где асинхронный блок или функция ждёт футуру, — это
потенциальная точка, где их выполнение может приостановиться и потом
возобновиться. Проверка, не готово ли уже значение футуры, называется
опросом (polling).
В некоторых других языках, например в C# и JavaScript, тоже есть ключевые слова
async и await для асинхронного программирования. Если вы с ними знакомы,
то увидите серьёзные отличия в том, как этот синтаксис устроен в Rust. И на то
есть веские причины, как мы увидим!
Когда мы пишем асинхронный код на Rust, то чаще всего используем async и
await. Rust компилирует их в равнозначный код с трейтом Future — примерно
так же, как циклы for компилируются в равнозначный код с трейтом Iterator.
Но раз трейт Future есть в языке, при необходимости его можно реализовать и
для своих типов данных. Многие функции, которые встретятся нам в этой главе,
возвращают типы с собственными реализациями Future. В конце главы мы
вернёмся к определению этого трейта и разберём подробнее, как он работает, а
пока этого достаточно, чтобы двигаться дальше.
Всё это может показаться абстрактным, поэтому напишем первую асинхронную программу — маленький веб-скрейпер. Мы передадим в командной строке два URL, конкурентно загрузим обе страницы и вернём результат той, что закончит первой. В этом примере будет немало нового синтаксиса, но не волнуйтесь — всё, что нужно, объясним по ходу дела.
Первая асинхронная программа
Чтобы в этой главе сосредоточиться на изучении async, а не жонглировать
частями экосистемы, мы сделали крейт trpl (сокращение от «The Rust
Programming Language»). Он реэкспортирует все нужные типы, трейты и функции —
в основном из крейтов futures и
tokio. Крейт futures — официальная площадка для
экспериментов с асинхронным кодом в Rust; именно там изначально и
проектировался трейт Future. Tokio — самая популярная сегодня асинхронная
среда выполнения в Rust, особенно для веб-приложений. Есть и другие отличные
среды выполнения, и, возможно, для ваших задач они подойдут лучше. Под
капотом trpl мы используем tokio, потому что он хорошо протестирован и
широко распространён.
Иногда trpl ещё и переименовывает или оборачивает исходные API, чтобы вы
могли сосредоточиться на деталях, важных для этой главы. Если хотите понять,
что делает этот крейт, загляните в его исходный код. Там видно,
из какого крейта взят каждый реэкспорт, а подробные комментарии объясняют, что
делает крейт.
Создайте новый бинарный проект hello-async и добавьте в зависимости крейт
trpl:
$ cargo new hello-async
$ cd hello-async
$ cargo add trpl
Теперь с помощью того, что даёт trpl, можно написать первую асинхронную
программу. Сделаем небольшую утилиту командной строки, которая загружает две
веб-страницы, достаёт из каждой элемент <title> и выводит заголовок той
страницы, для которой весь этот процесс закончится первым.
Функция page_title
Начнём с функции, которая принимает параметром URL страницы, отправляет на
него запрос и возвращает текст элемента <title> (листинг 17-1).
extern crate trpl; // нужно для mdbook test
fn main() {
// TODO: допишем дальше!
}
use trpl::Html;
async fn page_title(url: &str) -> Option<String> {
let response = trpl::get(url).await;
let response_text = response.text().await;
Html::parse(&response_text)
.select_first("title")
.map(|title| title.inner_html())
}Сначала мы определяем функцию page_title и помечаем её ключевым словом
async. Затем с помощью функции trpl::get загружаем переданный URL и
добавляем ключевое слово await, чтобы дождаться ответа. Чтобы получить текст
ответа response, вызываем его метод text и снова ждём результат через
await. Оба шага асинхронные. В случае get нужно дождаться, пока сервер
пришлёт первую часть ответа: HTTP-заголовки, cookie и прочее — она может
прийти отдельно от тела ответа. А тело, особенно большое, может приходить
долго. Нам нужно дождаться ответа целиком, поэтому метод text тоже
асинхронный.
Обе футуры нужно явно ждать через await, потому что футуры в Rust ленивые
(lazy): они ничего не делают, пока вы не попросите их об этом ключевым словом
await. (Более того, если футуру не использовать, Rust выдаст предупреждение.)
Это может напомнить вам разговор об итераторах в разделе «Обработка
последовательностей итераторами» главы 13.
Итераторы ничего не делают, пока не вызван их метод next — напрямую или через
циклы for и методы вроде map, которые используют next под капотом. Так и
футуры ничего не делают, пока вы явно их об этом не попросите. Благодаря этой
ленивости Rust не выполняет асинхронный код, пока он действительно не нужен.
Примечание: это отличается от поведения thread::spawn в разделе
«Создание потока через spawn» главы 16, где
замыкание, переданное в другой поток, начинало выполняться сразу. И от того,
как устроена асинхронность во многих других языках, — тоже. Но для Rust это
важно, чтобы он мог давать свои гарантии производительности, — как и в случае
итераторов.
Получив response_text, мы разбираем его в экземпляр типа Html с помощью
Html::parse. Вместо «сырой» строки у нас теперь тип данных, позволяющий
работать с HTML как с более богатой структурой. В частности, методом
select_first можно найти первый элемент, подходящий под CSS-селектор.
Передав строку "title", получим первый элемент <title> в документе, если он
есть. Подходящего элемента может и не быть, поэтому select_first возвращает
Option<ElementRef>. Наконец, мы вызываем метод Option::map, который
позволяет поработать с элементом внутри Option, если он есть, и ничего не
делать, если нет. (Можно было использовать и выражение match, но map
идиоматичнее.) В теле функции, которую мы передаём в map, вызываем у title
метод inner_html, чтобы получить его содержимое типа String. В итоге у нас
получается Option<String>.
Обратите внимание: в Rust ключевое слово await пишется после выражения,
которое мы ждём, а не перед ним. То есть это постфиксное ключевое слово. Если
вы пользовались async в других языках, это может быть непривычно, но в Rust
так гораздо удобнее строить цепочки методов. Поэтому тело page_title можно
переписать, соединив вызовы trpl::get и text в цепочку с await между ними,
как в листинге 17-2.
extern crate trpl; // нужно для mdbook test
use trpl::Html;
fn main() {
// TODO: допишем дальше!
}
async fn page_title(url: &str) -> Option<String> {
let response_text = trpl::get(url).await.text().await;
Html::parse(&response_text)
.select_first("title")
.map(|title| title.inner_html())
}awaitВот мы и написали первую асинхронную функцию! Прежде чем добавить в main код,
который её вызывает, поговорим ещё немного о том, что мы написали и что это
значит.
Когда Rust видит блок, помеченный ключевым словом async, он компилирует его
в уникальный анонимный тип данных, реализующий трейт Future. А когда видит
функцию, помеченную async, компилирует её в обычную (не асинхронную)
функцию, телом которой служит асинхронный блок. Возвращаемый тип асинхронной
функции — тот анонимный тип, который компилятор создаёт для этого асинхронного
блока.
Таким образом, написать async fn — всё равно что написать функцию, которая
возвращает футуру возвращаемого типа. Для компилятора определение вроде
async fn page_title из листинга 17-1 примерно равнозначно такой обычной
функции:
#![allow(unused)]
fn main() {
extern crate trpl; // required for mdbook test
use std::future::Future;
use trpl::Html;
fn page_title(url: &str) -> impl Future<Output = Option<String>> {
async move {
let text = trpl::get(url).await.text().await;
Html::parse(&text)
.select_first("title")
.map(|title| title.inner_html())
}
}
}Разберём каждую часть этой преобразованной версии:
- Используется синтаксис
impl Trait, который мы обсуждали в главе 10 в разделе «Трейты как параметры». - Возвращаемое значение реализует трейт
Futureс ассоциированным типомOutput. Заметьте, что типOutput—Option<String>, то есть тот же, что и возвращаемый тип исходной версииpage_titleсasync fn. - Весь код из тела исходной функции обёрнут в блок
async move. Помните, что блоки — это выражения. Весь этот блок и есть выражение, которое возвращает функция. - Этот асинхронный блок выдаёт значение типа
Option<String>, как только что было сказано. Оно совпадает с типомOutputв возвращаемом типе. Всё как с другими блоками, которые вы уже видели. - Новое тело функции — блок
async moveиз-за того, как в нём используется параметрurl. (Обasyncиasync moveмы подробно поговорим дальше в главе.)
Теперь можно вызвать page_title в main.
Запуск асинхронной функции в среде выполнения
Для начала получим заголовок одной страницы — листинг 17-3. К сожалению, этот код пока не компилируется.
extern crate trpl; // нужно для mdbook test
use trpl::Html;
async fn main() {
let args: Vec<String> = std::env::args().collect();
let url = &args[1];
match page_title(url).await {
Some(title) => println!("The title for {url} was {title}"),
None => println!("{url} had no title"),
}
}
async fn page_title(url: &str) -> Option<String> {
let response_text = trpl::get(url).await.text().await;
Html::parse(&response_text)
.select_first("title")
.map(|title| title.inner_html())
}page_title из main с аргументом, который передал пользовательАргументы командной строки мы получаем так же, как в разделе «Аргументы
командной строки» главы 12. Затем передаём аргумент с
URL в page_title и ждём результат. Футура выдаёт Option<String>, поэтому
выражением match выводим разные сообщения в зависимости от того, был ли у
страницы <title>.
Но ключевое слово await можно использовать только в асинхронных функциях или
блоках, а помечать особую функцию main как async Rust не позволяет.
error[E0752]: `main` function is not allowed to be `async`
--> src/main.rs:6:1
|
6 | async fn main() {
| ^^^^^^^^^^^^^^^ `main` function is not allowed to be `async`
main нельзя пометить async, потому что асинхронному коду нужна среда
выполнения (runtime) — крейт Rust, который берёт на себя все детали
выполнения асинхронного кода. Функция main может инициализировать среду
выполнения, но сама ею не является. (Почему так — разберёмся чуть позже.) В
каждой программе на Rust, выполняющей асинхронный код, есть хотя бы одно место,
где создаётся среда выполнения, которая и выполняет футуры.
Большинство языков с поддержкой асинхронности поставляют среду выполнения вместе с языком, а Rust — нет. Вместо этого есть множество разных асинхронных сред выполнения, и в каждой свои компромиссы, подходящие под свою задачу. Например, у высоконагруженного веб-сервера с множеством ядер и большим объёмом памяти совсем другие потребности, чем у микроконтроллера с одним ядром, небольшим объёмом памяти и без возможности выделять память в куче. Крейты, предоставляющие такие среды выполнения, часто дают и асинхронные версии распространённой функциональности, например файлового и сетевого ввода-вывода.
Здесь и до конца главы мы будем использовать функцию block_on из крейта
trpl. Она принимает аргументом футуру и блокирует текущий поток, пока эта
футура не выполнится до конца. За кулисами вызов block_on создаёт с помощью
крейта tokio среду выполнения, в которой и выполняется переданная футура
(функция block_on из trpl ведёт себя так же, как функции block_on из
других крейтов сред выполнения). Когда футура завершается, block_on
возвращает выданное ею значение.
Можно было бы передать в block_on футуру, которую вернула page_title,
напрямую, а когда она завершится — сопоставить полученный Option<String>, как
мы пытались в листинге 17-3. Но в большинстве примеров главы (и в
большинстве реального асинхронного кода) вызовов асинхронных функций будет
больше одного. Поэтому мы передадим блок async и внутри явно дождёмся
результата page_title, как в листинге 17-4.
extern crate trpl; // нужно для mdbook test
use trpl::Html;
fn main() {
let args: Vec<String> = std::env::args().collect();
trpl::block_on(async {
let url = &args[1];
match page_title(url).await {
Some(title) => println!("The title for {url} was {title}"),
None => println!("{url} had no title"),
}
})
}
async fn page_title(url: &str) -> Option<String> {
let response_text = trpl::get(url).await.text().await;
Html::parse(&response_text)
.select_first("title")
.map(|title| title.inner_html())
}trpl::block_onЗапустив этот код, получаем то поведение, которого и ожидали:
$ cargo run -- "https://www.rust-lang.org"
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.05s
Running `target/debug/async_await 'https://www.rust-lang.org'`
The title for https://www.rust-lang.org was
Rust Programming Language
Уф, наконец-то у нас есть работающий асинхронный код! Но прежде чем добавить код, который устроит гонку двух сайтов, ненадолго вернёмся к тому, как работают футуры.
Каждая точка ожидания (await point) — то есть каждое место, где в коде
стоит await, — это место, где управление возвращается среде выполнения. Чтобы
это работало, Rust должен отслеживать состояние асинхронного блока: тогда среда
выполнения может запустить другую работу, а потом вернуться и снова попытаться
продвинуть первую. Получается невидимый конечный автомат — как если бы вы
написали перечисление вроде такого, чтобы сохранять текущее состояние в каждой
точке ожидания:
#![allow(unused)]
fn main() {
extern crate trpl; // нужно для mdbook test
enum PageTitleFuture<'a> {
Initial { url: &'a str },
GetAwaitPoint { url: &'a str },
TextAwaitPoint { response: trpl::Response },
}
}Писать вручную код переходов между состояниями было бы утомительно, и в нём легко ошибиться — особенно когда позже нужно добавить в код больше функциональности и состояний. К счастью, компилятор Rust сам создаёт структуры данных конечного автомата для асинхронного кода и управляет ими. Обычные правила заимствования и владения для структур данных при этом по-прежнему действуют: компилятор сам их проверяет и выдаёт полезные сообщения об ошибках. Некоторые из них мы разберём дальше в главе.
В конечном счёте этот конечный автомат кто-то должен выполнять, и этот «кто-то» — среда выполнения. (Поэтому, изучая среды выполнения, вы можете встретить упоминания исполнителей (executors): исполнитель — та часть среды выполнения, которая отвечает за выполнение асинхронного кода.)
Теперь понятно, почему компилятор не дал сделать саму main асинхронной
функцией в листинге 17-3. Если бы main была асинхронной, кому-то другому
пришлось бы управлять конечным автоматом футуры, которую возвращает main, а
ведь main — это точка входа в программу! Поэтому мы вызвали в main функцию
trpl::block_on, чтобы создать среду выполнения и выполнить до конца футуру,
которую возвращает блок async.
Примечание: некоторые среды выполнения предоставляют макросы, с которыми
асинхронную main написать можно. Эти макросы переписывают
async fn main() { ... } в обычную fn main, которая делает то же, что мы
сделали вручную в листинге 17-4: вызывает функцию, выполняющую футуру до
конца, как trpl::block_on.
Теперь соберём всё вместе и посмотрим, как писать конкурентный код.
Гонка двух URL
В листинге 17-5 мы вызываем page_title для двух разных URL, переданных в
командной строке, и устраиваем между ними гонку: берём ту футуру, которая
закончит первой.
extern crate trpl; // нужно для mdbook test
use trpl::{Either, Html};
fn main() {
let args: Vec<String> = std::env::args().collect();
trpl::block_on(async {
let title_fut_1 = page_title(&args[1]);
let title_fut_2 = page_title(&args[2]);
let (url, maybe_title) =
match trpl::select(title_fut_1, title_fut_2).await {
Either::Left(left) => left,
Either::Right(right) => right,
};
println!("{url} returned first");
match maybe_title {
Some(title) => println!("Its page title was: '{title}'"),
None => println!("It had no title."),
}
})
}
async fn page_title(url: &str) -> (&str, Option<String>) {
let response_text = trpl::get(url).await.text().await;
let title = Html::parse(&response_text)
.select_first("title")
.map(|title| title.inner_html());
(url, title)
}page_title для двух URL и смотрим, какой вернётся первымСначала вызываем page_title для каждого из переданных пользователем URL и
сохраняем получившиеся футуры в title_fut_1 и title_fut_2. Помните: пока
они ничего не делают — футуры ленивые, а мы их ещё не ждали. Затем передаём
футуры в trpl::select, которая возвращает значение, показывающее, какая из
переданных ей футур завершилась первой.
Примечание: под капотом trpl::select построена на более общей функции
select из крейта futures. Функция select из futures умеет многое, чего
не умеет trpl::select, но она и сложнее — эту сложность пока можно
пропустить.
Выиграть может любая из футур, так что возвращать Result бессмысленно.
Вместо этого trpl::select возвращает тип, которого мы ещё не видели, —
trpl::Either. Тип Either чем-то похож на Result: у него тоже два случая. Но,
в отличие от Result, в Either нет понятия успеха или неудачи. Вместо этого
он использует Left и Right — «то или другое»:
#![allow(unused)]
fn main() {
enum Either<A, B> {
Left(A),
Right(B),
}
}Функция select возвращает Left с результатом первой футуры, если выиграла
она, и Right с результатом второй, если выиграла та. Это соответствует
порядку аргументов при вызове функции: первый аргумент стоит левее второго.
Ещё мы изменили page_title так, чтобы она возвращала и переданный ей URL.
Тогда, даже если у страницы, ответившей первой, не найдётся <title>, мы всё
равно сможем вывести осмысленное сообщение. Имея эту информацию, мы в
завершение обновляем вывод println!, чтобы показать, какой URL закончил
первым и какой <title> (если он есть) у страницы по этому URL.
Теперь у вас есть маленький работающий веб-скрейпер! Выберите пару URL и запустите утилиту. Возможно, вы обнаружите, что некоторые сайты стабильно быстрее других, а в других случаях более быстрый сайт меняется от запуска к запуску. А главное — вы освоили основы работы с футурами, и теперь можно глубже разобраться, что можно делать с async.
Конкурентность с помощью async
Конкурентность с помощью async
В этом разделе мы применим async к некоторым из тех же задач конкурентности, которые решали с помощью потоков в главе 16. Многие ключевые идеи мы уже обсудили там, поэтому здесь сосредоточимся на том, чем потоки отличаются от футур.
Во многих случаях API для конкурентности на основе async очень похожи на API для потоков. В других — заметно отличаются. И даже когда API потоков и async выглядят похоже, ведут они себя часто по-разному — и почти всегда у них разные характеристики производительности.
Создание задачи с помощью spawn_task
Первое, что мы делали в разделе «Создание потока через
spawn» главы 16, — считали в двух отдельных
потоках. Сделаем то же самое с async. Крейт trpl даёт функцию spawn_task,
очень похожую на API thread::spawn, и функцию sleep — асинхронную версию
thread::sleep. С их помощью можно реализовать пример со счётом, как в
листинге 17-6.
extern crate trpl; // нужно для mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
trpl::spawn_task(async {
for i in 1..10 {
println!("hi number {i} from the first task!");
trpl::sleep(Duration::from_millis(500)).await;
}
});
for i in 1..5 {
println!("hi number {i} from the second task!");
trpl::sleep(Duration::from_millis(500)).await;
}
});
}Для начала оборачиваем код функции main в trpl::block_on, чтобы функция
верхнего уровня могла быть асинхронной.
Примечание: дальше в этой главе в каждом примере будет точно такой же
обёрточный код с trpl::block_on в main, поэтому мы часто будем его
опускать — так же, как опускаем саму main. Не забывайте добавлять его в
свой код!
Затем пишем внутри блока два цикла, в каждом из которых вызов trpl::sleep
ждёт полсекунды (500 миллисекунд) перед отправкой следующего сообщения. Один
цикл помещаем в тело trpl::spawn_task, другой — в цикл for на верхнем
уровне. И добавляем await после вызовов sleep.
Этот код ведёт себя похоже на реализацию с потоками — в том числе сообщения у вас в терминале могут появляться в другом порядке:
hi number 1 from the second task!
hi number 1 from the first task!
hi number 2 from the first task!
hi number 2 from the second task!
hi number 3 from the first task!
hi number 3 from the second task!
hi number 4 from the first task!
hi number 4 from the second task!
hi number 5 from the first task!
Эта версия останавливается, как только заканчивается цикл for в теле
главного асинхронного блока: задача, порождённая spawn_task, завершается
вместе с функцией main. Чтобы задача отработала до конца, нужно дождаться её
через дескриптор. С потоками мы «блокировались» методом join, пока поток не
закончит работу. В листинге 17-7 то же самое можно сделать через await: сам
дескриптор задачи — это футура. Её тип Output — Result, так что после
ожидания мы ещё и разворачиваем его через unwrap.
extern crate trpl; // нужно для mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let handle = trpl::spawn_task(async {
for i in 1..10 {
println!("hi number {i} from the first task!");
trpl::sleep(Duration::from_millis(500)).await;
}
});
for i in 1..5 {
println!("hi number {i} from the second task!");
trpl::sleep(Duration::from_millis(500)).await;
}
handle.await.unwrap();
});
}await, чтобы задача выполнилась до концаОбновлённая версия работает, пока не закончатся оба цикла:
hi number 1 from the second task!
hi number 1 from the first task!
hi number 2 from the first task!
hi number 2 from the second task!
hi number 3 from the first task!
hi number 3 from the second task!
hi number 4 from the first task!
hi number 4 from the second task!
hi number 5 from the first task!
hi number 6 from the first task!
hi number 7 from the first task!
hi number 8 from the first task!
hi number 9 from the first task!
Пока похоже, что async и потоки дают одинаковый результат, только синтаксис
другой: вместо вызова join у дескриптора — await, и вызовы sleep тоже
ждём через await.
Главное же отличие в том, что для этого не понадобилось создавать ещё один
поток операционной системы. Более того, здесь не нужно создавать даже задачу.
Асинхронные блоки компилируются в анонимные футуры, поэтому можно поместить
каждый цикл в асинхронный блок и попросить среду выполнения выполнить оба до
конца с помощью функции trpl::join.
В разделе «Ждём завершения всех потоков» главы 16
мы показали, как вызывать метод join у типа JoinHandle, который возвращает
std::thread::spawn. Функция trpl::join похожа на него, только для футур.
Если передать ей две футуры, она создаст одну новую. Эта новая футура
завершается, когда завершатся обе переданные, и выдаёт кортеж с их
результатами.
Поэтому в листинге 17-8 мы с помощью trpl::join ждём завершения и fut1, и
fut2. Ждём мы при этом не сами fut1 и fut2, а новую футуру, которую
создала trpl::join. Результат мы игнорируем: это просто кортеж из двух
единичных значений.
extern crate trpl; // нужно для mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let fut1 = async {
for i in 1..10 {
println!("hi number {i} from the first task!");
trpl::sleep(Duration::from_millis(500)).await;
}
};
let fut2 = async {
for i in 1..5 {
println!("hi number {i} from the second task!");
trpl::sleep(Duration::from_millis(500)).await;
}
};
trpl::join(fut1, fut2).await;
});
}trpl::joinЗапустив код, увидим, что обе футуры выполняются до конца:
hi number 1 from the first task!
hi number 1 from the second task!
hi number 2 from the first task!
hi number 2 from the second task!
hi number 3 from the first task!
hi number 3 from the second task!
hi number 4 from the first task!
hi number 4 from the second task!
hi number 5 from the first task!
hi number 6 from the first task!
hi number 7 from the first task!
hi number 8 from the first task!
hi number 9 from the first task!
Теперь порядок каждый раз будет одинаковым — совсем не то, что мы видели с
потоками и с trpl::spawn_task в листинге 17-7. Дело в том, что функция
trpl::join справедливая (fair): она проверяет каждую футуру одинаково
часто, чередуя их, и никогда не даёт одной вырваться вперёд, если другая
готова. С потоками решает операционная система — какой поток проверить и
сколько дать ему поработать. В асинхронном Rust решает среда выполнения —
какую задачу проверить. (На практике всё сложнее: асинхронная среда выполнения
может под капотом использовать потоки операционной системы для управления
конкурентностью, так что гарантировать справедливость ей бывает труднее — но
всё же возможно!) Среды выполнения не обязаны гарантировать справедливость для
каждой операции и часто дают разные API, позволяя выбрать, нужна ли вам
справедливость.
Попробуйте разные варианты ожидания футур и посмотрите, что получится:
- уберите асинхронный блок вокруг одного или обоих циклов;
- ждите каждый асинхронный блок сразу после его определения;
- оберните в асинхронный блок только первый цикл, а получившуюся футуру ждите после тела второго цикла.
А в качестве дополнительного упражнения попробуйте угадать вывод в каждом случае до запуска кода!
Передача данных между задачами через сообщения
Обмен данными между футурами тоже будет знакомым: снова воспользуемся передачей сообщений, но на этот раз с асинхронными версиями типов и функций. Мы пойдём немного другим путём, чем в разделе «Передача данных между потоками через сообщения» главы 16, чтобы показать ключевые различия между конкурентностью на потоках и на футурах. В листинге 17-9 начнём с одного асинхронного блока — не порождая отдельную задачу, как порождали отдельный поток.
extern crate trpl; // нужно для mdbook test
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let val = String::from("hi");
tx.send(val).unwrap();
let received = rx.recv().await.unwrap();
println!("received '{received}'");
});
}tx и rxЗдесь используется trpl::channel — асинхронная версия API канала «много
производителей, один потребитель», которым мы пользовались с потоками в главе
16. Асинхронная версия API лишь немного отличается от версии для потоков:
приёмник rx здесь изменяемый, а метод recv возвращает футуру, которую нужно
дождаться, а не само значение. Теперь можно отправлять сообщения от отправителя
к приёмнику. Заметьте: ни отдельного потока, ни даже задачи порождать не нужно —
достаточно дождаться вызова rx.recv.
Синхронный метод Receiver::recv из std::mpsc::channel блокирует поток, пока
не получит сообщение. А trpl::Receiver::recv — нет, потому что он
асинхронный. Вместо блокировки он возвращает управление среде выполнения, пока
не придёт сообщение или пока не закроется отправляющая сторона канала. Вызов
send, напротив, мы не ждём, потому что он не блокирует. Ему это и не нужно:
канал, в который мы отправляем, неограниченный (unbounded).
Примечание: весь этот асинхронный код выполняется в асинхронном блоке внутри
вызова trpl::block_on, поэтому всё внутри него может обходиться без
блокировок. А вот код снаружи будет заблокирован, пока функция block_on не
вернёт результат. В этом и смысл trpl::block_on: она позволяет выбрать,
где блокироваться на наборе асинхронного кода, а значит, где проходит граница
между синхронным и асинхронным кодом.
Обратите внимание на две вещи в этом примере. Во-первых, сообщение придёт сразу же. Во-вторых, хотя здесь используется футура, никакой конкурентности пока нет. Всё в листинге происходит последовательно — точно так же, как если бы никаких футур не было.
Займёмся первым: отправим серию сообщений с паузами между ними, как в листинге 17-10.
extern crate trpl; // нужно для mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_millis(500)).await;
}
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
});
}awaitСообщения нужно не только отправить, но и получить. Здесь мы знаем, сколько
придёт сообщений, так что можно было бы вручную четыре раза вызвать
rx.recv().await. Но в реальности обычно ждёшь заранее неизвестное число
сообщений, и ждать нужно, пока не станет ясно, что сообщений больше не будет.
В листинге 16-10 мы обрабатывали все элементы, полученные из синхронного
канала, циклом for. Но для последовательности элементов, которые появляются
асинхронно, цикла for в Rust пока нет, поэтому понадобится цикл, которого мы
ещё не видели, — условный цикл while let. Это циклическая версия конструкции
if let из раздела «Краткое управление потоком: if let и
let...else» главы 6. Цикл выполняется, пока
указанный в нём образец продолжает совпадать со значением.
Вызов rx.recv возвращает футуру, которую мы ждём. Среда выполнения
приостанавливает футуру, пока та не будет готова. Каждый раз, когда приходит
сообщение, футура разрешается в Some(message). Когда канал закрывается —
неважно, пришло ли хоть одно сообщение, — футура разрешается в None: это
значит, что значений больше нет и опрашивать (то есть ждать) больше не нужно.
Цикл while let сводит всё это вместе. Если результат rx.recv().await —
Some(message), мы получаем сообщение и можем использовать его в теле цикла,
как с if let. Если результат — None, цикл заканчивается. На каждом новом
витке цикл снова доходит до точки ожидания, и среда выполнения снова
приостанавливает его до прихода следующего сообщения.
Теперь код успешно отправляет и получает все сообщения. К сожалению, осталась пара проблем. Во-первых, сообщения приходят не с интервалом в полсекунды, а все сразу — через 2 секунды (2000 миллисекунд) после запуска программы. Во-вторых, программа никогда не завершается! Она вечно ждёт новых сообщений. Остановить её придётся сочетанием ctrl-C.
Код внутри одного асинхронного блока выполняется последовательно
Начнём с того, почему сообщения приходят все сразу после общей задержки, а не
с паузами между ними. Внутри одного асинхронного блока порядок, в котором
await стоят в коде, — это и порядок их выполнения при работе программы.
В листинге 17-10 всего один асинхронный блок, поэтому всё в нём выполняется
последовательно. Конкурентности по-прежнему нет. Сначала выполняются все вызовы
tx.send вперемешку со всеми вызовами trpl::sleep и их точками ожидания. И
только потом цикл while let добирается до точек ожидания на вызовах recv.
Чтобы получить нужное поведение — паузу между сообщениями, — операции с tx и
rx нужно разнести по отдельным асинхронным блокам, как в листинге 17-11. Тогда
среда выполнения сможет выполнять их по отдельности с помощью trpl::join, как
в листинге 17-8. И снова ждём мы результат вызова trpl::join, а не отдельные
футуры. Если бы мы ждали отдельные футуры по очереди, то просто вернулись бы к
последовательному выполнению — ровно к тому, чего пытаемся избежать.
extern crate trpl; // нужно для mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let tx_fut = async {
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_millis(500)).await;
}
};
let rx_fut = async {
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
};
trpl::join(tx_fut, rx_fut).await;
});
}send и recv по отдельным блокам async и ждём футуры этих блоковС обновлённым кодом из листинга 17-11 сообщения выводятся с интервалом в 500 миллисекунд, а не все разом через 2 секунды.
Перемещение владения в асинхронный блок
Но программа по-прежнему не завершается — из-за того, как цикл while let
взаимодействует с trpl::join:
- Футура, которую возвращает
trpl::join, завершается только тогда, когда завершились обе переданные ей футуры. - Футура
tx_futзавершается, когда заканчивается пауза после отправки последнего сообщения изvals. - Футура
rx_futне завершится, пока не закончится циклwhile let. - Цикл
while letне закончится, пока ожиданиеrx.recvне вернётNone. - Ожидание
rx.recvвернётNone, только когда другой конец канала закроется. - Канал закроется, только если вызвать
rx.closeили когда будет уничтожена отправляющая сторона,tx. rx.closeмы нигде не вызываем, аtxне будет уничтожен, пока не закончится самый внешний асинхронный блок, переданный вtrpl::block_on.- А этот блок не может закончиться, потому что заблокирован в ожидании
trpl::join— и мы возвращаемся к началу списка.
Сейчас асинхронный блок, в котором мы отправляем сообщения, лишь
заимствует tx: для отправки сообщения владение не нужно. Но если бы мы
переместили tx в этот асинхронный блок, он уничтожался бы, как только блок
заканчивается. В разделе «Захват ссылок или перемещение
владения» главы 13 вы научились использовать
ключевое слово move с замыканиями, а в разделе «Замыкания move и
потоки» главы 16 мы говорили, что при работе с
потоками данные часто нужно перемещать в замыкания. С асинхронными блоками
действует то же самое, поэтому ключевое слово move работает с асинхронными
блоками так же, как с замыканиями.
В листинге 17-12 мы меняем блок, отправляющий сообщения, с async на
async move.
extern crate trpl; // нужно для mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let tx_fut = async move {
// --пропуск--
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_millis(500)).await;
}
};
let rx_fut = async {
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
};
trpl::join(tx_fut, rx_fut).await;
});
}Эта версия кода аккуратно завершается после того, как последнее сообщение отправлено и получено. Теперь посмотрим, что нужно изменить, чтобы данные отправляли несколько футур.
Объединение нескольких футур макросом join!
Этот асинхронный канал тоже поддерживает нескольких производителей, так что,
чтобы отправлять сообщения из нескольких футур, можно вызвать clone у tx,
как в листинге 17-13.
extern crate trpl; // нужно для mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let tx1 = tx.clone();
let tx1_fut = async move {
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx1.send(val).unwrap();
trpl::sleep(Duration::from_millis(500)).await;
}
};
let rx_fut = async {
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
};
let tx_fut = async move {
let vals = vec![
String::from("more"),
String::from("messages"),
String::from("for"),
String::from("you"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_millis(1500)).await;
}
};
trpl::join!(tx1_fut, tx_fut, rx_fut);
});
}Сначала клонируем tx, создавая tx1 за пределами первого асинхронного блока,
и перемещаем tx1 в этот блок — как раньше tx. Затем перемещаем исходный tx
в новый асинхронный блок, где отправляем ещё сообщения с чуть большей
задержкой. Мы поставили этот новый блок после блока приёма сообщений, но он мог
бы стоять и до него. Важен порядок, в котором мы ждём футуры, а не порядок,
в котором их создаём.
Оба отправляющих асинхронных блока должны быть блоками async move, чтобы и
tx, и tx1 уничтожались, когда эти блоки заканчиваются. Иначе мы снова
окажемся в том же бесконечном цикле, с которого начинали.
Наконец, переходим с trpl::join на trpl::join!, чтобы справиться с ещё одной
футурой: макрос join! ждёт произвольное количество футур, если их число
известно при компиляции. Как ждать коллекцию из заранее неизвестного числа
футур, мы обсудим дальше в этой главе.
Теперь мы видим все сообщения от обеих отправляющих футур, а поскольку после отправки они ждут немного разное время, сообщения и приходят с разными интервалами:
received 'hi'
received 'more'
received 'from'
received 'the'
received 'messages'
received 'future'
received 'for'
received 'you'
Мы разобрали, как передавать данные между футурами через сообщения, как последовательно выполняется код внутри асинхронного блока, как перемещать владение в асинхронный блок и как объединять несколько футур. Дальше поговорим о том, как и зачем сообщать среде выполнения, что она может переключиться на другую задачу.
Работа с любым числом футур
Передача управления среде выполнения
Вспомните из раздела «Первая асинхронная программа»: в каждой точке ожидания Rust даёт среде выполнения возможность приостановить задачу и переключиться на другую, если ожидаемая футура ещё не готова. Верно и обратное: Rust приостанавливает асинхронные блоки и возвращает управление среде выполнения только в точках ожидания. Всё, что между точками ожидания, выполняется синхронно.
Значит, если в асинхронном блоке выполняется много работы без единой точки ожидания, эта футура не даст продвигаться никаким другим футурам. Иногда говорят, что одна футура морит голодом (starving) остальные. Порой в этом нет ничего страшного. Но если вы выполняете какую-то дорогую подготовку или долгую работу либо у вас есть футура, которая бесконечно выполняет какую-то задачу, нужно продумать, когда и где возвращать управление среде выполнения.
Сымитируем долгую операцию, чтобы показать проблему «голодания», а потом
разберёмся, как её решить. В листинге 17-14 появляется функция slow.
extern crate trpl; // нужно для mdbook test
use std::{thread, time::Duration};
fn main() {
trpl::block_on(async {
// Позже здесь будем вызывать `slow`
});
}
fn slow(name: &str, ms: u64) {
thread::sleep(Duration::from_millis(ms));
println!("'{name}' ran for {ms}ms");
}thread::sleepЗдесь используется std::thread::sleep, а не trpl::sleep, так что вызов slow
блокирует текущий поток на заданное число миллисекунд. Функцией slow можно
заменять реальные операции, которые и долгие, и блокирующие.
В листинге 17-15 мы с помощью slow имитируем такую работу, ограниченную
процессором, в паре футур.
extern crate trpl; // нужно для mdbook test
use std::{thread, time::Duration};
fn main() {
trpl::block_on(async {
let a = async {
println!("'a' started.");
slow("a", 30);
slow("a", 10);
slow("a", 20);
trpl::sleep(Duration::from_millis(50)).await;
println!("'a' finished.");
};
let b = async {
println!("'b' started.");
slow("b", 75);
slow("b", 10);
slow("b", 15);
slow("b", 350);
trpl::sleep(Duration::from_millis(50)).await;
println!("'b' finished.");
};
trpl::select(a, b).await;
});
}
fn slow(name: &str, ms: u64) {
thread::sleep(Duration::from_millis(ms));
println!("'{name}' ran for {ms}ms");
}slow, чтобы сымитировать медленные операцииКаждая футура возвращает управление среде выполнения, только выполнив целую серию медленных операций. Запустив этот код, вы увидите:
'a' started.
'a' ran for 30ms
'a' ran for 10ms
'a' ran for 20ms
'b' started.
'b' ran for 75ms
'b' ran for 10ms
'b' ran for 15ms
'b' ran for 350ms
'a' finished.
Как и в листинге 17-5 (там мы с помощью trpl::select устраивали гонку двух
загрузок), select завершается, как только готова a. Но вызовы slow в двух футурах не перемежаются. Футура a делает всю
свою работу, пока не дойдёт до ожидания trpl::sleep; затем футура b делает
всю свою, пока не дойдёт до своего trpl::sleep; и наконец завершается a.
Чтобы обе футуры могли продвигаться между своими медленными задачами, нужны
точки ожидания, в которых управление возвращается среде выполнения. А значит,
нужно что-то, чего можно ждать!
Такую передачу управления мы уже видим в листинге 17-15: если убрать
trpl::sleep в конце футуры a, она завершится, а футура b не выполнится
вообще. Попробуем для начала с помощью trpl::sleep дать операциям
продвигаться по очереди, как в листинге 17-16.
extern crate trpl; // нужно для mdbook test
use std::{thread, time::Duration};
fn main() {
trpl::block_on(async {
let one_ms = Duration::from_millis(1);
let a = async {
println!("'a' started.");
slow("a", 30);
trpl::sleep(one_ms).await;
slow("a", 10);
trpl::sleep(one_ms).await;
slow("a", 20);
trpl::sleep(one_ms).await;
println!("'a' finished.");
};
let b = async {
println!("'b' started.");
slow("b", 75);
trpl::sleep(one_ms).await;
slow("b", 10);
trpl::sleep(one_ms).await;
slow("b", 15);
trpl::sleep(one_ms).await;
slow("b", 350);
trpl::sleep(one_ms).await;
println!("'b' finished.");
};
trpl::select(a, b).await;
});
}
fn slow(name: &str, ms: u64) {
thread::sleep(Duration::from_millis(ms));
println!("'{name}' ran for {ms}ms");
}trpl::sleep даём операциям продвигаться по очередиМежду вызовами slow мы добавили вызовы trpl::sleep с точками ожидания.
Теперь работа двух футур перемежается:
'a' started.
'a' ran for 30ms
'b' started.
'b' ran for 75ms
'a' ran for 10ms
'b' ran for 10ms
'a' ran for 20ms
'b' ran for 15ms
'a' finished.
Футура a всё ещё немного работает, прежде чем передать управление b: она
вызывает slow раньше, чем trpl::sleep. Но после этого футуры передают
управление друг другу каждый раз, когда одна из них доходит до точки ожидания.
Здесь мы делаем это после каждого вызова slow, но разбить работу можно так,
как удобнее нам.
Только вот спать нам здесь на самом деле не нужно: мы хотим продвигаться как
можно быстрее. Нужно лишь вернуть управление среде выполнения. Это можно
сделать напрямую — функцией trpl::yield_now. В листинге 17-17 мы заменяем все
вызовы trpl::sleep на trpl::yield_now.
extern crate trpl; // нужно для mdbook test
use std::{thread, time::Duration};
fn main() {
trpl::block_on(async {
let a = async {
println!("'a' started.");
slow("a", 30);
trpl::yield_now().await;
slow("a", 10);
trpl::yield_now().await;
slow("a", 20);
trpl::yield_now().await;
println!("'a' finished.");
};
let b = async {
println!("'b' started.");
slow("b", 75);
trpl::yield_now().await;
slow("b", 10);
trpl::yield_now().await;
slow("b", 15);
trpl::yield_now().await;
slow("b", 350);
trpl::yield_now().await;
println!("'b' finished.");
};
trpl::select(a, b).await;
});
}
fn slow(name: &str, ms: u64) {
thread::sleep(Duration::from_millis(ms));
println!("'{name}' ran for {ms}ms");
}yield_now даём операциям продвигаться по очередиТакой код и точнее выражает намерение, и может работать заметно быстрее, чем
со sleep: у таймеров вроде того, что использует sleep, часто ограничена
точность. Например, наша версия sleep всегда спит не меньше миллисекунды,
даже если передать ей Duration в одну наносекунду. А ведь современные
компьютеры быстрые: за миллисекунду они успевают очень многое!
Получается, что async может пригодиться даже для задач, ограниченных процессором, — в зависимости от того, что ещё делает программа. Он даёт удобный инструмент для организации взаимодействия разных частей программы (хотя и ценой накладных расходов на асинхронный конечный автомат). Это форма кооперативной многозадачности (cooperative multitasking): каждая футура сама решает, когда передать управление, — через точки ожидания. А значит, каждая футура и отвечает за то, чтобы не блокировать слишком надолго. В некоторых встраиваемых операционных системах на Rust это единственный вид многозадачности!
Конечно, в реальном коде вы обычно не будете чередовать вызовы функций с точками ожидания на каждой строке. Такая передача управления относительно дешёвая, но не бесплатная. Во многих случаях попытка раздробить задачу, ограниченную процессором, может заметно её замедлить, так что иногда для общей производительности лучше дать операции ненадолго заблокировать поток. Всегда измеряйте, где на самом деле узкие места вашего кода. Но саму эту механику полезно держать в голове, если вы видите, что много работы выполняется последовательно, хотя вы ожидали, что она пойдёт конкурентно!
Собственные асинхронные абстракции
Футуры можно комбинировать и создавать из них новые шаблоны. Например, можно
собрать функцию timeout из уже имеющихся асинхронных строительных блоков. В
итоге получится ещё один строительный блок, из которого можно будет строить
новые асинхронные абстракции.
В листинге 17-18 показано, как мы хотим пользоваться timeout с медленной
футурой.
extern crate trpl; // нужно для mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let slow = async {
trpl::sleep(Duration::from_secs(5)).await;
"Finally finished"
};
match timeout(slow, Duration::from_secs(2)).await {
Ok(message) => println!("Succeeded with '{message}'"),
Err(duration) => {
println!("Failed after {} seconds", duration.as_secs())
}
}
});
}timeoutРеализуем её! Для начала продумаем API функции timeout:
- Она сама должна быть асинхронной, чтобы её можно было ждать.
- Первый параметр — футура, которую нужно выполнить. Сделаем его обобщённым, чтобы функция работала с любой футурой.
- Второй параметр — максимальное время ожидания. Если взять
Duration, его будет легко передать вtrpl::sleep. - Возвращать функция должна
Result. Если футура успешно завершилась, этоOkсо значением, которое выдала футура. Если раньше истекло время —Errс длительностью, которую мы прождали.
Это объявление — в листинге 17-19.
extern crate trpl; // нужно для mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let slow = async {
trpl::sleep(Duration::from_secs(5)).await;
"Finally finished"
};
match timeout(slow, Duration::from_secs(2)).await {
Ok(message) => println!("Succeeded with '{message}'"),
Err(duration) => {
println!("Failed after {} seconds", duration.as_secs())
}
}
});
}
async fn timeout<F: Future>(
future_to_try: F,
max_time: Duration,
) -> Result<F::Output, Duration> {
// Здесь будет наша реализация!
}timeoutС типами разобрались. Теперь продумаем нужное поведение: мы хотим устроить
гонку между переданной футурой и заданной длительностью. Из длительности можно
сделать футуру-таймер с помощью trpl::sleep, а с помощью trpl::select
запустить таймер наперегонки с футурой, которую передал вызывающий код.
В листинге 17-20 мы реализуем timeout, сопоставляя результат ожидания
trpl::select.
extern crate trpl; // нужно для mdbook test
use std::time::Duration;
use trpl::Either;
// --пропуск--
fn main() {
trpl::block_on(async {
let slow = async {
trpl::sleep(Duration::from_secs(5)).await;
"Finally finished"
};
match timeout(slow, Duration::from_secs(2)).await {
Ok(message) => println!("Succeeded with '{message}'"),
Err(duration) => {
println!("Failed after {} seconds", duration.as_secs())
}
}
});
}
async fn timeout<F: Future>(
future_to_try: F,
max_time: Duration,
) -> Result<F::Output, Duration> {
match trpl::select(future_to_try, trpl::sleep(max_time)).await {
Either::Left(output) => Ok(output),
Either::Right(_) => Err(max_time),
}
}timeout через select и sleepРеализация trpl::select несправедливая: она всегда опрашивает аргументы в том
порядке, в каком их передали (другие реализации select выбирают, какой
аргумент опросить первым, случайно). Поэтому мы передаём в select первой
future_to_try — чтобы у неё был шанс завершиться, даже если max_time очень
короткий. Если первой закончит future_to_try, select вернёт Left с её
результатом. Если первым сработает timer, select вернёт Right с
результатом таймера — ().
Если future_to_try завершилась успешно и мы получили Left(output),
возвращаем Ok(output). Если же раньше истёк таймер и мы получили Right(()),
игнорируем () через _ и возвращаем Err(max_time).
Вот и готова работающая timeout, собранная из двух других асинхронных
помощников. Если запустить код, после истечения времени он выведет сообщение о
неудаче:
Failed after 2 seconds
Раз футуры можно сочетать с другими футурами, из небольших асинхронных строительных блоков можно собирать очень мощные инструменты. Например, тем же способом можно объединить таймауты с повторными попытками, а их, в свою очередь, — с операциями вроде сетевых запросов (как в листинге 17-5).
На практике вы обычно будете работать напрямую с async и await, а уже во
вторую очередь — с функциями вроде select и макросами вроде join!, которые
управляют тем, как выполняются самые внешние футуры.
Мы рассмотрели несколько способов работать с несколькими футурами одновременно. Дальше посмотрим, как работать с последовательностью футур во времени — со стримами.
Стримы: последовательности футур
Стримы: последовательности футур
Вспомните, как раньше в этой главе, в разделе «Передача данных между задачами
через сообщения», мы пользовались приёмником
асинхронного канала. Асинхронный метод recv выдаёт последовательность
элементов во времени. Это частный случай гораздо более общего шаблона —
стрима (stream, асинхронного потока данных). Многое естественно
представляется в виде стримов: элементы, появляющиеся в очереди; фрагменты
данных, которые постепенно читаются из файловой системы, когда весь набор
данных не помещается в память; данные, приходящие по сети. Раз стримы — это
футуры, их можно использовать с любыми другими футурами и интересно
комбинировать. Например, можно группировать события, чтобы не делать слишком
много сетевых запросов, задавать таймауты для последовательностей долгих
операций или притормаживать события интерфейса, чтобы не делать лишней
работы.
Последовательность элементов мы уже видели в главе 13, когда разбирали трейт
Iterator в разделе «Трейт Iterator и метод next». Но между итераторами и приёмником асинхронного канала два отличия.
Первое — время: итераторы синхронные, а приёмник канала асинхронный. Второе —
API. Работая напрямую с Iterator, мы вызываем его синхронный метод next. А у
стрима trpl::Receiver мы вызывали асинхронный метод recv. В остальном эти
API очень похожи, и это сходство не случайно. Стрим — это что-то вроде
асинхронной формы итерации. Только trpl::Receiver специально ждёт сообщения,
а универсальный API стримов гораздо шире: он выдаёт следующий элемент так же,
как Iterator, но асинхронно.
Благодаря сходству итераторов и стримов в Rust стрим можно создать из любого
итератора. Как и с итератором, со стримом можно работать, вызывая его метод
next и дожидаясь результата, как в листинге 17-21. Правда, этот код пока не
скомпилируется.
extern crate trpl; // нужно для mdbook test
fn main() {
trpl::block_on(async {
let values = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10];
let iter = values.iter().map(|n| n * 2);
let mut stream = trpl::stream_from_iter(iter);
while let Some(value) = stream.next().await {
println!("The value was: {value}");
}
});
}Начинаем с массива чисел, превращаем его в итератор и вызываем map, чтобы
удвоить все значения. Затем превращаем итератор в стрим функцией
trpl::stream_from_iter. И перебираем элементы стрима по мере их поступления
циклом while let.
К сожалению, при попытке запустить код он не компилируется и сообщает, что
метода next нет:
error[E0599]: no method named `next` found for struct `tokio_stream::iter::Iter` in the current scope
--> src/main.rs:10:40
|
10 | while let Some(value) = stream.next().await {
| ^^^^
|
= help: items from traits can only be used if the trait is in scope
help: the following traits which provide `next` are implemented but not in scope; perhaps you want to import one of them
|
1 + use crate::trpl::StreamExt;
|
1 + use futures_util::stream::stream::StreamExt;
|
1 + use std::iter::Iterator;
|
1 + use std::str::pattern::Searcher;
|
help: there is a method `try_next` with a similar name
|
10 | while let Some(value) = stream.try_next().await {
| ~~~~~~~~
Как объясняет этот вывод, метод next станет доступен, только если подключить
в область видимости соответствующий трейт. После всего
сказанного логично ожидать, что это трейт Stream, но на самом деле это
StreamExt. Ext — сокращение от extension (расширение); это
распространённый в сообществе Rust шаблон, когда один трейт расширяют
другим.
Трейт Stream задаёт низкоуровневый интерфейс, по сути объединяющий трейты
Iterator и Future. А StreamExt надстраивает над Stream
более высокоуровневый набор API, включая метод next и другие вспомогательные
методы, похожие на те, что даёт трейт Iterator. Stream и StreamExt пока не
входят в стандартную библиотеку Rust, но большинство крейтов экосистемы
используют похожие определения.
Чтобы исправить ошибку компиляции, добавим инструкцию use для
trpl::StreamExt, как в листинге 17-22.
extern crate trpl; // нужно для mdbook test
use trpl::StreamExt;
fn main() {
trpl::block_on(async {
let values = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10];
// --пропуск--
let iter = values.iter().map(|n| n * 2);
let mut stream = trpl::stream_from_iter(iter);
while let Some(value) = stream.next().await {
println!("The value was: {value}");
}
});
}Когда всё собрано вместе, код работает так, как мы хотим! Более того, теперь,
когда StreamExt в области видимости, можно пользоваться всеми его
вспомогательными методами — так же, как с итераторами.
Трейты асинхронности поближе
Трейты асинхронности поближе
На протяжении главы мы по-разному пользовались трейтами Future, Stream и
StreamExt. Но до сих пор не углублялись в то, как они устроены и как
сочетаются друг с другом, — для повседневной работы на Rust это обычно и не
нужно. Однако иногда встречаются ситуации, когда нужно понимать чуть больше
подробностей об этих трейтах, а также о типе Pin и трейте Unpin. В этом
разделе мы копнём ровно настолько, чтобы помочь в таких ситуациях, а
по-настоящему глубокое погружение оставим другой документации.
Трейт Future
Начнём с того, как устроен трейт Future. Вот как он определён в Rust:
#![allow(unused)]
fn main() {
use std::pin::Pin;
use std::task::{Context, Poll};
pub trait Future {
type Output;
fn poll(self: Pin<&mut Self>, cx: &mut Context<'_>) -> Poll<Self::Output>;
}
}В этом определении много новых типов и немного синтаксиса, которого мы ещё не видели, так что разберём его по частям.
Во-первых, ассоциированный тип Output у Future говорит, во что разрешается
футура. Это аналог ассоциированного типа Item у трейта Iterator.
Во-вторых, у Future есть метод poll, который принимает особую ссылку Pin
в качестве параметра self и изменяемую ссылку на тип Context, а возвращает
Poll<Self::Output>. О Pin и Context поговорим чуть позже. А пока
сосредоточимся на том, что возвращает метод, — на типе Poll:
#![allow(unused)]
fn main() {
pub enum Poll<T> {
Ready(T),
Pending,
}
}Тип Poll похож на Option: у него есть вариант со значением, Ready(T), и
вариант без значения, Pending. Но смысл у Poll совсем другой! Вариант
Pending означает, что футуре ещё есть что делать, и вызывающему нужно будет
проверить её позже. А вариант Ready означает, что Future закончила работу и
значение T готово.
Примечание: вызывать poll напрямую приходится редко. Но если всё-таки
придётся, помните: у большинства футур нельзя снова вызывать poll после
того, как футура вернула Ready. Многие футуры паникуют, если их опросить
после готовности. Те футуры, которые можно безопасно опрашивать повторно,
прямо говорят об этом в документации. Это похоже на поведение
Iterator::next.
Код, где используется await, Rust под капотом компилирует в код, вызывающий
poll. Вернитесь к листингу 17-4, где мы выводили заголовок страницы для одного
URL, когда тот был получен. Rust компилирует его во что-то примерно (хотя и не
точно) такое:
match page_title(url).poll() {
Ready(page_title) => match page_title {
Some(title) => println!("The title for {url} was {title}"),
None => println!("{url} had no title"),
}
Pending => {
// А что здесь?
}
}Что делать, если футура ещё в состоянии Pending? Нужно как-то пробовать снова,
и снова, и снова, пока футура наконец не будет готова. Иначе говоря, нужен
цикл:
let mut page_title_fut = page_title(url);
loop {
match page_title_fut.poll() {
Ready(value) => match page_title {
Some(title) => println!("The title for {url} was {title}"),
None => println!("{url} had no title"),
}
Pending => {
// продолжаем
}
}
}Но если бы Rust компилировал код ровно в это, каждый await был бы
блокирующим — прямая противоположность тому, чего мы добивались! Вместо этого
Rust делает так, чтобы цикл мог передать управление тому, кто может
приостановить работу над этой футурой, поработать над другими, а потом снова
проверить эту. Как мы уже видели, этот «кто-то» — асинхронная среда
выполнения, и такое планирование и координация — одна из её главных задач.
В разделе «Передача данных между задачами через
сообщения» мы говорили об ожидании rx.recv.
Вызов recv возвращает футуру, а ожидание футуры означает её опрос. Мы
отмечали, что среда выполнения приостанавливает футуру, пока та не будет готова
— с Some(message) или с None, когда канал закроется. Теперь, лучше понимая
трейт Future и в особенности Future::poll, мы видим, как это работает.
Среда выполнения знает, что футура не готова, когда та возвращает
Poll::Pending. И наоборот, среда выполнения знает, что футура готова, и
продвигает её дальше, когда poll возвращает Poll::Ready(Some(message)) или
Poll::Ready(None).
Точные подробности того, как среда выполнения это делает, выходят за рамки книги, но главное — увидеть базовую механику футур: среда выполнения опрашивает каждую футуру, за которую отвечает, и снова «усыпляет» её, если та ещё не готова.
Тип Pin и трейт Unpin
В листинге 17-13 мы ждали три футуры с помощью макроса trpl::join!. Но часто
бывает коллекция — например, вектор — с каким-то количеством футур, которое
становится известно только во время выполнения. Изменим листинг 17-13 на код из
листинга 17-23: положим три футуры в вектор и вызовем функцию
trpl::join_all. Пока этот код не скомпилируется.
extern crate trpl; // нужно для mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let tx1 = tx.clone();
let tx1_fut = async move {
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx1.send(val).unwrap();
trpl::sleep(Duration::from_secs(1)).await;
}
};
let rx_fut = async {
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
};
let tx_fut = async move {
// --пропуск--
let vals = vec![
String::from("more"),
String::from("messages"),
String::from("for"),
String::from("you"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_secs(1)).await;
}
};
let futures: Vec<Box<dyn Future<Output = ()>>> =
vec![Box::new(tx1_fut), Box::new(rx_fut), Box::new(tx_fut)];
trpl::join_all(futures).await;
});
}Каждую футуру мы помещаем в Box, чтобы превратить их в трейт-объекты, как
в разделе «Возвращаем ошибки из run» главы 12. (Подробно о трейт-объектах — в
главе 18.) Трейт-объекты позволяют обращаться со всеми анонимными футурами,
которые создают эти блоки, как с одним типом: все они реализуют трейт
Future.
Это может удивить. Ведь ни один из асинхронных блоков ничего не возвращает, так
что каждый даёт Future<Output = ()>. Но помните: Future — это трейт, а
компилятор создаёт для каждого асинхронного блока уникальное перечисление, даже
если типы результатов совпадают. Как нельзя положить в Vec две разные
написанные вручную структуры, так нельзя и смешивать перечисления,
сгенерированные компилятором.
Затем мы передаём коллекцию футур в функцию trpl::join_all и ждём результат.
Однако код не компилируется. Вот важная часть сообщений об ошибке:
error[E0277]: `dyn Future<Output = ()>` cannot be unpinned
--> src/main.rs:48:33
|
48 | trpl::join_all(futures).await;
| ^^^^^ the trait `Unpin` is not implemented for `dyn Future<Output = ()>`
|
= note: consider using the `pin!` macro
consider using `Box::pin` if you need to access the pinned value outside of the current scope
= note: required for `Box<dyn Future<Output = ()>>` to implement `Future`
note: required by a bound in `futures_util::future::join_all::JoinAll`
--> file:///home/.cargo/registry/src/index.crates.io-1949cf8c6b5b557f/futures-util-0.3.30/src/future/join_all.rs:29:8
|
27 | pub struct JoinAll<F>
| ------- required by a bound in this struct
28 | where
29 | F: Future,
| ^^^^^^ required by this bound in `JoinAll`
Заметка в сообщении советует закрепить (pin) значения макросом pin!, то
есть поместить их в тип Pin, который гарантирует, что значения не будут
перемещаться в памяти. Сообщение говорит, что закрепление нужно, потому что
dyn Future<Output = ()> должен реализовывать трейт Unpin, а сейчас не
реализует.
Функция trpl::join_all возвращает структуру JoinAll. Эта структура обобщена
по типу F, который обязан реализовывать трейт Future. Когда футуру ждут
напрямую через await, она неявно закрепляется. Поэтому pin! не нужно писать
везде, где мы ждём футуры.
Но здесь мы ждём не футуру напрямую. Мы создаём новую футуру, JoinAll,
передавая коллекцию футур в функцию join_all. Сигнатура join_all требует,
чтобы типы элементов коллекции реализовывали трейт Future, а Box<T>
реализует Future, только если обёрнутый им T — футура, реализующая трейт
Unpin.
Многовато для одного раза! Чтобы по-настоящему разобраться, копнём чуть глубже
в то, как на самом деле работает трейт Future, особенно в части закрепления.
Взгляните ещё раз на определение трейта Future:
#![allow(unused)]
fn main() {
use std::pin::Pin;
use std::task::{Context, Poll};
pub trait Future {
type Output;
// Обязательный метод
fn poll(self: Pin<&mut Self>, cx: &mut Context<'_>) -> Poll<Self::Output>;
}
}Параметр cx и его тип Context — ключ к тому, как среда выполнения узнаёт,
когда проверять ту или иную футуру, оставаясь при этом ленивой. Подробности
опять же выходят за рамки этой главы, и думать об этом обычно приходится,
только когда пишешь собственную реализацию Future. Сосредоточимся на типе
self: мы впервые видим метод, у которого self аннотирован типом. Аннотация
типа у self работает как аннотации типов других параметров функции, но с
двумя важными отличиями:
- Она говорит Rust, каким должен быть тип
self, чтобы метод можно было вызвать. - Это не может быть любой тип. Допускается только тип, для которого реализован
метод, ссылка или умный указатель на этот тип либо
Pin, обёрнутый вокруг ссылки на этот тип.
Подробнее этот синтаксис мы увидим в главе 18. Пока
достаточно знать: чтобы опросить футуру и проверить, Pending она или
Ready(Output), нужна изменяемая ссылка на тип, обёрнутая в Pin.
Pin — обёртка для типов, похожих на указатели: &, &mut, Box, Rc.
(Формально Pin работает с типами, реализующими трейты Deref или
DerefMut, но на практике это равносильно работе только со ссылками и умными
указателями.) Pin сам по себе не указатель, и, в отличие от Rc и Arc, у
него нет собственного поведения вроде подсчёта ссылок. Это чисто инструмент,
с помощью которого компилятор накладывает ограничения на использование
указателей.
То, что await реализован через вызовы poll, отчасти объясняет ошибку,
которую мы видели. Но там речь шла об Unpin, а не о Pin. Как же связаны
Pin и Unpin и почему Future требует, чтобы для вызова poll значение
self было обёрнуто в Pin?
Вспомните: последовательность точек ожидания в футуре компилируется в конечный автомат, и компилятор следит, чтобы этот автомат соблюдал все обычные правила безопасности Rust, в том числе правила заимствования и владения. Для этого Rust смотрит, какие данные нужны между одной точкой ожидания и следующей (или концом асинхронного блока), и создаёт соответствующий вариант в скомпилированном автомате. Каждый вариант получает тот доступ к данным, который нужен в этом фрагменте исходного кода: забирает владение данными или получает на них изменяемую либо неизменяемую ссылку.
Пока всё хорошо: если мы ошибёмся с владением или ссылками в асинхронном блоке,
анализатор заимствований нам скажет. Сложности начинаются, когда футуру,
соответствующую этому блоку, нужно куда-то перемещать — например, положить в
Vec, чтобы передать в join_all.
Когда мы перемещаем футуру — кладём её в структуру данных, чтобы перебирать в
join_all, или возвращаем из функции, — на самом деле перемещается конечный
автомат, который для нас создал Rust. И, в отличие от большинства других типов
в Rust, у футур, которые Rust создаёт для асинхронных блоков, в полях
вариантов могут оказаться ссылки на самих себя, как показано на упрощённой
схеме на рисунке 17-4.
Но по умолчанию любой объект со ссылкой на самого себя небезопасно перемещать: ссылки всегда указывают на фактический адрес в памяти того, на что ссылаются (рисунок 17-5). Если переместить саму структуру данных, внутренние ссылки продолжат указывать на старое место. А это место в памяти теперь недействительно. Во-первых, его значение не будет обновляться при изменении структуры. Во-вторых — и это важнее, — компьютер теперь волен использовать эту память для чего-то другого! Позже можно прочитать оттуда совершенно посторонние данные.
Теоретически компилятор Rust мог бы при каждом перемещении объекта обновлять все ссылки на него, но это могло бы сильно ударить по производительности — особенно если обновлять нужно целую сеть ссылок. Если же гарантировать, что структура данных не перемещается в памяти, обновлять ссылки не придётся. Именно для этого и нужен анализатор заимствований Rust: в безопасном коде он не даёт переместить элемент, на который есть активная ссылка.
Pin опирается на это и даёт ровно ту гарантию, которая нам нужна. Если
закрепить значение, обернув указатель на него в Pin, оно больше не сможет
перемещаться. То есть если у вас Pin<Box<SomeType>>, закрепляется значение
SomeType, а не указатель Box. Это показано на рисунке 17-6.
На самом деле сам указатель Box по-прежнему может свободно перемещаться.
Помните: нам важно, чтобы на месте оставались данные, на которые в конечном
счёте указывает ссылка. Если указатель перемещается, а данные, на которые он
указывает, остаются на месте, как на рисунке 17-7, никакой проблемы нет. (В
качестве самостоятельного упражнения изучите документацию к этим типам и к
модулю std::pin и попробуйте понять, как сделать это с Pin, обёрнутым вокруг
Box.) Главное — сам самоссылающийся тип переместиться не может: он
по-прежнему закреплён.
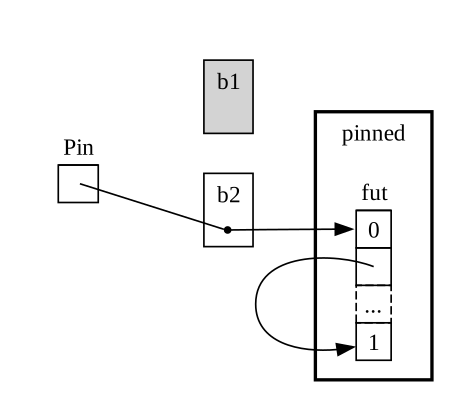
Однако большинство типов совершенно безопасно перемещать, даже если они
оказались за указателем Pin. О закреплении нужно думать, только когда у
элементов есть внутренние ссылки. Примитивные значения вроде чисел и
логических значений безопасны: внутренних ссылок у них, очевидно, нет. Как и у
большинства типов, с которыми вы обычно работаете в Rust. Например, Vec можно
перемещать без опаски. Но, судя по тому, что мы видели до сих пор, с
Pin<Vec<String>> пришлось бы делать всё через безопасные, но ограниченные API
Pin, хотя Vec<String> всегда безопасно перемещать, если на него нет других
ссылок. Нужен способ сказать компилятору, что в таких случаях перемещать
элементы можно, — и здесь в игру вступает Unpin.
Unpin — трейт-маркер, как трейты Send и Sync из главы 16, и собственной
функциональности у него нет. Трейты-маркеры существуют лишь для того, чтобы
сообщить компилятору, что тип, реализующий трейт, безопасно использовать в
определённом контексте. Unpin говорит компилятору, что данному типу не
нужно соблюдать никаких гарантий насчёт того, можно ли безопасно перемещать
значение.
Как и в случае с Send и Sync, компилятор автоматически реализует Unpin
для всех типов, для которых может доказать, что это безопасно. Особый случай —
опять же как с Send и Sync — когда Unpin для типа не реализован.
Записывается это как impl !Unpin for SomeType, где
SomeType — имя типа, которому нужно соблюдать эти
гарантии, чтобы оставаться безопасным, когда указатель на него используется в
Pin.
Иначе говоря, о связи Pin и Unpin нужно помнить две вещи. Во-первых,
Unpin — это «обычный» случай, а !Unpin — особый. Во-вторых, реализует тип
Unpin или !Unpin, важно только тогда, когда вы используете закреплённый
указатель на этот тип вроде Pin<&mut SomeType>.
Для наглядности возьмём String: у неё есть длина и символы Юникода, из
которых она состоит. String можно обернуть в Pin, как на рисунке 17-8. Но
String автоматически реализует Unpin, как и большинство других типов в Rust.
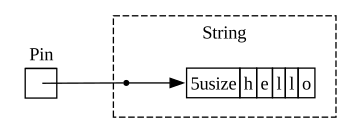
Поэтому с String можно делать то, что было бы недопустимо, реализуй она
!Unpin, — например, заменить одну строку другой ровно на том же месте в
памяти, как на рисунке 17-9. Договор Pin это не нарушает: у String нет
внутренних ссылок, из-за которых её было бы небезопасно перемещать. Именно
поэтому она реализует Unpin, а не !Unpin.
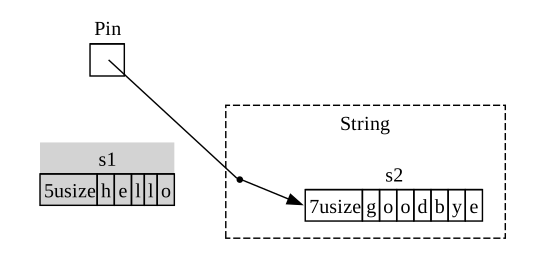
Теперь мы знаем достаточно, чтобы понять ошибки при вызове join_all из
листинга 17-23. Изначально мы пытались переместить футуры, созданные
асинхронными блоками, в Vec<Box<dyn Future<Output = ()>>>, но, как мы видели,
у этих футур могут быть внутренние ссылки, поэтому Unpin они автоматически не
реализуют. Если же их закрепить, получившиеся значения Pin можно класть в
Vec, не опасаясь, что данные внутри футур куда-то переместятся. В листинге 17-24
показано, как исправить код: вызвать макрос pin! там, где определена каждая
из трёх футур, и поправить тип трейт-объекта.
extern crate trpl; // нужно для mdbook test
use std::pin::{Pin, pin};
// --пропуск--
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let tx1 = tx.clone();
let tx1_fut = pin!(async move {
// --пропуск--
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx1.send(val).unwrap();
trpl::sleep(Duration::from_secs(1)).await;
}
});
let rx_fut = pin!(async {
// --пропуск--
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
});
let tx_fut = pin!(async move {
// --пропуск--
let vals = vec![
String::from("more"),
String::from("messages"),
String::from("for"),
String::from("you"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_secs(1)).await;
}
});
let futures: Vec<Pin<&mut dyn Future<Output = ()>>> =
vec![tx1_fut, rx_fut, tx_fut];
trpl::join_all(futures).await;
});
}Теперь пример компилируется и работает, и во время выполнения можно добавлять футуры в вектор или убирать их и ждать все вместе.
Pin и Unpin важны в основном при написании низкоуровневых библиотек или
самих сред выполнения, а не в повседневном коде на Rust. Но теперь, встретив
эти трейты в сообщениях об ошибках, вы будете лучше понимать, как исправить
код!
Примечание: сочетание Pin и Unpin позволяет безопасно реализовать в Rust
целый класс сложных типов, с которыми иначе было бы трудно работать, потому
что они ссылаются сами на себя. Сегодня типы, которым нужен Pin, чаще всего
встречаются в асинхронном Rust, но изредка вы можете увидеть их и в других
контекстах.
Как именно работают Pin и Unpin и какие правила они обязаны соблюдать,
подробно описано в документации к API std::pin — если хотите узнать
больше, начните оттуда.
А если хотите разобраться, как всё устроено под капотом, ещё подробнее, прочитайте главы 2 и 4 книги Asynchronous Programming in Rust.
Трейт Stream
Теперь, когда вы глубже понимаете Future, Pin и Unpin, обратимся к трейту
Stream. Как вы узнали раньше в этой главе, стримы похожи на асинхронные
итераторы. Но, в отличие от Iterator и Future, на момент написания книги у
Stream нет определения в стандартной библиотеке. Зато есть очень
распространённое определение из крейта futures, которое используется по всей
экосистеме.
Прежде чем смотреть, как трейт Stream может объединить трейты Iterator и
Future, вспомним их определения. От Iterator берётся идея
последовательности: его метод next выдаёт Option<Self::Item>. От Future —
идея готовности во времени: его метод poll выдаёт Poll<Self::Output>. Чтобы
представить последовательность элементов, которые становятся готовыми со
временем, определим трейт Stream, объединяющий эти возможности:
#![allow(unused)]
fn main() {
use std::pin::Pin;
use std::task::{Context, Poll};
trait Stream {
type Item;
fn poll_next(
self: Pin<&mut Self>,
cx: &mut Context<'_>
) -> Poll<Option<Self::Item>>;
}
}Трейт Stream определяет ассоциированный тип Item — тип элементов, которые
выдаёт стрим. Это похоже на Iterator, где элементов может быть от нуля до
сколь угодно многих, и не похоже на Future, где Output всегда ровно один,
пусть даже это единичный тип ().
Ещё Stream определяет метод получения этих элементов. Мы назвали его
poll_next, чтобы было видно: он опрашивает так же, как Future::poll, и
выдаёт последовательность элементов так же, как Iterator::next. Его
возвращаемый тип сочетает Poll и Option. Внешний тип — Poll, потому что,
как и у футуры, нужно проверять готовность. Внутренний — Option, потому что,
как и итератору, нужно сообщать, будут ли ещё сообщения.
Нечто очень похожее на это определение, скорее всего, в итоге войдёт в стандартную библиотеку Rust. А пока оно есть в инструментарии большинства сред выполнения, так что на него можно полагаться, и всё, о чём пойдёт речь дальше, в целом применимо!
Однако в примерах из раздела «Стримы: последовательности футур» мы использовали не poll_next и не Stream, а next и
StreamExt. Конечно, можно было бы работать напрямую с API poll_next, вручную
написав собственные конечные автоматы Stream, — так же, как можно работать с
футурами напрямую через их метод poll. Но с await гораздо приятнее, и трейт
StreamExt даёт метод next, чтобы так и делать:
#![allow(unused)]
fn main() {
use std::pin::Pin;
use std::task::{Context, Poll};
trait Stream {
type Item;
fn poll_next(
self: Pin<&mut Self>,
cx: &mut Context<'_>,
) -> Poll<Option<Self::Item>>;
}
trait StreamExt: Stream {
async fn next(&mut self) -> Option<Self::Item>
where
Self: Unpin;
// другие методы...
}
}Примечание: настоящее определение, которым мы пользовались раньше в главе, выглядит немного иначе: оно поддерживает версии Rust, где асинхронных функций в трейтах ещё не было. Поэтому оно такое:
fn next(&mut self) -> Next<'_, Self> where Self: Unpin;Next — это структура (struct), реализующая Future. С её помощью можно
указать время жизни ссылки на self как Next<'_, Self>, чтобы с этим
методом работал await.
В трейте StreamExt собраны и все интересные методы для работы со стримами.
StreamExt автоматически реализован для любого типа, реализующего Stream, но
эти трейты определены отдельно, чтобы сообщество могло развивать удобные API,
не затрагивая базовый трейт.
В версии StreamExt из крейта trpl трейт не только определяет метод next,
но и даёт его реализацию по умолчанию, которая правильно обрабатывает все
детали вызова Stream::poll_next. Значит, даже если вам понадобится написать
собственный потоковый тип данных, реализовать нужно только Stream — и все,
кто пользуется вашим типом, автоматически смогут применять к нему StreamExt и
его методы.
На этом с низкоуровневыми подробностями этих трейтов всё. В завершение посмотрим, как сочетаются друг с другом футуры (включая стримы), задачи и потоки!
Футуры, задачи и потоки
Собираем всё вместе: футуры, задачи и потоки
Как мы видели в главе 16, потоки — один из подходов к конкурентности. В этой главе мы познакомились с другим: async с футурами и стримами. Если вам интересно, когда выбирать один, а когда другой, ответ такой: по обстоятельствам! И во многих случаях выбор стоит не «потоки или async», а «потоки и async».
Многие операционные системы уже десятилетиями предоставляют модели конкурентности на основе потоков, и поэтому их поддерживают многие языки. Но и у этих моделей есть свои издержки. Во многих ОС каждый поток расходует довольно много памяти. А кроме того, потоки доступны, только если их поддерживают операционная система и железо. В отличие от обычных настольных и мобильных компьютеров, у некоторых встраиваемых систем вообще нет ОС, а значит, нет и потоков.
Асинхронная модель предлагает другой — а в итоге дополняющий — набор
компромиссов. В ней конкурентным операциям не нужны собственные потоки. Вместо
этого они могут выполняться в задачах (tasks) — как когда мы в разделе о
стримах запускали работу из синхронной функции через trpl::spawn_task.
Задача похожа на поток, но управляет ею не операционная система, а код на
уровне библиотеки — среда выполнения.
API для порождения потоков и задач так похожи не случайно. Потоки служат границей для наборов синхронных операций: конкурентность возможна между потоками. Задачи служат границей для наборов асинхронных операций: конкурентность возможна и между задачами, и внутри них, потому что задача может переключаться между футурами в своём теле. Наконец, футуры — самая мелкая единица конкурентности в Rust, и каждая футура может представлять целое дерево других футур. Среда выполнения — точнее, её исполнитель — управляет задачами, а задачи управляют футурами. В этом смысле задачи похожи на лёгкие потоки, которыми управляет среда выполнения. И у них есть дополнительные возможности — как раз потому, что управляет ими среда выполнения, а не операционная система.
Это не значит, что асинхронные задачи всегда лучше потоков (или наоборот). В
чём-то конкурентность с потоками — более простая модель программирования, чем
конкурентность с async. Это может быть и плюсом, и минусом. Потоки работают
по принципу «запустил и забыл»: у них нет встроенного аналога футуры, поэтому
они просто выполняются до конца, и прервать их может только сама операционная
система.
А ещё оказывается, что потоки и задачи часто отлично работают вместе: задачи (по
крайней мере в некоторых средах выполнения) можно перемещать между потоками.
Более того, под капотом среда выполнения, которой мы пользовались, — включая
функции spawn_blocking и spawn_task, — по умолчанию многопоточная! Многие
среды выполнения используют подход под названием перехват работы (work
stealing): они незаметно перемещают задачи между потоками в зависимости от
того, насколько загружены потоки, чтобы повысить общую производительность
системы. Для такого подхода нужны и потоки, и задачи, а значит, и футуры.
Выбирая, что использовать, ориентируйтесь на такие правила:
- Если работа хорошо распараллеливается (то есть ограничена процессором) — например, нужно обработать кучу данных, каждую часть которых можно обрабатывать отдельно, — лучше выбрать потоки.
- Если работа сильно конкурентная (то есть ограничена вводом-выводом) — например, нужно обрабатывать сообщения из множества разных источников, которые приходят с разными интервалами и с разной скоростью, — лучше выбрать async.
А если нужны и параллелизм, и конкурентность, выбирать между потоками и async не обязательно. Их можно свободно сочетать, давая каждому делать то, что у него получается лучше всего. Например, в листинге 17-25 — довольно типичный для реального кода на Rust пример такого сочетания.
extern crate trpl; // для mdbook test
use std::{thread, time::Duration};
fn main() {
let (tx, mut rx) = trpl::channel();
thread::spawn(move || {
for i in 1..11 {
tx.send(i).unwrap();
thread::sleep(Duration::from_secs(1));
}
});
trpl::block_on(async {
while let Some(message) = rx.recv().await {
println!("{message}");
}
});
}Сначала создаём асинхронный канал, затем порождаем поток, который с помощью
ключевого слова move забирает владение отправляющей стороной канала. В
потоке отправляем числа от 1 до 10 с паузой в секунду между ними. И наконец, как
и на протяжении всей главы, выполняем футуру, созданную асинхронным блоком,
переданным в trpl::block_on. В этой футуре ждём сообщения — как и в других
примерах с передачей сообщений, которые мы видели.
Вернёмся к сценарию, с которого начиналась глава: представьте, что набор задач кодирования видео выполняется в отдельном потоке (ведь кодирование видео ограничено процессором), а интерфейс узнаёт о завершении этих операций через асинхронный канал. В реальных задачах таких сочетаний бесчисленное множество.
Итоги
Это не последняя встреча с конкурентностью в книге. Проект из главы 21 применит эти понятия в ситуации, более приближенной к реальности, чем простые примеры здесь, и нагляднее сравнит решение задач с помощью потоков и с помощью задач и футур.
Какой бы подход вы ни выбрали, Rust даёт инструменты, чтобы писать безопасный, быстрый конкурентный код — будь то высоконагруженный веб-сервер или встраиваемая операционная система.
Дальше мы поговорим об идиоматичных способах моделировать задачи и структурировать решения по мере роста программ на Rust. А заодно обсудим, как идиомы Rust соотносятся с тем, что может быть вам знакомо по объектно-ориентированному программированию.
Возможности объектно-ориентированного программирования
Объектно-ориентированное программирование (ООП) — это способ моделировать программы. Объекты как понятие программирования появились в языке Simula в 1960-х годах. Они повлияли на архитектуру программ Алана Кея, в которой объекты обмениваются сообщениями. Чтобы описать эту архитектуру, в 1967 году он придумал термин объектно-ориентированное программирование. Существует много конкурирующих определений ООП, и по одним из них Rust объектно-ориентированный, а по другим — нет. В этой главе мы рассмотрим черты, которые обычно считают объектно-ориентированными, и посмотрим, как они выглядят в идиоматичном Rust. Затем покажем, как реализовать на Rust объектно-ориентированный шаблон проектирования, и обсудим, чем это лучше или хуже решения, использующего сильные стороны самого Rust.
Черты объектно-ориентированных языков
Черты объектно-ориентированных языков
В сообществе программистов нет согласия о том, какие возможности должны быть у языка, чтобы он считался объектно-ориентированным. На Rust повлияли многие парадигмы программирования, включая ООП; например, в главе 13 мы разбирали возможности, пришедшие из функционального программирования. Можно сказать, что у ООП-языков есть общие черты — объекты, инкапсуляция и наследование. Посмотрим, что означает каждая из них и поддерживает ли её Rust.
Объекты содержат данные и поведение
Книга Design Patterns: Elements of Reusable Object-Oriented Software («Приёмы объектно-ориентированного проектирования. Паттерны проектирования») Эриха Гаммы, Ричарда Хелма, Ральфа Джонсона и Джона Влиссидеса (Addison-Wesley, 1994), которую в обиходе называют книгой «Банды четырёх» (The Gang of Four), — это каталог объектно-ориентированных шаблонов проектирования. ООП в ней определяется так:
Объектно-ориентированные программы состоят из объектов. Объект объединяет данные и процедуры, которые работают с этими данными. Процедуры обычно называют методами или операциями.
По этому определению Rust объектно-ориентированный: у структур и перечислений
есть данные, а блоки impl дают им методы. Хотя структуры и перечисления с
методами не называют объектами, по определению «Банды четырёх» они дают ту же
функциональность.
Инкапсуляция скрывает детали реализации
Ещё одна черта, которую обычно связывают с ООП, — инкапсуляция (encapsulation): детали реализации объекта недоступны коду, который этот объект использует. Взаимодействовать с объектом можно только через его публичный API; код, использующий объект, не должен залезать во внутренности объекта и напрямую менять данные или поведение. Благодаря этому программист может менять и рефакторить внутренности объекта, не трогая код, который его использует.
Как управлять инкапсуляцией, мы обсуждали в главе 7: ключевым словом pub
можно решать, какие модули, типы, функции и методы в коде будут публичными, а
всё остальное по умолчанию приватно. Например, можно определить структуру
AveragedCollection с полем, содержащим вектор значений i32. У структуры
может быть и поле со средним значением элементов вектора — тогда среднее не
придётся вычислять каждый раз, когда оно кому-то понадобится. Иначе говоря,
AveragedCollection будет кешировать вычисленное среднее. Определение структуры
AveragedCollection — в листинге 18-1.
pub struct AveragedCollection {
list: Vec<i32>,
average: f64,
}AveragedCollection, которая хранит список целых чисел и среднее значение элементов коллекцииСтруктура помечена pub, чтобы ею мог пользоваться другой код, а поля
структуры остаются приватными. Здесь это важно: мы хотим гарантировать, что
при каждом добавлении или удалении значения из списка обновляется и среднее.
Для этого реализуем для структуры методы add, remove и average, как в
листинге 18-2.
pub struct AveragedCollection {
list: Vec<i32>,
average: f64,
}
impl AveragedCollection {
pub fn add(&mut self, value: i32) {
self.list.push(value);
self.update_average();
}
pub fn remove(&mut self) -> Option<i32> {
let result = self.list.pop();
match result {
Some(value) => {
self.update_average();
Some(value)
}
None => None,
}
}
pub fn average(&self) -> f64 {
self.average
}
fn update_average(&mut self) {
let total: i32 = self.list.iter().sum();
self.average = total as f64 / self.list.len() as f64;
}
}add, remove и average для AveragedCollectionПубличные методы add, remove и average — единственный способ обратиться к
данным экземпляра AveragedCollection или изменить их. Когда элемент
добавляется в list методом add или удаляется методом remove, их реализации
вызывают приватный метод update_average, который заодно обновляет поле
average.
Поля list и average мы оставляем приватными, чтобы внешний код никак не мог
напрямую добавлять элементы в поле list или удалять их оттуда; иначе при
изменении list поле average могло бы рассогласоваться с ним. Метод
average возвращает значение из поля average, позволяя внешнему коду читать
среднее, но не менять его.
Раз детали реализации структуры AveragedCollection инкапсулированы, в будущем
можно легко поменять кое-что внутри — например, структуру данных. Скажем, для
поля list можно взять HashSet<i32> вместо Vec<i32>. Пока сигнатуры
публичных методов add, remove и average остаются прежними, менять код,
использующий AveragedCollection, не придётся. А будь list публичным, так
было бы не всегда: у HashSet<i32> и Vec<i32> разные методы добавления и
удаления элементов, и внешний код, напрямую менявший list, скорее всего,
пришлось бы переписать.
Если инкапсуляция — обязательная черта объектно-ориентированного языка, то
Rust этому требованию отвечает. Возможность использовать или не использовать
pub для разных частей кода позволяет инкапсулировать детали реализации.
Наследование: система типов и повторное использование кода
Наследование (inheritance) — механизм, при котором объект может унаследовать элементы определения другого объекта, то есть получить данные и поведение родительского объекта без повторного определения.
Если для объектно-ориентированности язык обязан поддерживать наследование, то Rust не такой язык. Определить структуру, которая наследовала бы поля и реализации методов родительской структуры, без макросов нельзя.
Но если вы привыкли к наследованию, в Rust можно воспользоваться другими решениями — в зависимости от того, зачем вам вообще понадобилось наследование.
Наследование выбирают по двум основным причинам. Первая — повторное
использование кода: поведение реализуют один раз для одного типа, а благодаря
наследованию пользуются им и в другом типе. В Rust это
можно сделать в ограниченном виде с помощью реализаций методов трейта по
умолчанию — вы видели такое в листинге 10-14, когда мы добавили реализацию по
умолчанию метода summarize в трейт Summary. У любого типа, реализующего
трейт Summary, метод summarize будет доступен без всякого дополнительного
кода. Это похоже на то, как у родительского класса есть реализация метода, и
наследующий дочерний класс тоже её получает. А при реализации трейта Summary
реализацию summarize по умолчанию можно переопределить — это похоже на то,
как дочерний класс переопределяет метод, унаследованный от родителя.
Вторая причина связана с системой типов: чтобы дочерний тип можно было использовать там же, где родительский. Это называют полиморфизмом (polymorphism): во время выполнения несколько объектов можно подставлять друг вместо друга, если у них есть общие черты.
Полиморфизм
Для многих полиморфизм — синоним наследования. Но на самом деле это более общее понятие: код, который может работать с данными разных типов. При наследовании такие типы обычно — подклассы.
Rust же использует обобщения, чтобы абстрагироваться от разных возможных типов, и ограничения трейтами, чтобы задать, что эти типы должны уметь. Иногда это называют ограниченным параметрическим полиморфизмом (bounded parametric polymorphism).
Отказавшись от наследования, Rust выбрал другой набор компромиссов. При наследовании легко получить больше общего кода, чем нужно. Подклассу не всегда нужны все характеристики родительского класса, но при наследовании он получает их все. Из-за этого дизайн программы может стать менее гибким. К тому же появляется возможность вызывать у подклассов методы, которые не имеют для них смысла или приводят к ошибкам, потому что к подклассу не применимы. А некоторые языки допускают только одиночное наследование (подкласс может наследоваться лишь от одного класса), что ещё сильнее ограничивает гибкость дизайна.
Поэтому Rust идёт другим путём и для полиморфизма во время выполнения использует вместо наследования трейт-объекты. Посмотрим, как они работают.
Трейт-объекты: абстракция над общим поведением
Трейт-объекты: абстракция над общим поведением
В главе 8 мы упоминали, что у векторов есть ограничение: они хранят элементы
только одного типа. В листинге 8-9 мы обошли его, определив перечисление
SpreadsheetCell с вариантами для целых чисел, чисел с плавающей точкой и
текста. Так в каждой ячейке можно было хранить данные разного типа, и при этом
вектор по-прежнему представлял строку ячеек. Это отличное решение, когда
взаимозаменяемые элементы — фиксированный набор типов, известный при
компиляции.
Но иногда хочется, чтобы пользователь библиотеки мог сам расширять набор типов,
допустимых в определённой ситуации. Чтобы показать, как этого добиться, сделаем
пример инструмента для графического интерфейса (GUI): он перебирает список
элементов и у каждого вызывает метод draw, чтобы нарисовать его на экране, —
распространённый приём в GUI-инструментах. Создадим библиотечный крейт gui
со структурой GUI-библиотеки. В нём могут быть готовые типы, например Button
(кнопка) или TextField (текстовое поле). А пользователи gui захотят создавать
собственные типы, которые можно рисовать: один программист добавит Image
(изображение), другой — SelectBox (выпадающий список).
Когда мы пишем библиотеку, мы не можем знать и определить все типы, которые
захотят создать другие программисты. Но мы знаем, что gui должна хранить
множество значений разных типов и вызывать у каждого метод draw. Ей не нужно
точно знать, что произойдёт при вызове draw, — достаточно того, что у
значения есть такой метод.
В языке с наследованием можно было бы определить класс Component с методом
draw. Остальные классы — Button, Image, SelectBox — наследовались бы от
Component и тем самым получали бы метод draw. Каждый мог бы переопределить
draw со своим поведением, а фреймворк обращался бы со всеми этими типами как с
экземплярами Component и вызывал бы у них draw. Но наследования в Rust нет,
так что библиотеку gui нужно устроить иначе, чтобы пользователи могли
создавать новые типы, совместимые с ней.
Трейт для общего поведения
Чтобы реализовать нужное поведение gui, определим трейт Draw с одним
методом draw. Затем можно определить вектор, хранящий трейт-объекты.
Трейт-объект (trait object) указывает и на экземпляр типа, реализующего
заданный трейт, и на таблицу, по которой во время выполнения ищутся методы
трейта для этого типа. Трейт-объект создаётся так: указывается какой-нибудь
указатель — ссылка или умный указатель Box<T>, — затем ключевое слово dyn и
нужный трейт. (Почему трейт-объекты обязательно используют указатель, мы
поговорим в разделе «Типы с динамическим размером и трейт
Sized» главы 20.) Трейт-объекты можно
использовать вместо обобщённого или конкретного типа. Где бы мы ни
использовали трейт-объект, система типов Rust при компиляции проверит, что
любое значение в этом контексте реализует трейт трейт-объекта. Поэтому все
возможные типы при компиляции знать не нужно.
Мы уже говорили, что в Rust структуры и перечисления не называют «объектами»,
чтобы отличать их от объектов других языков. В структуре или перечислении данные
в полях и поведение в блоках impl разделены, а в других языках данные и
поведение, объединённые в одно понятие, часто и называют объектом.
Трейт-объекты отличаются от объектов других языков тем, что добавить в
трейт-объект данные нельзя. Трейт-объекты не так универсальны, как объекты в
других языках: их конкретное назначение — абстракция над общим поведением.
В листинге 18-3 — определение трейта Draw с одним методом draw.
pub trait Draw {
fn draw(&self);
}DrawЭтот синтаксис должен быть знаком по главе 10, где мы обсуждали определение
трейтов. А дальше — новый синтаксис: в листинге 18-4 определена структура
Screen (экран) с вектором components. Тип вектора — Box<dyn Draw>, то есть
трейт-объект: заменитель для любого типа внутри Box, реализующего трейт
Draw.
pub trait Draw {
fn draw(&self);
}
pub struct Screen {
pub components: Vec<Box<dyn Draw>>,
}Screen с полем components — вектором трейт-объектов, реализующих трейт DrawОпределим для структуры Screen метод run, который вызывает метод draw у
каждого элемента components, как в листинге 18-5.
pub trait Draw {
fn draw(&self);
}
pub struct Screen {
pub components: Vec<Box<dyn Draw>>,
}
impl Screen {
pub fn run(&self) {
for component in self.components.iter() {
component.draw();
}
}
}run у Screen, вызывающий метод draw у каждого компонентаЭто работает иначе, чем структура с обобщённым параметром типа и ограничениями
трейтами. Вместо обобщённого параметра подставляется ровно один конкретный тип
сразу для всех значений, а на место трейт-объекта во время выполнения можно
подставлять разные конкретные типы. Например,
структуру Screen можно было определить с обобщённым типом и ограничением
трейтом, как в листинге 18-6.
pub trait Draw {
fn draw(&self);
}
pub struct Screen<T: Draw> {
pub components: Vec<T>,
}
impl<T> Screen<T>
where
T: Draw,
{
pub fn run(&self) {
for component in self.components.iter() {
component.draw();
}
}
}Screen и её метода run через обобщения и ограничения трейтамиТогда экземпляр Screen может хранить список компонентов, которые все либо
типа Button, либо все типа TextField. Если коллекции у вас всегда однородные,
лучше использовать обобщения и ограничения трейтами: определения будут
мономорфизированы при компиляции под конкретные типы.
А с методом на трейт-объектах один экземпляр Screen может хранить Vec<T>, в
котором есть и Box<Button>, и Box<TextField>. Посмотрим, как это работает, а
потом поговорим о влиянии на производительность.
Реализация трейта
Теперь добавим несколько типов, реализующих трейт Draw. Сделаем тип Button.
Опять же, настоящая реализация GUI-библиотеки выходит за рамки этой книги,
поэтому в теле метода draw ничего полезного не будет. Чтобы представить, как
могла бы выглядеть реализация, пусть у структуры Button будут поля width,
height и label (подпись), как в листинге 18-7.
pub trait Draw {
fn draw(&self);
}
pub struct Screen {
pub components: Vec<Box<dyn Draw>>,
}
impl Screen {
pub fn run(&self) {
for component in self.components.iter() {
component.draw();
}
}
}
pub struct Button {
pub width: u32,
pub height: u32,
pub label: String,
}
impl Draw for Button {
fn draw(&self) {
// код, который на самом деле рисует кнопку
}
}Button, реализующая трейт DrawПоля width, height и label у Button отличаются от полей других
компонентов: например, у TextField могут быть те же поля плюс поле
placeholder. Каждый тип, который мы хотим рисовать на экране, реализует трейт
Draw, но в методе draw у каждого свой код — как рисовать именно этот тип, как
здесь у Button (только, как сказано, без настоящего кода GUI). У Button,
например, может быть ещё один блок impl с методами о том, что происходит, когда
пользователь нажимает кнопку. К типам вроде TextField такие методы не
относятся.
Если кто-то, пользуясь нашей библиотекой, решит реализовать структуру
SelectBox с полями width, height и options (варианты), он реализует трейт
Draw и для типа SelectBox, как в листинге 18-8.
use gui::Draw;
struct SelectBox {
width: u32,
height: u32,
options: Vec<String>,
}
impl Draw for SelectBox {
fn draw(&self) {
// код, который на самом деле рисует выпадающий список
}
}
fn main() {}gui и реализует трейт Draw для структуры SelectBoxТеперь пользователь библиотеки может написать функцию main, создающую
экземпляр Screen, и добавить в него SelectBox и Button, поместив каждый в
Box<T>, чтобы получить трейт-объекты. Затем он вызывает у экземпляра Screen
метод run, который вызовет draw у каждого компонента. Эта реализация — в
листинге 18-9.
use gui::Draw;
struct SelectBox {
width: u32,
height: u32,
options: Vec<String>,
}
impl Draw for SelectBox {
fn draw(&self) {
// код, который на самом деле рисует выпадающий список
}
}
use gui::{Button, Screen};
fn main() {
let screen = Screen {
components: vec![
Box::new(SelectBox {
width: 75,
height: 10,
options: vec![
String::from("Yes"),
String::from("Maybe"),
String::from("No"),
],
}),
Box::new(Button {
width: 50,
height: 10,
label: String::from("OK"),
}),
],
};
screen.run();
}Когда мы писали библиотеку, мы не знали, что кто-то добавит тип SelectBox, но
наша реализация Screen смогла работать с новым типом и нарисовать его,
потому что SelectBox реализует трейт Draw, а значит, и метод draw.
Такой подход — интересоваться только тем, на какие сообщения отвечает
значение, а не его конкретным типом, — похож на утиную типизацию (duck
typing) в динамически типизированных языках: если что-то ходит как утка и
крякает как утка, значит, это утка! В реализации run для Screen из листинга
18-5 методу run не нужно знать конкретный тип каждого компонента. Он не
проверяет, экземпляр ли это Button или SelectBox, а просто вызывает у
компонента метод draw. Указав тип значений вектора components как
Box<dyn Draw>, мы определили, что Screen нужны значения, у которых можно
вызвать метод draw.
Преимущество трейт-объектов и системы типов Rust перед утиной типизацией в том, что во время выполнения никогда не нужно проверять, реализует ли значение определённый метод, и не нужно бояться ошибки, если значение метод не реализует, а мы его всё равно вызвали. Rust просто не скомпилирует код, если значения не реализуют трейты, которые нужны трейт-объектам.
Например, листинг 18-10 показывает, что будет, если попытаться создать Screen
со String в качестве компонента.
use gui::Screen;
fn main() {
let screen = Screen {
components: vec![Box::new(String::from("Hi"))],
};
screen.run();
}Получим ошибку, потому что String не реализует трейт Draw:
$ cargo run
Compiling gui v0.1.0 (file:///projects/gui)
error[E0277]: the trait bound `String: Draw` is not satisfied
--> src/main.rs:5:26
|
5 | components: vec![Box::new(String::from("Hi"))],
| ^^^^^^^^^^^^^^^^^^^^^^^^^^^^ the trait `Draw` is not implemented for `String`
|
help: the trait `Draw` is implemented for `Button`
--> src/lib.rs:23:1
|
23 | impl Draw for Button {
| ^^^^^^^^^^^^^^^^^^^^
= note: required for the cast from `Box<String>` to `Box<dyn Draw>`
For more information about this error, try `rustc --explain E0277`.
error: could not compile `gui` (bin "gui") due to 1 previous error
Эта ошибка говорит, что либо мы передаём в Screen не то, что собирались, и
нужно передать другой тип, либо нужно реализовать Draw для String, чтобы
Screen мог вызвать у неё draw.
Динамическая диспетчеризация
Вспомните раздел «Производительность кода с обобщениями» главы 10, где мы обсуждали мономорфизацию, которую компилятор выполняет для обобщений: для каждого конкретного типа, подставленного вместо обобщённого параметра, компилятор генерирует необобщённые реализации функций и методов. Код, получающийся в результате мономорфизации, использует статическую диспетчеризацию (static dispatch): компилятор при компиляции знает, какой метод вы вызываете. Противоположность — динамическая диспетчеризация (dynamic dispatch): компилятор при компиляции не может сказать, какой метод вызывается. В этом случае он генерирует код, который узнает нужный метод во время выполнения.
С трейт-объектами Rust вынужден использовать динамическую диспетчеризацию. Компилятор не знает всех типов, которые могут использоваться с кодом на трейт-объектах, поэтому не знает, метод какого типа вызывать. Вместо этого во время выполнения Rust по указателям внутри трейт-объекта определяет, какой метод вызвать. Этот поиск стоит времени во время выполнения — при статической диспетчеризации таких затрат нет. Кроме того, динамическая диспетчеризация не даёт компилятору встроить (inline) код метода, а значит, мешает некоторым оптимизациям. Ещё в Rust есть правила о том, где можно и где нельзя использовать динамическую диспетчеризацию, — dyn-совместимость (dyn compatibility). Эти правила выходят за рамки обсуждения, но подробнее о них можно прочитать в справочнике. Зато код из листинга 18-5 получился гибче, и мы смогли поддержать сценарий из листинга 18-9, — так что это компромисс, который стоит взвешивать.
Реализация объектно-ориентированного паттерна
Реализация объектно-ориентированного паттерна
Паттерн «Состояние» (state pattern) — объектно-ориентированный шаблон проектирования. Его суть в том, что мы определяем набор состояний, в которых может находиться значение. Состояния представлены набором объектов-состояний (state objects), а поведение значения меняется в зависимости от его состояния. Мы разберём пример структуры записи в блоге (post) с полем для состояния — объекта-состояния из набора «черновик», «на проверке» и «опубликовано».
У объектов-состояний общая функциональность: в Rust, конечно, для этого служат структуры и трейты, а не объекты и наследование. Каждый объект-состояние отвечает за собственное поведение и за то, когда переходить в другое состояние. Значение, которое хранит объект-состояние, ничего не знает ни о разном поведении состояний, ни о том, когда переходить между ними.
Преимущество паттерна «Состояние» в том, что при изменении бизнес-требований не нужно менять ни код значения, хранящего состояние, ни код, который это значение использует. Достаточно поправить код внутри одного из объектов-состояний, чтобы поменять его правила, или добавить новые объекты-состояния.
Сначала мы реализуем паттерн «Состояние» в более традиционном объектно-ориентированном стиле. Затем воспользуемся подходом, более естественным для Rust. Давайте шаг за шагом реализуем процесс публикации записи в блоге с помощью этого паттерна.
Итоговая функциональность будет такой:
- Запись в блоге создаётся как пустой черновик.
- Когда черновик готов, запрашивается проверка записи.
- Когда запись одобрена, она публикуется.
- Только опубликованные записи возвращают текст для вывода, чтобы неодобренные записи нельзя было случайно опубликовать.
Любые другие попытки изменить запись не должны ни на что влиять. Например, если попытаться одобрить черновик, не запросив перед этим проверку, запись должна остаться неопубликованным черновиком.
Попытка в традиционном объектно-ориентированном стиле
Устроить код для решения одной и той же задачи можно бесконечным числом способов, и у каждого свои компромиссы. Реализация в этом разделе выдержана в традиционном объектно-ориентированном стиле: на Rust так писать можно, но некоторые его сильные стороны остаются неиспользованными. Позже мы покажем другое решение, которое всё ещё использует объектно-ориентированный паттерн, но устроено так, что программистам с опытом ООП может показаться менее привычным. Сравнив два решения, мы прочувствуем, чем проектирование кода на Rust отличается от проектирования на других языках.
В листинге 18-11 этот процесс записан в виде кода: это пример использования
API, который мы реализуем в библиотечном крейте blog. Пока код не
скомпилируется — крейт blog ещё не написан.
use blog::Post;
fn main() {
let mut post = Post::new();
post.add_text("I ate a salad for lunch today");
assert_eq!("", post.content());
post.request_review();
assert_eq!("", post.content());
post.approve();
assert_eq!("I ate a salad for lunch today", post.content());
}blogМы хотим, чтобы пользователь мог создать новый черновик записи через
Post::new и добавить в запись текст. Если сразу же, до одобрения, попытаться
получить содержимое записи, текста быть не должно: запись ещё черновик.
assert_eq! мы добавили в код для наглядности. Отличным модульным тестом было
бы проверить, что черновик возвращает из метода content пустую строку, но
тесты для этого примера мы писать не будем.
Дальше мы хотим разрешить запросить проверку записи, и пока идёт проверка,
content должен возвращать пустую строку. Когда запись одобрят, она должна
быть опубликована — то есть вызов content будет возвращать текст записи.
Заметьте, что из всего крейта мы работаем только с типом Post. Этот тип будет
использовать паттерн «Состояние» и хранить значение — один из трёх
объектов-состояний, соответствующих возможным состояниям записи: черновик, на
проверке или опубликовано. Переходы из одного состояния в другое управляются
внутри типа Post. Состояния меняются в ответ на вызовы методов, которые
пользователи библиотеки делают у экземпляра Post, но управлять переходами
напрямую им не нужно. И ошибиться с состояниями — например, опубликовать запись
до проверки — пользователи не смогут.
Определяем Post и создаём новый экземпляр
Приступим к реализации библиотеки! Мы знаем, что нужна публичная структура
Post, хранящая содержимое. Начнём с определения структуры и публичной
ассоциированной функции new, создающей экземпляр Post, как в листинге
18-12. Ещё сделаем приватный трейт State, который задаёт поведение, общее для
всех объектов-состояний записи Post.
Post будет хранить объект-состояние в приватном поле state — трейт-объект
Box<dyn State> внутри Option<T>. Зачем нужен Option<T>, станет ясно чуть
позже.
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
}
trait State {}
struct Draft {}
impl State for Draft {}Post и функции new, создающей новый экземпляр Post, трейта State и структуры DraftТрейт State задаёт поведение, общее для разных состояний записи.
Объекты-состояния — Draft (черновик), PendingReview (ожидает проверки) и
Published (опубликовано), и все они будут реализовывать трейт State. Пока у
трейта нет методов, и мы начнём с определения только состояния Draft: именно
в нём запись должна начинать жизнь.
При создании нового Post мы записываем в поле state значение Some с
Box внутри. Этот Box указывает на новый экземпляр структуры Draft. Так
любой новый экземпляр Post начинает с состояния черновика. Поле state у
Post приватное, поэтому создать Post в каком-либо другом состоянии
невозможно! В функции Post::new поле content получает новую пустую
String.
Храним текст записи
В листинге 18-11 мы видели, что хотим вызывать метод add_text и передавать
ему &str, который добавляется к тексту записи. Мы делаем это методом, а не
открываем поле content через pub, чтобы потом реализовать метод,
управляющий тем, как читаются данные поля content. Метод add_text довольно
простой, так что добавим его реализацию из листинга 18-13 в блок impl Post.
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
// --пропуск--
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
}
trait State {}
struct Draft {}
impl State for Draft {}add_text, который добавляет текст в content записиМетод add_text принимает изменяемую ссылку на self, потому что меняет
экземпляр Post, у которого его вызвали. Затем у String в content вызываем
push_str и передаём аргумент text, чтобы дописать его к сохранённому
content. Это поведение не зависит от состояния записи, поэтому к паттерну
«Состояние» не относится. Метод add_text вообще не трогает поле state, но
это часть поведения, которое мы хотим поддерживать.
У черновика содержимое пустое
Даже после того, как мы вызвали add_text и добавили в запись текст, метод
content должен возвращать пустой строковый срез — ведь запись всё ещё
черновик, как показывает первый assert_eq! в листинге 18-11. Пока реализуем
метод content самым простым способом, удовлетворяющим этому требованию:
всегда возвращаем пустой строковый срез. Поменяем это позже, когда реализуем
изменение состояния записи и её публикацию. Пока запись может быть только
черновиком, так что её содержимое всегда должно быть пустым. Эта
реализация-заглушка — в листинге 18-14.
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
// --пропуск--
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn content(&self) -> &str {
""
}
}
trait State {}
struct Draft {}
impl State for Draft {}content у Post заглушку, которая всегда возвращает пустой строковый срезС этим методом content всё в листинге 18-11 вплоть до первого assert_eq!
работает как задумано.
Запрос проверки меняет состояние записи
Теперь нужно добавить запрос проверки записи, который переводит её из
состояния Draft в PendingReview. Этот код — в листинге 18-15.
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
// --пропуск--
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn content(&self) -> &str {
""
}
pub fn request_review(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.request_review())
}
}
}
trait State {
fn request_review(self: Box<Self>) -> Box<dyn State>;
}
struct Draft {}
impl State for Draft {
fn request_review(self: Box<Self>) -> Box<dyn State> {
Box::new(PendingReview {})
}
}
struct PendingReview {}
impl State for PendingReview {
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
}request_review у Post и у трейта StateДаём Post публичный метод request_review, который принимает изменяемую
ссылку на self. Внутри вызываем внутренний метод request_review у текущего
состояния Post, и этот второй request_review поглощает текущее состояние и
возвращает новое.
Метод request_review мы добавляем в трейт State; теперь все типы,
реализующие этот трейт, обязаны реализовать request_review. Обратите
внимание: первым параметром метода стоит не self, &self или &mut self, а
self: Box<Self>. Такая запись означает, что метод можно вызвать, только если
тип лежит в Box. Метод забирает владение Box<Self>, делая старое состояние
недействительным, чтобы значение состояния Post могло превратиться в новое.
Чтобы поглотить старое состояние, методу request_review нужно забрать
владение значением состояния. Тут и пригождается Option в поле state
структуры Post: методом take мы забираем значение Some из поля state, а
на его месте оставляем None — Rust не допускает в структурах незаполненных
полей. Так значение state можно переместить из Post, а не позаимствовать.
Затем записываем в поле state записи результат операции.
Почему нельзя просто написать self.state = self.state.request_review();?
Потому что нам нужно забрать владение значением state, а для этого на его
место приходится временно поставить None. Зато так Post гарантированно не
сможет пользоваться старым значением state после того, как мы превратили его
в новое состояние.
Метод request_review у Draft возвращает новый экземпляр структуры
PendingReview в коробке — это состояние, когда запись ждёт проверки.
Структура PendingReview тоже реализует метод request_review, но никаких
превращений не делает, а возвращает саму себя: если запросить проверку у
записи, которая уже в состоянии PendingReview, она должна в нём и остаться.
Теперь начинают проявляться преимущества паттерна «Состояние»: метод
request_review у Post один и тот же, каким бы ни было значение state.
Каждое состояние отвечает за свои правила.
Метод content у Post оставим как есть — он возвращает пустой строковый
срез. Теперь Post может быть и в состоянии PendingReview, и в Draft, но в
PendingReview поведение должно быть таким же. Листинг 18-11 теперь работает
вплоть до второго вызова assert_eq!!
approve меняет поведение content
Метод approve (одобрить) будет похож на request_review: он записывает в
state то значение, которое, по словам текущего состояния, должно быть после
одобрения, как в листинге 18-16.
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
// --пропуск--
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn content(&self) -> &str {
""
}
pub fn request_review(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.request_review())
}
}
pub fn approve(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.approve())
}
}
}
trait State {
fn request_review(self: Box<Self>) -> Box<dyn State>;
fn approve(self: Box<Self>) -> Box<dyn State>;
}
struct Draft {}
impl State for Draft {
// --пропуск--
fn request_review(self: Box<Self>) -> Box<dyn State> {
Box::new(PendingReview {})
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
}
struct PendingReview {}
impl State for PendingReview {
// --пропуск--
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
Box::new(Published {})
}
}
struct Published {}
impl State for Published {
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
}approve у Post и у трейта StateДобавляем метод approve в трейт State и новую структуру, реализующую
State, — состояние Published.
Как и request_review у PendingReview, вызов approve у Draft ни на что не
повлияет: approve вернёт self. А вызов approve у PendingReview вернёт
новый экземпляр структуры Published в коробке. Структура Published
реализует трейт State и в обоих методах — и request_review, и approve —
возвращает саму себя: в этих случаях запись должна оставаться в состоянии
Published.
Теперь нужно обновить метод content у Post. Мы хотим, чтобы значение,
которое возвращает content, зависело от текущего состояния Post, поэтому
пусть Post делегирует работу методу content, определённому у его state,
как в листинге 18-17.
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
// --пропуск--
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn content(&self) -> &str {
self.state.as_ref().unwrap().content(self)
}
// --пропуск--
pub fn request_review(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.request_review())
}
}
pub fn approve(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.approve())
}
}
}
trait State {
fn request_review(self: Box<Self>) -> Box<dyn State>;
fn approve(self: Box<Self>) -> Box<dyn State>;
}
struct Draft {}
impl State for Draft {
fn request_review(self: Box<Self>) -> Box<dyn State> {
Box::new(PendingReview {})
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
}
struct PendingReview {}
impl State for PendingReview {
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
Box::new(Published {})
}
}
struct Published {}
impl State for Published {
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
}content у Post, чтобы он делегировал работу методу content у StateНаша цель — держать все эти правила внутри структур, реализующих State,
поэтому мы вызываем метод content у значения в state и передаём аргументом
экземпляр записи (то есть self). А возвращаем то, что вернул метод content
у значения state.
У Option мы вызываем метод as_ref, потому что нам нужна ссылка на значение
внутри Option, а не владение им. state имеет тип Option<Box<dyn State>>,
поэтому as_ref вернёт Option<&Box<dyn State>>. Не вызови мы as_ref, была
бы ошибка: нельзя переместить state из заимствованного параметра &self.
Затем вызываем метод unwrap, который, как мы знаем, никогда не запаникует:
методы Post гарантируют, что по их завершении в state всегда лежит Some.
Это один из случаев, о которых мы говорили в разделе «Когда вы знаете больше
компилятора» главы 9: мы знаем, что
None здесь невозможен, хотя компилятор понять этого не может.
Теперь, когда мы вызываем content у &Box<dyn State>, неявное разыменование
срабатывает и для &, и для Box, так что метод content в итоге вызовется у
типа, реализующего трейт State. Значит, нужно добавить content в
определение трейта State — туда мы и поместим логику, какое содержимое
возвращать в зависимости от состояния, как в листинге 18-18.
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn content(&self) -> &str {
self.state.as_ref().unwrap().content(self)
}
pub fn request_review(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.request_review())
}
}
pub fn approve(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.approve())
}
}
}
trait State {
// --пропуск--
fn request_review(self: Box<Self>) -> Box<dyn State>;
fn approve(self: Box<Self>) -> Box<dyn State>;
fn content<'a>(&self, post: &'a Post) -> &'a str {
""
}
}
// --пропуск--
struct Draft {}
impl State for Draft {
fn request_review(self: Box<Self>) -> Box<dyn State> {
Box::new(PendingReview {})
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
}
struct PendingReview {}
impl State for PendingReview {
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
Box::new(Published {})
}
}
struct Published {}
impl State for Published {
// --пропуск--
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
fn content<'a>(&self, post: &'a Post) -> &'a str {
&post.content
}
}content в трейт StateМы добавляем для метода content реализацию по умолчанию, которая возвращает
пустой строковый срез. Значит, реализовывать content для структур Draft и
PendingReview не нужно. Структура Published переопределит метод content и
вернёт значение из post.content. Это удобно, но граница между обязанностями
State и Post при этом размывается: что возвращать в качестве содержимого
Post, теперь решает метод content у State.
Обратите внимание: у этого метода нужны аннотации времени жизни, как мы
обсуждали в главе 10. Мы принимаем аргументом ссылку на post и возвращаем
ссылку на часть этого post, так что время жизни возвращаемой ссылки связано
со временем жизни аргумента post.
Готово — весь листинг 18-11 теперь работает! Мы реализовали паттерн
«Состояние» с правилами процесса публикации записи. Логика, связанная с
правилами, живёт в объектах-состояниях, а не разбросана по Post.
А почему не перечисление?
Возможно, вы задумались, почему мы не использовали перечисление с
возможными состояниями записи в качестве вариантов. Это, безусловно, тоже
решение — попробуйте и сравните результаты, чтобы понять, что вам больше
нравится! Один из недостатков перечисления в том, что в каждом месте, где
проверяется его значение, нужно выражение match или что-то подобное, чтобы
обработать все возможные варианты. Повторений может оказаться больше, чем в
решении с трейт-объектами.
Оценка паттерна «Состояние»
Мы показали, что на Rust можно реализовать объектно-ориентированный паттерн
«Состояние» и инкапсулировать разное поведение записи в каждом состоянии.
Методы Post ничего не знают о разных вариантах поведения. Благодаря такой
организации кода, чтобы узнать, как может вести себя опубликованная запись,
достаточно посмотреть в одно место — в реализацию трейта State для структуры
Published.
Если бы мы сделали альтернативную реализацию без паттерна «Состояние», то,
возможно, использовали бы выражения match в методах Post или даже в коде
main, проверяя состояние записи и меняя поведение прямо там. Тогда, чтобы
понять все последствия того, что запись опубликована, пришлось бы заглядывать в
несколько мест.
С паттерном «Состояние» ни методам Post, ни местам, где используется Post,
выражения match не нужны, а чтобы добавить новое состояние, достаточно
добавить новую структуру и реализовать методы трейта для неё одной — в одном
месте.
Реализацию на паттерне «Состояние» легко расширять. Чтобы убедиться, насколько просто поддерживать такой код, попробуйте выполнить несколько заданий:
- Добавьте метод
reject(отклонить), который возвращает запись из состоянияPendingReviewобратно вDraft. - Сделайте так, чтобы для перехода в
Publishedтребовалось два вызоваapprove. - Разрешите пользователям добавлять текст, только когда запись в состоянии
Draft. Подсказка: пусть объект-состояние отвечает за то, что может меняться в содержимом, но не отвечает за изменение самогоPost.
Один из недостатков паттерна «Состояние» в том, что переходы между
состояниями реализуют сами состояния, а значит, некоторые состояния связаны
друг с другом. Если добавить ещё одно состояние между PendingReview и
Published, например Scheduled (запланировано), придётся изменить код
PendingReview, чтобы он переходил в Scheduled. Было бы проще, если бы
PendingReview не приходилось менять при добавлении нового состояния, но это
означало бы переход на другой паттерн.
Другой недостаток — часть логики дублируется. Чтобы убрать часть
дублирования, можно попробовать сделать в трейте State реализации методов
request_review и approve по умолчанию, возвращающие self. Но так не
выйдет: когда State используется как трейт-объект, трейт не знает, каким
именно будет конкретный self, так что возвращаемый тип неизвестен при
компиляции. (Это одно из правил dyn-совместимости, о которых говорилось
раньше.)
Есть и другое дублирование: похожие реализации методов request_review и
approve у Post. Оба метода применяют Option::take к полю state структуры
Post и, если state — это Some, делегируют работу одноимённому методу
обёрнутого значения и записывают результат в поле state. Будь у Post много
таких методов, можно было бы определить макрос, чтобы убрать повторы (см.
раздел «Макросы» главы 20).
Реализуя паттерн «Состояние» в точности так, как он определён для
объектно-ориентированных языков, мы используем сильные стороны Rust не в
полной мере. Посмотрим, как изменить крейт blog, чтобы недопустимые
состояния и переходы стали ошибками компиляции.
Состояния и поведение как типы
Покажем, как переосмыслить паттерн «Состояние» и получить другой набор компромиссов. Вместо того чтобы полностью инкапсулировать состояния и переходы, скрыв их от внешнего кода, закодируем состояния в виде разных типов. Тогда система проверки типов Rust не даст использовать черновики там, где допустимы только опубликованные записи, — выдаст ошибку компиляции.
Вспомним первую часть main из листинга 18-11:
use blog::Post;
fn main() {
let mut post = Post::new();
post.add_text("I ate a salad for lunch today");
assert_eq!("", post.content());
post.request_review();
assert_eq!("", post.content());
post.approve();
assert_eq!("I ate a salad for lunch today", post.content());
}Мы по-прежнему позволяем создавать новые записи в состоянии черновика через
Post::new и добавлять текст в содержимое записи. Но вместо метода content у
черновика, возвращающего пустую строку, сделаем так, чтобы у черновиков метода
content вообще не было. Тогда попытка получить содержимое черновика приведёт
к ошибке компиляции: такого метода нет. В итоге случайно показать содержимое
черновика в продакшене станет невозможно — такой код просто не скомпилируется.
В листинге 18-19 — определения структур Post и DraftPost и методов каждой.
pub struct Post {
content: String,
}
pub struct DraftPost {
content: String,
}
impl Post {
pub fn new() -> DraftPost {
DraftPost {
content: String::new(),
}
}
pub fn content(&self) -> &str {
&self.content
}
}
impl DraftPost {
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
}Post с методом content и DraftPost без метода contentУ обеих структур, Post и DraftPost, есть приватное поле content, в
котором хранится текст записи. Поля state у структур больше нет: состояние
теперь кодируется типами структур. Структура Post будет представлять
опубликованную запись, и у неё есть метод content, возвращающий content.
Функция Post::new по-прежнему есть, но возвращает она не экземпляр Post, а
экземпляр DraftPost. Поле content приватное, и функций, возвращающих
Post, нет, так что создать экземпляр Post сейчас невозможно.
У структуры DraftPost есть метод add_text, так что добавлять текст в
content можно, как и раньше, но, заметьте, метода content у DraftPost
нет! Теперь программа гарантирует, что любая запись начинается как черновик, а
содержимое черновика показать нельзя. Любая попытка обойти эти ограничения
приведёт к ошибке компиляции.
Как же получить опубликованную запись? Мы хотим обеспечить правило: черновик
должен пройти проверку и быть одобрен, прежде чем его опубликуют. Запись,
ожидающая проверки, тоже не должна показывать содержимое. Реализуем эти
ограничения: добавим ещё одну структуру, PendingReviewPost, определим у
DraftPost метод request_review, возвращающий PendingReviewPost, а у
PendingReviewPost — метод approve, возвращающий Post, как в листинге 18-20.
pub struct Post {
content: String,
}
pub struct DraftPost {
content: String,
}
impl Post {
pub fn new() -> DraftPost {
DraftPost {
content: String::new(),
}
}
pub fn content(&self) -> &str {
&self.content
}
}
impl DraftPost {
// --пропуск--
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn request_review(self) -> PendingReviewPost {
PendingReviewPost {
content: self.content,
}
}
}
pub struct PendingReviewPost {
content: String,
}
impl PendingReviewPost {
pub fn approve(self) -> Post {
Post {
content: self.content,
}
}
}PendingReviewPost создаётся вызовом request_review у DraftPost, а метод approve превращает PendingReviewPost в опубликованный PostМетоды request_review и approve забирают владение self, то есть поглощают
экземпляры DraftPost и PendingReviewPost и превращают их соответственно в
PendingReviewPost и опубликованный Post. Так после вызова request_review у
DraftPost никаких «повисших» экземпляров DraftPost не остаётся, и так далее.
У структуры PendingReviewPost нет метода content, так что попытка прочитать
её содержимое, как и у DraftPost, приводит к ошибке компиляции. Единственный
способ получить опубликованный экземпляр Post, у которого метод content
есть, — вызвать approve у PendingReviewPost. А единственный способ получить
PendingReviewPost — вызвать request_review у DraftPost. Тем самым мы
закодировали процесс публикации записи в системе типов.
Но в main тоже придётся внести небольшие изменения. Методы request_review и
approve возвращают новые экземпляры, а не меняют структуру, у которой их
вызвали, поэтому нужно добавить ещё затеняющих присваиваний let post =, чтобы
сохранять возвращённые экземпляры. Проверки, что содержимое черновика и записи
на проверке — пустые строки, тоже придётся убрать, да они и не нужны: код,
который пытается использовать содержимое записей в этих состояниях, больше не
скомпилируется. Обновлённый код main — в листинге 18-21.
use blog::Post;
fn main() {
let mut post = Post::new();
post.add_text("I ate a salad for lunch today");
let post = post.request_review();
let post = post.approve();
assert_eq!("I ate a salad for lunch today", post.content());
}main для новой реализации процесса публикации записиРаз в main приходится заново присваивать post, эта реализация уже не
совсем следует объектно-ориентированному паттерну «Состояние»: переходы между
состояниями больше не инкапсулированы целиком в реализации Post. Зато мы
выиграли в другом: благодаря системе типов и проверке типов при компиляции
недопустимые состояния теперь невозможны! Это гарантирует, что некоторые баги —
например, показ содержимого неопубликованной записи — будут найдены ещё до
того, как код попадёт в продакшен.
Попробуйте выполнить задания из начала этого раздела для крейта blog в том
виде, в каком он стал после листинга 18-21, и оцените, как вам дизайн этой
версии кода. Учтите, что некоторые задания в таком дизайне, возможно, уже
выполнены.
Мы увидели, что, хотя на Rust можно реализовывать объектно-ориентированные паттерны, в нём доступны и другие — например, кодирование состояния в системе типов. У этих паттернов разные компромиссы. Даже если вам хорошо знакомы объектно-ориентированные паттерны, переосмысление задачи с учётом возможностей Rust может дать преимущества — например, предотвращать некоторые баги ещё при компиляции. Объектно-ориентированные паттерны не всегда будут лучшим решением в Rust, потому что в нём есть возможности вроде владения, которых нет в объектно-ориентированных языках.
Итоги
Считаете ли вы после этой главы Rust объектно-ориентированным языком или нет, теперь вы знаете, что с помощью трейт-объектов можно получить в Rust некоторые объектно-ориентированные возможности. Динамическая диспетчеризация даёт коду гибкость ценой небольшой доли производительности во время выполнения. Эту гибкость можно использовать, чтобы реализовывать объектно-ориентированные паттерны, облегчающие сопровождение кода. А ещё в Rust есть возможности вроде владения, которых нет в объектно-ориентированных языках. Объектно-ориентированный паттерн — не всегда лучший способ использовать сильные стороны Rust, но такой вариант у вас есть.
Дальше мы рассмотрим образцы — ещё одну возможность Rust, дающую много гибкости. Мы бегло встречали их на протяжении всей книги, но всех их возможностей ещё не видели. Вперёд!
Образцы и сопоставление
Образцы (patterns) — это особый синтаксис Rust для сопоставления со
структурой типов, как сложных, так и простых. Образцы вместе с выражениями
match и другими конструкциями дают больше контроля над тем, как выполняется
программа. Образец состоит из некоторого сочетания следующего:
- литералов;
- деструктурированных массивов, перечислений, структур или кортежей;
- переменных;
- подстановочных знаков (wildcards);
- заполнителей (placeholders).
Примеры образцов: x, (a, 3) и Some(Color::Red). В тех местах, где образцы
допустимы, эти составные части описывают форму данных. Программа сопоставляет
значения с образцами, чтобы определить, подходит ли форма данных для того,
чтобы выполнить определённый фрагмент кода.
Чтобы использовать образец, его сравнивают с каким-то значением. Если образец
совпадает со значением, части этого значения можно использовать в коде.
Вспомните выражения match из главы 6 с образцами — например, пример с
автоматом для сортировки монет. Если значение подходит под форму образца, можно
пользоваться его именованными частями. Если нет — код, связанный с образцом, не
выполнится.
Эта глава — справочник по всему, что касается образцов. Мы разберём, где можно использовать образцы, чем опровержимые образцы отличаются от неопровержимых и какие бывают разновидности синтаксиса образцов. К концу главы вы будете знать, как с помощью образцов ясно выражать самые разные идеи.
Где можно использовать образцы
Где можно использовать образцы
Образцы встречаются в Rust во многих местах, и вы уже много ими пользовались, сами того не замечая! В этом разделе перечислены все места, где образцы допустимы.
Ветки match
Как говорилось в главе 6, образцы используются в ветках выражений match.
Формально выражение match состоит из ключевого слова match, значения для
сопоставления и одной или нескольких веток. Каждая ветка — это образец и
выражение, которое выполняется, если значение совпало с образцом ветки:
match ЗНАЧЕНИЕ {
ОБРАЗЕЦ => ВЫРАЖЕНИЕ,
ОБРАЗЕЦ => ВЫРАЖЕНИЕ,
ОБРАЗЕЦ => ВЫРАЖЕНИЕ,
}Например, вот выражение match из листинга 6-5, которое сопоставляет значение
Option<i32> в переменной x:
match x {
None => None,
Some(i) => Some(i + 1),
}Образцы в этом выражении match — None и Some(i) слева от каждой стрелки.
Одно из требований к выражениям match — они должны быть исчерпывающими: все
возможные значения в выражении match должны быть учтены. Один из способов
гарантировать, что вы покрыли все случаи, — сделать последнюю ветку
«для всего остального». Например, образец из одного имени переменной
совпадает с любым значением, поэтому такая ветка покрывает все оставшиеся
случаи.
Особый образец _ совпадает с чем угодно, но никогда не привязывается к
переменной, поэтому его часто используют в последней ветке. Образец _ удобен,
например, когда нужно проигнорировать все значения, не указанные явно. Подробнее
об образце _ — в разделе «Игнорирование значений в
образце» дальше в этой главе.
Инструкции let
До этой главы мы явно говорили об образцах только в связи с match и if let,
но на самом деле пользовались ими и в других местах — в том числе в
инструкциях let. Возьмём, например, простое присваивание с let:
#![allow(unused)]
fn main() {
let x = 5;
}Каждый раз, когда вы писали подобную инструкцию let, вы пользовались
образцами, даже если не догадывались об этом! Формально инструкция let
выглядит так:
let ОБРАЗЕЦ = ВЫРАЖЕНИЕ;
В инструкциях вроде let x = 5;, где на месте ОБРАЗЦА стоит имя переменной,
имя переменной — просто очень простая разновидность образца. Rust сравнивает
выражение с образцом и привязывает все найденные имена. Так что в примере
let x = 5; x — это образец, который означает «привязать то, что здесь
совпадёт, к переменной x». Раз имя x — это весь образец целиком, он, по
сути, означает «привязать всё к переменной x, каким бы ни было значение».
Чтобы яснее увидеть, что в let происходит сопоставление с образцом,
посмотрите на листинг 19-1, где образец в let разбирает кортеж.
fn main() {
let (x, y, z) = (1, 2, 3);
}Здесь кортеж сопоставляется с образцом. Rust сравнивает значение (1, 2, 3) с
образцом (x, y, z) и видит, что значение совпадает с образцом — количество
элементов в них одинаковое, — поэтому привязывает 1 к x, 2 к y и 3 к
z. Этот образец кортежа можно считать тремя вложенными в него образцами
отдельных переменных.
Если количество элементов в образце не совпадает с количеством элементов кортежа, типы целиком не совпадут, и будет ошибка компиляции. Например, в листинге 19-2 попытка разобрать кортеж из трёх элементов на две переменные — так не получится.
fn main() {
let (x, y) = (1, 2, 3);
}Попытка скомпилировать этот код даёт ошибку типов:
$ cargo run
Compiling patterns v0.1.0 (file:///projects/patterns)
error[E0308]: mismatched types
--> src/main.rs:2:9
|
2 | let (x, y) = (1, 2, 3);
| ^^^^^^ --------- this expression has type `({integer}, {integer}, {integer})`
| |
| expected a tuple with 3 elements, found one with 2 elements
|
= note: expected tuple `({integer}, {integer}, {integer})`
found tuple `(_, _)`
For more information about this error, try `rustc --explain E0308`.
error: could not compile `patterns` (bin "patterns") due to 1 previous error
Чтобы исправить ошибку, можно проигнорировать одно или несколько значений
кортежа с помощью _ или .., как показано в разделе «Игнорирование значений
в образце». А если проблема в том,
что переменных в образце слишком много, нужно убрать лишние, чтобы их число
совпало с числом элементов кортежа и типы совпали.
Условные выражения if let
В главе 6 мы обсуждали выражения if let в основном как краткую запись
match, который обрабатывает только один случай. При желании у if let может
быть else с кодом, который выполнится, если образец в if let не совпал.
В листинге 19-3 видно, что можно также сочетать выражения if let, else if и
else if let. Это даёт больше гибкости, чем выражение match, где с образцами
сравнивается лишь одно значение. К тому же Rust не требует, чтобы условия в
цепочке веток if let, else if и else if let были связаны друг с другом.
Код в листинге 19-3 выбирает цвет фона, проверяя несколько условий подряд. Для этого примера мы создали переменные с вписанными в код значениями — в настоящей программе они могли бы приходить из пользовательского ввода.
fn main() {
let favorite_color: Option<&str> = None;
let is_tuesday = false;
let age: Result<u8, _> = "34".parse();
if let Some(color) = favorite_color {
println!("Using your favorite color, {color}, as the background");
} else if is_tuesday {
println!("Tuesday is green day!");
} else if let Ok(age) = age {
if age > 30 {
println!("Using purple as the background color");
} else {
println!("Using orange as the background color");
}
} else {
println!("Using blue as the background color");
}
}if let, else if, else if let и elseЕсли пользователь указал любимый цвет, фоном становится он. Если любимый цвет не указан, а сегодня вторник, фон зелёный. Иначе, если пользователь указал возраст строкой и её удалось разобрать как число, цвет будет фиолетовым или оранжевым в зависимости от числа. Если ни одно из этих условий не выполнено, фон синий.
Такая условная структура позволяет поддерживать сложные требования. С
заданными в коде значениями этот пример выведет
Using purple as the background color.
Видно, что if let, как и ветки match, может вводить новые переменные,
затеняющие существующие: строка if let Ok(age) = age вводит новую переменную
age со значением изнутри варианта Ok, затеняя прежнюю age. Поэтому условие
if age > 30 нужно поместить внутрь этого блока: объединить два условия в
if let Ok(age) = age && age > 30 нельзя. Новая age, которую мы хотим
сравнить с 30, становится действительной только с началом новой области
видимости — с фигурной скобки.
Недостаток выражений if let в том, что компилятор не проверяет, учтены ли все
случаи, а с выражениями match проверяет. Если бы мы убрали последний блок
else и тем самым пропустили какие-то случаи, компилятор не предупредил бы нас
о возможной логической ошибке.
Условные циклы while let
Условный цикл while let, устроенный похоже на if let, позволяет циклу
while выполняться, пока образец продолжает совпадать. В листинге 19-4 цикл
while let ждёт сообщений, пересылаемых между потоками, — только здесь
проверяется Result, а не Option.
fn main() {
let (tx, rx) = std::sync::mpsc::channel();
std::thread::spawn(move || {
for val in [1, 2, 3] {
tx.send(val).unwrap();
}
});
while let Ok(value) = rx.recv() {
println!("{value}");
}
}while let выводит значения, пока rx.recv() возвращает OkЭтот пример выведет 1, 2, а затем 3. Метод recv забирает первое сообщение
с принимающей стороны канала и возвращает Ok(value). Когда мы впервые увидели
recv в главе 16, мы сразу разворачивали ошибку или работали с приёмником как
с итератором в цикле for. Но, как показывает листинг 19-4, можно использовать и
while let: метод recv возвращает Ok каждый раз, когда приходит сообщение,
пока существует отправитель, а когда отправляющая сторона отключается — Err.
Циклы for
В цикле for значение сразу после ключевого слова for — это образец.
Например, в for x in y образец — x. В листинге 19-5 показано, как с помощью
образца в цикле for разобрать на части (деструктурировать) кортеж.
fn main() {
let v = vec!['a', 'b', 'c'];
for (index, value) in v.iter().enumerate() {
println!("{value} is at index {index}");
}
}for разбирает кортежКод из листинга 19-5 выведет:
$ cargo run
Compiling patterns v0.1.0 (file:///projects/patterns)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.52s
Running `target/debug/patterns`
a is at index 0
b is at index 1
c is at index 2
Мы адаптируем итератор методом enumerate, чтобы он выдавал значение вместе с
его индексом в виде кортежа. Первое выданное значение — кортеж (0, 'a').
Когда оно сопоставляется с образцом (index, value), index будет равен 0, а
value — 'a', и выведется первая строка вывода.
Параметры функций
Параметры функций тоже могут быть образцами. Код в листинге 19-6, который
объявляет функцию foo с одним параметром x типа i32, должен быть вам уже
знаком.
fn foo(x: i32) {
// здесь код
}
fn main() {}Часть x — это образец! Как и с let, кортеж в аргументах функции можно
сопоставить с образцом. В листинге 19-7 значения кортежа разделяются прямо при
передаче его в функцию.
fn print_coordinates(&(x, y): &(i32, i32)) {
println!("Current location: ({x}, {y})");
}
fn main() {
let point = (3, 5);
print_coordinates(&point);
}Этот код выводит Current location: (3, 5). Значения &(3, 5) совпадают с
образцом &(x, y), так что x — это значение 3, а y — 5.
Образцы можно использовать и в списках параметров замыканий — так же, как в списках параметров функций, ведь замыкания похожи на функции, как мы говорили в главе 13.
Итак, вы увидели несколько способов использовать образцы, но работают образцы не везде одинаково. В одних местах образцы обязаны быть неопровержимыми, в других могут быть опровержимыми. Об этих двух понятиях и пойдёт речь дальше.
Опровержимость: может ли образец не совпасть
Опровержимость: может ли образец не совпасть
Образцы бывают двух видов: опровержимые и неопровержимые. Образцы, которые
совпадают с любым возможным переданным значением, называются
неопровержимыми (irrefutable). Пример — x в инструкции let x = 5;: x
совпадает с чем угодно, а значит, не совпасть не может. Образцы, которые для
некоторых возможных значений могут не совпасть, называются опровержимыми
(refutable). Пример — Some(x) в выражении if let Some(x) = a_value: если в
переменной a_value окажется None, а не Some, образец Some(x) не совпадёт.
Параметры функций, инструкции let и циклы for принимают только
неопровержимые образцы: если значение не совпало, программе нечего осмысленно
делать. Выражения if let и while let и инструкция let...else принимают и
опровержимые, и неопровержимые образцы, но на неопровержимые компилятор
выдаёт предупреждение: эти конструкции по определению предназначены для
обработки возможной неудачи. Весь смысл условной конструкции в том, что она
ведёт себя по-разному в зависимости от успеха или неудачи.
В целом о разнице между опровержимыми и неопровержимыми образцами думать не приходится. Но с понятием опровержимости нужно быть знакомым, чтобы понимать, что делать, когда оно встретится в сообщении об ошибке. Тогда придётся поменять либо образец, либо конструкцию, в которой он используется, — в зависимости от того, как должен вести себя код.
Посмотрим, что будет, если использовать опровержимый образец там, где Rust
требует неопровержимый, и наоборот. В листинге 19-8 — инструкция let, но в
качестве образца указан опровержимый Some(x). Как и следовало ожидать, код
не скомпилируется.
fn main() {
let some_option_value: Option<i32> = None;
let Some(x) = some_option_value;
}letЕсли бы some_option_value оказалось None, оно не совпало бы с образцом
Some(x) — значит, образец опровержимый. А инструкция let принимает только
неопровержимые образцы: со значением None код ничего корректного сделать не
может. При компиляции Rust пожалуется, что мы пытаемся использовать
опровержимый образец там, где требуется неопровержимый:
$ cargo run
Compiling patterns v0.1.0 (file:///projects/patterns)
error[E0005]: refutable pattern in local binding
--> src/main.rs:3:9
|
3 | let Some(x) = some_option_value;
| ^^^^^^^ pattern `None` not covered
|
= note: `let` bindings require an "irrefutable pattern", like a `struct` or an `enum` with only one variant
= note: for more information, visit https://doc.rust-lang.org/book/ch19-02-refutability.html
= note: the matched value is of type `Option<i32>`
help: you might want to use `let...else` to handle the variant that isn't matched
|
3 | let Some(x) = some_option_value else { todo!() };
| ++++++++++++++++
For more information about this error, try `rustc --explain E0005`.
error: could not compile `patterns` (bin "patterns") due to 1 previous error
Образцом Some(x) мы не покрыли (да и не могли покрыть!) все допустимые
значения, поэтому Rust вполне справедливо выдаёт ошибку компиляции.
Если опровержимый образец оказался там, где нужен неопровержимый, исправить
это можно, поменяв код, который использует образец: вместо let взять
let...else. Тогда, если образец не совпадёт, значение обработает код в
фигурных скобках. В листинге 19-9 показано, как исправить код из листинга
19-8.
fn main() {
let some_option_value: Option<i32> = None;
let Some(x) = some_option_value else {
return;
};
}let...else с блоком и опровержимым образцом вместо letМы дали коду запасной выход! Этот код совершенно корректен, хотя это значит,
что использовать здесь неопровержимый образец без предупреждения нельзя. Если
дать let...else образец, который совпадает всегда, — например x, как в
листинге 19-10, — компилятор выдаст предупреждение.
fn main() {
let x = 5 else {
return;
};
}let...elseRust жалуется, что использовать let...else с неопровержимым образцом
бессмысленно: до else дело никогда не дойдёт.
$ cargo run
Compiling patterns v0.1.0 (file:///projects/patterns)
warning: unreachable `else` clause
--> src/main.rs:2:15
|
2 | let x = 5 else {
| --------- ^^^^
| |
| assigning to binding pattern will always succeed
|
= note: this pattern always matches, so the else clause is unreachable
= note: `#[warn(irrefutable_let_patterns)]` on by default
warning: `patterns` (bin "patterns") generated 1 warning
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.39s
Running `target/debug/patterns`
По той же причине в ветках match должны быть опровержимые образцы — кроме
последней ветки, которая неопровержимым образцом должна поймать все
оставшиеся значения. Rust разрешает использовать неопровержимый образец в
match с одной-единственной веткой, но толку от этого мало: такой match можно
заменить более простой инструкцией let.
Теперь, когда вы знаете, где используются образцы и чем опровержимые отличаются от неопровержимых, разберём весь синтаксис, с помощью которого можно составлять образцы.
Синтаксис образцов
Синтаксис образцов
В этом разделе собран весь синтаксис, допустимый в образцах, и обсуждается, зачем и когда может пригодиться каждый его вариант.
Сопоставление с литералами
Как вы видели в главе 6, образцы можно сопоставлять прямо с литералами. Вот несколько примеров:
fn main() {
let x = 1;
match x {
1 => println!("one"),
2 => println!("two"),
3 => println!("three"),
_ => println!("anything"),
}
}Этот код выведет one, потому что в x значение 1. Такой синтаксис удобен,
когда код должен что-то сделать при получении определённого конкретного
значения.
Сопоставление с именованными переменными
Именованные переменные — неопровержимые образцы, совпадающие с любым
значением, и мы много раз пользовались ими в этой книге. Но с именованными
переменными в выражениях match, if let и while let есть одна сложность.
Каждое из этих выражений открывает новую область видимости, поэтому
переменные, объявленные в образце внутри них, затеняют одноимённые переменные
снаружи — как это бывает с любыми переменными. В листинге 19-11 мы объявляем
переменную x со значением Some(5) и переменную y со значением 10. Затем
создаём выражение match для значения x. Посмотрите на образцы в ветках и на
println! в конце и попробуйте понять, что выведет код, прежде чем запускать
его или читать дальше.
fn main() {
let x = Some(5);
let y = 10;
match x {
Some(50) => println!("Got 50"),
Some(y) => println!("Matched, y = {y}"),
_ => println!("Default case, x = {x:?}"),
}
println!("at the end: x = {x:?}, y = {y}");
}match с веткой, которая вводит новую переменную, затеняющую существующую переменную yРазберём, что происходит при выполнении выражения match. Образец первой ветки
не совпадает со значением x, так что выполнение идёт дальше.
Образец второй ветки вводит новую переменную y, которая совпадёт с любым
значением внутри Some. Мы находимся в новой области видимости внутри
выражения match, поэтому это новая переменная y, а не та y со значением
10, что мы объявили в начале. Эта новая привязка y совпадёт с любым
значением внутри Some, а у нас в x как раз Some. Поэтому новая y
привязывается к значению внутри Some из x. Это значение — 5, так что
выполняется выражение этой ветки и выводит Matched, y = 5.
Если бы x был None, а не Some(5), образцы первых двух веток не совпали бы, и
значение совпало бы с подчёркиванием. В образце ветки с подчёркиванием мы не
вводили переменную x, поэтому x в выражении — по-прежнему внешний,
незатенённый x. В этом гипотетическом случае match вывел бы
Default case, x = None.
Когда выражение match заканчивается, заканчивается и его область видимости, а
вместе с ней и область видимости внутренней y. Последний println! выводит
at the end: x = Some(5), y = 10.
Чтобы создать выражение match, которое сравнивает значения внешних x и y, а
не вводит новую переменную, затеняющую существующую y, нужно использовать
условие-охранник. Об охранниках мы поговорим ниже, в разделе «Дополнительные
условия: охранники в match».
Несколько образцов
В выражениях match можно сопоставлять сразу с несколькими образцами с помощью
синтаксиса | — это оператор «или» для образцов. Например, в следующем коде
значение x сопоставляется с ветками, и у первой из них есть вариант
«или»: если значение x совпадёт с любым из значений этой ветки, выполнится
её код.
fn main() {
let x = 1;
match x {
1 | 2 => println!("one or two"),
3 => println!("three"),
_ => println!("anything"),
}
}Этот код выведет one or two.
Диапазоны значений с ..=
Синтаксис ..= позволяет сопоставлять с диапазоном значений, включающим обе
границы. В следующем коде, если образец совпадёт с любым значением из
заданного диапазона, выполнится соответствующая ветка:
fn main() {
let x = 5;
match x {
1..=5 => println!("one through five"),
_ => println!("something else"),
}
}Если x равен 1, 2, 3, 4 или 5, совпадёт первая ветка. Для множества
значений такой синтаксис удобнее, чем оператор |: с | пришлось бы писать
1 | 2 | 3 | 4 | 5. Диапазон записать гораздо короче — особенно если нужно
сопоставить, скажем, любое число от 1 до 1000!
Компилятор при компиляции проверяет, что диапазон не пуст. А определить,
пуст ли диапазон, Rust может только для char и числовых значений, поэтому
диапазоны допустимы только для числовых значений и char.
Вот пример с диапазонами значений char:
fn main() {
let x = 'c';
match x {
'a'..='j' => println!("early ASCII letter"),
'k'..='z' => println!("late ASCII letter"),
_ => println!("something else"),
}
}Rust видит, что 'c' попадает в диапазон первого образца, и выводит
early ASCII letter.
Деструктуризация: разбираем значения на части
С помощью образцов можно также деструктурировать структуры, перечисления и кортежи, чтобы пользоваться отдельными частями этих значений. Разберём каждый случай.
Структуры
В листинге 19-12 — структура Point с двумя полями, x и y, которую можно
разобрать на части образцом в инструкции let.
struct Point {
x: i32,
y: i32,
}
fn main() {
let p = Point { x: 0, y: 7 };
let Point { x: a, y: b } = p;
assert_eq!(0, a);
assert_eq!(7, b);
}Этот код создаёт переменные a и b, совпадающие со значениями полей x и
y структуры p. Пример показывает, что имена переменных в образце не
обязаны совпадать с именами полей структуры. Но обычно имена переменных берут
такими же, как имена полей, чтобы легче было помнить, какая переменная из
какого поля. Раз так делают часто, а запись let Point { x: x, y: y } = p;
полна повторений, в Rust есть сокращённая запись образцов для полей структуры:
достаточно перечислить имена полей, и созданные образцом переменные получат
те же имена. Листинг 19-13 ведёт себя так же, как листинг 19-12, только
переменные, созданные образцом в let, называются x и y, а не a и b.
struct Point {
x: i32,
y: i32,
}
fn main() {
let p = Point { x: 0, y: 7 };
let Point { x, y } = p;
assert_eq!(0, x);
assert_eq!(7, y);
}Этот код создаёт переменные x и y, совпадающие с полями x и y
переменной p. В итоге в переменных x и y оказываются значения из
структуры p.
В образце структуры можно указывать и литералы, а не только создавать переменные для всех полей. Так можно проверить, что некоторые поля имеют определённые значения, и одновременно создать переменные для остальных.
В листинге 19-14 выражение match делит значения Point на три случая: точки
прямо на оси x (когда y = 0), на оси y (x = 0) и не на осях.
struct Point {
x: i32,
y: i32,
}
fn main() {
let p = Point { x: 0, y: 7 };
match p {
Point { x, y: 0 } => println!("On the x axis at {x}"),
Point { x: 0, y } => println!("On the y axis at {y}"),
Point { x, y } => {
println!("On neither axis: ({x}, {y})");
}
}
}Первая ветка совпадёт с любой точкой на оси x: мы указываем, что поле y
совпадает, если его значение равно литералу 0. При этом образец всё равно
создаёт переменную x, которую можно использовать в коде этой ветки.
Аналогично вторая ветка совпадает с любой точкой на оси y: поле x совпадает,
если равно 0, и создаётся переменная y со значением поля y. В третьей ветке
литералов нет, так что она совпадает с любой другой Point и создаёт
переменные для обоих полей, x и y.
В этом примере значение p совпадает со второй веткой, потому что в x лежит
0, так что код выведет On the y axis at 7.
Помните: выражение match перестаёт проверять ветки, как только находит первый
совпавший образец. Поэтому, хотя Point { x: 0, y: 0 } лежит и на оси x, и на
оси y, этот код вывел бы только On the x axis at 0.
Перечисления
Мы уже деструктурировали перечисления в этой книге (например, в листинге 6-5
главы 6), но ещё не говорили явно, что образец для деструктуризации
перечисления повторяет то, как определены данные внутри перечисления. Для
примера в листинге 19-15 мы берём перечисление Message из листинга 6-2 и
пишем match с образцами, которые разбирают каждое внутреннее значение.
enum Message {
Quit,
Move { x: i32, y: i32 },
Write(String),
ChangeColor(i32, i32, i32),
}
fn main() {
let msg = Message::ChangeColor(0, 160, 255);
match msg {
Message::Quit => {
println!("The Quit variant has no data to destructure.");
}
Message::Move { x, y } => {
println!("Move in the x direction {x} and in the y direction {y}");
}
Message::Write(text) => {
println!("Text message: {text}");
}
Message::ChangeColor(r, g, b) => {
println!("Change color to red {r}, green {g}, and blue {b}");
}
}
}Этот код выведет Change color to red 0, green 160, and blue 255. Попробуйте
поменять значение msg, чтобы выполнился код других веток.
Варианты перечисления без данных, вроде Message::Quit, разбирать дальше
некуда. Можно лишь сопоставить с самим значением Message::Quit, и переменных в
таком образце нет.
Для вариантов, похожих на структуры, вроде Message::Move, используется образец,
похожий на образец для структур. После имени варианта ставятся фигурные скобки
и перечисляются поля с переменными, чтобы разобрать значение на части для кода
этой ветки. Здесь мы используем сокращённую запись, как в листинге 19-13.
Для вариантов, похожих на кортежи, — вроде Message::Write с кортежем из одного
элемента и Message::ChangeColor с кортежем из трёх — образец похож на образец
для кортежей. Число переменных в образце должно совпадать с числом элементов в
сопоставляемом варианте.
Вложенные структуры и перечисления
До сих пор во всех примерах сопоставлялись структуры или перечисления с
вложенностью в один уровень, но сопоставлять можно и вложенные элементы!
Например, код из листинга 19-15 можно переделать так, чтобы сообщение
ChangeColor поддерживало цвета в RGB и HSV, как в листинге 19-16.
enum Color {
Rgb(i32, i32, i32),
Hsv(i32, i32, i32),
}
enum Message {
Quit,
Move { x: i32, y: i32 },
Write(String),
ChangeColor(Color),
}
fn main() {
let msg = Message::ChangeColor(Color::Hsv(0, 160, 255));
match msg {
Message::ChangeColor(Color::Rgb(r, g, b)) => {
println!("Change color to red {r}, green {g}, and blue {b}");
}
Message::ChangeColor(Color::Hsv(h, s, v)) => {
println!("Change color to hue {h}, saturation {s}, value {v}");
}
_ => (),
}
}Образец первой ветки выражения match совпадает с вариантом
Message::ChangeColor, содержащим вариант Color::Rgb, и привязывает три
внутренних значения i32. Образец второй ветки тоже совпадает с вариантом
Message::ChangeColor, но внутреннее перечисление — Color::Hsv. Такие сложные
условия можно задать в одном выражении match, хотя в них участвуют два
перечисления.
Структуры и кортежи
Образцы для деструктуризации можно сочетать и вкладывать друг в друга ещё более сложными способами. Следующий пример показывает сложную деструктуризацию: структуры и кортежи вложены в кортеж, и из всего этого извлекаются примитивные значения.
fn main() {
struct Point {
x: i32,
y: i32,
}
let ((feet, inches), Point { x, y }) = ((3, 10), Point { x: 3, y: -10 });
}Так сложные типы можно разбирать на составные части и пользоваться нужными значениями по отдельности.
Деструктуризация с помощью образцов — удобный способ пользоваться частями значений, например значением каждого поля структуры, независимо друг от друга.
Игнорирование значений в образце
Вы уже видели, что иногда полезно игнорировать значения в образце — например,
в последней ветке match, чтобы поймать «всё остальное»: такая ветка ничего не
делает, но учитывает все оставшиеся возможные значения. Игнорировать значения
целиком или по частям можно несколькими способами: образцом _ (его вы уже
видели), образцом _ внутри другого образца, именем, начинающимся с
подчёркивания, или .., чтобы проигнорировать оставшиеся части значения.
Разберём, как и зачем использовать каждый из них.
Значение целиком: _
Мы уже использовали подчёркивание как подстановочный образец, который
совпадает с любым значением, но не привязывает его. Особенно он полезен в
последней ветке выражения match, но использовать его можно в любом образце, в
том числе в параметрах функций, как в листинге 19-17.
fn foo(_: i32, y: i32) {
println!("This code only uses the y parameter: {y}");
}
fn main() {
foo(3, 4);
}_ в сигнатуре функцииЭтот код полностью проигнорирует значение 3, переданное первым аргументом, и
выведет This code only uses the y parameter: 4.
Обычно, когда какой-то параметр функции больше не нужен, сигнатуру меняют так, чтобы неиспользуемого параметра в ней не было. Но игнорирование параметра бывает особенно полезно, например, когда вы реализуете трейт: сигнатура должна быть определённой, а телу функции в вашей реализации один из параметров не нужен. Так вы избегаете предупреждения компилятора о неиспользуемом параметре, которое появилось бы, если бы вы дали ему имя.
Части значения: вложенный _
_ можно использовать и внутри другого образца, чтобы игнорировать лишь часть
значения, — например, когда нужно проверить только часть значения, а остальные
части в коде не понадобятся. В листинге 19-18 — код, управляющий значением
настройки. По бизнес-требованиям пользователь не может перезаписать уже
заданное значение настройки, но может сбросить настройку и задать ей значение,
если сейчас оно не задано.
fn main() {
let mut setting_value = Some(5);
let new_setting_value = Some(10);
match (setting_value, new_setting_value) {
(Some(_), Some(_)) => {
println!("Can't overwrite an existing customized value");
}
_ => {
setting_value = new_setting_value;
}
}
println!("setting is {setting_value:?}");
}Some, когда значение внутри Some не нужноЭтот код выведет Can't overwrite an existing customized value, а затем
setting is Some(5). В первой ветке нам не нужно ни сопоставлять, ни
использовать значения внутри вариантов Some, но нужно проверить случай,
когда и setting_value, и new_setting_value — варианты Some. В этом случае
мы выводим, почему setting_value не меняется, и не меняем его.
Во всех остальных случаях (когда setting_value или new_setting_value равно
None) срабатывает образец _ во второй ветке, и мы записываем
new_setting_value в setting_value.
Подчёркивания можно использовать и в нескольких местах одного образца, чтобы игнорировать определённые значения. В листинге 19-19 пример, где игнорируются второе и четвёртое значения кортежа из пяти элементов.
fn main() {
let numbers = (2, 4, 8, 16, 32);
match numbers {
(first, _, third, _, fifth) => {
println!("Some numbers: {first}, {third}, {fifth}");
}
}
}Этот код выведет Some numbers: 2, 8, 32, а значения 4 и 16 будут
проигнорированы.
Неиспользуемая переменная: имя с _
Если создать переменную и нигде её не использовать, Rust обычно выдаёт предупреждение: неиспользуемая переменная может быть признаком бага. Но иногда полезно создать переменную, которую вы пока использовать не будете, — например, при прототипировании или в самом начале проекта. Тогда можно попросить Rust не предупреждать о неиспользуемой переменной, начав её имя с подчёркивания. В листинге 19-20 мы создаём две неиспользуемые переменные, но при компиляции предупреждение будет только об одной из них.
fn main() {
let _x = 5;
let y = 10;
}Здесь мы получаем предупреждение о том, что не используется переменная y, а о
_x — нет.
Учтите тонкую разницу между одиночным _ и именем, начинающимся с
подчёркивания. Запись _x всё равно привязывает значение к переменной, а _
не привязывает вообще ничего. Чтобы показать, когда эта разница важна, вот
листинг 19-21, который выдаст ошибку.
fn main() {
let s = Some(String::from("Hello!"));
if let Some(_s) = s {
println!("found a string");
}
println!("{s:?}");
}Будет ошибка: значение s всё равно переместится в _s, и снова использовать
s будет нельзя. А одиночное подчёркивание никогда ничего не привязывает.
Листинг 19-22 скомпилируется без ошибок, потому что s не перемещается в _.
fn main() {
let s = Some(String::from("Hello!"));
if let Some(_) = s {
println!("found a string");
}
println!("{s:?}");
}Этот код прекрасно работает: s ни к чему не привязывается, а значит, и не
перемещается.
Оставшиеся части значения: ..
Если у значения много частей, синтаксисом .. можно взять нужные части и
проигнорировать остальные, не выписывая подчёркивание для каждой
игнорируемой. Образец .. игнорирует все части значения, которые не
сопоставлены явно в остальной части образца. В листинге 19-23 структура
Point хранит координату в трёхмерном пространстве. В выражении match нам
нужна только координата x, а значения полей y и z мы игнорируем.
fn main() {
struct Point {
x: i32,
y: i32,
z: i32,
}
let origin = Point { x: 0, y: 0, z: 0 };
match origin {
Point { x, .. } => println!("x is {x}"),
}
}Point, кроме x, с помощью ..Мы указываем x, а затем просто добавляем образец ... Это быстрее, чем писать
y: _ и z: _, особенно когда у структуры много полей, а важны лишь одно-два.
.. растягивается на столько значений, сколько нужно. В листинге 19-24 показано,
как использовать .. с кортежем.
fn main() {
let numbers = (2, 4, 8, 16, 32);
match numbers {
(first, .., last) => {
println!("Some numbers: {first}, {last}");
}
}
}Здесь первое и последнее значения сопоставляются с first и last, а ..
совпадает со всем, что посередине, и игнорирует это.
Однако использование .. должно быть однозначным. Если непонятно, какие
значения сопоставлять, а какие игнорировать, Rust выдаст ошибку. В листинге
19-25 — пример неоднозначного использования .., поэтому код не скомпилируется.
fn main() {
let numbers = (2, 4, 8, 16, 32);
match numbers {
(.., second, ..) => {
println!("Some numbers: {second}")
},
}
}.. неоднозначноПри компиляции этого примера получим ошибку:
$ cargo run
Compiling patterns v0.1.0 (file:///projects/patterns)
error: `..` can only be used once per tuple pattern
--> src/main.rs:5:22
|
5 | (.., second, ..) => {
| -- ^^ can only be used once per tuple pattern
| |
| previously used here
error: could not compile `patterns` (bin "patterns") due to 1 previous error
Rust не может определить, сколько значений кортежа проигнорировать, прежде чем
сопоставить значение с second, и сколько проигнорировать после. Этот код может
означать, что мы хотим проигнорировать 2, привязать second к 4, а потом
проигнорировать 8, 16 и 32; или проигнорировать 2 и 4, привязать
second к 8, а потом проигнорировать 16 и 32; и так далее. Имя переменной
second для Rust ничего особенного не значит, поэтому мы получаем ошибку
компиляции: использовать .. в двух местах вот так — неоднозначно.
Дополнительные условия: охранники в match
Охранник (match guard) — дополнительное условие if, указанное после образца
в ветке match. Чтобы ветка была выбрана, должно выполниться и оно. Охранники
полезны, когда нужно выразить идею сложнее, чем позволяет один образец. Учтите,
однако, что они есть только в выражениях match, но не в if let и
while let.
В условии можно использовать переменные, созданные в образце. В листинге 19-26 —
match, у первой ветки которого образец Some(x) и охранник if x % 2 == 0
(истинный, если число чётное).
fn main() {
let num = Some(4);
match num {
Some(x) if x % 2 == 0 => println!("The number {x} is even"),
Some(x) => println!("The number {x} is odd"),
None => (),
}
}Этот пример выведет The number 4 is even. Когда num сравнивается с образцом
первой ветки, он совпадает: Some(4) совпадает с Some(x). Затем охранник
проверяет, равен ли 0 остаток от деления x на 2, — и раз равен, выбирается
первая ветка.
Если бы num был Some(5), охранник первой ветки дал бы false: остаток от
деления 5 на 2 равен 1, а не 0. Тогда Rust перешёл бы ко второй ветке, и она
совпала бы: охранника у неё нет, а значит, она совпадает с любым вариантом
Some.
Выразить условие if x % 2 == 0 внутри образца никак нельзя, а охранник даёт
такую возможность. Обратная сторона этой выразительности — когда в выражении
есть охранники, компилятор не пытается проверить, что учтены все случаи.
Обсуждая листинг 19-11, мы упоминали, что охранники помогут решить нашу
проблему с затенением в образце. Вспомните: внутри образца в выражении match
мы создали новую переменную вместо того, чтобы использовать переменную снаружи
match. Из-за этой новой переменной сравнить значение с внешней переменной
было нельзя. В листинге 19-27 показано, как исправить это с помощью охранника.
fn main() {
let x = Some(5);
let y = 10;
match x {
Some(50) => println!("Got 50"),
Some(n) if n == y => println!("Matched, n = {n}"),
_ => println!("Default case, x = {x:?}"),
}
println!("at the end: x = {x:?}, y = {y}");
}Теперь код выведет Default case, x = Some(5). Образец второй ветки не вводит
новую переменную y, которая затенила бы внешнюю y, так что внешнюю y можно
использовать в охраннике. Вместо образца Some(y), который затенил бы внешнюю
y, мы пишем Some(n). Так создаётся новая переменная n, которая ничего не
затеняет: снаружи match переменной n нет.
Охранник if n == y — не образец, поэтому новых переменных не вводит. Эта y —
внешняя y, а не новая, затеняющая её, и, сравнивая n с y, можно искать
значение, равное значению внешней y.
В охраннике можно использовать и оператор «или» |, чтобы указать несколько
образцов; условие охранника будет применяться ко всем ним. Листинг 19-28
показывает приоритет при сочетании образца с | и охранника. Главное в этом
примере то, что охранник if y применяется к 4, 5 и 6, хотя может
показаться, что if y относится только к 6.
fn main() {
let x = 4;
let y = false;
match x {
4 | 5 | 6 if y => println!("yes"),
_ => println!("no"),
}
}Условие ветки говорит, что она совпадает, только если значение x равно 4,
5 или 6, и при этом y истинно. При выполнении образец первой ветки
совпадает, потому что x равен 4, но охранник if y даёт false, так что
первая ветка не выбирается. Код переходит ко второй ветке, она совпадает, и
программа выводит no. Дело в том, что условие if относится ко всему образцу
4 | 5 | 6, а не только к последнему значению 6. Иначе говоря, приоритет
охранника относительно образца такой:
(4 | 5 | 6) if y => ...
а не такой:
4 | 5 | (6 if y) => ...
Запустив код, в этом легко убедиться: если бы охранник применялся только к
последнему значению из списка через |, ветка совпала бы, и программа вывела бы
yes.
Привязки с @
Оператор @ (at) позволяет создать переменную, хранящую значение, и
одновременно проверить, совпадает ли это значение с образцом. В листинге 19-29
мы хотим проверить, что поле id у Message::Hello лежит в диапазоне 3..=7.
И ещё хотим привязать значение к переменной id, чтобы пользоваться им в коде
ветки.
fn main() {
enum Message {
Hello { id: i32 },
}
let msg = Message::Hello { id: 5 };
match msg {
Message::Hello { id: id @ 3..=7 } => {
println!("Found an id in range: {id}")
}
Message::Hello { id: 10..=12 } => {
println!("Found an id in another range")
}
Message::Hello { id } => println!("Found some other id: {id}"),
}
}@ привязываем значение в образце и одновременно проверяем егоЭтот пример выведет Found an id in range: 5. Указав id @ перед диапазоном
3..=7, мы сохраняем совпавшее с диапазоном значение в переменной id и
одновременно проверяем, что значение совпало с образцом-диапазоном.
Во второй ветке в образце указан только диапазон, и в коде этой ветки нет
переменной с фактическим значением поля id. Значение id могло быть 10, 11 или
12, но код этой ветки не знает, какое именно. Воспользоваться значением
поля id он не может: мы не сохранили его в переменную.
В последней ветке, где указана переменная без диапазона, значение доступно в
коде ветки в переменной id: здесь мы воспользовались сокращённой записью полей
структуры. Но в этой ветке значение поля id никак не проверяется, в отличие от
первых двух: с этим образцом совпадёт любое значение.
@ позволяет в одном образце и проверить значение, и сохранить его в
переменную.
Итоги
Образцы в Rust очень полезны для различения разных видов данных. В выражениях
match Rust гарантирует, что образцы покрывают все возможные значения, — иначе
программа не скомпилируется. Образцы в инструкциях let и параметрах функций
делают эти конструкции полезнее: позволяют разбирать значения на части и
присваивать эти части переменным. Образцы можно делать простыми или сложными —
как того требует задача.
Дальше, в предпоследней главе книги, мы рассмотрим продвинутые стороны самых разных возможностей Rust.
Продвинутые возможности
К этому моменту вы изучили самые используемые части языка Rust. Прежде чем взяться за ещё один проект в главе 21, рассмотрим несколько сторон языка, которые могут иногда встречаться, но которыми вы, возможно, не пользуетесь каждый день. Эту главу можно использовать как справочник, когда встретите что-то незнакомое. Описанные здесь возможности полезны в очень конкретных ситуациях. И хотя вы вряд ли будете часто к ним обращаться, мы хотим, чтобы вы представляли себе все возможности, которые даёт Rust.
В этой главе мы разберём:
- небезопасный Rust: как отказаться от части гарантий Rust и взять на себя ответственность за их соблюдение;
- продвинутые трейты: ассоциированные типы, параметры типа по умолчанию, полностью квалифицированный синтаксис, супертрейты и паттерн newtype применительно к трейтам;
- продвинутые типы: ещё о паттерне newtype, псевдонимы типов, тип never и типы с динамическим размером;
- продвинутые функции и замыкания: указатели на функции и возврат замыканий;
- макросы: способы определять код, который при компиляции порождает другой код.
Это целая палитра возможностей Rust — каждый найдёт что-то для себя! Начнём!
Небезопасный Rust
Небезопасный Rust
Во всём коде, который мы обсуждали до сих пор, гарантии безопасности памяти Rust проверялись при компиляции. Но внутри Rust спрятан второй язык, который этих гарантий не обеспечивает. Он называется небезопасным Rust (unsafe Rust) и работает как обычный Rust, но даёт дополнительные «суперспособности».
Небезопасный Rust существует потому, что статический анализ по своей природе консервативен. Когда компилятор пытается определить, соблюдает ли код гарантии, лучше отвергнуть какие-то корректные программы, чем принять некорректные. Код может быть в порядке, но если компилятору Rust не хватает информации, чтобы в этом убедиться, он код отвергнет. В таких случаях небезопасным кодом можно сказать компилятору: «Поверь, я знаю, что делаю». Но учтите: небезопасный Rust вы используете на свой страх и риск. Если использовать его неправильно, возможны проблемы из-за небезопасной работы с памятью — например, разыменование нулевого указателя.
Есть и другая причина, по которой у Rust есть небезопасное альтер эго: само железо компьютера по своей природе небезопасно. Если бы Rust не позволял небезопасных операций, некоторые задачи было бы не решить. Rust должен позволять низкоуровневое системное программирование — например, напрямую взаимодействовать с операционной системой или даже писать собственную ОС. Низкоуровневое системное программирование — одна из целей языка. Посмотрим, что и как можно делать с помощью небезопасного Rust.
Небезопасные суперспособности
Чтобы перейти к небезопасному Rust, напишите ключевое слово unsafe и откройте
новый блок с небезопасным кодом. В небезопасном Rust можно делать пять вещей,
недоступных в безопасном; мы называем их небезопасными суперспособностями
(unsafe superpowers). Вот они:
- Разыменовать сырой указатель.
- Вызвать небезопасную функцию или метод.
- Обратиться к изменяемой статической переменной или изменить её.
- Реализовать небезопасный трейт.
- Обратиться к полям объединения (
union).
Важно понимать, что unsafe не отключает анализатор заимствований и другие
проверки безопасности Rust: если использовать ссылку в небезопасном коде, она
всё равно будет проверена. Ключевое слово unsafe лишь открывает доступ к этим
пяти возможностям, которые компилятор затем не проверяет на безопасность
памяти. Определённая степень безопасности внутри блока unsafe всё равно
сохраняется.
Кроме того, unsafe не означает, что код внутри блока обязательно опасен или в
нём точно будут проблемы с безопасностью памяти. Смысл в том, что вы как
программист сами гарантируете, что код внутри блока unsafe обращается к
памяти корректно.
Люди ошибаются, и ошибки будут. Но раз эти пять небезопасных операций
разрешены только внутри блоков, помеченных unsafe, вы будете знать: любые
ошибки, связанные с безопасностью памяти, находятся внутри какого-то блока
unsafe. Делайте блоки unsafe маленькими — потом, разбираясь с ошибками
памяти, вы скажете себе спасибо.
Чтобы как можно сильнее изолировать небезопасный код, лучше всего обернуть его
в безопасную абстракцию с безопасным API — об этом мы поговорим дальше в главе,
когда будем разбирать небезопасные функции и методы. Части стандартной
библиотеки реализованы как безопасные абстракции над проверенным небезопасным
кодом. Обёртка из безопасной абстракции не даёт unsafe расползтись по всем
местам, где вы или ваши пользователи захотите воспользоваться
функциональностью, реализованной на небезопасном коде, — ведь пользоваться
безопасной абстракцией безопасно.
Разберём по очереди все пять небезопасных суперспособностей, а заодно посмотрим на абстракции, которые дают безопасный интерфейс к небезопасному коду.
Разыменование сырого указателя
В главе 4, в разделе «Висячие ссылки», мы
говорили, что компилятор гарантирует действительность ссылок. В небезопасном
Rust есть два новых типа, похожих на ссылки, — сырые указатели (raw
pointers). Как и ссылки, сырые указатели бывают неизменяемыми и изменяемыми и
записываются как *const T и *mut T соответственно. Звёздочка здесь — не
оператор разыменования, а часть имени типа. Применительно к сырым указателям
неизменяемый означает, что после разыменования указателю нельзя напрямую
присвоить значение.
В отличие от ссылок и умных указателей, сырые указатели:
- могут нарушать правила заимствования: можно иметь одновременно неизменяемые и изменяемые указатели или несколько изменяемых указателей на одно и то же место;
- не обязательно указывают на действительную память;
- могут быть нулевыми;
- не реализуют никакой автоматической очистки.
Отказываясь от этих гарантий Rust, вы жертвуете гарантированной безопасностью ради большей производительности или возможности взаимодействовать с другим языком или железом, где гарантии Rust не действуют.
В листинге 20-1 показано, как создать неизменяемый и изменяемый сырые указатели.
fn main() {
let mut num = 5;
let r1 = &raw const num;
let r2 = &raw mut num;
}Заметьте, что ключевого слова unsafe в этом коде нет. Создавать сырые
указатели можно и в безопасном коде; нельзя лишь разыменовывать их за
пределами блока unsafe, как вы скоро увидите.
Сырые указатели здесь созданы операторами сырого заимствования:
&raw const num создаёт неизменяемый сырой указатель *const i32, а
&raw mut num — изменяемый сырой указатель *mut i32. Мы создали их прямо из
локальной переменной, поэтому знаем, что именно эти сырые указатели
действительны, но о произвольном сыром указателе такого сказать нельзя.
Чтобы показать это, создадим сырой указатель, в действительности которого
уверенности нет: вместо оператора сырого заимствования используем приведение
значения через as. В листинге 20-2 показано, как создать сырой указатель на
произвольное место в памяти. Попытка использовать произвольную память — это
неопределённое поведение: по этому адресу могут быть данные, а могут и не быть;
компилятор может так оптимизировать код, что обращения к памяти не будет
вовсе; а может программа и завершиться с ошибкой сегментации. Обычно нет
никаких веских причин писать такой код, особенно когда можно воспользоваться
оператором сырого заимствования, но это возможно.
fn main() {
let address = 0x012345usize;
let r = address as *const i32;
}Напомним: создавать сырые указатели в безопасном коде можно, а вот
разыменовывать их и читать данные, на которые они указывают, — нельзя. В
листинге 20-3 мы применяем к сырому указателю оператор разыменования *, для
чего нужен блок unsafe.
fn main() {
let mut num = 5;
let r1 = &raw const num;
let r2 = &raw mut num;
unsafe {
println!("r1 is: {}", *r1);
println!("r2 is: {}", *r2);
}
}unsafeСоздание указателя ничем не вредит; проблемы с недействительным значением могут возникнуть, только когда мы пытаемся обратиться к тому, на что он указывает.
Обратите также внимание: в листингах 20-1 и 20-3 мы создали сырые указатели
*const i32 и *mut i32, которые оба указывают на одно и то же место в памяти —
туда, где хранится num. Если бы мы попытались создать неизменяемую и
изменяемую ссылки на num, код не скомпилировался бы: правила владения Rust не
допускают изменяемую ссылку одновременно с неизменяемыми. А с сырыми
указателями можно создать изменяемый и неизменяемый указатели на одно и то же
место и менять данные через изменяемый — и, возможно, получить гонку данных.
Будьте осторожны!
При всех этих опасностях зачем вообще использовать сырые указатели? Одно из главных применений — взаимодействие с кодом на C, как вы увидите в следующем разделе. Другое — построение безопасных абстракций, которых не понимает анализатор заимствований. Сначала познакомимся с небезопасными функциями, а потом посмотрим на пример безопасной абстракции на небезопасном коде.
Вызов небезопасной функции или метода
Второй вид операций, доступных в блоке unsafe, — вызов небезопасных функций.
Небезопасные функции и методы выглядят точно так же, как обычные, но перед
определением у них стоит unsafe. Здесь ключевое слово unsafe означает, что
у функции есть требования, которые мы должны соблюдать при её вызове, потому
что Rust не может гарантировать их выполнение. Вызывая небезопасную функцию
внутри блока unsafe, мы говорим, что прочитали документацию к ней и берём на
себя ответственность за соблюдение её договора.
Вот небезопасная функция dangerous с пустым телом:
fn main() {
unsafe fn dangerous() {}
unsafe {
dangerous();
}
}Функцию dangerous нужно вызывать внутри отдельного блока unsafe. Если
попытаться вызвать dangerous без блока unsafe, получим ошибку:
$ cargo run
Compiling unsafe-example v0.1.0 (file:///projects/unsafe-example)
error[E0133]: call to unsafe function `dangerous` is unsafe and requires unsafe block
--> src/main.rs:4:5
|
4 | dangerous();
| ^^^^^^^^^^^ call to unsafe function
|
= note: consult the function's documentation for information on how to avoid undefined behavior
For more information about this error, try `rustc --explain E0133`.
error: could not compile `unsafe-example` (bin "unsafe-example") due to 1 previous error
Блоком unsafe мы заверяем Rust, что прочитали документацию к функции,
понимаем, как правильно ею пользоваться, и проверили, что соблюдаем её договор.
Чтобы выполнять небезопасные операции в теле функции unsafe, всё равно нужен
блок unsafe — как и в обычной функции, — и компилятор предупредит, если вы
забудете. Это помогает делать блоки unsafe как можно меньше: небезопасные
операции могут быть нужны не во всём теле функции.
Безопасная абстракция над небезопасным кодом
Если функция содержит небезопасный код, это ещё не значит, что всю функцию
нужно помечать как небезопасную. Наоборот, обернуть небезопасный код в
безопасную функцию — распространённая абстракция. Для примера разберём функцию
split_at_mut из стандартной библиотеки, которой нужен небезопасный код, и
посмотрим, как её можно реализовать. Этот безопасный метод определён для
изменяемых срезов: он берёт один срез и делает из него два, разделив его по
переданному индексу. В листинге 20-4 показано, как пользоваться
split_at_mut.
fn main() {
let mut v = vec![1, 2, 3, 4, 5, 6];
let r = &mut v[..];
let (a, b) = r.split_at_mut(3);
assert_eq!(a, &mut [1, 2, 3]);
assert_eq!(b, &mut [4, 5, 6]);
}split_at_mutРеализовать эту функцию только на безопасном Rust нельзя. Попытка может
выглядеть как в листинге 20-5 — и не скомпилируется. Для простоты реализуем
split_at_mut как функцию, а не метод, и только для срезов значений i32, а не
для обобщённого типа T.
fn split_at_mut(values: &mut [i32], mid: usize) -> (&mut [i32], &mut [i32]) {
let len = values.len();
assert!(mid <= len);
(&mut values[..mid], &mut values[mid..])
}
fn main() {
let mut vector = vec![1, 2, 3, 4, 5, 6];
let (left, right) = split_at_mut(&mut vector, 3);
}split_at_mut только на безопасном RustСначала функция получает общую длину среза. Затем проверяет, что переданный параметром индекс лежит внутри среза, то есть не больше длины. Благодаря этой проверке, если передать индекс больше длины, функция запаникует раньше, чем попытается его использовать.
Затем мы возвращаем в кортеже два изменяемых среза: один — от начала исходного
среза до индекса mid, другой — от mid до конца.
При компиляции кода из листинга 20-5 получим ошибку:
$ cargo run
Compiling unsafe-example v0.1.0 (file:///projects/unsafe-example)
error[E0499]: cannot borrow `*values` as mutable more than once at a time
--> src/main.rs:6:31
|
1 | fn split_at_mut(values: &mut [i32], mid: usize) -> (&mut [i32], &mut [i32]) {
| - let's call the lifetime of this reference `'1`
...
6 | (&mut values[..mid], &mut values[mid..])
| --------------------------^^^^^^--------
| | | |
| | | second mutable borrow occurs here
| | first mutable borrow occurs here
| returning this value requires that `*values` is borrowed for `'1`
|
= help: use `.split_at_mut(position)` to obtain two mutable non-overlapping sub-slices
For more information about this error, try `rustc --explain E0499`.
error: could not compile `unsafe-example` (bin "unsafe-example") due to 1 previous error
Анализатор заимствований Rust не понимает, что мы заимствуем разные части среза; он знает лишь, что мы дважды заимствуем из одного и того же среза. Заимствовать разные части среза в принципе нормально: два среза не пересекаются. Но Rust недостаточно умён, чтобы это понять. Когда мы знаем, что код в порядке, а Rust — нет, пора браться за небезопасный код.
В листинге 20-6 показано, как с помощью блока unsafe, сырого указателя и
нескольких вызовов небезопасных функций заставить реализацию split_at_mut
работать.
use std::slice;
fn split_at_mut(values: &mut [i32], mid: usize) -> (&mut [i32], &mut [i32]) {
let len = values.len();
let ptr = values.as_mut_ptr();
assert!(mid <= len);
unsafe {
(
slice::from_raw_parts_mut(ptr, mid),
slice::from_raw_parts_mut(ptr.add(mid), len - mid),
)
}
}
fn main() {
let mut vector = vec![1, 2, 3, 4, 5, 6];
let (left, right) = split_at_mut(&mut vector, 3);
}split_at_mutВспомните из раздела «Срезы» главы 4: срез —
это указатель на данные и длина. Длину среза мы получаем методом len, а сырой
указатель среза — методом as_mut_ptr. Здесь у нас изменяемый срез значений
i32, поэтому as_mut_ptr возвращает сырой указатель типа *mut i32, который
мы сохраняем в переменной ptr.
Проверку, что индекс mid лежит внутри среза, мы оставляем. Дальше идёт
небезопасный код: функция slice::from_raw_parts_mut принимает сырой указатель
и длину и создаёт срез. С её помощью мы создаём срез, который начинается с
ptr и содержит mid элементов. Затем вызываем у ptr метод add с аргументом
mid, чтобы получить сырой указатель, начинающийся с mid, и создаём срез из
этого указателя и оставшегося после mid числа элементов.
Функция slice::from_raw_parts_mut небезопасна: она принимает сырой указатель
и вынуждена доверять, что он действителен. Метод add у сырых указателей тоже
небезопасен: он вынужден доверять, что место по смещению — тоже
действительный указатель. Поэтому вызовы slice::from_raw_parts_mut и add
пришлось обернуть в блок unsafe. Глядя на код и на проверку, что mid не
больше len, мы можем сказать, что все сырые указатели внутри блока unsafe
будут действительными указателями на данные внутри среза. Это приемлемое и
уместное использование unsafe.
Заметьте: помечать получившуюся функцию split_at_mut как unsafe не нужно, и
вызывать её можно из безопасного Rust. Мы создали безопасную абстракцию над
небезопасным кодом: реализация функции использует unsafe безопасно, потому
что создаёт только действительные указатели на данные, к которым у функции
есть доступ.
А вот использование slice::from_raw_parts_mut в листинге 20-7, скорее всего,
приведёт к падению при обращении к срезу. Этот код берёт произвольное место в
памяти и создаёт срез из 10 000 элементов.
fn main() {
use std::slice;
let address = 0x01234usize;
let r = address as *mut i32;
let values: &[i32] = unsafe { slice::from_raw_parts_mut(r, 10000) };
}Памятью по этому произвольному адресу мы не владеем, и нет никакой гарантии,
что созданный срез содержит корректные значения i32. Попытка использовать
values как корректный срез — неопределённое поведение.
Вызов внешнего кода через функции extern
Иногда коду на Rust нужно взаимодействовать с кодом на другом языке. Для этого
в Rust есть ключевое слово extern, которое помогает создавать и использовать
интерфейс внешних функций (Foreign Function Interface, FFI) — способ, которым
один язык программирования определяет функции и позволяет другому (внешнему)
языку их вызывать.
В листинге 20-8 показано, как подключить функцию abs из стандартной
библиотеки C. Функции, объявленные в блоках extern, вызывать из кода на Rust
обычно небезопасно, поэтому сами блоки extern тоже должны быть помечены
unsafe. Причина в том, что другие языки не соблюдают правил и гарантий Rust, а
Rust не может их проверить, так что ответственность за безопасность ложится на
программиста.
unsafe extern "C" {
fn abs(input: i32) -> i32;
}
fn main() {
unsafe {
println!("Absolute value of -3 according to C: {}", abs(-3));
}
}extern, определённую в другом языкеВ блоке unsafe extern "C" перечисляются имена и сигнатуры внешних функций из
другого языка, которые мы хотим вызывать. Часть "C" задаёт, какой двоичный
интерфейс приложений (application binary interface, ABI) использует внешняя
функция: ABI определяет, как вызывать функцию на уровне ассемблера. ABI "C" —
самый распространённый и соответствует ABI языка C. Сведения обо всех ABI,
которые поддерживает Rust, есть в справочнике Rust.
Любой элемент, объявленный в блоке unsafe extern, неявно небезопасен. Но
некоторые FFI-функции вызывать безопасно. Например, у функции abs из
стандартной библиотеки C нет никаких проблем с безопасностью памяти, и мы
знаем, что её можно вызывать с любым i32. В таких случаях с помощью ключевого
слова safe можно сказать, что эта конкретная функция безопасна, хотя и
находится в блоке unsafe extern. После этого её вызов уже не требует блока
unsafe, как в листинге 20-9.
unsafe extern "C" {
safe fn abs(input: i32) -> i32;
}
fn main() {
println!("Absolute value of -3 according to C: {}", abs(-3));
}safe внутри блока unsafe extern и вызываем её безопасноПометка safe сама по себе не делает функцию безопасной! Это скорее ваше
обещание Rust, что она безопасна. Следить за тем, чтобы обещание выполнялось, —
по-прежнему ваша обязанность!
Вызов функций Rust из других языков
С помощью extern можно сделать и интерфейс, через который другие языки
вызывают функции Rust. Вместо целого блока extern ключевое слово extern и
нужный ABI указывают прямо перед ключевым словом fn у соответствующей
функции. Ещё нужно добавить аннотацию #[unsafe(no_mangle)], чтобы компилятор
Rust не искажал (mangle) имя этой функции. Искажение имён — это когда
компилятор меняет данное нами имя функции на другое: в нём больше информации
для других этапов компиляции, но человеку его читать труднее. Компилятор
каждого языка искажает имена по-своему, поэтому, чтобы функцию Rust можно было
вызвать по имени из других языков, искажение имён в компиляторе Rust нужно
отключить. Это небезопасно: без встроенного искажения возможны конфликты имён
между библиотеками, так что мы сами отвечаем за то, чтобы выбранное имя можно
было безопасно экспортировать без искажения.
В следующем примере мы делаем функцию call_from_c доступной из кода на C —
после того как её скомпилируют в разделяемую библиотеку и скомпонуют с кодом на
C:
#[unsafe(no_mangle)]
pub extern "C" fn call_from_c() {
println!("Just called a Rust function from C!");
}
При таком использовании extern unsafe нужен только в атрибуте, а не у блока
extern.
Изменяемые статические переменные
Мы ещё не говорили в этой книге о глобальных переменных. Rust их поддерживает, но с правилами владения они могут создавать проблемы. Если два потока обращаются к одной и той же изменяемой глобальной переменной, возможна гонка данных.
В Rust глобальные переменные называются статическими (static). В листинге 20-10 — пример объявления и использования статической переменной со значением — строковым срезом.
static HELLO_WORLD: &str = "Hello, world!";
fn main() {
println!("value is: {HELLO_WORLD}");
}Статические переменные похожи на константы, о которых мы говорили в разделе
«Константы» главы 3. Имена статических переменных по
соглашению пишутся в SCREAMING_SNAKE_CASE. Статические переменные могут
хранить только ссылки со временем жизни 'static, а значит, компилятор Rust сам
может определить время жизни, и указывать его явно не нужно. Обращение к
неизменяемой статической переменной безопасно.
Тонкое отличие констант от неизменяемых статических переменных в том, что у
значения статической переменной фиксированный адрес в памяти: при каждом
использовании обращение идёт к одним и тем же данным. А константы могут
дублировать свои данные при каждом использовании. Ещё одно отличие —
статические переменные могут быть изменяемыми. Обращение к изменяемым
статическим переменным и их изменение — небезопасны. В листинге 20-11 показано,
как объявить изменяемую статическую переменную COUNTER, обращаться к ней и
менять её.
static mut COUNTER: u32 = 0;
/// SAFETY: вызов этой функции одновременно из нескольких потоков — неопределённое
/// поведение, поэтому вы *обязаны* гарантировать, что она вызывается только
/// из одного потока за раз.
unsafe fn add_to_count(inc: u32) {
unsafe {
COUNTER += inc;
}
}
fn main() {
unsafe {
// SAFETY: вызывается только из одного потока, в `main`.
add_to_count(3);
println!("COUNTER: {}", *(&raw const COUNTER));
}
}Как и у обычных переменных, изменяемость задаётся ключевым словом mut. Любой
код, читающий COUNTER или пишущий в неё, должен быть внутри блока unsafe. Код
из листинга 20-11 компилируется и, как и ожидалось, выводит COUNTER: 3, потому
что он однопоточный. Если бы к COUNTER обращались несколько потоков, скорее
всего, возникли бы гонки данных, а это неопределённое поведение. Поэтому всю
функцию нужно пометить как unsafe и задокументировать ограничение
безопасности, чтобы любой, кто её вызывает, знал, что можно делать безопасно, а
что нельзя.
Когда мы пишем небезопасную функцию, идиоматично добавлять комментарий,
начинающийся с SAFETY, и объяснять в нём, что должен сделать вызывающий,
чтобы вызвать функцию безопасно. Точно так же, выполняя небезопасную операцию,
идиоматично писать комментарий с SAFETY и объяснять, как соблюдаются правила
безопасности.
Кроме того, компилятор с помощью линта по умолчанию запрещает любые попытки
создать ссылки на изменяемую статическую переменную. Нужно либо явно отказаться
от защиты этого линта, добавив аннотацию #[allow(static_mut_refs)], либо
обращаться к изменяемой статической переменной через сырой указатель,
созданный одним из операторов сырого заимствования. Это касается и случаев,
когда ссылка создаётся незаметно — как при использовании в println! в этом
листинге. Требование создавать ссылки на изменяемые статические переменные
через сырые указатели помогает сделать требования безопасности к ним
нагляднее.
С изменяемыми глобально доступными данными трудно гарантировать отсутствие гонок данных, поэтому Rust и считает изменяемые статические переменные небезопасными. Где возможно, лучше использовать приёмы конкурентности и потокобезопасные умные указатели из главы 16 — тогда компилятор проверит, что доступ к данным из разных потоков безопасен.
Реализация небезопасного трейта
С помощью unsafe можно реализовать небезопасный трейт. Трейт небезопасен,
если хотя бы у одного из его методов есть инвариант, который компилятор не
может проверить. Чтобы объявить трейт небезопасным, перед trait добавляют
ключевое слово unsafe, а реализацию трейта тоже помечают unsafe, как в
листинге 20-12.
unsafe trait Foo {
// здесь методы
}
unsafe impl Foo for i32 {
// здесь реализации методов
}
fn main() {}Используя unsafe impl, мы обещаем соблюдать инварианты, которые компилятор
проверить не может.
Для примера вспомните трейты-маркеры Send и Sync из раздела «Расширяемая
конкурентность: Send и Sync» главы 16:
компилятор реализует их автоматически, если наши типы целиком состоят из
других типов, реализующих Send и Sync. Если же мы реализуем тип, в котором
есть тип без Send или Sync — например, сырые указатели, — и хотим пометить
наш тип как Send или Sync, нужно использовать unsafe. Rust не может
проверить, что наш тип соблюдает гарантии, позволяющие безопасно передавать
его между потоками или обращаться к нему из нескольких потоков, поэтому
проверять это приходится вручную и сообщать об этом через unsafe.
Доступ к полям объединения
Последнее, что можно сделать только с unsafe, — обратиться к полям
объединения. Объединение (union) похоже на структуру (struct), но в каждом
экземпляре в каждый момент используется лишь одно из объявленных полей.
Объединения нужны в основном для взаимодействия с объединениями в коде на C.
Обращение к полям объединения небезопасно, потому что Rust не может
гарантировать, данные какого типа сейчас хранятся в экземпляре объединения.
Подробнее об объединениях — в справочнике Rust.
Проверка небезопасного кода с помощью Miri
Когда небезопасный код написан, хочется проверить, что он действительно безопасен и корректен. Один из лучших способов — Miri, официальный инструмент Rust для обнаружения неопределённого поведения. Анализатор заимствований — статический инструмент, работающий при компиляции, а Miri — динамический, работающий во время выполнения. Он проверяет код, запуская программу или её тесты, и обнаруживает нарушения известных ему правил того, как должен работать Rust.
Для Miri нужна nightly-сборка Rust (подробнее о ней — в приложении G «Как
создаётся Rust и что такое „nightly Rust“»). Установить
и nightly-версию Rust, и Miri можно командой
rustup +nightly component add miri. Это не меняет версию Rust, которую
использует ваш проект, — просто добавляет инструмент в систему, чтобы вы могли
пользоваться им, когда понадобится. Запустить Miri для проекта можно командой
cargo +nightly miri run или cargo +nightly miri test.
Чтобы увидеть, насколько это полезно, посмотрим, что будет, если запустить его для листинга 20-7.
$ cargo +nightly miri run
Compiling unsafe-example v0.1.0 (file:///projects/unsafe-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.17s
Running `file:///home/.rustup/toolchains/nightly/bin/cargo-miri runner target/miri/debug/unsafe-example`
warning: integer-to-pointer cast
--> src/main.rs:5:13
|
5 | let r = address as *mut i32;
| ^^^^^^^^^^^^^^^^^^^ integer-to-pointer cast
|
= help: this program is using integer-to-pointer casts or (equivalently) `ptr::with_exposed_provenance`, which means that Miri might miss pointer bugs in this program
= help: see https://doc.rust-lang.org/nightly/std/ptr/fn.with_exposed_provenance.html for more details on that operation
= help: to ensure that Miri does not miss bugs in your program, use Strict Provenance APIs (https://doc.rust-lang.org/nightly/std/ptr/index.html#strict-provenance, https://crates.io/crates/sptr) instead
= help: you can then set `MIRIFLAGS=-Zmiri-strict-provenance` to ensure you are not relying on `with_exposed_provenance` semantics
= help: alternatively, `MIRIFLAGS=-Zmiri-permissive-provenance` disables this warning
error: Undefined Behavior: constructing invalid value of type &mut [i32]: encountered a dangling reference (0x1234[noalloc] has no provenance)
--> src/main.rs:7:35
|
7 | let values: &[i32] = unsafe { slice::from_raw_parts_mut(r, 10000) };
| ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ Undefined Behavior occurred here
|
= help: this indicates a bug in the program: it performed an invalid operation, and caused Undefined Behavior
= help: see https://doc.rust-lang.org/nightly/reference/behavior-considered-undefined.html for further information
note: some details are omitted, run with `MIRIFLAGS=-Zmiri-backtrace=full` for a verbose backtrace
error: aborting due to 1 previous error; 1 warning emitted
Miri справедливо предупреждает, что мы приводим целое число к указателю, — это может быть проблемой, но определить, есть ли она, Miri не может: он не знает, откуда взялся указатель. Затем Miri выдаёт ошибку там, где в листинге 20-7 неопределённое поведение: у нас висячий указатель. Благодаря Miri мы знаем о риске неопределённого поведения и можем подумать, как сделать код безопасным. Иногда Miri даже подсказывает, как исправить ошибки.
Miri ловит не всё, что можно сделать неправильно в небезопасном коде. Это инструмент динамического анализа, поэтому он находит проблемы только в коде, который реально выполняется. Значит, использовать его нужно вместе с хорошими практиками тестирования, чтобы увереннее полагаться на свой небезопасный код. И не все способы, которыми код может оказаться некорректным (unsound), Miri охватывает.
Иначе говоря: если Miri нашёл проблему, баг точно есть; но если Miri бага не нашёл, это ещё не значит, что проблемы нет. Хотя ловит он многое. Попробуйте запустить его на других примерах небезопасного кода из этой главы и посмотрите, что он скажет!
Подробнее о Miri — в его репозитории на GitHub.
Как правильно пользоваться небезопасным кодом
Использовать unsafe ради одной из пяти описанных суперспособностей — не
ошибка и даже не что-то порицаемое. Просто правильно написать unsafe-код
сложнее: компилятор не может помочь соблюсти безопасность памяти. Когда у вас
есть причина использовать небезопасный код, — используйте; явная пометка
unsafe поможет быстрее найти источник проблем, если они возникнут. А написав
небезопасный код, проверьте его с помощью Miri, чтобы увереннее знать, что он
соблюдает правила Rust.
Чтобы гораздо глубже разобраться, как эффективно работать с небезопасным Rust,
прочитайте официальное руководство Rust по unsafe — The Rustonomicon.
Продвинутые трейты
Продвинутые трейты
Впервые мы познакомились с трейтами в разделе «Трейты: общее поведение» главы 10, но в продвинутые детали не вдавались. Теперь, когда вы знаете о Rust больше, можно разобраться в тонкостях.
Трейты с ассоциированными типами
Ассоциированные типы (associated types) связывают с трейтом тип-заполнитель, который определения методов трейта могут использовать в своих сигнатурах. Тот, кто реализует трейт, указывает конкретный тип, который будет использоваться вместо заполнителя в данной реализации. Так можно определить трейт, который использует какие-то типы, и не знать точно, что это за типы, пока трейт не реализован.
Большинство продвинутых возможностей в этой главе мы описывали как редко нужные. Ассоциированные типы — где-то посередине: они встречаются реже, чем возможности из остальной книги, но чаще многих других возможностей из этой главы.
Пример трейта с ассоциированным типом — трейт Iterator из стандартной
библиотеки. Ассоциированный тип называется Item и обозначает тип значений,
которые перебирает тип, реализующий Iterator. Определение трейта Iterator —
в листинге 20-13.
pub trait Iterator {
type Item;
fn next(&mut self) -> Option<Self::Item>;
}Iterator с ассоциированным типом ItemТип Item — заполнитель, а определение метода next показывает, что он будет
возвращать значения типа Option<Self::Item>. Тот, кто реализует трейт
Iterator, укажет конкретный тип Item, и метод next будет возвращать
Option со значением этого конкретного типа.
Ассоциированные типы могут показаться похожими на обобщения: обобщения тоже
позволяют определить функцию, не указывая, с какими типами она работает. Чтобы
разобраться в разнице, посмотрим на реализацию трейта Iterator для типа
Counter (счётчик), где указано, что Item — это u32:
struct Counter {
count: u32,
}
impl Counter {
fn new() -> Counter {
Counter { count: 0 }
}
}
impl Iterator for Counter {
type Item = u32;
fn next(&mut self) -> Option<Self::Item> {
// --пропуск--
if self.count < 5 {
self.count += 1;
Some(self.count)
} else {
None
}
}
}Синтаксис похож на синтаксис обобщений. Так почему бы не определить трейт
Iterator через обобщения, как в листинге 20-14?
pub trait Iterator<T> {
fn next(&mut self) -> Option<T>;
}Iterator через обобщенияРазница в том, что с обобщениями, как в листинге 20-14, типы нужно указывать в
каждой реализации. Ведь можно реализовать и Iterator<String> for Counter, и
для любого другого типа, — то есть у Counter может быть несколько реализаций
Iterator. Иначе говоря, если у трейта есть обобщённый параметр, его можно
реализовать для одного типа много раз, каждый раз подставляя другие конкретные
типы. И тогда при вызове next у Counter пришлось бы указывать аннотации
типов, чтобы выбрать, какая реализация Iterator нужна.
С ассоциированными типами аннотации не нужны: реализовать трейт для одного типа
несколько раз нельзя. В листинге 20-13, где определение использует
ассоциированный тип, тип Item выбирается лишь однажды, потому что
impl Iterator for Counter может быть только один. Не нужно уточнять, что нам
нужен итератор по значениям u32, при каждом вызове next у Counter.
Ассоциированные типы также становятся частью договора трейта: реализующий трейт обязан указать тип на место заполнителя. Обычно у ассоциированных типов есть имя, описывающее, как будет использоваться тип, и хорошая практика — документировать ассоциированный тип в документации к API.
Параметры по умолчанию и перегрузка операторов
Для обобщённого параметра типа можно указать конкретный тип по умолчанию. Тогда тем, кто реализует трейт, не нужно указывать
конкретный тип, если подходит тип по умолчанию. Тип по умолчанию указывается
при объявлении обобщённого типа синтаксисом <PlaceholderType=ConcreteType>.
Отличный пример, где это полезно, — перегрузка операторов (operator
overloading), когда поведение оператора (например, +) настраивается для
определённых ситуаций.
Создавать собственные операторы или перегружать произвольные операторы Rust не
позволяет. Но операции и соответствующие трейты, перечисленные в std::ops,
перегрузить можно, реализовав трейты, связанные с оператором. Например, в
листинге 20-15 мы перегружаем оператор +, чтобы складывать два экземпляра
Point. Для этого реализуем для структуры Point трейт Add.
use std::ops::Add;
#[derive(Debug, Copy, Clone, PartialEq)]
struct Point {
x: i32,
y: i32,
}
impl Add for Point {
type Output = Point;
fn add(self, other: Point) -> Point {
Point {
x: self.x + other.x,
y: self.y + other.y,
}
}
}
fn main() {
assert_eq!(
Point { x: 1, y: 0 } + Point { x: 2, y: 3 },
Point { x: 3, y: 3 }
);
}Add, чтобы перегрузить оператор + для экземпляров PointМетод add складывает значения x двух экземпляров Point и значения y двух
экземпляров Point и создаёт новую Point. У трейта Add есть
ассоциированный тип Output, который задаёт тип, возвращаемый методом add.
Обобщённый тип по умолчанию в этом коде находится внутри трейта Add. Вот его
определение:
#![allow(unused)]
fn main() {
trait Add<Rhs=Self> {
type Output;
fn add(self, rhs: Rhs) -> Self::Output;
}
}В целом код должен выглядеть знакомо: трейт с одним методом и ассоциированным
типом. Новое здесь — Rhs=Self: такой синтаксис называется параметрами типа по
умолчанию (default type parameters). Обобщённый параметр типа Rhs
(сокращение от right-hand side — «правая часть») задаёт тип параметра rhs в
методе add. Если при реализации трейта Add не указать конкретный тип для
Rhs, по умолчанию Rhs будет Self — то есть тем типом, для которого мы
реализуем Add.
Реализуя Add для Point, мы взяли Rhs по умолчанию, потому что хотели
складывать два экземпляра Point. Посмотрим на пример реализации трейта Add,
где тип Rhs нужно задать свой, а не брать по умолчанию.
У нас есть две структуры, Millimeters и Meters, хранящие значения в разных
единицах измерения. Такая тонкая обёртка существующего типа в другую структуру
называется паттерном newtype (newtype pattern); подробнее о нём — в разделе
«Реализация внешних трейтов с помощью паттерна newtype».
Мы хотим складывать значения в миллиметрах со значениями в метрах, чтобы
реализация Add правильно выполняла перевод. Можно реализовать Add для
Millimeters с Meters в качестве Rhs, как в листинге 20-16.
use std::ops::Add;
struct Millimeters(u32);
struct Meters(u32);
impl Add<Meters> for Millimeters {
type Output = Millimeters;
fn add(self, other: Meters) -> Millimeters {
Millimeters(self.0 + (other.0 * 1000))
}
}Add для Millimeters, чтобы складывать Millimeters и MetersЧтобы складывать Millimeters и Meters, мы пишем impl Add<Meters> и тем
самым задаём параметр типа Rhs вместо Self по умолчанию.
Параметры типа по умолчанию используют в основном двумя способами:
- Чтобы расширить тип, не ломая существующий код.
- Чтобы дать возможность настройки в особых случаях, которые большинству пользователей не нужны.
Трейт Add из стандартной библиотеки — пример второго назначения: обычно
складывают два одинаковых типа, но трейт Add позволяет настроить и большее.
Благодаря параметру типа по умолчанию в определении Add дополнительный
параметр в большинстве случаев указывать не нужно. Иначе говоря, можно
обойтись без лишнего шаблонного кода в реализации, и трейтом удобнее
пользоваться.
Первое назначение похоже на второе, только наоборот: если нужно добавить параметр типа в существующий трейт, ему можно дать значение по умолчанию — тогда функциональность трейта расширится, а существующий код реализаций не сломается.
Различаем одноимённые методы
Ничто в Rust не мешает двум трейтам иметь методы с одинаковыми именами и не мешает реализовать оба трейта для одного типа. Можно также реализовать прямо для типа метод с тем же именем, что и у методов трейтов.
Вызывая методы с одинаковым именем, нужно сказать Rust, какой из них вы имеете
в виду. Посмотрите на код в листинге 20-17: мы определили два трейта, Pilot
(пилот) и Wizard (волшебник), у обоих есть метод fly (летать). Затем
реализуем оба трейта для типа Human (человек), у которого уже есть
собственный метод fly. Каждый метод fly делает что-то своё.
trait Pilot {
fn fly(&self);
}
trait Wizard {
fn fly(&self);
}
struct Human;
impl Pilot for Human {
fn fly(&self) {
println!("This is your captain speaking.");
}
}
impl Wizard for Human {
fn fly(&self) {
println!("Up!");
}
}
impl Human {
fn fly(&self) {
println!("*waving arms furiously*");
}
}
fn main() {}fly реализованы для типа Human, и ещё один метод fly реализован прямо для HumanЕсли вызвать fly у экземпляра Human, компилятор по умолчанию вызовет метод,
реализованный прямо для типа, как в листинге 20-18.
trait Pilot {
fn fly(&self);
}
trait Wizard {
fn fly(&self);
}
struct Human;
impl Pilot for Human {
fn fly(&self) {
println!("This is your captain speaking.");
}
}
impl Wizard for Human {
fn fly(&self) {
println!("Up!");
}
}
impl Human {
fn fly(&self) {
println!("*waving arms furiously*");
}
}
fn main() {
let person = Human;
person.fly();
}fly у экземпляра HumanЭтот код выведет *waving arms furiously*: Rust вызвал метод fly,
реализованный прямо для Human.
Чтобы вызвать метод fly из трейта Pilot или из трейта Wizard, нужен более
явный синтаксис, указывающий, какой именно fly имеется в виду. Он показан в
листинге 20-19.
trait Pilot {
fn fly(&self);
}
trait Wizard {
fn fly(&self);
}
struct Human;
impl Pilot for Human {
fn fly(&self) {
println!("This is your captain speaking.");
}
}
impl Wizard for Human {
fn fly(&self) {
println!("Up!");
}
}
impl Human {
fn fly(&self) {
println!("*waving arms furiously*");
}
}
fn main() {
let person = Human;
Pilot::fly(&person);
Wizard::fly(&person);
person.fly();
}fly какого трейта нужно вызватьИмя трейта перед именем метода объясняет Rust, какую реализацию fly мы хотим
вызвать. Можно было бы написать и Human::fly(&person) — это равнозначно
person.fly() из листинга 20-19, только длиннее, если различать ничего не
нужно.
Этот код выводит:
$ cargo run
Compiling traits-example v0.1.0 (file:///projects/traits-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.46s
Running `target/debug/traits-example`
This is your captain speaking.
Up!
*waving arms furiously*
Метод fly принимает параметр self, поэтому, будь у нас два типа,
реализующих один трейт, Rust смог бы определить нужную реализацию трейта по
типу self.
Но у ассоциированных функций, которые не являются методами, параметра self
нет. Если несколько типов или трейтов определяют функции-не-методы с
одинаковым именем, Rust не всегда понимает, какой тип вы имеете в виду, пока вы
не используете полностью квалифицированный синтаксис. Например, в листинге
20-20 мы создаём трейт для приюта для животных, где всех щенков хотят называть
Спот (Spot). Делаем трейт Animal с ассоциированной функцией-не-методом
baby_name (имя детёныша). Трейт Animal реализован для структуры Dog, у
которой есть и собственная ассоциированная функция-не-метод baby_name.
trait Animal {
fn baby_name() -> String;
}
struct Dog;
impl Dog {
fn baby_name() -> String {
String::from("Spot")
}
}
impl Animal for Dog {
fn baby_name() -> String {
String::from("puppy")
}
}
fn main() {
println!("A baby dog is called a {}", Dog::baby_name());
}Код, называющий всех щенков Спотами, находится в ассоциированной функции
baby_name, определённой для Dog. Тип Dog также реализует трейт Animal,
описывающий черты, общие для всех животных. Детёныши собак называются щенками
(puppy), и это выражено в реализации трейта Animal для Dog — в функции
baby_name, связанной с трейтом Animal.
В main мы вызываем функцию Dog::baby_name, то есть ассоциированную
функцию, определённую прямо для Dog. Этот код выводит:
$ cargo run
Compiling traits-example v0.1.0 (file:///projects/traits-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.54s
Running `target/debug/traits-example`
A baby dog is called a Spot
Это не то, что мы хотели. Мы хотим вызвать функцию baby_name из трейта
Animal, реализованного для Dog, чтобы код вывел
A baby dog is called a puppy. Приём с указанием имени трейта из листинга 20-19
здесь не поможет: если изменить main на код из листинга 20-21, будет ошибка
компиляции.
trait Animal {
fn baby_name() -> String;
}
struct Dog;
impl Dog {
fn baby_name() -> String {
String::from("Spot")
}
}
impl Animal for Dog {
fn baby_name() -> String {
String::from("puppy")
}
}
fn main() {
println!("A baby dog is called a {}", Animal::baby_name());
}baby_name из трейта Animal, но Rust не знает, какую реализацию использоватьУ Animal::baby_name нет параметра self, а трейт Animal могут реализовывать
и другие типы, поэтому Rust не может понять, какая реализация
Animal::baby_name нужна. Получим ошибку компиляции:
$ cargo run
Compiling traits-example v0.1.0 (file:///projects/traits-example)
error[E0790]: cannot call associated function on trait without specifying the corresponding `impl` type
--> src/main.rs:20:43
|
2 | fn baby_name() -> String;
| ------------------------- `Animal::baby_name` defined here
...
20 | println!("A baby dog is called a {}", Animal::baby_name());
| ^^^^^^^^^^^^^^^^^^^ cannot call associated function of trait
|
help: use the fully-qualified path to the only available implementation
|
20 | println!("A baby dog is called a {}", <Dog as Animal>::baby_name());
| +++++++ +
For more information about this error, try `rustc --explain E0790`.
error: could not compile `traits-example` (bin "traits-example") due to 1 previous error
Чтобы снять неоднозначность и сказать Rust, что нужна реализация Animal для
Dog, а не для какого-то другого типа, нужен полностью квалифицированный
синтаксис. Как им пользоваться, показано в листинге 20-22.
trait Animal {
fn baby_name() -> String;
}
struct Dog;
impl Dog {
fn baby_name() -> String {
String::from("Spot")
}
}
impl Animal for Dog {
fn baby_name() -> String {
String::from("puppy")
}
}
fn main() {
println!("A baby dog is called a {}", <Dog as Animal>::baby_name());
}baby_name из трейта Animal в реализации для DogМы даём Rust аннотацию типа в угловых скобках: она говорит, что нужно вызвать
метод baby_name из трейта Animal в реализации для Dog — мы хотим
обращаться с типом Dog как с Animal в этом вызове. Теперь код выводит то,
что нужно:
$ cargo run
Compiling traits-example v0.1.0 (file:///projects/traits-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.48s
Running `target/debug/traits-example`
A baby dog is called a puppy
В общем виде полностью квалифицированный синтаксис выглядит так:
<Type as Trait>::function(receiver_if_method, next_arg, ...);У ассоциированных функций, которые не являются методами, получателя
(receiver) нет — есть только список остальных аргументов. Полностью
квалифицированный синтаксис можно использовать везде, где вызываются функции
или методы. Но любую его часть, которую Rust может вывести из другой
информации в программе, можно опускать. Этот многословный синтаксис нужен,
только когда есть несколько реализаций с одинаковым именем и Rust нужна помощь,
чтобы понять, какую из них вызвать.
Супертрейты
Иногда определение трейта зависит от другого трейта: чтобы тип мог реализовать первый трейт, нужно, чтобы он реализовывал и второй. Так делают, чтобы определение трейта могло пользоваться ассоциированными элементами второго трейта. Трейт, на который опирается определение вашего трейта, называется супертрейтом (supertrait) вашего трейта.
Допустим, мы хотим сделать трейт OutlinePrint с методом outline_print,
который выводит значение в рамке из звёздочек. То есть если структура Point
реализует трейт стандартной библиотеки Display и выводится как (x, y), то
вызов outline_print у экземпляра Point с x равным 1 и y равным 3
должен вывести:
**********
* *
* (1, 3) *
* *
**********
В реализации метода outline_print мы хотим пользоваться функциональностью
трейта Display. Поэтому нужно указать, что трейт OutlinePrint работает
только с типами, которые реализуют и Display — и дают ту функциональность,
которая нужна OutlinePrint. В определении трейта это делается так:
OutlinePrint: Display. Это похоже на добавление ограничения трейтом к самому
трейту. Реализация трейта OutlinePrint — в листинге 20-23.
use std::fmt;
trait OutlinePrint: fmt::Display {
fn outline_print(&self) {
let output = self.to_string();
let len = output.len();
println!("{}", "*".repeat(len + 4));
println!("*{}*", " ".repeat(len + 2));
println!("* {output} *");
println!("*{}*", " ".repeat(len + 2));
println!("{}", "*".repeat(len + 4));
}
}
fn main() {}OutlinePrint, которому нужна функциональность DisplayРаз мы указали, что OutlinePrint требует трейт Display, можно пользоваться
функцией to_string, которая автоматически реализована для любого типа,
реализующего Display. Если бы мы попытались использовать to_string, не
добавив двоеточие и Display после имени трейта, получили бы ошибку: для типа
&Self в текущей области видимости метод to_string не найден.
Посмотрим, что будет, если попытаться реализовать OutlinePrint для типа,
который не реализует Display, — например, для структуры Point:
use std::fmt;
trait OutlinePrint: fmt::Display {
fn outline_print(&self) {
let output = self.to_string();
let len = output.len();
println!("{}", "*".repeat(len + 4));
println!("*{}*", " ".repeat(len + 2));
println!("* {output} *");
println!("*{}*", " ".repeat(len + 2));
println!("{}", "*".repeat(len + 4));
}
}
struct Point {
x: i32,
y: i32,
}
impl OutlinePrint for Point {}
fn main() {
let p = Point { x: 1, y: 3 };
p.outline_print();
}Получим ошибку: Display требуется, но не реализован.
$ cargo run
Compiling traits-example v0.1.0 (file:///projects/traits-example)
error[E0277]: `Point` doesn't implement `std::fmt::Display`
--> src/main.rs:20:23
|
20 | impl OutlinePrint for Point {}
| ^^^^^ unsatisfied trait bound
|
help: the trait `std::fmt::Display` is not implemented for `Point`
--> src/main.rs:15:1
|
15 | struct Point {
| ^^^^^^^^^^^^
note: required by a bound in `OutlinePrint`
--> src/main.rs:3:21
|
3 | trait OutlinePrint: fmt::Display {
| ^^^^^^^^^^^^ required by this bound in `OutlinePrint`
error[E0277]: `Point` doesn't implement `std::fmt::Display`
--> src/main.rs:24:7
|
24 | p.outline_print();
| ^^^^^^^^^^^^^ unsatisfied trait bound
|
help: the trait `std::fmt::Display` is not implemented for `Point`
--> src/main.rs:15:1
|
15 | struct Point {
| ^^^^^^^^^^^^
note: required by a bound in `OutlinePrint::outline_print`
--> src/main.rs:3:21
|
3 | trait OutlinePrint: fmt::Display {
| ^^^^^^^^^^^^ required by this bound in `OutlinePrint::outline_print`
4 | fn outline_print(&self) {
| ------------- required by a bound in this associated function
For more information about this error, try `rustc --explain E0277`.
error: could not compile `traits-example` (bin "traits-example") due to 2 previous errors
Чтобы это исправить, реализуем Display для Point и удовлетворим требование
OutlinePrint:
trait OutlinePrint: fmt::Display {
fn outline_print(&self) {
let output = self.to_string();
let len = output.len();
println!("{}", "*".repeat(len + 4));
println!("*{}*", " ".repeat(len + 2));
println!("* {output} *");
println!("*{}*", " ".repeat(len + 2));
println!("{}", "*".repeat(len + 4));
}
}
struct Point {
x: i32,
y: i32,
}
impl OutlinePrint for Point {}
use std::fmt;
impl fmt::Display for Point {
fn fmt(&self, f: &mut fmt::Formatter) -> fmt::Result {
write!(f, "({}, {})", self.x, self.y)
}
}
fn main() {
let p = Point { x: 1, y: 3 };
p.outline_print();
}Теперь реализация трейта OutlinePrint для Point скомпилируется, и можно
вызвать outline_print у экземпляра Point, чтобы вывести его в рамке из
звёздочек.
Реализация внешних трейтов с помощью паттерна newtype
В разделе «Реализация трейта для типа» главы 10 мы упоминали правило сироты: реализовать трейт для типа можно, только если трейт, тип или оба они локальны для нашего крейта. Обойти это ограничение можно с помощью паттерна newtype — создать новый тип в виде кортежной структуры. (О кортежных структурах мы говорили в разделе «Кортежные структуры: разные типы из похожих кортежей» главы 5.) У кортежной структуры будет одно поле, и она станет тонкой обёрткой вокруг типа, для которого мы хотим реализовать трейт. Тогда тип-обёртка локален для нашего крейта, и для него можно реализовать трейт. Термин newtype («новый тип») пришёл из языка программирования Haskell. Этот паттерн не снижает производительность: при компиляции тип-обёртка исчезает.
Для примера допустим, что мы хотим реализовать Display для Vec<T>, а правило
сироты не даёт сделать это напрямую: и трейт Display, и тип Vec<T>
определены вне нашего крейта. Можно сделать структуру Wrapper (обёртка),
хранящую экземпляр Vec<T>, а затем реализовать Display для Wrapper и
пользоваться значением Vec<T>, как в листинге 20-24.
use std::fmt;
struct Wrapper(Vec<String>);
impl fmt::Display for Wrapper {
fn fmt(&self, f: &mut fmt::Formatter) -> fmt::Result {
write!(f, "[{}]", self.0.join(", "))
}
}
fn main() {
let w = Wrapper(vec![String::from("hello"), String::from("world")]);
println!("w = {w}");
}Wrapper вокруг Vec<String>, чтобы реализовать DisplayРеализация Display обращается к внутреннему Vec<T> через self.0: Wrapper —
кортежная структура, а Vec<T> — её элемент с индексом 0. Теперь
функциональностью трейта Display можно пользоваться у Wrapper.
Недостаток этого приёма в том, что Wrapper — новый тип, и методов значения,
которое он хранит, у него нет. Пришлось бы реализовать все методы Vec<T>
прямо у Wrapper, чтобы они делегировали работу self.0, — тогда с Wrapper
можно было бы обращаться точно как с Vec<T>. Если нужно, чтобы у нового типа
были все методы внутреннего, решением будет реализовать для Wrapper трейт
Deref, возвращающий внутренний тип (о реализации трейта Deref мы говорили в
разделе «Умные указатели как обычные ссылки» главы 15). А если нужно, чтобы у Wrapper были не все методы внутреннего
типа — например, чтобы ограничить его поведение, — придётся вручную
реализовать только нужные.
Паттерн newtype полезен и тогда, когда трейты здесь ни при чём. Сменим тему и посмотрим на продвинутые способы работы с системой типов Rust.
Продвинутые типы
Продвинутые типы
В системе типов Rust есть возможности, которые мы уже упоминали, но пока не
обсуждали. Начнём с паттерна newtype в целом и разберёмся, чем он полезен как
тип. Затем перейдём к псевдонимам типов — возможности, похожей на newtype, но с
немного другой семантикой. А ещё поговорим о типе ! и типах с динамическим
размером.
Типобезопасность и абстракция с паттерном newtype
Этот раздел предполагает, что вы прочитали раздел «Реализация внешних трейтов
с помощью паттерна newtype». Паттерн newtype полезен и
для других задач, кроме тех, что мы обсуждали, — например, чтобы статически
гарантировать, что значения никогда не перепутаются, и указывать единицы
измерения значения. Пример с единицами измерения вы видели в листинге 20-16:
вспомните, что структуры Millimeters и Meters оборачивали значения u32 в
newtype. Если написать функцию с параметром типа Millimeters, программа, в
которой эту функцию случайно вызывают со значением типа Meters или голым
u32, просто не скомпилируется.
С помощью паттерна newtype можно также скрыть некоторые детали реализации типа: новый тип может открывать публичный API, отличный от API приватного внутреннего типа.
Например, можно сделать тип
People (люди), который оборачивает HashMap<i32, String>, хранящий ID
человека вместе с его именем. Код, использующий People, будет работать только
с публичным API, который мы дадим, — например, с методом добавления имени в
коллекцию People. Этому коду не нужно знать, что внутри мы присваиваем именам
ID типа i32. Паттерн newtype — лёгкий способ добиться инкапсуляции и скрыть
детали реализации, о чём мы говорили в разделе «Инкапсуляция скрывает детали
реализации»
главы 18.
Синонимы и псевдонимы типов
В Rust можно объявить псевдоним типа (type alias) — дать существующему типу
другое имя. Для этого используется ключевое слово type. Например, можно
создать псевдоним Kilometers для i32:
fn main() {
type Kilometers = i32;
let x: i32 = 5;
let y: Kilometers = 5;
println!("x + y = {}", x + y);
}Теперь псевдоним Kilometers — синоним i32. В отличие от типов
Millimeters и Meters, которые мы создали в листинге 20-16, Kilometers — не
отдельный новый тип. Со значениями типа Kilometers обращаются так же, как со
значениями типа i32:
fn main() {
type Kilometers = i32;
let x: i32 = 5;
let y: Kilometers = 5;
println!("x + y = {}", x + y);
}Раз Kilometers и i32 — один и тот же тип, значения обоих типов можно
складывать, а значения Kilometers можно передавать в функции, принимающие
параметры i32. Но при этом мы не получаем преимуществ проверки типов, которые
даёт обсуждавшийся раньше паттерн newtype. Иначе говоря, если где-то перепутать
значения Kilometers и i32, компилятор ошибку не выдаст.
Главное применение синонимов типов — сократить повторения. Например, у нас может быть длинный тип вроде такого:
Box<dyn Fn() + Send + 'static>Писать такой длинный тип в сигнатурах функций и в аннотациях типов по всему коду утомительно, и легко ошибиться. Представьте проект, полный кода вроде того, что в листинге 20-25.
fn main() {
let f: Box<dyn Fn() + Send + 'static> = Box::new(|| println!("hi"));
fn takes_long_type(f: Box<dyn Fn() + Send + 'static>) {
// --пропуск--
}
fn returns_long_type() -> Box<dyn Fn() + Send + 'static> {
// --пропуск--
Box::new(|| ())
}
}Псевдоним типа делает такой код удобнее, сокращая повторения. В листинге
20-26 мы ввели для многословного типа псевдоним Thunk и заменили им все
упоминания этого типа.
fn main() {
type Thunk = Box<dyn Fn() + Send + 'static>;
let f: Thunk = Box::new(|| println!("hi"));
fn takes_long_type(f: Thunk) {
// --пропуск--
}
fn returns_long_type() -> Thunk {
// --пропуск--
Box::new(|| ())
}
}Thunk, чтобы сократить повторенияТакой код гораздо проще читать и писать! Осмысленное имя псевдонима к тому же помогает передать ваше намерение (thunk — так называют код, который будет выполнен позже, так что это подходящее имя для сохраняемого замыкания).
Псевдонимы типов часто используют и с типом Result<T, E>, чтобы сократить
повторения. Возьмём модуль std::io из стандартной библиотеки. Операции
ввода-вывода часто возвращают Result<T, E>, чтобы обрабатывать случаи, когда
операция не сработала. В этой библиотеке есть структура std::io::Error,
представляющая все возможные ошибки ввода-вывода. Многие функции в std::io
возвращают Result<T, E>, где E — это std::io::Error, — например, эти
функции трейта Write:
use std::fmt;
use std::io::Error;
pub trait Write {
fn write(&mut self, buf: &[u8]) -> Result<usize, Error>;
fn flush(&mut self) -> Result<(), Error>;
fn write_all(&mut self, buf: &[u8]) -> Result<(), Error>;
fn write_fmt(&mut self, fmt: fmt::Arguments) -> Result<(), Error>;
}Result<..., Error> повторяется очень часто. Поэтому в std::io есть такое
объявление псевдонима:
use std::fmt;
type Result<T> = std::result::Result<T, std::io::Error>;
pub trait Write {
fn write(&mut self, buf: &[u8]) -> Result<usize>;
fn flush(&mut self) -> Result<()>;
fn write_all(&mut self, buf: &[u8]) -> Result<()>;
fn write_fmt(&mut self, fmt: fmt::Arguments) -> Result<()>;
}Раз это объявление находится в модуле std::io, можно пользоваться полным
псевдонимом std::io::Result<T> — то есть Result<T, E>, где вместо E
подставлен std::io::Error. В итоге сигнатуры функций трейта Write выглядят
так:
use std::fmt;
type Result<T> = std::result::Result<T, std::io::Error>;
pub trait Write {
fn write(&mut self, buf: &[u8]) -> Result<usize>;
fn flush(&mut self) -> Result<()>;
fn write_all(&mut self, buf: &[u8]) -> Result<()>;
fn write_fmt(&mut self, fmt: fmt::Arguments) -> Result<()>;
}Псевдоним типа помогает двояко: код проще писать, и интерфейс во всём
std::io получается единообразным. А раз это всего лишь псевдоним, это всё тот
же Result<T, E>, так что с ним работают любые методы Result<T, E> и особый
синтаксис вроде оператора ?.
Тип never, который никогда не возвращается
В Rust есть особый тип !, который в теории типов называют пустым типом
(empty type): у него нет значений. Мы предпочитаем называть его типом never
(never type, «никогда»), потому что он ставится на место возвращаемого типа,
когда функция никогда не возвращает управление. Вот пример:
fn bar() -> ! {
// --пропуск--
panic!();
}Этот код читается как «функция bar никогда не возвращает». Функции, которые
никогда не возвращают, называют расходящимися (diverging functions).
Создать значение типа ! невозможно, так что bar никак не может вернуть
управление.
Но какой прок от типа, значения которого невозможно создать? Вспомните код из листинга 2-5 — часть игры «Угадай число»; фрагмент повторён в листинге 20-27.
use std::cmp::Ordering;
use std::io;
use rand::prelude::*;
fn main() {
println!("Guess the number!");
let secret_number = rand::rng().random_range(1..=100);
println!("The secret number is: {secret_number}");
loop {
println!("Please input your guess.");
let mut guess = String::new();
// --пропуск--
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
let guess: u32 = match guess.trim().parse() {
Ok(num) => num,
Err(_) => continue,
};
println!("You guessed: {guess}");
// --пропуск--
match guess.cmp(&secret_number) {
Ordering::Less => println!("Too small!"),
Ordering::Greater => println!("Too big!"),
Ordering::Equal => {
println!("You win!");
break;
}
}
}
}match с веткой, которая заканчивается continueТогда мы пропустили некоторые детали этого кода. В разделе «Конструкция
match» главы 6 мы говорили,
что все ветки match должны возвращать один и тот же тип. Поэтому, например,
следующий код не работает:
fn main() {
let guess = "3";
let guess = match guess.trim().parse() {
Ok(_) => 5,
Err(_) => "hello",
};
}Тогда guess в этом коде должна была бы быть и целым числом, и строкой, а Rust
требует, чтобы у guess был только один тип. Так что же возвращает continue?
Как в листинге 20-27 одна ветка могла вернуть u32, а другая — закончиться
continue?
Как вы, наверное, догадались, значение continue — типа !. То есть, вычисляя
тип guess, Rust смотрит на обе ветки: в первой значение u32, во второй — !.
Раз у ! значения быть не может, Rust решает, что тип guess — u32.
Формально это поведение описывается так: выражения типа ! можно привести к
любому другому типу. Закончить ветку match словом continue можно, потому что
continue не возвращает значения: оно передаёт управление в начало цикла, так
что в случае Err значение guess вообще не присваивается.
Тип never полезен и с макросом panic!. Вспомните функцию unwrap, которую мы
вызываем у значений Option<T>, чтобы получить значение или запаниковать; вот
её определение:
enum Option<T> {
Some(T),
None,
}
use crate::Option::*;
impl<T> Option<T> {
pub fn unwrap(self) -> T {
match self {
Some(val) => val,
None => panic!("called `Option::unwrap()` on a `None` value"),
}
}
}Здесь происходит то же, что и в match из листинга 20-27: Rust видит, что у
val тип T, а у panic! — тип !, поэтому результат всего выражения match
— T. Код работает, потому что panic! не выдаёт значения, а завершает
программу. В случае None мы не возвращаем значение из unwrap, так что код
корректен.
И последнее выражение типа ! — цикл:
fn main() {
print!("forever ");
loop {
print!("and ever ");
}
}Здесь цикл никогда не заканчивается, так что значение выражения — !. Но если бы
в цикле был break, это было бы не так: дойдя до break, цикл завершился бы.
Типы с динамическим размером и трейт Sized
Rust должен знать о своих типах некоторые подробности — например, сколько места выделить под значение определённого типа. Из-за этого один уголок его системы типов поначалу немного сбивает с толку — понятие типов с динамическим размером (dynamically sized types). Их ещё называют DST или безразмерными типами (unsized types); они позволяют писать код со значениями, размер которых становится известен только во время выполнения.
Разберём подробнее тип с динамическим размером str, которым мы пользовались
на протяжении всей книги. Именно так: не &str, а сам по себе str — это DST.
Во многих случаях, например когда хранится введённый пользователем текст,
длину строки нельзя узнать до момента выполнения. Значит, нельзя ни создать
переменную типа str, ни принять аргумент типа str. Посмотрите на следующий
код — он не работает:
fn main() {
let s1: str = "Hello there!";
let s2: str = "How's it going?";
}Rust должен знать, сколько памяти выделить под любое значение определённого
типа, и все значения одного типа должны занимать одинаковый объём памяти. Если
бы Rust разрешил такой код, эти два значения str должны были бы занимать
одинаковое место. Но длина у них разная: s1 нужно 12 байт, а s2 — 15. Вот
почему переменную, хранящую значение типа с динамическим размером, создать
нельзя.
Что же делать? Здесь вы уже знаете ответ: сделать тип s1 и s2 строковым
срезом (&str), а не str. Вспомните из раздела «Строковые
срезы» главы 4: структура данных среза хранит
только начальную позицию и длину среза. Так что если &T — одно значение,
хранящее адрес в памяти, где лежит T, то строковый срез — это два значения:
адрес str и его длина. Поэтому размер значения строкового среза известен при
компиляции: он равен удвоенному размеру usize. Иначе говоря, размер строкового
среза известен всегда, какой бы длины ни была строка, на которую он
ссылается. В целом так типы с динамическим размером и используются в Rust: у них
есть дополнительный кусочек метаданных, хранящий размер динамической
информации. Золотое правило типов с динамическим размером: значения таких типов
всегда нужно держать за каким-нибудь указателем.
str можно сочетать с самыми разными указателями: например, Box<str> или
Rc<str>. На самом деле вы уже видели такое, только с другим типом
динамического размера — трейтами. Каждый трейт — это тип с динамическим
размером, на который можно сослаться по имени трейта. В разделе «Трейт-объекты:
абстракция над общим
поведением» главы 18 мы упоминали, что, чтобы использовать трейты как трейт-объекты, их
нужно держать за указателем — например, &dyn Trait или Box<dyn Trait>
(подойдёт и Rc<dyn Trait>).
Для работы с DST в Rust есть трейт Sized, который определяет, известен ли
размер типа при компиляции. Этот трейт автоматически реализован для всего, чей
размер известен при компиляции. Кроме того, Rust неявно добавляет ограничение
Sized к каждой обобщённой функции. То есть определение обобщённой функции
вроде такого:
fn generic<T>(t: T) {
// --пропуск--
}на самом деле воспринимается так, будто мы написали:
fn generic<T: Sized>(t: T) {
// --пропуск--
}По умолчанию обобщённые функции работают только с типами, размер которых известен при компиляции. Но это ограничение можно ослабить особым синтаксисом:
fn generic<T: ?Sized>(t: &T) {
// --пропуск--
}Ограничение ?Sized означает «T может быть Sized, а может и не быть», и эта
запись отменяет правило по умолчанию, что у обобщённых типов размер должен быть
известен при компиляции. Синтаксис ?Trait с таким смыслом есть только для
Sized, но не для других трейтов.
Заметьте также, что мы поменяли тип параметра t с T на &T. Тип может быть не
Sized, поэтому пользоваться им нужно через какой-нибудь указатель. Здесь мы
выбрали ссылку.
Дальше поговорим о функциях и замыканиях!
Продвинутые функции и замыкания
Продвинутые функции и замыкания
В этом разделе разбираются продвинутые возможности, связанные с функциями и замыканиями, — указатели на функции и возврат замыканий.
Указатели на функции
Мы уже говорили, как передавать в функции замыкания; но в функции можно
передавать и обычные функции! Это удобно, когда нужно передать уже
определённую функцию, а не создавать новое замыкание. Функции приводятся к типу
fn (со строчной f) — не путать с трейтом замыканий Fn. Тип fn
называется указателем на функцию (function pointer). Указатели на функции
позволяют передавать функции аргументами в другие функции.
Синтаксис, указывающий, что параметр — указатель на функцию, похож на синтаксис
замыканий, как в листинге 20-28. Там мы определили функцию add_one, которая
прибавляет 1 к своему параметру. Функция do_twice принимает два параметра:
указатель на любую функцию, которая принимает параметр i32 и возвращает i32,
и одно значение i32. Функция do_twice дважды вызывает функцию f, передавая
ей значение arg, и складывает результаты обоих вызовов. Функция main
вызывает do_twice с аргументами add_one и 5.
fn add_one(x: i32) -> i32 {
x + 1
}
fn do_twice(f: fn(i32) -> i32, arg: i32) -> i32 {
f(arg) + f(arg)
}
fn main() {
let answer = do_twice(add_one, 5);
println!("The answer is: {answer}");
}fn позволяет принять указатель на функцию в качестве аргументаЭтот код выводит The answer is: 12. Мы указываем, что параметр f в
do_twice — это fn, принимающий один параметр типа i32 и возвращающий i32.
Затем f можно вызвать в теле do_twice. А в main первым аргументом в
do_twice можно передать просто имя функции add_one.
В отличие от замыканий, fn — это тип, а не трейт, поэтому тип параметра
указывается прямо как fn, а не через обобщённый параметр типа с ограничением
одним из трейтов Fn.
Указатели на функции реализуют все три трейта замыканий (Fn, FnMut и
FnOnce), так что указатель на функцию всегда можно передать в функцию,
которая ожидает замыкание. Функции лучше писать с обобщённым типом и одним из
трейтов замыканий — тогда они будут принимать и функции, и замыкания.
Тем не менее бывает, что нужно принимать только fn, а не замыкания, — например,
при взаимодействии с внешним кодом, где замыканий нет: функции C могут
принимать функции аргументами, но замыканий в C нет.
В качестве примера, где можно использовать и замыкание, определённое прямо на
месте, и именованную функцию, посмотрим на метод map трейта Iterator из
стандартной библиотеки. Чтобы с помощью map превратить вектор чисел в вектор
строк, можно использовать замыкание, как в листинге 20-29.
fn main() {
let list_of_numbers = vec![1, 2, 3];
let list_of_strings: Vec<String> =
list_of_numbers.iter().map(|i| i.to_string()).collect();
}map превращает числа в строкиА можно вместо замыкания передать в map имя функции. Как это выглядит —
показано в листинге 20-30.
fn main() {
let list_of_numbers = vec![1, 2, 3];
let list_of_strings: Vec<String> =
list_of_numbers.iter().map(ToString::to_string).collect();
}String::to_string в методе map превращает числа в строкиОбратите внимание: здесь нужен полностью квалифицированный синтаксис, о
котором мы говорили в разделе «Продвинутые трейты», потому что функций с именем to_string несколько.
Здесь используется функция to_string из трейта ToString, который стандартная
библиотека реализовала для любого типа, реализующего Display.
Вспомните из раздела «Значения перечисления» главы 6: имя каждого варианта перечисления становится ещё и функцией- инициализатором. Эти функции-инициализаторы можно использовать как указатели на функции, реализующие трейты замыканий, а значит, передавать их аргументами в методы, принимающие замыкания, как в листинге 20-31.
fn main() {
enum Status {
Value(u32),
Stop,
}
let list_of_statuses: Vec<Status> = (0u32..20).map(Status::Value).collect();
}map создаёт экземпляры Status из чиселЗдесь мы создаём экземпляры Status::Value из каждого значения u32 в
диапазоне, у которого вызван map, — с помощью функции-инициализатора
Status::Value. Одним нравится такой стиль, другим — замыкания. Компилируются
они в одинаковый код, так что выбирайте тот стиль, который вам понятнее.
Возврат замыканий
Замыкания представлены трейтами, поэтому вернуть замыкание напрямую нельзя.
Обычно, когда хочется вернуть трейт, можно вернуть из функции конкретный тип,
реализующий этот трейт. Но с замыканиями так, как правило, не получится: у них
нет конкретного типа, который можно было бы вернуть. Например, если замыкание
захватывает какие-то значения из своей области видимости, вернуть его как
указатель на функцию fn нельзя.
Вместо этого обычно используют синтаксис impl Trait из главы 10. Вернуть
можно функцию любого вида — через Fn, FnOnce и FnMut. Например, код из
листинга 20-32 прекрасно скомпилируется.
#![allow(unused)]
fn main() {
fn returns_closure() -> impl Fn(i32) -> i32 {
|x| x + 1
}
}impl TraitОднако, как мы отмечали в разделе «Выведение и аннотации типов замыканий» главы 13, у каждого замыкания ещё и свой отдельный тип. Если нужно работать с несколькими функциями с одинаковой сигнатурой, но разной реализацией, для них придётся использовать трейт-объект. Посмотрите, что будет, если написать код вроде листинга 20-33.
fn main() {
let handlers = vec![returns_closure(), returns_initialized_closure(123)];
for handler in handlers {
let output = handler(5);
println!("{output}");
}
}
fn returns_closure() -> impl Fn(i32) -> i32 {
|x| x + 1
}
fn returns_initialized_closure(init: i32) -> impl Fn(i32) -> i32 {
move |x| x + init
}Vec<T> из замыканий, которые возвращают функции с типом impl FnЗдесь две функции, returns_closure и returns_initialized_closure, и обе
возвращают impl Fn(i32) -> i32. Заметьте, что возвращаемые ими замыкания
разные, хотя реализуют один и тот же тип. Если попытаться это скомпилировать,
Rust сообщит, что так не выйдет:
$ cargo build
Compiling functions-example v0.1.0 (file:///projects/functions-example)
error[E0308]: mismatched types
--> src/main.rs:2:44
|
2 | let handlers = vec![returns_closure(), returns_initialized_closure(123)];
| ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ expected opaque type, found a different opaque type
...
9 | fn returns_closure() -> impl Fn(i32) -> i32 {
| ------------------- the expected opaque type
...
13 | fn returns_initialized_closure(init: i32) -> impl Fn(i32) -> i32 {
| ------------------- the found opaque type
|
= note: expected opaque type `impl Fn(i32) -> i32`
found opaque type `impl Fn(i32) -> i32`
= note: distinct uses of `impl Trait` result in different opaque types
For more information about this error, try `rustc --explain E0308`.
error: could not compile `functions-example` (bin "functions-example") due to 1 previous error
Сообщение об ошибке говорит, что всякий раз, когда мы возвращаем impl Trait,
Rust создаёт уникальный непрозрачный тип (opaque type) — тип, в устройство
которого мы не можем заглянуть и который не можем угадать, чтобы написать его
сами. Поэтому, хотя обе функции возвращают замыкания, реализующие один и тот же
трейт Fn(i32) -> i32, непрозрачные типы, которые Rust создаёт для каждой, —
разные. (Это похоже на то, как Rust создаёт разные конкретные типы для разных
асинхронных блоков, даже если тип результата у них одинаковый, — мы видели это
в разделе «Тип Pin и трейт Unpin» главы 17.)
Решение мы уже видели несколько раз — трейт-объект, как в листинге 20-34.
fn main() {
let handlers = vec![returns_closure(), returns_initialized_closure(123)];
for handler in handlers {
let output = handler(5);
println!("{output}");
}
}
fn returns_closure() -> Box<dyn Fn(i32) -> i32> {
Box::new(|x| x + 1)
}
fn returns_initialized_closure(init: i32) -> Box<dyn Fn(i32) -> i32> {
Box::new(move |x| x + init)
}Vec<T> из замыканий, которые возвращают функции с типом Box<dyn Fn>, — так у них один и тот же типЭтот код прекрасно скомпилируется. Подробнее о трейт-объектах — в разделе «Трейт-объекты: абстракция над общим поведением» главы 18.
Дальше посмотрим на макросы!
Макросы
Макросы
На протяжении книги мы пользовались макросами вроде println!, но так и не
разобрались толком, что такое макрос и как он работает. Под словом макрос
(macro) в Rust понимается целое семейство возможностей: декларативные макросы
на macro_rules! и три вида процедурных макросов:
- пользовательские макросы
#[derive], задающие код, который добавляется атрибутомderiveк структурам и перечислениям; - атрибутоподобные макросы, определяющие собственные атрибуты, которые можно применять к любым элементам;
- функциеподобные макросы, которые выглядят как вызовы функций, но работают с токенами, переданными им в качестве аргумента.
Разберём каждый из них по очереди, но сначала поймём, зачем вообще нужны макросы, если есть функции.
Чем макросы отличаются от функций
По сути, макросы — способ писать код, который пишет другой код; это называется
метапрограммированием (metaprogramming). В приложении C мы обсуждаем атрибут
derive, который генерирует реализацию разных трейтов за вас. А на протяжении
книги мы пользовались макросами println! и vec!. Все эти макросы
разворачиваются (expand) в больший объём кода, чем вы написали вручную.
Метапрограммирование помогает уменьшить объём кода, который нужно писать и поддерживать, — но эту задачу решают и функции. Но у макросов есть возможности, которых у функций нет.
В сигнатуре функции нужно объявить число и типы её параметров. А макросы могут
принимать переменное число параметров: можно вызвать println!("hello") с
одним аргументом или println!("hello {}", name) с двумя. Кроме того, макросы
разворачиваются раньше, чем компилятор разбирает смысл кода, поэтому макрос
может, например, реализовать трейт для заданного типа. Функция так не может: она
вызывается во время выполнения, а трейт нужно реализовать при компиляции.
Минус реализации макроса вместо функции в том, что определения макросов сложнее определений функций: вы пишете код на Rust, который пишет код на Rust. Из-за этой косвенности определения макросов обычно труднее читать, понимать и поддерживать, чем определения функций.
Ещё одно важное отличие: макросы нужно определить или подключить в область видимости до того, как вы вызываете их в файле, а функции можно определять где угодно и вызывать где угодно.
Декларативные макросы для общего метапрограммирования
Самая распространённая разновидность макросов в Rust — декларативные макросы
(declarative macros). Их ещё называют «макросы по образцу» (macros by
example), «макросы macro_rules!» или просто «макросы». В основе своей
декларативные макросы позволяют написать что-то похожее на выражение match.
Как говорилось в главе 6, выражения match — управляющие конструкции, которые
берут выражение, сравнивают его значение с образцами и выполняют код,
связанный с совпавшим образцом. Макросы тоже сравнивают значение с образцами,
связанными с определённым кодом. Только значение здесь — сам исходный код на
Rust, переданный макросу; образцы сравниваются со структурой этого исходного
кода; а код, связанный с совпавшим образцом, заменяет код, переданный макросу.
Всё это происходит при компиляции.
Макрос определяется конструкцией macro_rules!. Разберёмся, как ею
пользоваться, на примере определения макроса vec!. В главе 8 мы видели, как
макросом vec! создать новый вектор с определёнными значениями. Например,
следующий макрос создаёт новый вектор с тремя целыми числами:
#![allow(unused)]
fn main() {
let v: Vec<u32> = vec![1, 2, 3];
}Макросом vec! можно также создать вектор из двух целых чисел или из пяти
строковых срезов. Функцией так сделать не получилось бы: ни число, ни тип
значений заранее неизвестны.
В листинге 20-35 — немного упрощённое определение макроса vec!.
#[macro_export]
macro_rules! vec {
( $( $x:expr ),* ) => {
{
let mut temp_vec = Vec::new();
$(
temp_vec.push($x);
)*
temp_vec
}
};
}vec!Примечание: настоящее определение макроса vec! в стандартной библиотеке
содержит код, который заранее выделяет нужный объём памяти. Это оптимизация,
и мы её опустили, чтобы упростить пример.
Аннотация #[macro_export] означает, что макрос должен становиться доступным
всякий раз, когда крейт, в котором он определён, подключается в область
видимости. Без неё подключить макрос нельзя.
Затем определение макроса начинается с macro_rules! и имени макроса — без
восклицательного знака. За именем, в нашем случае vec, идут фигурные скобки с
телом определения макроса.
Тело vec! устроено похоже на выражение match. Здесь одна ветка с образцом
( $( $x:expr ),* ), за которым идёт => и блок кода, связанный с этим
образцом. Если образец совпал, выдаётся связанный с ним блок кода. Раз это
единственный образец макроса, совпасть можно только одним способом; любой
другой образец приведёт к ошибке. У более сложных макросов веток больше одной.
Синтаксис образцов в определениях макросов отличается от синтаксиса из главы 19: образцы макросов сопоставляются со структурой кода на Rust, а не со значениями. Разберём, что означают части образца в листинге 20-35; полный синтаксис образцов макросов — в справочнике Rust.
Сначала весь образец заключается в круглые скобки. Знаком доллара ($)
объявляется переменная в системе макросов, в которую попадёт код на Rust,
совпавший с образцом. Знак доллара ясно показывает, что это переменная макроса,
а не обычная переменная Rust. Дальше идут круглые скобки, которые захватывают
значения, совпавшие с образцом внутри скобок, чтобы использовать их в коде
замены. Внутри $() стоит $x:expr — он совпадает с любым выражением Rust и
даёт ему имя $x.
Запятая после $() означает, что между каждым фрагментом кода, совпавшим с
$(), должна стоять буквальная запятая-разделитель. А * означает, что образец
совпадает с нулём или более повторений того, что стоит перед *.
Когда мы вызываем этот макрос как vec![1, 2, 3];, образец $x совпадает трижды
— с тремя выражениями 1, 2 и 3.
Теперь посмотрим на тело кода, связанного с этой веткой: temp_vec.push()
внутри $()* генерируется для каждой части, совпавшей с $() в образце, — ноль
или более раз, в зависимости от того, сколько раз совпал образец. Вместо $x
подставляется каждое совпавшее выражение. Если вызвать этот макрос как
vec![1, 2, 3];, вместо вызова макроса будет сгенерирован такой код:
{
let mut temp_vec = Vec::new();
temp_vec.push(1);
temp_vec.push(2);
temp_vec.push(3);
temp_vec
}Мы определили макрос, который принимает любое число аргументов любого типа и генерирует код, создающий вектор с указанными элементами.
Чтобы узнать больше о том, как писать макросы, загляните в документацию в интернете или другие источники, например «The Little Book of Rust Macros», которую начал Дэниел Кип (Daniel Keep) и продолжил Лукас Вирт (Lukas Wirth).
Процедурные макросы: генерация кода из атрибутов
Вторая разновидность макросов — процедурные макросы, которые больше похожи на
функции (и сами являются разновидностью процедуры). Процедурные макросы
(procedural macros) принимают на вход некоторый код, обрабатывают его и выдают
на выходе другой код, а не сопоставляют с образцами и подменяют код другим, как
декларативные. Три вида процедурных макросов — пользовательские derive,
атрибутоподобные и функциеподобные — работают похожим образом.
Определения процедурных макросов должны находиться в отдельном крейте
особого типа. Причины тому — сложные технические, и мы надеемся когда-нибудь от
этого ограничения избавиться. В листинге 20-36 показано, как определить
процедурный макрос; some_attribute — заполнитель для конкретной разновидности
макроса.
use proc_macro::TokenStream;
#[some_attribute]
pub fn some_name(input: TokenStream) -> TokenStream {
}Функция, определяющая процедурный макрос, принимает на вход TokenStream и
выдаёт на выходе TokenStream. Тип TokenStream определён в крейте
proc_macro, который поставляется вместе с Rust, и представляет
последовательность токенов. Это сердце макроса: исходный код, который
обрабатывает макрос, — это входной TokenStream, а код, который макрос выдаёт,
— выходной TokenStream. К функции также прикреплён атрибут, указывающий, какой
вид процедурного макроса мы создаём. В одном крейте может быть несколько видов
процедурных макросов.
Рассмотрим разные виды процедурных макросов. Начнём с пользовательского
макроса derive, а затем объясним небольшие отличия остальных видов.
Пользовательские макросы derive
Создадим крейт hello_macro с трейтом HelloMacro, у которого одна
ассоциированная функция hello_macro. Вместо того чтобы заставлять
пользователей реализовывать трейт HelloMacro для каждого своего типа, дадим
им процедурный макрос: пометив свой тип #[derive(HelloMacro)], они получат
реализацию функции hello_macro по умолчанию. Она будет выводить
Hello, Macro! My name is TypeName!, где TypeName — имя типа, для которого
реализован трейт. Иначе говоря, мы напишем крейт, с помощью которого другой
программист сможет написать код вроде листинга 20-37.
use hello_macro::HelloMacro;
use hello_macro_derive::HelloMacro;
#[derive(HelloMacro)]
struct Pancakes;
fn main() {
Pancakes::hello_macro();
}Когда мы закончим, этот код выведет Hello, Macro! My name is Pancakes!.
Первый шаг — создать новый библиотечный крейт:
$ cargo new hello_macro --lib
Затем в листинге 20-38 определим трейт HelloMacro и его ассоциированную
функцию.
pub trait HelloMacro {
fn hello_macro();
}deriveУ нас есть трейт и его функция. Сейчас пользователь нашего крейта мог бы сам реализовать трейт и получить нужную функциональность, как в листинге 20-39.
use hello_macro::HelloMacro;
struct Pancakes;
impl HelloMacro for Pancakes {
fn hello_macro() {
println!("Hello, Macro! My name is Pancakes!");
}
}
fn main() {
Pancakes::hello_macro();
}HelloMacroНо им пришлось бы писать блок реализации для каждого типа, с которым они хотят
использовать hello_macro; мы хотим избавить их от этой работы.
Кроме того, мы пока не можем дать функции hello_macro реализацию по
умолчанию, которая выводила бы имя типа, для которого реализован трейт: в Rust
нет рефлексии, и узнать имя типа во время выполнения он не может. Нужен
макрос, который сгенерирует код при компиляции.
Следующий шаг — определить процедурный макрос. На момент написания книги
процедурные макросы должны находиться в собственном крейте. Возможно, со
временем это ограничение снимут. Соглашение об устройстве крейтов и крейтов с
макросами такое: для крейта foo крейт с пользовательским процедурным макросом
derive называется foo_derive. Создадим внутри проекта hello_macro новый
крейт hello_macro_derive:
$ cargo new hello_macro_derive --lib
Наши два крейта тесно связаны, поэтому крейт процедурного макроса мы создаём в
папке крейта hello_macro. Если мы изменим определение трейта в hello_macro,
придётся изменить и реализацию процедурного макроса в hello_macro_derive.
Публиковать эти два крейта придётся отдельно, а программистам, которые ими
пользуются, — добавлять в зависимости оба и подключать оба в область
видимости. Можно было бы сделать так, чтобы hello_macro зависел от
hello_macro_derive и реэкспортировал код процедурного макроса. Но при нашей
структуре проекта программисты могут пользоваться hello_macro, даже если им не
нужна функциональность derive.
Нужно объявить крейт hello_macro_derive как крейт процедурных макросов. Ещё
понадобится функциональность из крейтов syn и quote — как вы скоро увидите,
— так что их нужно добавить в зависимости. Добавьте в Cargo.toml крейта
hello_macro_derive следующее:
[lib]
proc-macro = true
[dependencies]
syn = "2.0"
quote = "1.0"
Чтобы начать определять процедурный макрос, поместите код из листинга 20-40 в
файл src/lib.rs крейта hello_macro_derive. Учтите, что код не скомпилируется,
пока мы не добавим определение функции impl_hello_macro.
use proc_macro::TokenStream;
use quote::quote;
#[proc_macro_derive(HelloMacro)]
pub fn hello_macro_derive(input: TokenStream) -> TokenStream {
// Строим представление кода на Rust в виде синтаксического дерева,
// с которым можно работать.
let ast = syn::parse(input).unwrap();
// Генерируем реализацию трейта.
impl_hello_macro(&ast)
}Обратите внимание: мы разделили код на функцию hello_macro_derive, которая
отвечает за разбор TokenStream, и функцию impl_hello_macro, которая отвечает
за преобразование синтаксического дерева. Так писать процедурный макрос
удобнее. Код во внешней функции (здесь hello_macro_derive) будет почти
одинаковым в любом крейте процедурных макросов, который вы увидите или
создадите. А код в теле внутренней функции (здесь impl_hello_macro) зависит от
назначения вашего процедурного макроса.
Здесь появились три новых крейта: proc_macro, syn и
quote. Крейт proc_macro поставляется вместе с Rust,
поэтому добавлять его в зависимости в Cargo.toml не нужно. Крейт proc_macro
— это API компилятора, позволяющий из нашего кода читать код на Rust и
манипулировать им.
Крейт syn разбирает код на Rust из строки в структуру данных, с которой можно
работать. А крейт quote превращает структуры данных syn обратно в код на Rust.
С этими крейтами гораздо проще разбирать любой код на Rust, который нам может
понадобиться: написать полноценный парсер Rust — задача непростая.
Функция hello_macro_derive будет вызываться, когда пользователь нашей
библиотеки укажет у типа #[derive(HelloMacro)]. Это возможно потому, что мы
пометили функцию hello_macro_derive атрибутом proc_macro_derive и указали
имя HelloMacro, совпадающее с именем нашего трейта, — этому соглашению следует
большинство процедурных макросов.
Функция hello_macro_derive сначала превращает input из TokenStream в
структуру данных, которую можно разбирать и обрабатывать. Тут и пригождается
syn. Функция parse из syn принимает TokenStream и возвращает структуру
DeriveInput, представляющую разобранный код на Rust. В листинге 20-41 — важные
части структуры DeriveInput, которую мы получаем, разбирая строку
struct Pancakes;.
DeriveInput {
// --snip--
ident: Ident {
ident: "Pancakes",
span: #0 bytes(95..103)
},
data: Struct(
DataStruct {
struct_token: Struct,
fields: Unit,
semi_token: Some(
Semi
)
}
)
}DeriveInput, получаемый при разборе кода с атрибутом макроса из листинга 20-37Поля этой структуры показывают, что разобранный код на Rust — единичная
структура с ident (identifier, то есть имя) Pancakes. У структуры есть и
другие поля для описания самого разного кода на Rust; подробнее — в
документации syn к DeriveInput.
Скоро мы определим функцию impl_hello_macro — в ней и будем строить новый код
на Rust, который хотим добавить. Но сначала заметьте: результат нашего макроса
derive — тоже TokenStream. Возвращённый TokenStream добавляется к коду,
который пишут пользователи нашего крейта, так что, компилируя свой крейт, они
получат дополнительную функциональность из изменённого TokenStream.
Вы, возможно, заметили, что мы вызываем unwrap, чтобы функция
hello_macro_derive паниковала, если вызов syn::parse не сработает. Паниковать
при ошибках процедурному макросу необходимо: функции proc_macro_derive должны
возвращать TokenStream, а не Result, — таков API процедурных макросов. Мы
упростили пример, взяв unwrap; в коде для продакшена стоит давать более
конкретные сообщения о том, что пошло не так, через panic! или expect.
Теперь, когда у нас есть код, превращающий размеченный код на Rust из
TokenStream в экземпляр DeriveInput, сгенерируем код, реализующий трейт
HelloMacro для размеченного типа, как в листинге 20-42.
use proc_macro::TokenStream;
use quote::quote;
#[proc_macro_derive(HelloMacro)]
pub fn hello_macro_derive(input: TokenStream) -> TokenStream {
// Строим представление кода на Rust в виде синтаксического дерева,
// с которым можно работать
let ast = syn::parse(input).unwrap();
// Генерируем реализацию трейта
impl_hello_macro(&ast)
}
fn impl_hello_macro(ast: &syn::DeriveInput) -> TokenStream {
let name = &ast.ident;
let generated = quote! {
impl HelloMacro for #name {
fn hello_macro() {
println!("Hello, Macro! My name is {}!", stringify!(#name));
}
}
};
generated.into()
}HelloMacro с помощью разобранного кода на RustЧерез ast.ident мы получаем экземпляр структуры Ident с именем
(идентификатором) размеченного типа. Структура из листинга 20-41 показывает, что
при запуске impl_hello_macro на коде из листинга 20-37 поле ident в
полученной структуре будет равно "Pancakes". Значит, переменная name в листинге 20-42
будет содержать экземпляр Ident, который при выводе превращается в строку
"Pancakes" — имя структуры из листинга 20-37.
Макрос quote! позволяет задать код на Rust, который мы хотим вернуть.
Компилятор ожидает не совсем то, что даёт прямой результат выполнения quote!,
поэтому его нужно преобразовать в TokenStream. Делается это вызовом метода
into, который поглощает промежуточное представление и возвращает значение
нужного типа TokenStream.
Ещё макрос quote! даёт очень удобный механизм шаблонов: можно написать
#name, и quote! подставит туда значение переменной name. Можно даже делать
повторения — похоже на то, как работают обычные макросы. Подробное введение —
в документации крейта quote.
Мы хотим, чтобы процедурный макрос генерировал реализацию трейта HelloMacro
для типа, который разметил пользователь; этот тип можно получить через
#name. В реализации трейта одна функция — hello_macro, а в её теле —
функциональность, которую мы хотим дать: вывести Hello, Macro! My name is, а
затем имя размеченного типа.
Использованный здесь макрос stringify! встроен в Rust. Он принимает выражение
на Rust, например 1 + 2, и при компиляции превращает его в строковый литерал,
например "1 + 2". Это отличается от format! и println! — те вычисляют
выражение и превращают результат в String. Входное #name может оказаться
выражением, которое нужно вывести буквально, поэтому мы используем
stringify!. Заодно stringify! экономит выделение памяти: #name превращается
в строковый литерал при компиляции.
Теперь cargo build должен успешно завершаться и в hello_macro, и в
hello_macro_derive. Подключим эти крейты к коду из листинга 20-37 и посмотрим
на процедурный макрос в действии! Создайте в папке projects новый бинарный
проект командой cargo new pancakes. В Cargo.toml крейта pancakes нужно
добавить зависимости hello_macro и hello_macro_derive. Если вы публикуете
свои версии hello_macro и hello_macro_derive на
crates.io, это будут обычные зависимости;
если нет — их можно указать как зависимости по пути (path):
[dependencies]
hello_macro = { path = "../hello_macro" }
hello_macro_derive = { path = "../hello_macro/hello_macro_derive" }
Поместите код из листинга 20-37 в src/main.rs и запустите cargo run: он должен
вывести Hello, Macro! My name is Pancakes!. Реализация трейта HelloMacro из
процедурного макроса подключилась без того, чтобы крейт pancakes реализовывал
её сам: реализацию трейта добавил #[derive(HelloMacro)].
Теперь посмотрим, чем другие виды процедурных макросов отличаются от
пользовательских макросов derive.
Атрибутоподобные макросы
Атрибутоподобные макросы похожи на пользовательские макросы derive, но вместо
того, чтобы генерировать код для атрибута derive, позволяют создавать новые
атрибуты. К тому же они гибче: derive работает только со структурами и
перечислениями, а атрибуты можно применять и к другим элементам, например к
функциям. Вот пример атрибутоподобного макроса. Допустим, в веб-фреймворке
есть атрибут route, которым размечают функции:
#[route(GET, "/")]
fn index() {Атрибут #[route] определил бы фреймворк в виде процедурного макроса.
Сигнатура функции, определяющей макрос, выглядела бы так:
#[proc_macro_attribute]
pub fn route(attr: TokenStream, item: TokenStream) -> TokenStream {Здесь два параметра типа TokenStream. Первый — содержимое атрибута, то есть
часть GET, "/". Второй — тело элемента, к которому прикреплён атрибут, в
данном случае fn index() {} и всё остальное тело функции.
В остальном атрибутоподобные макросы работают так же, как пользовательские
макросы derive: создаёте крейт типа proc-macro и реализуете функцию,
генерирующую нужный код!
Функциеподобные макросы
Функциеподобные макросы выглядят как вызовы функций. Как и макросы
macro_rules!, они гибче функций: например, могут принимать заранее
неизвестное число аргументов. Но макросы macro_rules! определяются только
похожим на match синтаксисом, который мы разбирали выше в разделе
«Декларативные макросы для общего метапрограммирования».
А функциеподобные макросы принимают параметр TokenStream, и их определение
обрабатывает этот TokenStream кодом на Rust — как и два других вида
процедурных макросов. Пример функциеподобного макроса — макрос sql!, который
можно было бы вызывать так:
let sql = sql!(SELECT * FROM posts WHERE id=1);Этот макрос разбирал бы SQL-инструкцию внутри и проверял бы её синтаксическую
корректность — обработка куда сложнее той, что под силу макросу macro_rules!.
Макрос sql! был бы определён так:
#[proc_macro]
pub fn sql(input: TokenStream) -> TokenStream {Это определение похоже на сигнатуру пользовательского макроса derive: мы
получаем токены, стоящие внутри скобок, и возвращаем код, который хотели
сгенерировать.
Итоги
Уф! Теперь в вашем арсенале есть возможности Rust, которыми вы, скорее всего, будете пользоваться нечасто, но будете знать, что они доступны в особых обстоятельствах. Мы познакомили вас с несколькими сложными темами, чтобы вы узнавали эти понятия и синтаксис, встретив их в подсказках сообщений об ошибках или в чужом коде. Используйте эту главу как справочник при поиске решений.
Дальше мы применим на практике всё, что обсуждали в книге, и сделаем ещё один проект!
Финальный проект: многопоточный веб-сервер
Путь был долгим, но мы добрались до конца книги. В этой главе мы вместе сделаем ещё один проект, чтобы показать некоторые понятия из последних глав, а заодно повторить кое-что из более ранних.
В качестве финального проекта мы напишем веб-сервер, который говорит «Hello!» и в браузере выглядит как на рисунке 21-1.
План создания веб-сервера такой:
- Немного разобраться в TCP и HTTP.
- Слушать TCP-соединения на сокете.
- Разбирать небольшое количество HTTP-запросов.
- Формировать правильный HTTP-ответ.
- Увеличить пропускную способность сервера с помощью пула потоков.
Рисунок 21-1: Наш финальный общий проект
Прежде чем начать, отметим две детали. Во-первых, наш способ — не лучший способ написать веб-сервер на Rust. Участники сообщества опубликовали на crates.io немало готовых к продакшену крейтов с более полными реализациями веб-серверов и пулов потоков, чем та, что мы напишем. Но наша цель в этой главе — помочь вам учиться, а не пойти лёгким путём. Rust — язык системного программирования, поэтому мы можем сами выбрать нужный уровень абстракции и спуститься ниже, чем возможно или практично в других языках.
Во-вторых, async и await здесь использоваться не будут. Сделать пул потоков
— и без того серьёзная задача, а тут ещё и асинхронную среду выполнения писать!
Но мы будем отмечать, как async и await могли бы пригодиться в некоторых из
тех же задач, что встретятся в этой главе. В конце концов, как мы говорили в
главе 17, многие асинхронные среды выполнения управляют своей работой с
помощью пулов потоков.
Поэтому мы напишем простой HTTP-сервер и пул потоков вручную — чтобы вы разобрались в общих идеях и приёмах, на которых построены крейты, которыми вы, возможно, будете пользоваться в будущем.
Однопоточный веб-сервер
Однопоточный веб-сервер
Начнём с того, что заставим работать однопоточный веб-сервер. Но сначала коротко посмотрим на протоколы, на которых строятся веб-серверы. Подробности этих протоколов выходят за рамки книги, но краткий обзор даст нужные сведения.
Два основных протокола, с которыми работают веб-серверы, — протокол передачи гипертекста (Hypertext Transfer Protocol, HTTP) и протокол управления передачей (Transmission Control Protocol, TCP). Оба протокола работают по схеме «запрос — ответ»: клиент отправляет запросы, а сервер слушает их и отвечает клиенту. Содержимое запросов и ответов определяют сами протоколы.
TCP — протокол нижнего уровня: он описывает, как информация попадает с одного сервера на другой, но не говорит, что это за информация. HTTP надстраивается над TCP и определяет содержимое запросов и ответов. Технически HTTP можно использовать и поверх других протоколов, но в подавляющем большинстве случаев HTTP передаёт данные по TCP. Мы будем работать с «сырыми» байтами запросов и ответов TCP и HTTP.
Слушаем TCP-соединение
Веб-сервер должен слушать TCP-соединение — с этого и начнём. В стандартной
библиотеке для этого есть модуль std::net. Создадим новый проект как обычно:
$ cargo new hello
Created binary (application) `hello` project
$ cd hello
Для начала введите в src/main.rs код из листинга 21-1. Он будет слушать
входящие TCP-потоки на локальном адресе 127.0.0.1:7878. Получив входящий
поток, он выведет Connection established!.
use std::net::TcpListener;
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
println!("Connection established!");
}
}С помощью TcpListener мы слушаем TCP-соединения на адресе 127.0.0.1:7878.
Часть адреса до двоеточия — IP-адрес, обозначающий ваш компьютер (он одинаков
на любом компьютере и не означает конкретно компьютер авторов), а 7878 —
порт. Этот порт мы выбрали по двум причинам: для HTTP он обычно не
используется, так что наш сервер вряд ли будет конфликтовать с другим
веб-сервером на вашей машине; а ещё 7878 — это слово rust, набранное на
телефонной клавиатуре.
Функция bind здесь работает как функция new: возвращает новый экземпляр
TcpListener. Называется она bind (привязать), потому что в сетевом
программировании подключение к порту, чтобы его слушать, называют «привязкой к
порту».
Функция bind возвращает Result<T, E>: привязка может не удаться — например,
если запустить два экземпляра нашей программы, и две программы будут слушать
один и тот же порт. Мы пишем простой сервер для учёбы, так что обрабатывать
такие ошибки не будем, а просто остановим программу через unwrap.
Метод incoming у TcpListener возвращает итератор, который выдаёт
последовательность потоков (точнее, потоков типа TcpStream). Один поток
(stream) — это открытое соединение между клиентом и сервером. Соединение
(connection) — это весь процесс запроса и ответа: клиент подключается к
серверу, сервер формирует ответ и закрывает соединение. Поэтому мы будем
читать из TcpStream, чтобы узнать, что прислал клиент, а затем писать в поток
ответ, чтобы отправить данные обратно клиенту. В целом этот цикл for по
очереди обрабатывает каждое соединение и выдаёт нам последовательность потоков.
Пока что вся обработка потока сводится к вызову unwrap, который завершит
программу, если у потока есть ошибки; если ошибок нет, программа выводит
сообщение. В следующем листинге мы добавим больше функциональности для
успешного случая. А ошибки от метода incoming при подключении клиента могут
приходить потому, что на самом деле мы перебираем не соединения, а попытки
соединения. Соединение может не состояться по многим причинам, и многие из них
зависят от операционной системы. Например, во многих ОС есть ограничение на
число одновременно открытых соединений; новые попытки сверх этого числа будут
давать ошибку, пока часть открытых соединений не закроется.
Попробуем запустить этот код! Выполните в терминале cargo run и откройте в
браузере 127.0.0.1:7878. Браузер покажет сообщение об ошибке вроде «Connection
reset» («Соединение сброшено»), потому что сервер пока ничего не отправляет. Но в
терминале вы увидите несколько сообщений, выведенных, когда браузер
подключался к серверу!
Running `target/debug/hello`
Connection established!
Connection established!
Connection established!
Иногда на один запрос браузера выводится несколько сообщений. Возможно, браузер запрашивает не только страницу, но и другие ресурсы — например, иконку favicon.ico, которая показывается во вкладке браузера.
А может быть, браузер пытается подключиться к серверу несколько раз, потому что
сервер ничего не отвечает. Когда в конце цикла stream выходит из области
видимости и уничтожается, соединение закрывается — это часть реализации drop.
Браузеры иногда реагируют на закрытые соединения повторными попытками: вдруг
проблема временная.
Ещё браузеры иногда открывают к серверу несколько соединений, ничего по ним не отправляя, — чтобы, если запросы всё-таки понадобятся, они выполнились быстрее. В этом случае наш сервер увидит каждое соединение, независимо от того, были ли по нему запросы. Так поступают, например, многие версии браузеров на основе Chrome; эту оптимизацию можно отключить, открыв приватное окно или воспользовавшись другим браузером.
Главное — мы успешно получили дескриптор TCP-соединения!
Закончив работу с очередной версией кода, не забывайте останавливать программу
сочетанием ctrl-C. А после каждого набора изменений
перезапускайте её командой cargo run, чтобы работал самый свежий код.
Читаем запрос
Реализуем чтение запроса от браузера! Чтобы разделить ответственность —
сначала получить соединение, потом что-то с ним сделать, — заведём новую
функцию для обработки соединений. В этой функции handle_connection мы будем
читать данные из TCP-потока и выводить их, чтобы видеть, что отправляет
браузер. Измените код, как в листинге 21-2.
use std::{
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let http_request: Vec<_> = buf_reader
.lines()
.map(|result| result.unwrap())
.take_while(|line| !line.is_empty())
.collect();
println!("Request: {http_request:#?}");
}TcpStream и выводим данныеМы подключаем std::io::BufReader и std::io::prelude, чтобы получить доступ к
трейтам и типам для чтения из потока и записи в него. В цикле for в функции
main вместо вывода сообщения о соединении теперь вызывается новая функция
handle_connection, которой передаётся stream.
В функции handle_connection мы создаём новый экземпляр BufReader, который
оборачивает ссылку на stream. BufReader добавляет буферизацию, управляя за
нас вызовами методов трейта std::io::Read.
Мы создаём переменную http_request, в которую собираем строки запроса,
присланного браузером. Аннотацией типа Vec<_> мы указываем, что хотим собрать
эти строки в вектор.
BufReader реализует трейт std::io::BufRead, в котором есть метод lines.
Метод lines возвращает итератор по Result<String, std::io::Error>, разделяя
поток данных всякий раз, когда встречает байт перевода строки. Чтобы получить
каждую String, мы через map вызываем unwrap для каждого Result. Result
может оказаться ошибкой, если данные — некорректный UTF-8 или если при чтении из
потока возникла проблема. Опять же, программа для продакшена должна
обрабатывать такие ошибки аккуратнее, но мы для простоты останавливаем
программу при ошибке.
Конец HTTP-запроса браузер обозначает двумя переводами строки подряд. Поэтому, чтобы получить из потока один запрос, мы берём строки, пока не встретим пустую. Собрав строки в вектор, выводим их в «красивом» отладочном формате, чтобы посмотреть, какие указания браузер отправляет нашему серверу.
Попробуем этот код! Запустите программу и снова сделайте запрос в браузере. Браузер по-прежнему покажет страницу с ошибкой, но вывод программы в терминале теперь будет примерно таким:
$ cargo run
Compiling hello v0.1.0 (file:///projects/hello)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.42s
Running `target/debug/hello`
Request: [
"GET / HTTP/1.1",
"Host: 127.0.0.1:7878",
"User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10.15; rv:99.0) Gecko/20100101 Firefox/99.0",
"Accept: text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
"Accept-Language: en-US,en;q=0.5",
"Accept-Encoding: gzip, deflate, br",
"DNT: 1",
"Connection: keep-alive",
"Upgrade-Insecure-Requests: 1",
"Sec-Fetch-Dest: document",
"Sec-Fetch-Mode: navigate",
"Sec-Fetch-Site: none",
"Sec-Fetch-User: ?1",
"Cache-Control: max-age=0",
]
В зависимости от браузера вывод может немного отличаться. Теперь, когда мы
выводим данные запроса, видно, почему на один запрос браузера приходит
несколько соединений: посмотрите на путь после GET в первой строке запроса.
Если все повторные соединения запрашивают /, значит, браузер раз за разом
пытается получить /, потому что не получает ответа от нашей программы.
Разберём эти данные, чтобы понять, чего браузер хочет от нашей программы.
HTTP-запрос поближе
HTTP — текстовый протокол, и запрос в нём выглядит так:
Method Request-URI HTTP-Version CRLF
headers CRLF
message-body
Первая строка — строка запроса (request line): в ней сведения о том, что
запрашивает клиент. Первая часть строки запроса — метод, например GET или
POST; он описывает, как клиент делает запрос. Наш клиент отправил запрос
GET, то есть просит выдать информацию.
Следующая часть строки запроса — /: это унифицированный идентификатор ресурса (uniform resource identifier, URI), который запрашивает клиент. URI — почти, но не совсем то же самое, что унифицированный указатель ресурса (uniform resource locator, URL). Разница между URI и URL для нашей главы не важна, но в спецификации HTTP используется термин URI, так что здесь можно мысленно читать URL вместо URI.
Последняя часть — версия HTTP, которую использует клиент, а затем строка
запроса заканчивается последовательностью CRLF. (CRLF — это carriage return
и line feed, «возврат каретки» и «перевод строки», — термины ещё со времён
пишущих машинок!) Последовательность CRLF можно записать и как \r\n, где \r
— возврат каретки, а \n — перевод строки. Последовательность CRLF отделяет
строку запроса от остальных данных запроса. Заметьте: при выводе CRLF мы видим
начало новой строки, а не \r\n.
Глядя на строку запроса, которую мы получили, видим: метод — GET, URI запроса
— /, версия — HTTP/1.1.
После строки запроса все оставшиеся строки, начиная с Host:, — заголовки
(headers). У запросов GET тела нет.
Попробуйте сделать запрос из другого браузера или запросить другой адрес, например 127.0.0.1:7878/test, и посмотрите, как меняются данные запроса.
Теперь, когда мы знаем, чего хочет браузер, отправим ему какие-нибудь данные!
Пишем ответ
Реализуем отправку данных в ответ на запрос клиента. Ответ имеет такой формат:
HTTP-Version Status-Code Reason-Phrase CRLF
headers CRLF
message-body
Первая строка — строка состояния (status line): в ней версия HTTP, использованная в ответе, числовой код состояния, кратко описывающий результат запроса, и поясняющая фраза — текстовое описание кода состояния. После последовательности CRLF идут заголовки, ещё одна последовательность CRLF и тело ответа.
Вот пример ответа с версией HTTP 1.1, кодом состояния 200, поясняющей фразой OK, без заголовков и без тела:
HTTP/1.1 200 OK\r\n\r\n
Код состояния 200 — стандартный ответ об успехе. Этот текст — крошечный
успешный HTTP-ответ. Запишем его в поток в ответ на успешный запрос! Уберите из
функции handle_connection println!, который выводил данные запроса, и
замените его кодом из листинга 21-3.
use std::{
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let http_request: Vec<_> = buf_reader
.lines()
.map(|result| result.unwrap())
.take_while(|line| !line.is_empty())
.collect();
let response = "HTTP/1.1 200 OK\r\n\r\n";
stream.write_all(response.as_bytes()).unwrap();
}Первая новая строка определяет переменную response с данными сообщения об
успехе. Затем мы вызываем у response метод as_bytes, чтобы превратить строку
в байты. Метод write_all у stream принимает &[u8] и отправляет эти байты
прямо в соединение. Операция write_all может не сработать, поэтому, как и
раньше, на любой ошибке вызываем unwrap. В настоящем приложении здесь,
конечно, нужна обработка ошибок.
С этими изменениями запустим код и сделаем запрос. В терминал мы больше ничего не выводим, так что, кроме вывода Cargo, ничего не увидим. Открыв в браузере 127.0.0.1:7878, вы получите пустую страницу вместо ошибки. Вы только что вручную написали получение HTTP-запроса и отправку ответа!
Возвращаем настоящий HTML
Реализуем возврат чего-то большего, чем пустая страница. Создайте новый файл hello.html в корне папки проекта, а не в папке src. HTML может быть любым; один из вариантов — в листинге 21-4.
<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="utf-8">
<title>Hello!</title>
</head>
<body>
<h1>Hello!</h1>
<p>Hi from Rust</p>
</body>
</html>
Это минимальный документ HTML5 с заголовком и немного текста. Чтобы сервер
возвращал его при получении запроса, изменим handle_connection, как в
листинге 21-5: прочитаем HTML-файл, добавим его в ответ как тело и отправим.
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
// --пропуск--
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let http_request: Vec<_> = buf_reader
.lines()
.map(|result| result.unwrap())
.take_while(|line| !line.is_empty())
.collect();
let status_line = "HTTP/1.1 200 OK";
let contents = fs::read_to_string("hello.html").unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}Мы добавили в инструкцию use модуль fs, чтобы подключить модуль файловой
системы стандартной библиотеки. Код чтения содержимого файла в строку должен
быть вам знаком: мы пользовались им, когда читали файл в проекте с
вводом-выводом в листинге 12-4.
Затем с помощью format! добавляем содержимое файла в тело успешного ответа.
Чтобы HTTP-ответ был корректным, добавляем заголовок Content-Length с
размером тела ответа — в нашем случае с размером hello.html.
Запустите этот код через cargo run и откройте в браузере 127.0.0.1:7878 — вы
увидите отрисованный HTML!
Сейчас мы игнорируем данные запроса в http_request и просто безусловно
отправляем содержимое HTML-файла. Значит, если запросить в браузере
127.0.0.1:7878/something-else, вы всё равно получите тот же HTML. Пока наш
сервер очень ограничен и не делает того, что делает большинство веб-серверов.
Мы хотим выбирать ответ в зависимости от запроса и отправлять HTML-файл только
на корректный запрос к /.
Проверяем запрос и отвечаем выборочно
Сейчас наш веб-сервер возвращает HTML из файла, что бы ни запросил клиент.
Добавим проверку: если браузер запрашивает /, вернём HTML-файл, а на любой
другой запрос — ошибку. Для этого нужно изменить handle_connection, как в
листинге 21-6. Новый код сравнивает содержимое полученного запроса с тем, как
выглядит запрос к /, и с помощью блоков if и else обрабатывает запросы
по-разному.
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
// --пропуск--
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
if request_line == "GET / HTTP/1.1" {
let status_line = "HTTP/1.1 200 OK";
let contents = fs::read_to_string("hello.html").unwrap();
let length = contents.len();
let response = format!(
"{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}"
);
stream.write_all(response.as_bytes()).unwrap();
} else {
// какой-то другой запрос
}
}Нас интересует только первая строка HTTP-запроса, поэтому, вместо того чтобы
читать весь запрос в вектор, мы вызываем next и получаем первый элемент
итератора. Первый unwrap разбирается с Option и останавливает программу,
если в итераторе нет элементов. Второй unwrap обрабатывает Result и делает
то же, что unwrap в map из листинга 21-2.
Затем проверяем, совпадает ли request_line со строкой запроса GET к пути /.
Если да, блок if возвращает содержимое нашего HTML-файла.
Если request_line не совпадает с запросом GET к пути /, значит, пришёл
какой-то другой запрос. Код в блоке else, отвечающий на все остальные
запросы, мы добавим чуть позже.
Запустите код и запросите 127.0.0.1:7878 — вы получите HTML из hello.html. А на любой другой запрос, например 127.0.0.1:7878/something-else, получите ошибку соединения — как при запуске кода из листингов 21-1 и 21-2.
Теперь добавим в блок else код из листинга 21-7, который возвращает ответ с
кодом состояния 404 — он означает, что запрошенное содержимое не найдено. Ещё
вернём HTML-страницу, которую браузер покажет пользователю.
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
if request_line == "GET / HTTP/1.1" {
let status_line = "HTTP/1.1 200 OK";
let contents = fs::read_to_string("hello.html").unwrap();
let length = contents.len();
let response = format!(
"{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}"
);
stream.write_all(response.as_bytes()).unwrap();
// --пропуск--
} else {
let status_line = "HTTP/1.1 404 NOT FOUND";
let contents = fs::read_to_string("404.html").unwrap();
let length = contents.len();
let response = format!(
"{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}"
);
stream.write_all(response.as_bytes()).unwrap();
}
}Здесь в строке состояния ответа код 404 и поясняющая фраза NOT FOUND. Телом
ответа будет HTML из файла 404.html. Для страницы ошибки нужно создать файл
404.html рядом с hello.html; опять же, HTML может быть любым — или
воспользуйтесь примером из листинга 21-8.
<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="utf-8">
<title>Hello!</title>
</head>
<body>
<h1>Oops!</h1>
<p>Sorry, I don't know what you're asking for.</p>
</body>
</html>
С этими изменениями снова запустите сервер. Запрос 127.0.0.1:7878 должен возвращать содержимое hello.html, а любой другой запрос, например 127.0.0.1:7878/foo, — HTML ошибки из 404.html.
Рефакторинг
Сейчас в блоках if и else много повторов: оба читают файлы и пишут их
содержимое в поток. Различаются только строка состояния и имя файла. Сделаем
код лаконичнее: вынесем различия в отдельные строки if и else, которые
присваивают переменным значения строки состояния и имени файла, а затем
безусловно используем эти переменные в коде, который читает файл и пишет
ответ. В листинге 21-9 — код после замены больших блоков if и else.
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
// --пропуск--
fn handle_connection(mut stream: TcpStream) {
// --пропуск--
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = if request_line == "GET / HTTP/1.1" {
("HTTP/1.1 200 OK", "hello.html")
} else {
("HTTP/1.1 404 NOT FOUND", "404.html")
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}if и else, чтобы в них остался только код, который различается в двух случаяхТеперь блоки if и else только возвращают подходящие значения строки
состояния и имени файла в виде кортежа. Затем с помощью образца в инструкции
let мы деструктурируем кортеж и присваиваем эти два значения переменным
status_line и filename, как обсуждалось в главе 19.
Код, который раньше дублировался, теперь вне блоков if и else и использует
переменные status_line и filename. Так легче увидеть разницу между двумя
случаями, а если понадобится изменить чтение файла и запись ответа, править
придётся только одно место. Поведение кода из листинга 21-9 такое же, как в
листинге 21-7.
Здорово! Теперь у нас есть простой веб-сервер примерно из 40 строк кода на Rust: на один запрос он отвечает страницей с содержимым, а на все остальные — ответом 404.
Сейчас сервер работает в одном потоке, то есть обслуживает только один запрос за раз. Сымитируем несколько медленных запросов и посмотрим, почему это может быть проблемой. А потом исправим, чтобы сервер мог обрабатывать несколько запросов одновременно.
От однопоточного сервера к многопоточному
От однопоточного сервера к многопоточному
Сейчас сервер обрабатывает запросы по очереди: второе соединение он не начнёт обрабатывать, пока не закончит с первым. Чем больше запросов приходит на сервер, тем хуже такая последовательная обработка. Если на сервер придёт запрос, обработка которого занимает много времени, всем следующим запросам придётся ждать, пока он не завершится, — даже если сами они обрабатываются быстро. Это нужно исправить, но сначала посмотрим на проблему в действии.
Имитируем медленный запрос
Посмотрим, как медленный запрос влияет на остальные запросы к нашему серверу в его текущем виде. В листинге 21-10 добавлена обработка запроса к /sleep с имитацией медленного ответа: прежде чем ответить, сервер «засыпает» на пять секунд.
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
// --пропуск--
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
fn handle_connection(mut stream: TcpStream) {
// --пропуск--
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
// --пропуск--
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}Случаев теперь три, поэтому мы перешли с if на match. Чтобы сопоставлять с
образцами-строковыми литералами, нужно явно сопоставлять срез request_line:
match, в отличие от метода проверки на равенство, не выполняет автоматическое
взятие ссылки и разыменование.
Первая ветка такая же, как блок if из листинга 21-9. Вторая ветка
соответствует запросу к /sleep: получив его, сервер поспит пять секунд, а
потом отрисует страницу успешного ответа. Третья ветка такая же, как блок
else из листинга 21-9.
Видно, насколько примитивен наш сервер: настоящие библиотеки распознают разные запросы гораздо лаконичнее!
Запустите сервер командой cargo run. Затем откройте два окна браузера: одно
для http://127.0.0.1:7878, другое для http://127.0.0.1:7878/sleep. Если
несколько раз открыть URI /, как раньше, он будет отвечать быстро. Но если
открыть /sleep, а затем загрузить /, то / будет ждать, пока sleep не
проспит свои пять секунд, и только потом загрузится.
Чтобы запросы не скапливались за медленным, есть несколько приёмов — например, асинхронность, как в главе 17. Мы же реализуем пул потоков.
Увеличиваем пропускную способность с помощью пула потоков
Пул потоков (thread pool) — это группа заранее запущенных потоков, которые ждут, когда им дадут задачу. Получив новую задачу, программа назначает на неё один из потоков пула, и этот поток её обрабатывает. Остальные потоки пула свободны и могут взять другие задачи, пришедшие, пока первый поток занят. Закончив свою задачу, первый поток возвращается в пул свободных потоков и готов к новой. Пул потоков позволяет обрабатывать соединения конкурентно и тем самым увеличивает пропускную способность сервера.
Число потоков в пуле мы ограничим небольшим значением, чтобы защититься от DoS-атак: если бы программа создавала новый поток на каждый пришедший запрос, кто-нибудь мог бы отправить на сервер 10 миллионов запросов, исчерпать все его ресурсы и полностью остановить обработку запросов.
Поэтому вместо неограниченного числа потоков в пуле будет ждать фиксированное
их количество. Пришедшие запросы отправляются в пул на обработку. Пул ведёт
очередь входящих запросов. Каждый поток пула берёт запрос из этой очереди,
обрабатывает его и просит у очереди следующий. При таком устройстве можно
обрабатывать до N запросов конкурентно, где N — число потоков. Если
каждый поток занят долгим запросом, следующие запросы всё равно могут
скапливаться в очереди, но мы увеличили число долгих запросов, которые сервер
выдержит, прежде чем до этого дойдёт.
Это лишь один из многих способов увеличить пропускную способность веб-сервера. Можно изучить и другие варианты: модель fork/join, однопоточную модель асинхронного ввода-вывода, многопоточную модель асинхронного ввода-вывода. Если тема вам интересна, почитайте о других решениях и попробуйте их реализовать: в низкоуровневом языке вроде Rust возможны все эти варианты.
Прежде чем реализовывать пул потоков, поговорим о том, как им должно быть удобно пользоваться. Когда проектируете код, полезно сначала написать клиентский интерфейс — он подскажет, каким должно быть устройство. Напишите API так, как вам хотелось бы его вызывать, а затем реализуйте функциональность внутри этой структуры, а не наоборот — сначала функциональность, а потом публичный API.
Подобно тому как в проекте из главы 12 мы разрабатывали через тесты, здесь мы будем разрабатывать «через компилятор». Напишем код, вызывающий нужные нам функции, а потом по ошибкам компилятора будем решать, что поменять дальше, чтобы код заработал. Но сначала в качестве отправной точки посмотрим на приём, которым мы пользоваться не будем.
По потоку на каждый запрос
Сначала посмотрим, как выглядел бы код, если бы он создавал новый поток на каждое соединение. Как уже говорилось, это не окончательный план — из-за проблем с потенциально неограниченным числом потоков, — но это отправная точка, чтобы сначала получить работающий многопоточный сервер. Потом мы добавим пул потоков как улучшение, и сравнивать два решения будет проще.
В листинге 21-11 показано, что нужно изменить в main, чтобы в цикле for для
обработки каждого потока создавался новый поток выполнения.
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
thread::spawn(|| {
handle_connection(stream);
});
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}Примечание: в этой главе слово «поток» встречается в двух значениях: поток
выполнения (thread) и поток данных (stream) — в нашем случае
TcpStream. Где из контекста не очевидно, о каком идёт речь, мы уточняем.
Как вы узнали в главе 16, thread::spawn создаёт новый поток и выполняет в нём
код замыкания. Если запустить этот код, открыть в браузере /sleep, а затем /
ещё в двух вкладках, вы увидите, что запросам к / действительно не нужно ждать
окончания /sleep. Но, как мы уже говорили, рано или поздно это перегрузит
систему, ведь новые потоки создаются без всякого ограничения.
Возможно, вы помните из главы 17, что это именно тот случай, где async и await по-настоящему блистают! Держите это в голове, пока мы строим пул потоков, и думайте, что было бы иначе, а что так же, если бы мы использовали async.
Создаём ограниченное число потоков
Мы хотим, чтобы пул потоков работал похожим, привычным образом, — тогда
переход с потоков на пул не потребует больших изменений в коде, который
использует наш API. В листинге 21-12 показан гипотетический интерфейс структуры
ThreadPool, которую мы хотим использовать вместо thread::spawn.
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
let pool = ThreadPool::new(4);
for stream in listener.incoming() {
let stream = stream.unwrap();
pool.execute(|| {
handle_connection(stream);
});
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}ThreadPoolС помощью ThreadPool::new мы создаём пул с настраиваемым числом потоков — в
данном случае с четырьмя. Затем в цикле for вызываем pool.execute, интерфейс
которого похож на thread::spawn: он принимает замыкание, которое пул должен
выполнить для каждого потока данных. Нужно реализовать pool.execute так, чтобы
он брал замыкание и отдавал его на выполнение одному из потоков пула. Этот код
пока не скомпилируется, но мы всё равно попробуем — пусть компилятор подскажет,
как его исправить.
Строим ThreadPool, следуя подсказкам компилятора
Внесите в src/main.rs изменения из листинга 21-12 и будем двигаться вперёд по
ошибкам компилятора из cargo check. Вот первая ошибка:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
error[E0433]: cannot find type `ThreadPool` in this scope
--> src/main.rs:11:16
|
11 | let pool = ThreadPool::new(4);
| ^^^^^^^^^^ use of undeclared type `ThreadPool`
For more information about this error, try `rustc --explain E0433`.
error: could not compile `hello` (bin "hello") due to 1 previous error
Отлично! Ошибка говорит, что нужен тип или модуль ThreadPool, — его мы сейчас
и сделаем. Реализация ThreadPool не будет зависеть от того, какую работу
выполняет веб-сервер. Поэтому превратим крейт hello из бинарного в
библиотечный, и в нём будет жить реализация ThreadPool. После этого отдельную
библиотеку пула потоков можно будет использовать для любой работы, которой
нужен пул потоков, а не только для обслуживания веб-запросов.
Создайте файл src/lib.rs со следующим содержимым — это самое простое
определение структуры ThreadPool, какое пока возможно:
pub struct ThreadPool;Затем отредактируйте main.rs: подключите ThreadPool из библиотечного крейта,
добавив в начало src/main.rs такой код:
use hello::ThreadPool;
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
let pool = ThreadPool::new(4);
for stream in listener.incoming() {
let stream = stream.unwrap();
pool.execute(|| {
handle_connection(stream);
});
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}Код всё ещё не работает, но проверим его снова и получим следующую ошибку, с которой надо разобраться:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
error[E0599]: no associated function or constant named `new` found for struct `ThreadPool` in the current scope
--> src/main.rs:12:28
|
12 | let pool = ThreadPool::new(4);
| ^^^ associated function or constant not found in `ThreadPool`
For more information about this error, try `rustc --explain E0599`.
error: could not compile `hello` (bin "hello") due to 1 previous error
Эта ошибка говорит, что дальше нужно создать для ThreadPool ассоциированную
функцию new. Мы также знаем, что у new должен быть один параметр, способный
принять аргумент 4, и что она должна возвращать экземпляр ThreadPool.
Реализуем самую простую функцию new с такими свойствами:
pub struct ThreadPool;
impl ThreadPool {
pub fn new(size: usize) -> ThreadPool {
ThreadPool
}
}Для параметра size мы выбрали тип usize, потому что отрицательное число
потоков не имеет смысла. К тому же эта 4 будет числом элементов в коллекции
потоков, а именно для этого и нужен тип usize, как говорилось в разделе
«Целочисленные типы» главы 3.
Проверим код ещё раз:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
error[E0599]: no method named `execute` found for struct `ThreadPool` in the current scope
--> src/main.rs:17:14
|
17 | pool.execute(|| {
| -----^^^^^^^ method not found in `ThreadPool`
For more information about this error, try `rustc --explain E0599`.
error: could not compile `hello` (bin "hello") due to 1 previous error
Теперь ошибка в том, что у ThreadPool нет метода execute. Вспомните: в
разделе «Создаём ограниченное число
потоков» мы решили, что
интерфейс пула потоков должен быть похож на thread::spawn. Кроме того, мы
реализуем функцию execute так, чтобы она брала переданное замыкание и
отдавала его на выполнение свободному потоку пула.
Определим у ThreadPool метод execute, принимающий замыкание в качестве
параметра. Как говорилось в разделе «Перемещение захваченных значений из
замыкания» главы 13, принимать замыкания
в параметрах можно с тремя разными трейтами: Fn, FnMut и FnOnce. Нужно
решить, какой вид замыкания использовать здесь. Мы знаем, что в итоге сделаем
что-то похожее на реализацию thread::spawn из стандартной библиотеки, поэтому
можно посмотреть, какие ограничения накладывает на свой параметр сигнатура
thread::spawn. Документация показывает следующее:
pub fn spawn<F, T>(f: F) -> JoinHandle<T>
where
F: FnOnce() -> T,
F: Send + 'static,
T: Send + 'static,Нас интересует параметр типа F; параметр T связан с возвращаемым значением,
и он нам не важен. Видно, что spawn ограничивает F трейтом FnOnce.
Вероятно, нам нужно то же самое: аргумент, полученный в execute, мы в итоге
передадим в spawn. Ещё больше уверенности в том, что FnOnce — нужный трейт,
даёт то, что поток, обрабатывающий запрос, выполнит замыкание этого запроса
ровно один раз, — это и есть Once в FnOnce.
У параметра типа F есть ещё ограничение трейтом Send и ограничение времени
жизни 'static, и оба пригодятся в нашей ситуации: Send нужен, чтобы
передавать замыкание из одного потока в другой, а 'static — потому что мы не
знаем, сколько времени поток будет его выполнять. Создадим у ThreadPool метод
execute, принимающий обобщённый параметр типа F с этими ограничениями:
pub struct ThreadPool;
impl ThreadPool {
// --пропуск--
pub fn new(size: usize) -> ThreadPool {
ThreadPool
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}После FnOnce по-прежнему стоят (), потому что этот FnOnce описывает
замыкание без параметров, возвращающее единичный тип (). Как и в определениях
функций, возвращаемый тип можно опустить из сигнатуры, но скобки нужны, даже
если параметров нет.
Опять же, это самая простая реализация метода execute: он ничего не делает,
мы лишь добиваемся, чтобы код скомпилировался. Проверим ещё раз:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.24s
Компилируется! Но учтите: если выполнить cargo run и сделать запрос в
браузере, вы увидите те же ошибки, что и в начале главы. Наша библиотека пока
не вызывает замыкание, переданное в execute!
Примечание: о языках со строгими компиляторами, таких как Haskell и Rust, иногда говорят: «Если код компилируется — он работает». Но это верно далеко не всегда. Наш проект компилируется, но не делает абсолютно ничего! Будь это настоящий, полноценный проект, сейчас самое время начать писать модульные тесты, проверяющие, что код компилируется и ведёт себя так, как нам нужно.
Подумайте: что было бы иначе, если бы мы выполняли не замыкание, а футуру?
Проверяем число потоков в new
Мы пока никак не используем параметры new и execute. Реализуем тела этих
функций с нужным поведением. Начнём с new. Раньше мы выбрали для параметра
size беззнаковый тип, потому что пул с отрицательным числом потоков не имеет
смысла. Но и пул с нулём потоков не имеет смысла, а ноль — вполне допустимое
значение usize. Добавим проверку, что size больше нуля, прежде чем вернуть
экземпляр ThreadPool, и с помощью макроса assert! заставим программу
паниковать, если пришёл ноль, как в листинге 21-13.
pub struct ThreadPool;
impl ThreadPool {
/// Создаёт новый ThreadPool.
///
/// size — число потоков в пуле.
///
/// # Паника
///
/// Функция `new` паникует, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
ThreadPool
}
// --пропуск--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}ThreadPool::new паникует, если size равен нулюМы также добавили к ThreadPool документационные комментарии. Обратите
внимание: следуя хорошим практикам документирования, мы добавили раздел,
описывающий ситуации, в которых функция может паниковать, — как обсуждалось в
главе 14. Попробуйте выполнить cargo doc --open и щёлкнуть по структуре
ThreadPool, чтобы увидеть, как выглядит сгенерированная документация для
new!
Вместо макроса assert! можно было бы переименовать new в build и
возвращать Result, как мы сделали с Config::build в проекте с вводом-выводом
в листинге 12-9. Но здесь мы решили, что попытка создать пул потоков вообще без
потоков должна быть неисправимой ошибкой. Если чувствуете в себе силы,
попробуйте написать функцию build с такой сигнатурой и сравните её с функцией
new:
pub fn build(size: usize) -> Result<ThreadPool, PoolCreationError> {Готовим место для хранения потоков
Теперь, когда мы знаем, что число потоков для пула допустимо, можно создать эти
потоки и сохранить их в структуре ThreadPool, прежде чем её вернуть. Но как
«сохранить» поток? Взглянем ещё раз на сигнатуру thread::spawn:
pub fn spawn<F, T>(f: F) -> JoinHandle<T>
where
F: FnOnce() -> T,
F: Send + 'static,
T: Send + 'static,Функция spawn возвращает JoinHandle<T>, где T — тип, который возвращает
замыкание. Попробуем тоже использовать JoinHandle и посмотрим, что получится.
В нашем случае замыкания, которые мы передаём пулу, обрабатывают соединение и
ничего не возвращают, так что T будет единичным типом ().
Код из листинга 21-14 скомпилируется, но потоков пока не создаёт. Мы изменили
определение ThreadPool, чтобы оно хранило вектор экземпляров
thread::JoinHandle<()>, инициализировали вектор ёмкостью size, завели цикл
for, в котором будет код создания потоков, и возвращаем экземпляр
ThreadPool, который их содержит.
use std::thread;
pub struct ThreadPool {
threads: Vec<thread::JoinHandle<()>>,
}
impl ThreadPool {
// --пропуск--
/// Создаёт новый ThreadPool.
///
/// size — число потоков в пуле.
///
/// # Паника
///
/// Функция `new` паникует, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let mut threads = Vec::with_capacity(size);
for _ in 0..size {
// создаём потоки и сохраняем их в векторе
}
ThreadPool { threads }
}
// --пропуск--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}ThreadPool вектор для хранения потоковМы подключили std::thread в библиотечном крейте, потому что используем
thread::JoinHandle как тип элементов вектора в ThreadPool.
Получив допустимый размер, ThreadPool создаёт новый вектор, способный вместить
size элементов. Функция with_capacity делает то же, что Vec::new, но с
важным отличием: она заранее выделяет место в векторе. Мы знаем, что нам нужно
хранить в векторе size элементов, поэтому выделить память сразу немного
эффективнее, чем использовать Vec::new, который меняет размер по мере
добавления элементов.
Если снова запустить cargo check, проверка должна пройти успешно.
Передаём код из ThreadPool в поток
В цикле for из листинга 21-14 мы оставили комментарий о создании потоков.
Теперь разберёмся, как на самом деле их создавать. Стандартная библиотека
предоставляет для создания потоков thread::spawn, и thread::spawn ожидает
получить код, который поток должен выполнить сразу после создания. Но нам нужно
создать потоки и заставить их ждать код, который мы отправим позже. В
стандартной реализации потоков такой возможности нет — придётся реализовать её
вручную.
Для этого введём между ThreadPool и потоками новую структуру данных, которая
и будет отвечать за это поведение. Назовём её Worker («работник») — это
распространённый термин в реализациях пулов. Worker забирает код, который
нужно выполнить, и выполняет его в своём потоке.
Представьте поваров на кухне ресторана: они ждут, пока от посетителей придут заказы, а затем берут эти заказы и выполняют их.
Вместо вектора экземпляров JoinHandle<()> будем хранить в пуле экземпляры
структуры Worker. Каждый Worker будет хранить один экземпляр
JoinHandle<()>. Затем реализуем у Worker метод, который будет принимать
замыкание с кодом и отправлять его на выполнение в уже работающий поток. Ещё
дадим каждому Worker идентификатор id, чтобы различать экземпляры Worker
в пуле при логировании и отладке.
Вот как будет выглядеть создание ThreadPool теперь. Код, отправляющий
замыкание в поток, мы напишем, когда Worker будет устроен так:
- Определить структуру
Worker, которая хранитidиJoinHandle<()>. - Изменить
ThreadPool, чтобы он хранил вектор экземпляровWorker. - Определить функцию
Worker::new, которая принимает числоidи возвращает экземплярWorkerс этимidи потоком, запущенным с пустым замыканием. - В
ThreadPool::newс помощью счётчика циклаforгенерироватьid, создавать новыйWorkerс этимidи сохранять его в векторе.
Если хотите испытать себя, попробуйте внести эти изменения сами, прежде чем смотреть на код в листинге 21-15.
Готовы? Вот листинг 21-15 с одним из вариантов этих изменений.
use std::thread;
pub struct ThreadPool {
workers: Vec<Worker>,
}
impl ThreadPool {
// --пропуск--
/// Создаёт новый ThreadPool.
///
/// size — число потоков в пуле.
///
/// # Паника
///
/// Функция `new` паникует, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id));
}
ThreadPool { workers }
}
// --пропуск--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize) -> Worker {
let thread = thread::spawn(|| {});
Worker { id, thread }
}
}ThreadPool хранит экземпляры Worker вместо того, чтобы хранить потоки напрямуюМы переименовали поле ThreadPool из threads в workers, потому что теперь в
нём хранятся экземпляры Worker, а не JoinHandle<()>. Счётчик цикла for мы
передаём аргументом в Worker::new, а каждый новый Worker сохраняем в векторе
workers.
Внешнему коду (например, нашему серверу в src/main.rs) не нужно знать
подробности реализации — то, что внутри ThreadPool используется структура
Worker, — поэтому мы делаем структуру Worker и её функцию new приватными.
Функция Worker::new использует переданный ей id и сохраняет экземпляр
JoinHandle<()>, полученный при запуске нового потока с пустым замыканием.
Примечание: если операционная система не может создать поток из-за нехватки
системных ресурсов, thread::spawn запаникует. Тогда запаникует и весь наш
сервер, даже если часть потоков создать удалось. Для простоты такое поведение
нас устроит, но в реализации пула потоков для продакшена вы, скорее всего,
захотите использовать std::thread::Builder и его
метод spawn, который возвращает Result.
Этот код скомпилируется и сохранит столько экземпляров Worker, сколько мы
указали аргументом ThreadPool::new. Но замыкание, которое мы получаем в
execute, мы всё ещё не обрабатываем. Разберёмся с этим дальше.
Отправляем запросы в потоки через каналы
Следующая проблема: замыкания, переданные в thread::spawn, не делают
абсолютно ничего. Сейчас замыкание, которое нужно выполнить, мы получаем в
методе execute. Но передать замыкание в thread::spawn нужно при создании
каждого Worker, то есть при создании ThreadPool.
Мы хотим, чтобы только что созданные структуры Worker забирали код из
очереди, которую хранит ThreadPool, и отправляли его на выполнение в свой
поток.
Каналы из главы 16 — простой способ связи между двумя потоками — идеально
подходят для этой задачи. Канал будет играть роль очереди заданий, а execute
будет отправлять задание из ThreadPool экземплярам Worker, а те — в свой
поток. План такой:
ThreadPoolсоздаёт канал и хранит у себя отправителя.- Каждый
Workerхранит у себя получателя. - Создаём новую структуру
Job, которая будет хранить замыкания, отправляемые по каналу. - Метод
executeотправляет задание, которое нужно выполнить, через отправителя. Workerв своём потоке в цикле читает получателя и выполняет замыкания всех полученных заданий.
Начнём с того, что создадим канал в ThreadPool::new и сохраним отправителя в
экземпляре ThreadPool, как в листинге 21-16. Структура Job пока ничего не
хранит, но это будет тип элементов, которые мы отправляем по каналу.
use std::{sync::mpsc, thread};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
struct Job;
impl ThreadPool {
// --пропуск--
/// Создаёт новый ThreadPool.
///
/// size — число потоков в пуле.
///
/// # Паника
///
/// Функция `new` паникует, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id));
}
ThreadPool { workers, sender }
}
// --пропуск--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize) -> Worker {
let thread = thread::spawn(|| {});
Worker { id, thread }
}
}ThreadPool хранит отправителя канала, который передаёт экземпляры JobВ ThreadPool::new мы создаём новый канал, и пул хранит отправителя. Это
успешно скомпилируется.
Попробуем при создании канала передать получателя в каждый Worker. Мы знаем,
что получатель нужен в потоке, который запускает Worker, поэтому обратимся к
параметру receiver в замыкании. Код из листинга 21-17 пока не совсем
компилируется.
use std::{sync::mpsc, thread};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
struct Job;
impl ThreadPool {
// --пропуск--
/// Создаёт новый ThreadPool.
///
/// size — число потоков в пуле.
///
/// # Паника
///
/// Функция `new` паникует, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, receiver));
}
ThreadPool { workers, sender }
}
// --пропуск--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}
// --пропуск--
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: mpsc::Receiver<Job>) -> Worker {
let thread = thread::spawn(|| {
receiver;
});
Worker { id, thread }
}
}WorkerИзменения небольшие и простые: передаём получателя в Worker::new, а затем
используем его внутри замыкания.
При проверке этого кода получаем ошибку:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
error[E0382]: use of moved value: `receiver`
--> src/lib.rs:26:42
|
21 | let (sender, receiver) = mpsc::channel();
| -------- move occurs because `receiver` has type `std::sync::mpsc::Receiver<Job>`, which does not implement the `Copy` trait
...
25 | for id in 0..size {
| ----------------- inside of this loop
26 | workers.push(Worker::new(id, receiver));
| ^^^^^^^^ value moved here, in previous iteration of loop
|
note: consider changing this parameter type in method `new` to borrow instead if owning the value isn't necessary
--> src/lib.rs:47:33
|
47 | fn new(id: usize, receiver: mpsc::Receiver<Job>) -> Worker {
| --- in this method ^^^^^^^^^^^^^^^^^^^ this parameter takes ownership of the value
For more information about this error, try `rustc --explain E0382`.
error: could not compile `hello` (lib) due to 1 previous error
Код пытается передать receiver нескольким экземплярам Worker. Так не выйдет
— вспомните главу 16: каналы в Rust устроены по схеме «много производителей,
один потребитель». Значит, просто клонировать принимающий конец канала,
чтобы исправить код, нельзя. К тому же мы не хотим отправлять одно сообщение
нескольким потребителям много раз: нам нужен один список сообщений и несколько
экземпляров Worker, причём так, чтобы каждое сообщение обрабатывалось один
раз.
Кроме того, чтобы взять задание из очереди канала, нужно изменить receiver,
поэтому потокам нужен безопасный способ совместно владеть receiver и изменять
его — иначе возможны состояния гонки (см. главу 16).
Вспомните потокобезопасные умные указатели из главы 16: чтобы разделить
владение между несколькими потоками и позволить им изменять значение, нужен
Arc<Mutex<T>>. Arc позволит нескольким экземплярам Worker владеть
получателем, а Mutex гарантирует, что в каждый момент задание из получателя
берёт только один Worker. Нужные изменения — в листинге 21-18.
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
// --пропуск--
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
struct Job;
impl ThreadPool {
// --пропуск--
/// Создаёт новый ThreadPool.
///
/// size — число потоков в пуле.
///
/// # Паника
///
/// Функция `new` паникует, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
// --пропуск--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}
// --пропуск--
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
// --пропуск--
let thread = thread::spawn(|| {
receiver;
});
Worker { id, thread }
}
}Worker совместно используют получателя с помощью Arc и MutexВ ThreadPool::new мы помещаем получателя в Arc и Mutex. Для каждого нового
Worker клонируем Arc, увеличивая счётчик ссылок, чтобы экземпляры Worker
могли совместно владеть получателем.
С этими изменениями код компилируется! Мы почти у цели!
Реализуем метод execute
Наконец реализуем метод execute у ThreadPool. Заодно превратим Job из
структуры в псевдоним типа для трейт-объекта, хранящего тип замыкания, которое
получает execute. Как говорилось в разделе «Синонимы и псевдонимы
типов» главы 20, псевдонимы типов позволяют
сокращать длинные типы для удобства. Посмотрите на листинг 21-19.
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
// --пропуск--
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
// --пропуск--
/// Создаёт новый ThreadPool.
///
/// size — число потоков в пуле.
///
/// # Паника
///
/// Функция `new` паникует, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.send(job).unwrap();
}
}
// --пропуск--
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(|| {
receiver;
});
Worker { id, thread }
}
}Job для Box, в котором хранится каждое замыкание, и отправляем задание по каналуСоздав новый экземпляр Job из замыкания, полученного в execute, мы
отправляем это задание в передающий конец канала. На send вызываем unwrap на
случай, если отправка не удастся. Такое может случиться, например, если мы
остановим все потоки, — тогда принимающий конец перестанет получать новые
сообщения. Пока что остановить потоки мы не можем: они работают, пока
существует пул. unwrap мы используем потому, что знаем: этот сбой не
произойдёт, — но компилятор этого не знает.
Но это ещё не всё! В Worker замыкание, передаваемое в thread::spawn, по-
прежнему лишь ссылается на принимающий конец канала. А нам нужно, чтобы
замыкание бесконечно крутилось в цикле: просило у принимающего конца канала
задание и выполняло его, когда получит. Внесём в Worker::new изменение из
листинга 21-20.
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Создаёт новый ThreadPool.
///
/// size — число потоков в пуле.
///
/// # Паника
///
/// Функция `new` паникует, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.send(job).unwrap();
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
// --пропуск--
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let job = receiver.lock().unwrap().recv().unwrap();
println!("Worker {id} got a job; executing.");
job();
}
});
Worker { id, thread }
}
}WorkerЗдесь мы сначала вызываем lock у receiver, чтобы захватить мьютекс, а затем
unwrap, чтобы паниковать при любых ошибках. Захват блокировки может не
удаться, если мьютекс отравлен (poisoned): так бывает, когда какой-то другой
поток запаниковал, удерживая блокировку, и не освободил её. В такой ситуации
вызвать unwrap, чтобы запаниковал и этот поток, — правильное решение. Можете
заменить этот unwrap на expect с сообщением об ошибке, которое вам будет
понятно.
Захватив мьютекс, вызываем recv, чтобы получить Job из канала. Последний
unwrap тоже пропускает любые ошибки; они возможны, если поток, владеющий
отправителем, завершился, — подобно тому, как метод send возвращает Err,
если завершился получатель.
Вызов recv блокирующий: если заданий пока нет, текущий поток будет ждать,
пока задание не появится. Mutex<T> гарантирует, что запрашивать задание в
каждый момент пытается только один поток Worker.
Теперь пул потоков работает! Запустите cargo run и сделайте несколько
запросов:
$ cargo run
Compiling hello v0.1.0 (file:///projects/hello)
warning: field `workers` is never read
--> src/lib.rs:7:5
|
6 | pub struct ThreadPool {
| ---------- field in this struct
7 | workers: Vec<Worker>,
| ^^^^^^^
|
= note: `#[warn(dead_code)]` on by default
warning: fields `id` and `thread` are never read
--> src/lib.rs:48:5
|
47 | struct Worker {
| ------ fields in this struct
48 | id: usize,
| ^^
49 | thread: thread::JoinHandle<()>,
| ^^^^^^
warning: `hello` (lib) generated 2 warnings
Finished `dev` profile [unoptimized + debuginfo] target(s) in 4.91s
Running `target/debug/hello`
Worker 0 got a job; executing.
Worker 2 got a job; executing.
Worker 1 got a job; executing.
Worker 3 got a job; executing.
Worker 0 got a job; executing.
Worker 2 got a job; executing.
Worker 1 got a job; executing.
Worker 3 got a job; executing.
Worker 0 got a job; executing.
Worker 2 got a job; executing.
Получилось! Теперь у нас есть пул потоков, который обрабатывает соединения асинхронно. Потоков никогда не создаётся больше четырёх, так что система не перегрузится, даже если на сервер придёт много запросов. Если сделать запрос к /sleep, сервер сможет обслуживать другие запросы, выполняя их в другом потоке.
Примечание: если открыть /sleep одновременно в нескольких окнах браузера, они могут загружаться по одному с интервалом в пять секунд. Некоторые браузеры ради кеширования выполняют несколько одинаковых запросов последовательно. Это ограничение вызвано не нашим веб-сервером.
Самое время остановиться и подумать: чем отличался бы код из листингов 21-18, 21-19 и 21-20, если бы работа задавалась не замыканием, а футурами? Какие типы изменились бы? Изменились бы сигнатуры методов, и если да, то как? Какие части кода остались бы прежними?
Познакомившись с циклом while let в главах 17 и 19, вы, возможно, задаётесь
вопросом: почему мы не написали код потока Worker так, как в листинге 21-21?
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Создаёт новый ThreadPool.
///
/// size — число потоков в пуле.
///
/// # Паника
///
/// Функция `new` паникует, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.send(job).unwrap();
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
// --пропуск--
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
while let Ok(job) = receiver.lock().unwrap().recv() {
println!("Worker {id} got a job; executing.");
job();
}
});
Worker { id, thread }
}
}Worker::new с помощью while letЭтот код компилируется и запускается, но нужного многопоточного поведения не
даёт: медленный запрос всё так же заставляет остальные запросы ждать. Причина
довольно тонкая. У структуры Mutex нет публичного метода unlock, потому что
владение блокировкой определяется временем жизни MutexGuard<T> внутри
LockResult<MutexGuard<T>>, который возвращает метод lock. Благодаря этому
анализатор заимствований ещё на этапе компиляции следит за правилом: к ресурсу
под защитой Mutex нельзя обратиться, не удерживая блокировку. Но из-за этого
же блокировка может удерживаться дольше, чем задумано, если не следить за
временем жизни MutexGuard<T>.
Код из листинга 21-20 с let job = receiver.lock().unwrap().recv().unwrap();
работает, потому что при let все временные значения из выражения справа от
знака равенства уничтожаются сразу, как только заканчивается инструкция let.
А вот while let (а также if let и match) не уничтожает временные значения
до конца связанного с ним блока. В листинге 21-21 блокировка удерживается всё
время, пока выполняется вызов job(), а значит, другие экземпляры Worker не
могут получать задания.
Корректное завершение и очистка
Корректное завершение и очистка
Код из листинга 21-20, как мы и хотели, отвечает на запросы асинхронно с
помощью пула потоков. Компилятор выдаёт предупреждения о полях workers, id и
thread, которые мы напрямую не используем, — это напоминание о том, что мы
ничего за собой не убираем. Когда мы останавливаем главный поток не самым
изящным способом — сочетанием ctrl-C, — все остальные
потоки тоже немедленно останавливаются, даже если они как раз обслуживают
запрос.
Поэтому дальше мы реализуем трейт Drop, чтобы вызывать join для каждого
потока пула: так потоки смогут закончить запросы, над которыми работают, прежде
чем закрыться. Затем реализуем способ сказать потокам, что им пора перестать
принимать новые запросы и завершиться. Чтобы увидеть этот код в действии,
изменим сервер так, чтобы он принимал только два запроса, а затем корректно
останавливал свой пул потоков.
Обратите внимание по ходу дела: ничто из этого не затрагивает код, который выполняет замыкания, так что всё здесь было бы точно так же, если бы мы использовали пул потоков для асинхронной среды выполнения.
Реализуем трейт Drop для ThreadPool
Начнём с реализации Drop для нашего пула потоков. Когда пул уничтожается, все
его потоки должны быть присоединены (join), чтобы гарантированно закончить
свою работу. В листинге 21-22 — первая попытка реализовать Drop; этот код
пока не совсем работает.
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Создаёт новый ThreadPool.
///
/// size — число потоков в пуле.
///
/// # Паника
///
/// Функция `new` паникует, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.send(job).unwrap();
}
}
impl Drop for ThreadPool {
fn drop(&mut self) {
for worker in &mut self.workers {
println!("Shutting down worker {}", worker.id);
worker.thread.join().unwrap();
}
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let job = receiver.lock().unwrap().recv().unwrap();
println!("Worker {id} got a job; executing.");
job();
}
});
Worker { id, thread }
}
}Сначала перебираем в цикле все workers пула. Используем для этого &mut,
потому что self — изменяемая ссылка, а ещё нам нужно иметь возможность
изменять worker. Для каждого worker выводим сообщение о том, что этот
экземпляр Worker завершает работу, а затем вызываем join у потока этого
экземпляра. Если вызов join не удастся, с помощью unwrap заставляем Rust
запаниковать и завершиться уже некорректно.
При компиляции этого кода получаем ошибку:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
error[E0507]: cannot move out of `worker.thread` which is behind a mutable reference
--> src/lib.rs:52:13
|
52 | worker.thread.join().unwrap();
| ^^^^^^^^^^^^^ ------ `worker.thread` moved due to this method call
| |
| move occurs because `worker.thread` has type `JoinHandle<()>`, which does not implement the `Copy` trait
|
note: `JoinHandle::<T>::join` takes ownership of the receiver `self`, which moves `worker.thread`
--> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/std/src/thread/join_handle.rs:149:16
For more information about this error, try `rustc --explain E0507`.
error: could not compile `hello` (lib) due to 1 previous error
Ошибка говорит, что вызвать join нельзя: у нас есть лишь изменяемое
заимствование каждого worker, а join забирает владение своим аргументом.
Чтобы решить проблему, нужно переместить поток из экземпляра Worker, который
владеет thread, — тогда join сможет поглотить поток. Один из способов —
поступить так же, как в листинге 18-15. Если бы Worker хранил
Option<thread::JoinHandle<()>>, можно было бы вызвать у Option метод take:
он забирает значение из варианта Some и оставляет на его месте None. Иначе
говоря, у работающего Worker в thread был бы Some, а когда понадобилось бы
убрать за Worker, мы бы заменили Some на None, и потока для выполнения у
Worker не осталось бы.
Но понадобилось бы это только при уничтожении Worker. А взамен пришлось бы
возиться с Option<thread::JoinHandle<()>> везде, где мы обращаемся к
worker.thread. В идиоматичном Rust Option используется довольно часто, но
если вы ловите себя на том, что в качестве обходного пути заворачиваете в
Option то, что, как вы знаете, всегда будет на месте, — стоит поискать другой
подход, чтобы код был чище и в нём было меньше места для ошибок.
В данном случае есть вариант получше — метод Vec::drain. Он принимает
диапазон, указывающий, какие элементы удалить из вектора, и возвращает итератор
по этим элементам. Если передать диапазон .., из вектора будут удалены все
значения.
Итак, нужно обновить реализацию drop у ThreadPool вот так:
#![allow(unused)]
fn main() {
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Создаёт новый ThreadPool.
///
/// size — число потоков в пуле.
///
/// # Паника
///
/// Функция `new` паникует, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.send(job).unwrap();
}
}
impl Drop for ThreadPool {
fn drop(&mut self) {
for worker in self.workers.drain(..) {
println!("Shutting down worker {}", worker.id);
worker.thread.join().unwrap();
}
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let job = receiver.lock().unwrap().recv().unwrap();
println!("Worker {id} got a job; executing.");
job();
}
});
Worker { id, thread }
}
}
}Это устраняет ошибку компиляции и не требует никаких других изменений в коде.
Учтите: поскольку drop может вызываться во время паники, unwrap тоже может
запаниковать и вызвать двойную панику, которая немедленно обрушит программу и
прервёт любую незавершённую очистку. Для учебной программы это допустимо, но в
продакшен-коде так делать не рекомендуется.
Сигнализируем потокам, что пора перестать ждать задания
После всех изменений код компилируется без единого предупреждения. Но плохая
новость в том, что работает он пока не так, как мы хотим. Всё дело в логике
замыканий, которые выполняют потоки экземпляров Worker: сейчас мы вызываем
join, но потоки от этого не завершатся, потому что они бесконечно крутятся в
loop в поисках заданий. Если попытаться уничтожить ThreadPool с текущей
реализацией drop, главный поток навсегда заблокируется в ожидании, пока
завершится первый поток.
Чтобы это исправить, нужно изменить реализацию drop у ThreadPool, а затем
цикл в Worker.
Сначала изменим реализацию drop у ThreadPool, чтобы она явно уничтожала
sender, прежде чем ждать завершения потоков. В листинге 21-23 показаны
изменения в ThreadPool, позволяющие явно уничтожить sender. В отличие от
ситуации с потоком, здесь нам действительно нужен Option, чтобы с помощью
Option::take переместить sender из ThreadPool.
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: Option<mpsc::Sender<Job>>,
}
// --пропуск--
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Создаёт новый ThreadPool.
///
/// size — число потоков в пуле.
///
/// # Паника
///
/// Функция `new` паникует, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
// --пропуск--
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool {
workers,
sender: Some(sender),
}
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.as_ref().unwrap().send(job).unwrap();
}
}
impl Drop for ThreadPool {
fn drop(&mut self) {
drop(self.sender.take());
for worker in self.workers.drain(..) {
println!("Shutting down worker {}", worker.id);
worker.thread.join().unwrap();
}
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let job = receiver.lock().unwrap().recv().unwrap();
println!("Worker {id} got a job; executing.");
job();
}
});
Worker { id, thread }
}
}sender, прежде чем присоединять потоки WorkerУничтожение sender закрывает канал — это означает, что сообщений больше не
будет. Когда это происходит, все вызовы recv, которые экземпляры Worker
делают в бесконечном цикле, начинают возвращать ошибку. В листинге 21-24 мы
меняем цикл в Worker так, чтобы в этом случае он корректно завершался, — а
значит, потоки закончат работу, когда реализация drop у ThreadPool вызовет
для них join.
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: Option<mpsc::Sender<Job>>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Создаёт новый ThreadPool.
///
/// size — число потоков в пуле.
///
/// # Паника
///
/// Функция `new` паникует, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool {
workers,
sender: Some(sender),
}
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.as_ref().unwrap().send(job).unwrap();
}
}
impl Drop for ThreadPool {
fn drop(&mut self) {
drop(self.sender.take());
for worker in self.workers.drain(..) {
println!("Shutting down worker {}", worker.id);
worker.thread.join().unwrap();
}
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let message = receiver.lock().unwrap().recv();
match message {
Ok(job) => {
println!("Worker {id} got a job; executing.");
job();
}
Err(_) => {
println!("Worker {id} disconnected; shutting down.");
break;
}
}
}
});
Worker { id, thread }
}
}recv возвращает ошибкуЧтобы увидеть этот код в действии, изменим main так, чтобы сервер принимал
только два запроса, а затем корректно завершался, как в листинге 21-25.
use hello::ThreadPool;
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
let pool = ThreadPool::new(4);
for stream in listener.incoming().take(2) {
let stream = stream.unwrap();
pool.execute(|| {
handle_connection(stream);
});
}
println!("Shutting down.");
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}Настоящему веб-серверу, конечно, незачем останавливаться после двух запросов. Этот код лишь показывает, что корректное завершение и очистка работают.
Метод take определён в трейте Iterator и ограничивает перебор максимум
двумя первыми элементами. В конце main ThreadPool выйдет из области
видимости, и выполнится реализация drop.
Запустите сервер командой cargo run и сделайте три запроса. Третий запрос
должен завершиться ошибкой, а в терминале вы увидите примерно такой вывод:
$ cargo run
Compiling hello v0.1.0 (file:///projects/hello)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.41s
Running `target/debug/hello`
Worker 0 got a job; executing.
Shutting down.
Shutting down worker 0
Worker 3 got a job; executing.
Worker 1 disconnected; shutting down.
Worker 2 disconnected; shutting down.
Worker 3 disconnected; shutting down.
Worker 0 disconnected; shutting down.
Shutting down worker 1
Shutting down worker 2
Shutting down worker 3
Порядок идентификаторов Worker и сообщений у вас может быть другим. По
сообщениям видно, как работает код: первые два запроса достались экземплярам
Worker 0 и 3. После второго соединения сервер перестал принимать новые, и
реализация Drop у ThreadPool начала выполняться ещё до того, как Worker 3
вообще взялся за своё задание. Уничтожение sender отключает все экземпляры
Worker и велит им завершиться. Каждый Worker, отключаясь, выводит
сообщение, а затем пул потоков вызывает join и ждёт завершения каждого потока
Worker.
Обратите внимание на одну интересную деталь именно этого запуска: ThreadPool
уничтожил sender, и ещё до того, как хоть один Worker получил ошибку, мы
попытались присоединить Worker 0. Worker 0 пока не получил ошибку от recv,
поэтому главный поток заблокировался, ожидая, пока Worker 0 закончит. Тем
временем Worker 3 получил задание, а затем ошибку получили все потоки. Когда
Worker 0 завершился, главный поток дождался завершения остальных экземпляров
Worker. К этому моменту все они уже вышли из своих циклов и остановились.
Поздравляем! Проект готов: у нас есть простой веб-сервер, который с помощью пула потоков отвечает на запросы асинхронно. Сервер умеет корректно завершаться, убирая за собой все потоки пула.
Вот полный код для справки:
use hello::ThreadPool;
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
let pool = ThreadPool::new(4);
for stream in listener.incoming().take(2) {
let stream = stream.unwrap();
pool.execute(|| {
handle_connection(stream);
});
}
println!("Shutting down.");
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: Option<mpsc::Sender<Job>>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Создаёт новый ThreadPool.
///
/// size — число потоков в пуле.
///
/// # Паника
///
/// Функция `new` паникует, если size равен нулю.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool {
workers,
sender: Some(sender),
}
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.as_ref().unwrap().send(job).unwrap();
}
}
impl Drop for ThreadPool {
fn drop(&mut self) {
drop(self.sender.take());
for worker in &mut self.workers {
println!("Shutting down worker {}", worker.id);
if let Some(thread) = worker.thread.take() {
thread.join().unwrap();
}
}
}
}
struct Worker {
id: usize,
thread: Option<thread::JoinHandle<()>>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let message = receiver.lock().unwrap().recv();
match message {
Ok(job) => {
println!("Worker {id} got a job; executing.");
job();
}
Err(_) => {
println!("Worker {id} disconnected; shutting down.");
break;
}
}
}
});
Worker {
id,
thread: Some(thread),
}
}
}Здесь можно сделать ещё многое! Если хотите и дальше развивать проект, вот несколько идей:
- Добавить больше документации к
ThreadPoolи его публичным методам. - Добавить тесты функциональности библиотеки.
- Заменить вызовы
unwrapболее надёжной обработкой ошибок. - Использовать
ThreadPoolдля какой-нибудь другой задачи, а не для обслуживания веб-запросов. - Найти крейт пула потоков на crates.io и написать похожий веб-сервер с его помощью. Затем сравнить его API и надёжность с нашим пулом потоков.
Итоги
Отличная работа! Вы дочитали книгу до конца! Спасибо, что прошли с нами это путешествие по Rust. Теперь вы готовы писать собственные проекты на Rust и помогать с чужими. Помните, что вокруг — дружелюбное сообщество растацеанов (Rustaceans), которые с радостью помогут вам с любыми трудностями на вашем пути в Rust.
Приложения
В следующих разделах собраны справочные материалы, которые могут пригодиться вам на пути в Rust.
А — Ключевые слова
Приложение A: ключевые слова
Ниже перечислены ключевые слова, зарезервированные языком Rust для текущего или будущего использования. Поэтому их нельзя использовать как идентификаторы (кроме сырых идентификаторов — о них в разделе «Сырые идентификаторы»). Идентификаторы — это имена функций, переменных, параметров, полей структур, модулей, крейтов, констант, макросов, статических значений, атрибутов, типов, трейтов и времён жизни.
Используемые ключевые слова
Вот список ключевых слов, которые используются сейчас, с описанием их назначения.
as: приведение примитивных типов, уточнение конкретного трейта, в котором находится элемент, или переименование элементов в инструкцияхuse.async: вернутьFutureвместо блокировки текущего потока.await: приостановить выполнение, пока результатFutureне будет готов.break: немедленно выйти из цикла.const: определить константу или константный сырой указатель.continue: перейти к следующей итерации цикла.crate: в пути модуля обозначает корень крейта.dyn: динамическая диспетчеризация к трейт-объекту.else: запасная ветка для конструкцийifиif let.enum: определить перечисление.extern: связать внешнюю функцию или переменную.false: логический литерал «ложь».fn: определить функцию или тип указателя на функцию.for: перебрать элементы итератора, реализовать трейт или указать время жизни высшего ранга (higher ranked lifetime).if: ветвление по результату условного выражения.impl: реализовать собственную функциональность типа или функциональность трейта.in: часть синтаксиса циклаfor.let: связать переменную.loop: безусловный цикл.match: сопоставить значение с образцами.mod: определить модуль.move: заставить замыкание забрать владение всем, что оно захватывает.mut: обозначить изменяемость ссылок, сырых указателей или привязок в образцах.pub: обозначить публичную видимость полей структур, блоковimplили модулей.ref: привязать по ссылке.return: вернуться из функции.Self: псевдоним типа для типа, который мы определяем или реализуем.self: объект, у которого вызван метод, или текущий модуль.static: глобальная переменная или время жизни на всё время выполнения программы.struct: определить структуру.super: родительский модуль текущего модуля.trait: определить трейт.true: логический литерал «истина».type: определить псевдоним типа или ассоциированный тип.union: определить объединение; ключевое слово только в объявлении объединения.unsafe: обозначить небезопасный код, функции, трейты или реализации.use: ввести имена в область видимости.where: обозначить условия, ограничивающие тип.while: условный цикл, зависящий от результата выражения.
Ключевые слова, зарезервированные на будущее
Следующие ключевые слова пока ничего не делают, но Rust резервирует их для возможного использования в будущем:
abstractbecomeboxdofinalgenmacrooverrideprivtrytypeofunsizedvirtualyield
Сырые идентификаторы
Сырые идентификаторы (raw identifiers) — это синтаксис, позволяющий
использовать ключевые слова там, где обычно они запрещены. Чтобы получить сырой
идентификатор, добавьте перед ключевым словом префикс r#.
Например, match — ключевое слово. Если попытаться скомпилировать функцию с
именем match:
Файл: src/main.rs
fn match(needle: &str, haystack: &str) -> bool {
haystack.contains(needle)
}вы получите такую ошибку:
error: expected identifier, found keyword `match`
--> src/main.rs:4:4
|
4 | fn match(needle: &str, haystack: &str) -> bool {
| ^^^^^ expected identifier, found keyword
Ошибка показывает, что ключевое слово match нельзя использовать как
идентификатор функции. Чтобы назвать функцию match, нужен синтаксис сырых
идентификаторов:
Файл: src/main.rs
fn r#match(needle: &str, haystack: &str) -> bool {
haystack.contains(needle)
}
fn main() {
assert!(r#match("foo", "foobar"));
}Этот код скомпилируется без ошибок. Обратите внимание на префикс r# у имени
функции — и в её определении, и там, где она вызывается в main.
Сырые идентификаторы позволяют использовать в качестве идентификатора любое
слово, даже если оно оказалось зарезервированным ключевым словом. Это даёт
больше свободы в выборе имён, а также позволяет интегрироваться с программами,
написанными на языках, где эти слова не являются ключевыми. Кроме того, сырые
идентификаторы позволяют использовать библиотеки, написанные в другой редакции
Rust, чем ваш крейт. Например, try — не ключевое слово в редакции 2015, но
ключевое в редакциях 2018, 2021 и 2024. Если вы зависите от библиотеки,
написанной в редакции 2015, в которой есть функция try, то, чтобы вызвать её
из кода в более поздней редакции, придётся использовать синтаксис сырых
идентификаторов — в данном случае r#try. Подробнее о редакциях — в
приложении E.
Б — Операторы и символы
Приложение B: операторы и символы
В этом приложении собран глоссарий синтаксиса Rust: операторы и другие символы, которые встречаются сами по себе или в контексте путей, обобщений, ограничений трейтами, макросов, атрибутов, комментариев, кортежей и скобок.
Операторы
В таблице B-1 перечислены операторы Rust: пример того, как оператор выглядит в контексте, краткое пояснение и можно ли его перегрузить. Если оператор перегружаемый, указан трейт, через который это делается.
Таблица B-1: Операторы
| Оператор | Пример | Пояснение | Перегружается? |
|---|---|---|---|
! | ident!(...), ident!{...}, ident![...] | Раскрытие макроса | |
! | !expr | Побитовое или логическое отрицание | Not |
!= | expr != expr | Сравнение на неравенство | PartialEq |
% | expr % expr | Остаток от деления | Rem |
%= | var %= expr | Остаток от деления с присваиванием | RemAssign |
& | &expr, &mut expr | Заимствование | |
& | &type, &mut type, &'a type, &'a mut type | Тип заимствованного указателя (ссылки) | |
& | expr & expr | Побитовое И | BitAnd |
&= | var &= expr | Побитовое И с присваиванием | BitAndAssign |
&& | expr && expr | Логическое И с коротким замыканием | |
* | expr * expr | Умножение | Mul |
*= | var *= expr | Умножение с присваиванием | MulAssign |
* | *expr | Разыменование | Deref |
* | *const type, *mut type | Сырой указатель | |
+ | trait + trait, 'a + trait | Составное ограничение типа | |
+ | expr + expr | Сложение | Add |
+= | var += expr | Сложение с присваиванием | AddAssign |
, | expr, expr | Разделитель аргументов и элементов | |
- | - expr | Арифметическое отрицание (смена знака) | Neg |
- | expr - expr | Вычитание | Sub |
-= | var -= expr | Вычитание с присваиванием | SubAssign |
-> | fn(...) -> type, |…| -> type | Тип возвращаемого значения функции или замыкания | |
. | expr.ident | Доступ к полю | |
. | expr.ident(expr, ...) | Вызов метода | |
. | expr.0, expr.1 и так далее | Доступ к элементу кортежа по индексу | |
.. | .., expr.., ..expr, expr..expr | Литерал диапазона, не включающего правую границу | PartialOrd |
..= | ..=expr, expr..=expr | Литерал диапазона, включающего правую границу | PartialOrd |
.. | ..expr | Синтаксис обновления структуры | |
.. | variant(x, ..), struct_type { x, .. } | Образец «и всё остальное» | |
... | expr...expr | (Устарело, используйте ..=) В образце: диапазон, включающий границы | |
/ | expr / expr | Деление | Div |
/= | var /= expr | Деление с присваиванием | DivAssign |
: | pat: type, ident: type | Ограничения (аннотации типа) | |
: | ident: expr | Инициализация поля структуры | |
: | 'a: loop {...} | Метка цикла | |
; | expr; | Завершение инструкции или элемента | |
; | [...; len] | Часть синтаксиса массива фиксированного размера | |
<< | expr << expr | Сдвиг влево | Shl |
<<= | var <<= expr | Сдвиг влево с присваиванием | ShlAssign |
< | expr < expr | Сравнение «меньше» | PartialOrd |
<= | expr <= expr | Сравнение «меньше или равно» | PartialOrd |
= | var = expr, ident = type | Присваивание/эквивалентность | |
== | expr == expr | Сравнение на равенство | PartialEq |
=> | pat => expr | Часть синтаксиса ветки match | |
> | expr > expr | Сравнение «больше» | PartialOrd |
>= | expr >= expr | Сравнение «больше или равно» | PartialOrd |
>> | expr >> expr | Сдвиг вправо | Shr |
>>= | var >>= expr | Сдвиг вправо с присваиванием | ShrAssign |
@ | ident @ pat | Привязка в образце | |
^ | expr ^ expr | Побитовое исключающее ИЛИ | BitXor |
^= | var ^= expr | Побитовое исключающее ИЛИ с присваиванием | BitXorAssign |
| | pat | pat | Альтернативы в образце | |
| | expr | expr | Побитовое ИЛИ | BitOr |
|= | var |= expr | Побитовое ИЛИ с присваиванием | BitOrAssign |
|| | expr || expr | Логическое ИЛИ с коротким замыканием | |
? | expr? | Проброс ошибки |
Символы, не являющиеся операторами
В следующих таблицах собраны все символы, которые не работают как операторы, то есть не ведут себя как вызов функции или метода.
В таблице B-2 — символы, которые встречаются сами по себе и допустимы в самых разных местах.
Таблица B-2: Самостоятельный синтаксис
| Символ | Пояснение |
|---|---|
'ident | Именованное время жизни или метка цикла |
Цифры, сразу за которыми идёт u8, i32, f64, usize и так далее | Числовой литерал конкретного типа |
"..." | Строковый литерал |
r"...", r#"..."#, r##"..."## и так далее | Сырой строковый литерал; экранирующие последовательности не обрабатываются |
b"..." | Байтовый строковый литерал; создаёт массив байтов вместо строки |
br"...", br#"..."#, br##"..."## и так далее | Сырой байтовый строковый литерал; сочетание сырого и байтового литерала |
'...' | Символьный литерал |
b'...' | Байтовый литерал ASCII |
|…| expr | Замыкание |
! | Всегда пустой «низший» тип для расходящихся функций |
_ | «Игнорирующая» привязка в образце; также делает целочисленные литералы читаемее |
В таблице B-3 — символы, которые встречаются в пути к элементу через иерархию модулей.
Таблица B-3: Синтаксис путей
| Символ | Пояснение |
|---|---|
ident::ident | Путь в пространстве имён |
::path | Путь относительно корня крейта (то есть явно абсолютный путь) |
self::path | Путь относительно текущего модуля (то есть явно относительный путь) |
super::path | Путь относительно родителя текущего модуля |
type::ident, <type as trait>::ident | Ассоциированные константы, функции и типы |
<type>::... | Ассоциированный элемент типа, который нельзя назвать напрямую (например, <&T>::..., <[T]>::... и так далее) |
trait::method(...) | Уточнение вызова метода через имя трейта, в котором он определён |
type::method(...) | Уточнение вызова метода через имя типа, для которого он определён |
<type as trait>::method(...) | Уточнение вызова метода через имя трейта и типа |
В таблице B-4 — символы, которые встречаются при использовании обобщённых параметров типа.
Таблица B-4: Обобщения
| Символ | Пояснение |
|---|---|
path<...> | Задаёт параметры обобщённого типа в записи типа (например, Vec<u8>) |
path::<...>, method::<...> | Задаёт параметры обобщённого типа, функции или метода в выражении; часто называется турбофиш (turbofish), например "42".parse::<i32>() |
fn ident<...> ... | Определение обобщённой функции |
struct ident<...> ... | Определение обобщённой структуры |
enum ident<...> ... | Определение обобщённого перечисления |
impl<...> ... | Определение обобщённой реализации |
for<...> type | Ограничения времени жизни высшего ранга |
type<ident=type> | Обобщённый тип, у которого одному или нескольким ассоциированным типам заданы конкретные значения (например, Iterator<Item=T>) |
В таблице B-5 — символы, которые встречаются при ограничении обобщённых параметров типа трейтами.
Таблица B-5: Ограничения трейтами
| Символ | Пояснение |
|---|---|
T: U | Обобщённый параметр T ограничен типами, реализующими U |
T: 'a | Обобщённый тип T должен жить дольше времени жизни 'a (то есть тип не может, даже косвенно, содержать ссылки со временем жизни короче 'a) |
T: 'static | Обобщённый тип T не содержит заимствованных ссылок, кроме 'static |
'b: 'a | Обобщённое время жизни 'b должно быть дольше времени жизни 'a |
T: ?Sized | Разрешить обобщённому параметру типа быть типом с динамическим размером |
'a + trait, trait + trait | Составное ограничение типа |
В таблице B-6 — символы, которые встречаются при вызове или определении макросов и при указании атрибутов элемента.
Таблица B-6: Макросы и атрибуты
| Символ | Пояснение |
|---|---|
#[meta] | Внешний атрибут |
#![meta] | Внутренний атрибут |
$ident | Подстановка в макросе |
$ident:kind | Метапеременная макроса |
$(...)... | Повторение в макросе |
ident!(...), ident!{...}, ident![...] | Вызов макроса |
В таблице B-7 — символы, создающие комментарии.
Таблица B-7: Комментарии
| Символ | Пояснение |
|---|---|
// | Однострочный комментарий |
//! | Внутренний однострочный документационный комментарий |
/// | Внешний однострочный документационный комментарий |
/*...*/ | Блочный комментарий |
/*!...*/ | Внутренний блочный документационный комментарий |
/**...*/ | Внешний блочный документационный комментарий |
В таблице B-8 — контексты, в которых используются круглые скобки.
Таблица B-8: Круглые скобки
| Символ | Пояснение |
|---|---|
() | Пустой кортеж (он же единичный тип, unit) — и литерал, и тип |
(expr) | Выражение в скобках |
(expr,) | Выражение кортежа из одного элемента |
(type,) | Тип кортежа из одного элемента |
(expr, ...) | Выражение кортежа |
(type, ...) | Тип кортежа |
expr(expr, ...) | Вызов функции; также используется для инициализации кортежных struct и кортежных вариантов enum |
В таблице B-9 — контексты, в которых используются фигурные скобки.
Таблица B-9: Фигурные скобки
| Контекст | Пояснение |
|---|---|
{...} | Выражение-блок |
Type {...} | Литерал структуры |
В таблице B-10 — контексты, в которых используются квадратные скобки.
Таблица B-10: Квадратные скобки
| Контекст | Пояснение |
|---|---|
[...] | Литерал массива |
[expr; len] | Литерал массива, содержащий len копий expr |
[type; len] | Тип массива, содержащий len экземпляров type |
expr[expr] | Индексация коллекции; перегружается (Index, IndexMut) |
expr[..], expr[a..], expr[..b], expr[a..b] | Индексация коллекции, которая выглядит как взятие среза; в качестве «индекса» используется Range, RangeFrom, RangeTo или RangeFull |
В — Выводимые трейты
Приложение C: выводимые трейты
В разных местах книги мы обсуждали атрибут derive, который можно применить к
определению структуры или перечисления. Атрибут derive генерирует код,
реализующий трейт со своей реализацией по умолчанию для типа, помеченного
синтаксисом derive.
В этом приложении собран справочник по всем трейтам стандартной библиотеки,
которые можно использовать с derive. В каждом разделе описано:
- какие операторы и методы становятся доступны, если вывести этот трейт;
- что делает реализация трейта, которую предоставляет
derive; - что реализация трейта говорит о типе;
- при каких условиях трейт можно или нельзя реализовать;
- примеры операций, которым нужен этот трейт.
Если вам нужно поведение, отличное от того, что даёт атрибут derive,
обратитесь к документации стандартной
библиотеки по каждому
трейту — там описано, как реализовать их вручную.
Перечисленные здесь трейты — единственные из определённых в стандартной
библиотеке, которые можно реализовать для своих типов через derive. У
остальных трейтов стандартной библиотеки нет разумного поведения по умолчанию,
поэтому реализовывать их вам придётся самим — так, как имеет смысл для вашей
задачи.
Пример трейта, который нельзя вывести, — Display: он отвечает за
форматирование для конечных пользователей. Всегда стоит продумать, как
правильно показывать тип конечному пользователю. Какие части типа ему можно
видеть? Какие будут для него важны? Какой формат данных будет ему наиболее
полезен? Компилятор Rust этого не знает, поэтому не может предоставить за вас
подходящее поведение по умолчанию.
Список выводимых трейтов в этом приложении не исчерпывающий: библиотеки могут
реализовать derive для своих трейтов, так что список трейтов, с которыми
можно использовать derive, по-настоящему открыт. Реализация derive требует
процедурного макроса — о них рассказано в разделе «Пользовательские макросы
derive» главы 20.
Debug — вывод для программиста
Трейт Debug включает отладочное форматирование в строках формата — оно
обозначается добавлением :? внутрь заполнителя {}.
Трейт Debug позволяет выводить экземпляры типа для отладки, чтобы вы и другие
программисты, использующие ваш тип, могли изучить экземпляр в определённый
момент выполнения программы.
Debug нужен, например, макросу assert_eq!. Если проверка на равенство не
проходит, этот макрос выводит значения переданных ему экземпляров, чтобы
программист видел, почему они не равны.
PartialEq и Eq — сравнение на равенство
Трейт PartialEq позволяет сравнивать экземпляры типа на равенство и включает
операторы == и !=.
Вывод PartialEq реализует метод eq. Если PartialEq выведен для структуры,
два экземпляра равны, только если равны все поля, и не равны, если не равно
хотя бы одно поле. Для перечисления каждый вариант равен самому себе и не
равен остальным вариантам.
PartialEq нужен, например, макросу assert_eq!, которому надо уметь
сравнивать два экземпляра типа на равенство.
У трейта Eq нет методов. Его назначение — сообщить, что любое значение
помеченного типа равно самому себе. Eq можно применить только к типам, которые
реализуют и PartialEq, хотя не каждый тип, реализующий PartialEq, может
реализовать Eq. Пример — числа с плавающей точкой: по их реализации два
экземпляра значения «не число» (NaN) не равны друг другу.
Eq нужен, например, ключам в HashMap<K, V> — чтобы HashMap<K, V> могла
определить, одинаковы ли два ключа.
PartialOrd и Ord — сравнение порядка
Трейт PartialOrd позволяет сравнивать экземпляры типа, чтобы их можно было
сортировать. Тип, реализующий PartialOrd, можно использовать с операторами
<, >, <= и >=. PartialOrd можно применить только к типам, которые
реализуют и PartialEq.
Вывод PartialOrd реализует метод partial_cmp, который возвращает
Option<Ordering>; результат будет None, если для переданных значений порядок
не определён. Пример значения, для которого порядок не определён, хотя
большинство значений этого типа сравнимы, — значение с плавающей точкой NaN.
Вызов partial_cmp для любого числа с плавающей точкой и NaN вернёт None.
Для структур выведенный PartialOrd сравнивает два экземпляра поле за полем в
том порядке, в котором поля перечислены в определении структуры. Для
перечислений варианты, объявленные раньше, считаются меньше вариантов,
объявленных позже.
PartialOrd нужен, например, методу gen_range из крейта rand, который
генерирует случайное значение в диапазоне, заданном выражением диапазона.
Трейт Ord гарантирует, что для любых двух значений помеченного типа
существует корректный порядок. Ord реализует метод cmp, который возвращает
Ordering, а не Option<Ordering>, потому что корректный порядок всегда
определён. Ord можно применить только к типам, которые реализуют и
PartialOrd, и Eq (а Eq требует PartialEq). Для структур и перечислений
выведенный cmp ведёт себя так же, как выведенная реализация partial_cmp в
PartialOrd.
Ord нужен, например, при хранении значений в BTreeSet<T> — структуре данных,
которая хранит данные в порядке их сортировки.
Clone и Copy — дублирование значений
Трейт Clone позволяет явно создать глубокую копию значения; при этом может
выполняться произвольный код и копироваться данные в куче. Подробнее о Clone
— в разделе «Переменные и данные:
клонирование» главы
4.
Вывод Clone реализует метод clone, который для типа целиком вызывает
clone у каждой его части. Поэтому, чтобы вывести Clone, все поля или
значения внутри типа тоже должны реализовывать Clone.
Clone нужен, например, при вызове метода to_vec у среза. Срез не владеет
экземплярами, которые содержит, а вектор, возвращаемый to_vec, должен ими
владеть, поэтому to_vec вызывает clone для каждого элемента. Значит, тип,
хранящийся в срезе, должен реализовывать Clone.
Трейт Copy позволяет продублировать значение, просто скопировав биты,
хранящиеся на стеке, — никакого произвольного кода не нужно. Подробнее о Copy
— в разделе «Данные только на стеке: копирование» главы 4.
Трейт Copy не определяет никаких методов — чтобы программисты не могли
перегрузить их и нарушить допущение, что при копировании не выполняется
произвольный код. Поэтому любой программист может рассчитывать, что
копирование значения — очень быстрая операция.
Вывести Copy можно для любого типа, все части которого реализуют Copy.
Тип, реализующий Copy, должен реализовывать и Clone, потому что у такого
типа есть тривиальная реализация Clone, которая делает то же, что Copy.
Copy требуется редко: для типов с Copy доступны оптимизации — не нужно
вызывать clone, и код получается лаконичнее.
Всё, что можно сделать с Copy, можно сделать и с Clone, но код может
работать медленнее или кое-где придётся вызывать clone.
Hash — отображение значения в значение фиксированного размера
Трейт Hash позволяет взять экземпляр типа произвольного размера и с помощью
хеш-функции отобразить его в значение фиксированного размера. Вывод Hash
реализует метод hash. Выведенная реализация hash объединяет результаты
вызова hash для каждой части типа, поэтому, чтобы вывести Hash, все поля
или значения тоже должны реализовывать Hash.
Hash нужен, например, ключам в HashMap<K, V>, чтобы эффективно хранить
данные.
Default — значения по умолчанию
Трейт Default позволяет создать для типа значение по умолчанию. Вывод
Default реализует функцию default. Выведенная реализация default вызывает
default для каждой части типа, поэтому, чтобы вывести Default, все поля или
значения внутри типа тоже должны реализовывать Default.
Функцию Default::default часто используют вместе с синтаксисом обновления
структуры, о котором говорилось в разделе «Создание экземпляров с синтаксисом
обновления» главы 5. Можно задать нужные значения нескольким полям структуры, а
для остальных полей взять значения по умолчанию с помощью
..Default::default().
Default нужен, например, при вызове метода unwrap_or_default у экземпляров
Option<T>. Если Option<T> равен None, метод unwrap_or_default вернёт
результат Default::default для типа T, хранящегося в Option<T>.
Г — Полезные инструменты разработки
Приложение D: полезные инструменты разработки
В этом приложении мы поговорим о полезных инструментах разработки, которые предоставляет проект Rust: автоматическом форматировании, быстром способе применить исправления предупреждений, линтере и интеграции с IDE.
Автоматическое форматирование с rustfmt
Инструмент rustfmt переформатирует код в соответствии со стилем, принятым в
сообществе. Многие совместные проекты используют rustfmt, чтобы не спорить о
стиле кода на Rust: все форматируют код этим инструментом.
rustfmt входит в стандартную установку Rust, так что программы rustfmt и
cargo-fmt у вас уже должны быть. Эти две команды соотносятся так же, как
rustc и cargo: rustfmt даёт более тонкий контроль, а cargo-fmt понимает
соглашения проекта на Cargo. Чтобы отформатировать любой проект Cargo,
выполните:
$ cargo fmt
Эта команда переформатирует весь код на Rust в текущем крейте. Меняться должен
только стиль кода, но не его смысл. Подробнее о rustfmt — в его
документации.
Исправляем код с помощью rustfix
Инструмент rustfix входит в установку Rust и умеет автоматически исправлять
предупреждения компилятора, у которых есть очевидный способ исправления — скорее
всего, именно тот, что вам нужен. Вы наверняка уже встречали предупреждения
компилятора. Например, возьмём такой код:
Файл: src/main.rs
fn main() {
let mut x = 42;
println!("{x}");
}Здесь мы объявляем переменную x изменяемой, но ни разу её не изменяем. Rust
предупреждает нас об этом:
$ cargo build
Compiling myprogram v0.1.0 (file:///projects/myprogram)
warning: variable does not need to be mutable
--> src/main.rs:2:9
|
2 | let mut x = 0;
| ----^
| |
| help: remove this `mut`
|
= note: `#[warn(unused_mut)]` on by default
Предупреждение предлагает убрать ключевое слово mut. Эту подсказку можно
применить автоматически с помощью rustfix, выполнив команду cargo fix:
$ cargo fix
Checking myprogram v0.1.0 (file:///projects/myprogram)
Fixing src/main.rs (1 fix)
Finished dev [unoptimized + debuginfo] target(s) in 0.59s
Если снова заглянуть в src/main.rs, видно, что cargo fix изменил код:
Файл: src/main.rs
fn main() {
let x = 42;
println!("{x}");
}Теперь переменная x неизменяемая, и предупреждение больше не появляется.
Команду cargo fix можно использовать и для перевода кода с одной редакции
Rust на другую. О редакциях рассказано в приложении E.
Больше проверок с Clippy
Clippy — набор проверок (линтов), которые анализируют код, помогая ловить типичные ошибки и улучшать код на Rust. Clippy входит в стандартную установку Rust.
Чтобы запустить проверки Clippy для любого проекта Cargo, выполните:
$ cargo clippy
Допустим, вы написали программу, в которой используется приближённое значение математической константы, например числа π:
fn main() {
let x = 3.1415;
let r = 8.0;
println!("the area of the circle is {}", x * r * r);
}Запуск cargo clippy для этого проекта приведёт к такой ошибке:
error: approximate value of `f{32, 64}::consts::PI` found
--> src/main.rs:2:13
|
2 | let x = 3.1415;
| ^^^^^^
|
= note: `#[deny(clippy::approx_constant)]` on by default
= help: consider using the constant directly
= help: for further information visit https://rust-lang.github.io/rust-clippy/master/index.html#approx_constant
Ошибка сообщает, что в Rust уже определена более точная константа PI и что
программа будет корректнее, если использовать её. Тогда стоит изменить код и
использовать константу PI.
Следующий код не вызывает у Clippy ни ошибок, ни предупреждений:
fn main() {
let x = std::f64::consts::PI;
let r = 8.0;
println!("the area of the circle is {}", x * r * r);
}Подробнее о Clippy — в его документации.
Интеграция с IDE через rust-analyzer
Для интеграции с IDE сообщество Rust рекомендует
rust-analyzer. Это набор утилит, построенных
вокруг компилятора и работающих по протоколу языкового сервера (Language Server
Protocol) — спецификации, по которой IDE и языки
программирования общаются друг с другом. rust-analyzer могут использовать
разные клиенты — например, плагин Rust analyzer для Visual Studio
Code.
Инструкции по установке есть на домашней странице проекта rust-analyzer; после этого установите поддержку языкового сервера
в своей IDE. Ваша IDE получит такие возможности, как автодополнение, переход к
определению и показ ошибок прямо в коде.
Д — Редакции
Приложение E: редакции
В главе 1 вы видели, что cargo new добавляет в файл Cargo.toml немного
метаданных о редакции (edition). В этом приложении разберёмся, что это
значит!
Язык Rust и его компилятор выходят по шестинедельному циклу, то есть пользователи постоянно получают новые возможности. Другие языки программирования выпускают крупные изменения реже; Rust выпускает небольшие обновления чаще. Со временем все эти мелкие изменения накапливаются. Но от релиза к релизу трудно оглянуться назад и сказать: «Ого, между Rust 1.10 и Rust 1.31 язык сильно изменился!»
Примерно раз в три года команда Rust выпускает новую редакцию Rust. Каждая редакция собирает накопившиеся возможности в цельный пакет с полностью обновлёнными документацией и инструментами. Новые редакции выходят в рамках обычного шестинедельного цикла релизов.
Для разных людей редакции значат разное:
- Для тех, кто активно пишет на Rust, новая редакция собирает постепенные изменения в понятный пакет.
- Для тех, кто на Rust не пишет, новая редакция — сигнал, что в языке появились крупные улучшения и, возможно, на Rust стоит взглянуть ещё раз.
- Для тех, кто разрабатывает сам Rust, новая редакция — общая точка сбора для всего проекта.
На момент написания книги доступны четыре редакции Rust: Rust 2015, Rust 2018, Rust 2021 и Rust 2024. Эта книга написана с использованием идиом редакции Rust 2024.
Ключ edition в Cargo.toml указывает, какую редакцию компилятор должен
использовать для вашего кода. Если ключа нет, ради обратной совместимости Rust
использует редакцию 2015.
Каждый проект может выбрать редакцию, отличную от редакции по умолчанию 2015. Редакции могут содержать несовместимые изменения — например, новое ключевое слово, которое конфликтует с идентификаторами в коде. Но пока вы сами не перейдёте на новую редакцию, ваш код будет компилироваться, даже если вы обновите версию компилятора Rust.
Любая версия компилятора Rust поддерживает все редакции, существовавшие до её выхода, и умеет компоновать вместе крейты любых поддерживаемых редакций. Редакции влияют только на то, как компилятор изначально разбирает код. Поэтому, если ваш проект на Rust 2015, а одна из зависимостей — на Rust 2018, проект скомпилируется и сможет использовать эту зависимость. Обратная ситуация — проект на Rust 2018, а зависимость на Rust 2015 — тоже работает.
Уточним: большинство возможностей доступно во всех редакциях. Разработчики на любой редакции Rust будут получать улучшения с каждым новым стабильным релизом. Однако в некоторых случаях — в основном когда добавляются новые ключевые слова — отдельные возможности могут быть доступны только в более поздних редакциях. Чтобы ими воспользоваться, придётся сменить редакцию.
Подробнее — в The Rust Edition Guide. Это полноценная книга,
в которой перечислены различия между редакциями и объяснено, как автоматически
перевести код на новую редакцию с помощью cargo fix.
Е — Переводы книги
Приложение F: переводы книги
Ресурсы на других языках, кроме английского. Большинство переводов ещё в работе; загляните в метку Translations, если хотите помочь или сообщить о новом переводе!
- Português (BR)
- Português (PT)
- 简体中文: KaiserY/trpl-zh-cn, gnu4cn/rust-lang-Zh_CN
- 正體中文
- Українська
- Español, alternate, Español por RustLangES
- Русский
- 한국어
- 日本語
- Français
- Polski
- Cebuano
- Tagalog
- Esperanto
- ελληνική
- Svenska
- Farsi, Persian (FA)
- Deutsch
- हिंदी
- ไทย
- Danske
- O’zbek
- Tiếng Việt
- Italiano
- বাংলা
Ж — Как создаётся Rust и что такое «nightly Rust»
Приложение G: как создаётся Rust и что такое «Nightly Rust»
Это приложение о том, как создаётся Rust и как это сказывается на вас как на разработчике на Rust.
Стабильность без застоя
Rust как язык очень заботится о стабильности вашего кода. Мы хотим, чтобы Rust был надёжным, как скала, фундаментом для ваших проектов, а если бы всё постоянно менялось, это было бы невозможно. В то же время, если не экспериментировать с новыми возможностями, важные недостатки могут обнаружиться только после релиза, когда менять что-либо уже поздно.
Наше решение этой проблемы мы называем «стабильностью без застоя» (stability without stagnation), а главный принцип такой: вам никогда не должно быть страшно обновляться до новой версии стабильного Rust. Каждое обновление должно проходить безболезненно, но при этом приносить новые возможности, меньше багов и более быструю компиляцию.
Чух-чух! Каналы релизов и «поезда»
Разработка Rust идёт по расписанию поездов (train schedule). Вся разработка ведётся в основной ветке репозитория Rust. Релизы следуют модели «поезда релизов» (software release train), которую используют Cisco IOS и другие программные проекты. У Rust три канала релизов (release channels):
- Nightly (ночной)
- Beta (бета)
- Stable (стабильный)
Большинство разработчиков на Rust в основном пользуются стабильным каналом, а те, кто хочет попробовать экспериментальные новые возможности, — nightly или beta.
Вот пример того, как устроен процесс разработки и релизов. Допустим, команда Rust работает над релизом Rust 1.5. Этот релиз вышел в декабре 2015 года, но на нём удобно показать реалистичные номера версий. В Rust добавляется новая возможность: в основную ветку попадает новый коммит. Каждую ночь собирается новая ночная версия Rust. Каждый день — день релиза, и эти релизы автоматически создаёт наша инфраструктура. Так что со временем релизы выглядят так — по одному за ночь:
nightly: * - - * - - *
Раз в шесть недель приходит время готовить новый релиз! Ветка beta
репозитория Rust ответвляется от основной ветки, из которой собирается nightly.
Теперь релизов два:
nightly: * - - * - - *
|
beta: *
Большинство пользователей Rust не используют бета-релизы напрямую, но прогоняют на них тесты в своих CI-системах, помогая Rust находить возможные регрессии. Тем временем ночной релиз по-прежнему выходит каждую ночь:
nightly: * - - * - - * - - * - - *
|
beta: *
Допустим, нашлась регрессия. Хорошо, что у нас было время протестировать
бета-релиз, прежде чем регрессия пробралась в стабильный! Исправление
применяется к основной ветке, так что nightly исправлен, затем исправление
переносится (backport) в ветку beta, и выходит новый бета-релиз:
nightly: * - - * - - * - - * - - * - - *
|
beta: * - - - - - - - - *
Через шесть недель после создания первой беты приходит время стабильного
релиза! Ветка stable создаётся из ветки beta:
nightly: * - - * - - * - - * - - * - - * - * - *
|
beta: * - - - - - - - - *
|
stable: *
Ура! Rust 1.5 готов! Но мы забыли одну вещь: раз шесть недель прошли, нужна
новая бета следующей версии Rust, 1.6. Поэтому после того, как stable
ответвилась от beta, следующая версия beta снова ответвляется от nightly:
nightly: * - - * - - * - - * - - * - - * - * - *
| |
beta: * - - - - - - - - * *
|
stable: *
Это называется «моделью поездов», потому что каждые шесть недель релиз «отправляется со станции», но, прежде чем прибыть стабильным релизом, ему ещё предстоит проехать через бета-канал.
Rust выходит каждые шесть недель, как по часам. Если вы знаете дату одного релиза Rust, то знаете и дату следующего: через шесть недель. Приятная сторона такого расписания — следующий поезд скоро. Если какая-то возможность не успела к определённому релизу, волноваться не о чем: следующий будет совсем скоро! Это снижает соблазн впихнуть недоработанные возможности в последний момент перед релизом.
Благодаря такому процессу вы всегда можете взять следующую сборку Rust и сами
убедиться, что на неё легко обновиться: если бета-релиз работает не так, как
ожидалось, можно сообщить команде и добиться исправления до выхода следующего
стабильного релиза! Поломки в бета-релизах случаются относительно редко, но
rustc — всё-таки программа, а в программах бывают баги.
Срок поддержки
Проект Rust поддерживает самую свежую стабильную версию. Когда выходит новая стабильная версия, срок жизни старой заканчивается (end of life, EOL). То есть каждая версия поддерживается шесть недель.
Нестабильные возможности
У этой модели релизов есть ещё одна особенность — нестабильные возможности. Чтобы определить, какие возможности включены в данном релизе, Rust использует приём под названием «флаги возможностей» (feature flags). Если новая возможность активно разрабатывается, она попадает в основную ветку, а значит, и в nightly, но за флагом возможности. Если вы как пользователь хотите попробовать возможность, работа над которой ещё идёт, — пожалуйста, но для этого нужно использовать ночной релиз Rust и пометить исходный код соответствующим флагом, явно её включив.
В бета- и стабильных релизах Rust флаги возможностей использовать нельзя. Именно это позволяет нам опробовать новые возможности на практике, прежде чем навсегда объявить их стабильными. Кто хочет быть на переднем крае — может включить их, а кто хочет надёжности — остаётся на стабильном канале и знает, что код не сломается. Стабильность без застоя.
В этой книге описаны только стабильные возможности: те, что ещё в разработке, продолжают меняться и наверняка будут отличаться от того, какими они были на момент написания книги, к тому времени, как их включат в стабильные сборки. Документацию по возможностям, доступным только в nightly, можно найти в сети.
Rustup и роль Rust Nightly
Rustup позволяет легко переключаться между каналами релизов Rust — глобально или для отдельного проекта. По умолчанию у вас установлен стабильный Rust. Чтобы установить, например, nightly:
$ rustup toolchain install nightly
С помощью rustup можно также посмотреть все установленные тулчейны
(toolchains — релизы Rust и сопутствующие компоненты). Вот пример с
Windows-компьютера одного из авторов:
> rustup toolchain list
stable-x86_64-pc-windows-msvc (default)
beta-x86_64-pc-windows-msvc
nightly-x86_64-pc-windows-msvc
Как видите, по умолчанию используется стабильный тулчейн. Большинство
пользователей Rust почти всегда работают на стабильном. Возможно, вы тоже
захотите почти всегда использовать stable, но для конкретного проекта —
nightly, потому что вам нужна какая-то передовая возможность. Для этого в
каталоге проекта выполните rustup override и укажите тулчейн nightly — его
rustup будет использовать, когда вы находитесь в этом каталоге:
$ cd ~/projects/needs-nightly
$ rustup override set nightly
Теперь при каждом вызове rustc или cargo внутри ~/projects/needs-nightly
rustup позаботится, чтобы использовался ночной Rust, а не стабильный,
выбранный по умолчанию. Это удобно, когда у вас много проектов на Rust!
Процесс RFC и команды
Как же узнавать об этих новых возможностях? Разработка Rust идёт по процессу RFC (Request For Comments, «запрос комментариев»). Если вы хотите улучшить что-то в Rust, можно написать предложение — RFC.
Писать RFC для улучшения Rust может кто угодно; предложения рассматривает и обсуждает команда Rust, которая состоит из множества тематических подкоманд. Полный список команд есть на сайте Rust: там команды для каждой области проекта — дизайна языка, реализации компилятора, инфраструктуры, документации и других. Соответствующая команда читает предложение и комментарии, добавляет свои, и в итоге достигается консенсус — принять возможность или отклонить.
Если возможность принята, в репозитории Rust открывается задача (issue), и кто-нибудь может её реализовать. Реализовывать её вполне может не тот, кто изначально предложил! Когда реализация готова, она попадает в основную ветку за флагом возможности, как описано в разделе «Нестабильные возможности».
Через какое-то время, когда разработчики, использующие ночные релизы, успеют попробовать новую возможность, члены команды обсуждают её и то, как она показала себя в nightly, и решают, попадёт ли она в стабильный Rust. Если решение положительное, флаг возможности убирается, и возможность считается стабильной! Она отправляется на поезде в новый стабильный релиз Rust.