Срезы
Срезы (slices) позволяют сослаться на непрерывную последовательность элементов коллекции, а не на всю коллекцию целиком. Срез — это разновидность ссылки, поэтому владения у него нет.
Вот небольшая задачка: написать функцию, которая принимает строку из слов, разделённых пробелами, и возвращает первое слово. Если в строке нет пробела, значит, вся строка — одно слово, и вернуть нужно её целиком.
Примечание: чтобы проще было объяснить срезы, в этом разделе мы считаем, что строки состоят только из символов ASCII. Подробнее о работе с UTF-8 — в разделе «Строки: текст в UTF-8» главы 8.
Чтобы понять, какую проблему решают срезы, сначала попробуем написать сигнатуру такой функции без них:
fn first_word(s: &String) -> ?Параметр функции first_word имеет тип &String. Владение нам не нужно, так
что это нормально. (В идиоматичном Rust функции не забирают владение
аргументами без необходимости — почему, станет понятно дальше.) Но что
возвращать? У нас пока нет способа описать часть строки. Зато можно вернуть
индекс конца слова — то есть позицию пробела. Попробуем, как в листинге 4-7.
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}first_word возвращает индекс байта внутри строки-параметра StringНам нужно пройтись по String элемент за элементом и проверить, не пробел ли
это. Поэтому сначала превращаем String в массив байтов методом as_bytes:
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}
Затем методом iter создаём итератор по этому массиву байтов:
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}
Подробно итераторы разбираются в главе 13. Пока
достаточно знать, что iter — метод, который по очереди выдаёт каждый элемент
коллекции, а enumerate оборачивает результат iter и выдаёт каждый элемент
в составе кортежа. Первый элемент кортежа из enumerate — индекс, второй —
ссылка на сам элемент. Так удобнее, чем считать индекс вручную.
Раз enumerate возвращает кортеж, его можно разобрать с помощью образца.
Подробнее об образцах мы поговорим в главе 6. В цикле
for мы указываем образец, где i — индекс из кортежа, а &item — байт из
кортежа. Поскольку .iter().enumerate() даёт нам ссылку на элемент, в образце
стоит &.
Внутри цикла for мы ищем байт пробела, записав его как байтовый литерал.
Если пробел нашёлся, возвращаем его позицию. Если нет — возвращаем длину
строки, s.len().
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}
Теперь мы умеем находить индекс конца первого слова, но есть проблема. Мы
возвращаем отдельное число usize, а смысл у него есть только в связке с
конкретной строкой &String. Иначе говоря, это значение живёт отдельно от
String, и нет никакой гарантии, что оно останется верным в будущем.
Посмотрите на программу из листинга 4-8, которая использует first_word из
листинга 4-7.
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {
    let mut s = String::from("hello world");

    let word = first_word(&s); // word получит значение 5

    s.clear(); // очищаем String: теперь она равна ""

    // word по-прежнему равно 5, но в s больше нет текста, к которому это
    // число имело бы смысл, так что word теперь совершенно бесполезно!
}first_word, а затем меняем содержимое StringЭта программа компилируется без ошибок — и скомпилировалась бы, даже если бы
мы использовали word после вызова s.clear(). Переменная word никак не
связана с состоянием s, поэтому в ней по-прежнему лежит 5. Мы могли бы
попытаться вырезать из s первое слово с помощью этой пятёрки, но это был бы
баг: с тех пор как мы сохранили 5 в word, содержимое s изменилось.
Следить за тем, чтобы индекс в word не разошёлся с данными в s, —
утомительно, и легко ошибиться! А если написать ещё и функцию second_word,
всё станет ещё хрупче. Её сигнатура выглядела бы так:
fn second_word(s: &String) -> (usize, usize) {Теперь нужно отслеживать и начальный, и конечный индекс. Оба числа вычислены по строке в какой-то момент, но если строка потом изменится, сами числа об этом не узнают. Получается три независимые переменные — строка и два индекса, — и следить, чтобы они не разошлись, приходится вручную.
К счастью, у Rust есть решение — строковые срезы.
Строковые срезы
Строковый срез (string slice) — это ссылка на непрерывную часть String.
Выглядит он так:
fn main() {
    let s = String::from("hello world");

    let hello = &s[0..5];
    let world = &s[6..11];
}
Здесь hello ссылается не на всю String, а только на её часть, заданную
добавкой [0..5]. Срез создаётся указанием диапазона в квадратных скобках:
[начальный_индекс..конечный_индекс], где начальный_индекс — первая
позиция среза, а конечный_индекс — позиция, следующая за последней. Внутри
срез хранит начальную позицию и длину, равную конечный_индекс минус
начальный_индекс. Так, в let world = &s[6..11]; срез world содержит
указатель на байт с индексом 6 в s и длину 5.
На рисунке 4-7 это показано схематично.
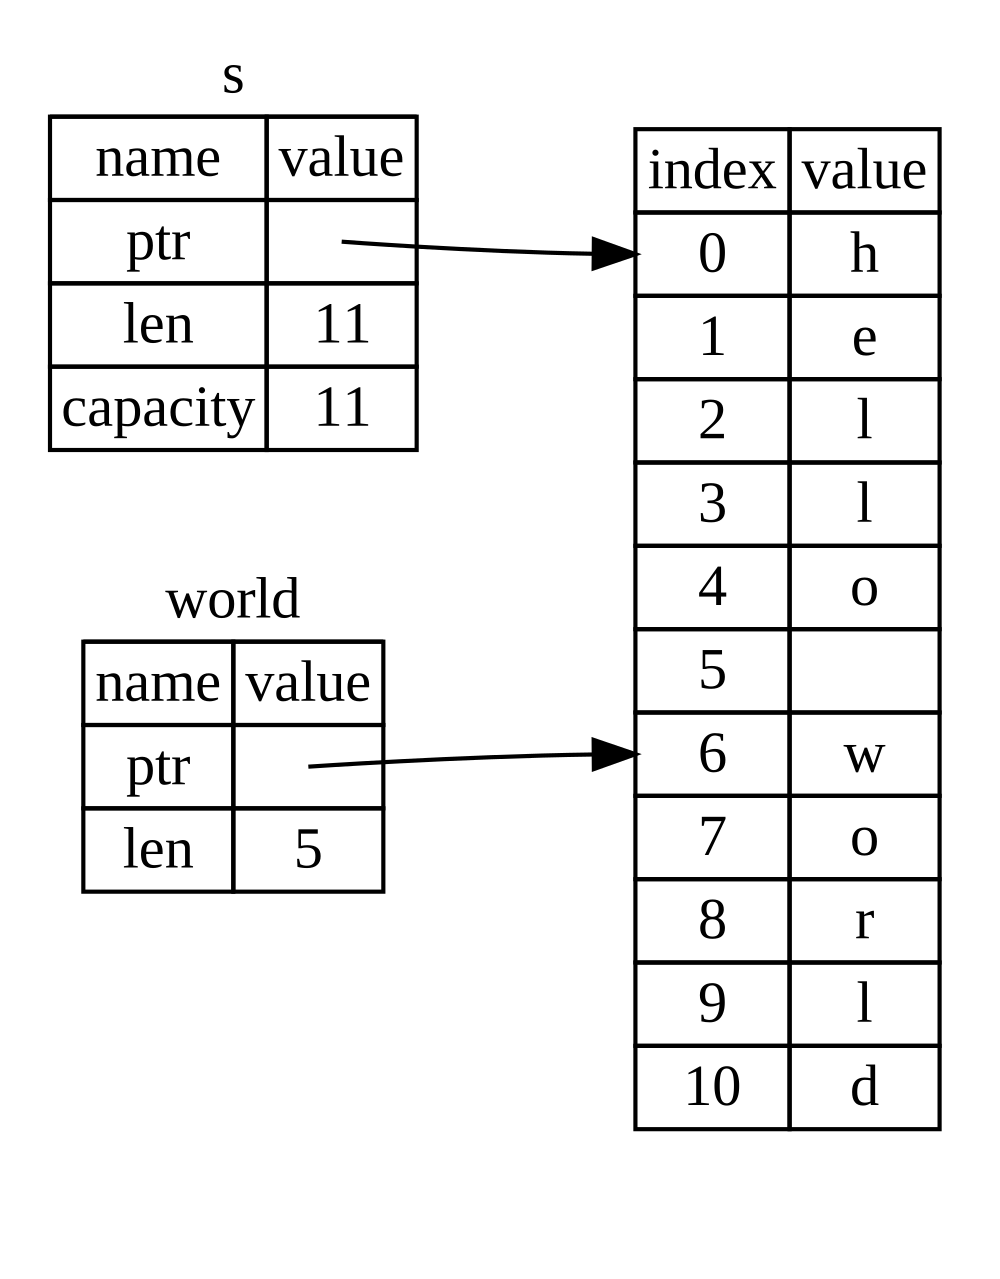
Рисунок 4-7: Строковый срез, ссылающийся на часть
String
Если диапазон .. начинается с индекса 0, число перед двумя точками можно не
писать. То есть эти две строки равнозначны:
#![allow(unused)]
fn main() {
let s = String::from("hello");

let slice = &s[0..2];
let slice = &s[..2];
}
Точно так же, если срез доходит до последнего байта String, можно не писать
число в конце. Эти строки тоже равнозначны:
#![allow(unused)]
fn main() {
let s = String::from("hello");

let len = s.len();

let slice = &s[3..len];
let slice = &s[3..];
}
А если опустить оба числа, получится срез всей строки. Эти строки равнозначны:
#![allow(unused)]
fn main() {
let s = String::from("hello");

let len = s.len();

let slice = &s[0..len];
let slice = &s[..];
}
Примечание: границы диапазона строкового среза должны приходиться на границы символов UTF-8. Если попытаться создать срез посередине многобайтового символа, программа завершится с ошибкой.
Теперь перепишем first_word так, чтобы она возвращала срез. Тип «строковый
срез» записывается как &str:
fn first_word(s: &String) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {}
Индекс конца слова мы находим так же, как в листинге 4-7, — ищем первый пробел. Найдя его, возвращаем строковый срез: от начала строки до индекса пробела.
Теперь first_word возвращает одно значение, которое привязано к исходным
данным. Оно состоит из ссылки на начало среза и количества элементов в нём.
Для функции second_word возврат среза тоже подойдёт:
fn second_word(s: &String) -> &str {Теперь у нас простой API, который гораздо сложнее использовать неправильно:
компилятор сам следит, чтобы ссылки внутрь String оставались
действительными. Помните баг из листинга 4-8? Мы получили индекс конца первого
слова, а потом очистили строку, и индекс стал бессмысленным. Код был логически
неверным, но никаких ошибок сразу не показывал. Проблемы всплыли бы позже —
если бы мы продолжили пользоваться индексом первого слова с уже пустой
строкой. Срезы делают такой баг невозможным и сообщают о проблеме гораздо
раньше. Версия first_word со срезом приведёт к ошибке компиляции:
fn first_word(s: &String) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {
    let mut s = String::from("hello world");

    let word = first_word(&s);

    s.clear(); // ошибка!

    println!("the first word is: {word}");
}
Вот ошибка компиляции:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0502]: cannot borrow `s` as mutable because it is also borrowed as immutable
  --> src/main.rs:18:5
   |
16 |     let word = first_word(&s);
   |                           -- immutable borrow occurs here
17 |
18 |     s.clear(); // ошибка!
   |     ^^^^^^^^^ mutable borrow occurs here
19 |
20 |     println!("the first word is: {word}");
   |                                   ---- immutable borrow later used here

For more information about this error, try `rustc --explain E0502`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
Почему так? Вспомните правило заимствования: пока на значение есть неизменяемая ссылка, изменяемую ссылку на него взять нельзя. Теперь посмотрим, что происходит в коде:
word— это срез строкиs, то есть неизменяемая ссылка наs.- Метод
clearочищает строкуs, а значит, меняет её. Для этого ему нужна изменяемая ссылка наs. - После
clearидётprintln!, который используетword. Значит, в момент вызоваclearнеизменяемая ссылкаwordвсё ещё нужна — она «жива».
Выходит, что в момент вызова clear на строку s должны одновременно
существовать и неизменяемая ссылка (word), и изменяемая (для clear). Rust
это запрещает, и компиляция завершается ошибкой. Так Rust не только сделал наш
API удобнее, но и избавил нас от целого класса ошибок — ещё до запуска
программы!
Строковые литералы — это срезы
Мы говорили, что строковые литералы хранятся прямо внутри бинарного файла. Теперь, зная о срезах, можно как следует понять, что такое строковый литерал:
#![allow(unused)]
fn main() {
let s = "Hello, world!";
}
Тип s здесь — &str: это срез, указывающий на определённое место в
бинарном файле. Поэтому строковые литералы и неизменяемы: &str —
неизменяемая ссылка.
Строковые срезы как параметры
Раз срезы можно брать и у литералов, и у значений String, сигнатуру
first_word можно улучшить ещё. Сейчас она такая:
fn first_word(s: &String) -> &str {Более опытный растацеан написал бы сигнатуру из листинга 4-9: с ней одна и та
же функция работает и со значениями &String, и со значениями &str.
fn first_word(s: &str) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {
    let my_string = String::from("hello world");

    // `first_word` принимает срезы `String` — как части, так и целой строки.
    let word = first_word(&my_string[0..6]);
    let word = first_word(&my_string[..]);
    // `first_word` принимает и ссылки на `String` — они равнозначны
    // срезам всей `String`.
    let word = first_word(&my_string);

    let my_string_literal = "hello world";

    // `first_word` принимает срезы строковых литералов — как части,
    // так и целого литерала.
    let word = first_word(&my_string_literal[0..6]);
    let word = first_word(&my_string_literal[..]);

    // Строковые литералы *уже* являются срезами строк,
    // поэтому сработает и так, без синтаксиса срезов!
    let word = first_word(my_string_literal);
}first_word: параметр s теперь имеет тип строкового срезаЕсли у нас есть строковый срез, его можно передать напрямую. Если есть
String, можно передать срез этой String или ссылку на неё. Такая гибкость
возможна благодаря неявному разыменованию (deref coercion) — мы разберём его
в разделе «Неявное разыменование в функциях и методах» главы 15.
Если функция принимает строковый срез, а не ссылку на String, её API
становится универсальнее и полезнее, а возможностей мы при этом не теряем:
fn first_word(s: &str) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {
    let my_string = String::from("hello world");

    // `first_word` принимает срезы `String` — как части, так и целой строки.
    let word = first_word(&my_string[0..6]);
    let word = first_word(&my_string[..]);
    // `first_word` принимает и ссылки на `String` — они равнозначны
    // срезам всей `String`.
    let word = first_word(&my_string);

    let my_string_literal = "hello world";

    // `first_word` принимает срезы строковых литералов — как части,
    // так и целого литерала.
    let word = first_word(&my_string_literal[0..6]);
    let word = first_word(&my_string_literal[..]);

    // Строковые литералы *уже* являются срезами строк,
    // поэтому сработает и так, без синтаксиса срезов!
    let word = first_word(my_string_literal);
}
Другие срезы
Строковые срезы, как нетрудно догадаться, бывают только у строк. Но есть и более общий вид среза. Возьмём массив:
#![allow(unused)]
fn main() {
let a = [1, 2, 3, 4, 5];
}
Точно так же, как может понадобиться сослаться на часть строки, может понадобиться сослаться на часть массива. Делается это так:
#![allow(unused)]
fn main() {
let a = [1, 2, 3, 4, 5];

let slice = &a[1..3];

assert_eq!(slice, &[2, 3]);
}
Тип этого среза — &[i32]. Работает он так же, как строковый срез: хранит
ссылку на первый элемент и длину. Такие срезы вы будете использовать с самыми
разными коллекциями. Подробно о коллекциях мы поговорим, когда дойдём до
векторов в главе 8.
Итоги
Владение, заимствование и срезы — это то, благодаря чему Rust гарантирует безопасную работу с памятью уже при компиляции. Памятью вы управляете так же точно, как в других языках системного программирования, но без лишней ручной работы. Освобождать память самому не нужно: как только переменная-владелец выходит из области видимости, Rust сам освобождает принадлежащие ей данные. Поэтому писать и отлаживать для этого отдельный код вам не придётся.
Владение влияет на то, как работают многие другие части Rust, поэтому мы ещё
не раз вернёмся к этим понятиям на протяжении книги. А теперь перейдём к
главе 5 и посмотрим, как объединять данные в структуры (struct).